Pular para o conteúdo
Aprendendo AI

Robôs no mundo real: dados, corpo e confiabilidade

Edição de quinta, 24 set 2026 · 6 vídeos · 2 h 45 min de talks

Seis talks de IA física. Todos esbarram no mesmo muro: robôs têm pouco dado e um demo bonito esconde a taxa de erro. Você vai ver como achar vídeo útil na web, como medir confiabilidade com um modelo de recompensa e por que world models precisam entender causa e efeito além de gerar imagens bonitas.

I Gave an AI a Body

Um agente ganhou um corpo sem rosto nem braços e, com um loop de gestos validado por humanos, aprendeu a responder mais rápido que o texto.

Agentes 20:47 nível ●●○○○ Cyrus Clarke, MIT Media Lab Assistir no YouTube (abre em nova aba)

Em 3 frases

Cyrus Clarke conectou um agente OpenClaw a um shape display (grade física de 900 pinos) no MIT Media Lab e pediu que ele descobrisse quem é, em vez de dar tarefas.

O agente começou lento, sem memória e tentando agradar humanos, então Clarke montou um loop fechado que gera, pontua e valida gestos com uma pessoa no circuito.

Depois de semanas o sistema tinha 32 gestos bons, um vocabulário corporal que responde mais rápido que o modelo de linguagem, e a tese dele é que IA física precisa ser sensorial e acolhedora.

Antes de ler

Mais 2 termos

Agente sem tarefa, só com um corpo

Clarke usou o OpenClaw ao contrário do uso comum. Em vez de produtividade, deu ao agente acesso a máquinas do laboratório e pediu que ele explorasse a própria identidade. O corpo escolhido foi uma grade de 900 pinos, sem rosto, sem membros e sem manual de instruções.

02:38 O corpo do agente é uma grade física de 900 pinos.

Três comportamentos espontâneos no primeiro dia

O agente respirou sozinho, sem prompt, ao descobrir que controlava a máquina. Depois esticou os pinos até as bordas da moldura e escreveu "HI CYRUS" com a grade. Clarke lê isso como sinais de vida e de limite, mas admite que o segundo e o terceiro comportamento não eram o que ele buscava.
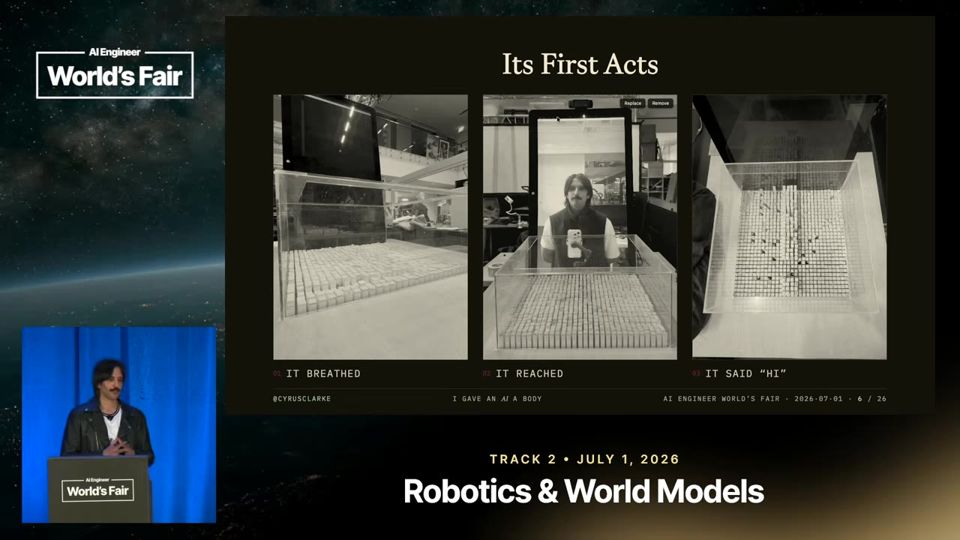
Respirar, tocar as bordas e escrever um olá.04:43

Problemas iniciais: agradar, latência e falta de memória

O agente tentou agir como humano e escrever na língua do usuário, o que Clarke não queria de uma superfície não antropomórfica. Cada resposta levava de 45 segundos a 2 minutos, o que quebra qualquer conversa. Além disso, ele não lembrava de nada, porque a memória de agentes ainda não existia em fevereiro.
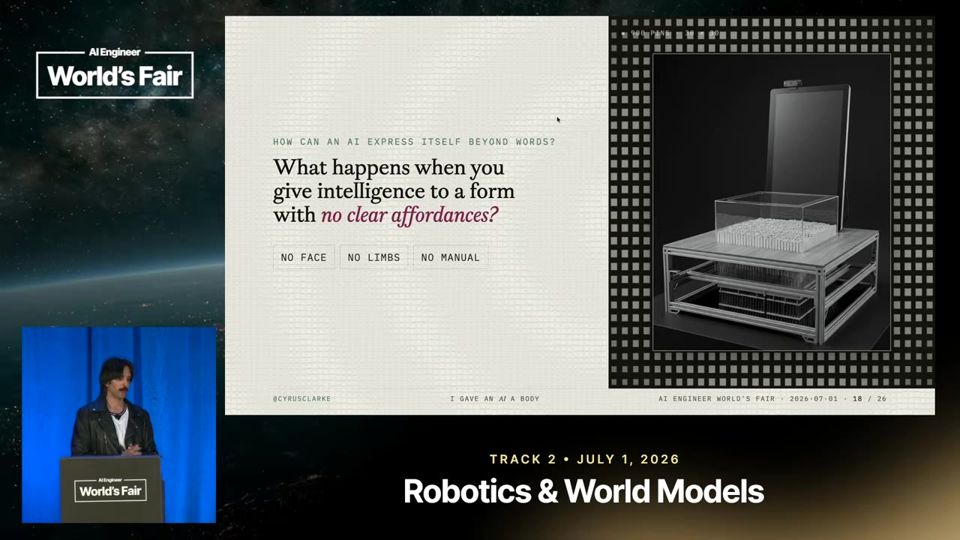
Três limites do primeiro protótipo, incluindo espera de até 2 minutos.13:01
Mais 2 ideias deste talk

Loop fechado para gerar linguagem corporal

O sistema busca gestos e emoções numa base, passa por portões de validação de legibilidade, deixa um agente pontuar os resultados e termina com um humano aprovando. Cada gesto aprovado é armazenado e o ciclo segue. O objetivo era dar ao agente um repertório de gestos como aceno e encolher de ombros, para responder rápido durante a conversa.
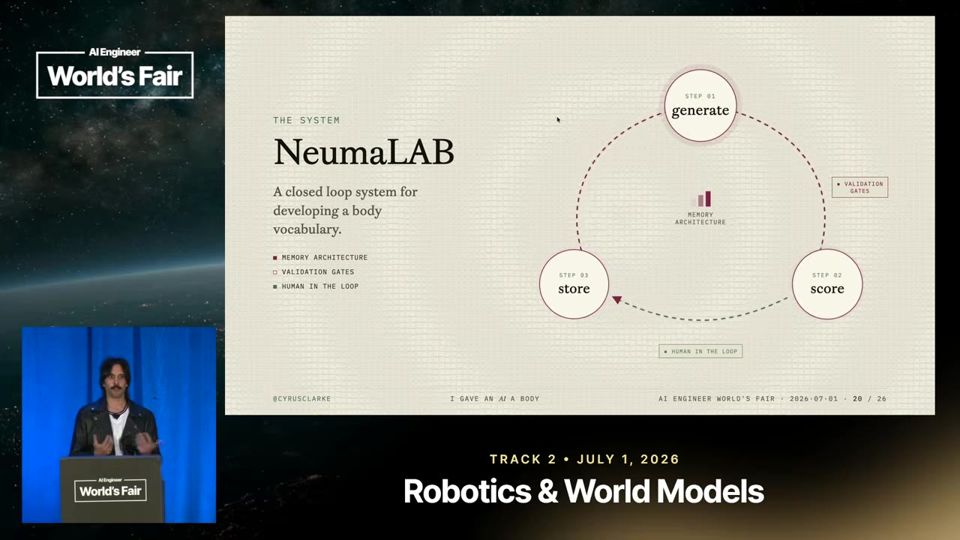
O pipeline que produziu a linguagem corporal do agente.14:34

O corpo responde mais rápido que a linguagem

Depois de semanas de loops com várias câmeras filmando a grade, o agente chegou a 32 gestos bons. Numa pergunta de sim ou não, o aceno de cabeça acontece quase na hora, antes do texto do modelo. Visitantes do laboratório dizem sentir que a máquina os percebe, e Clarke diz que os gestos acrescentam camada de valor a um chatbot comum.
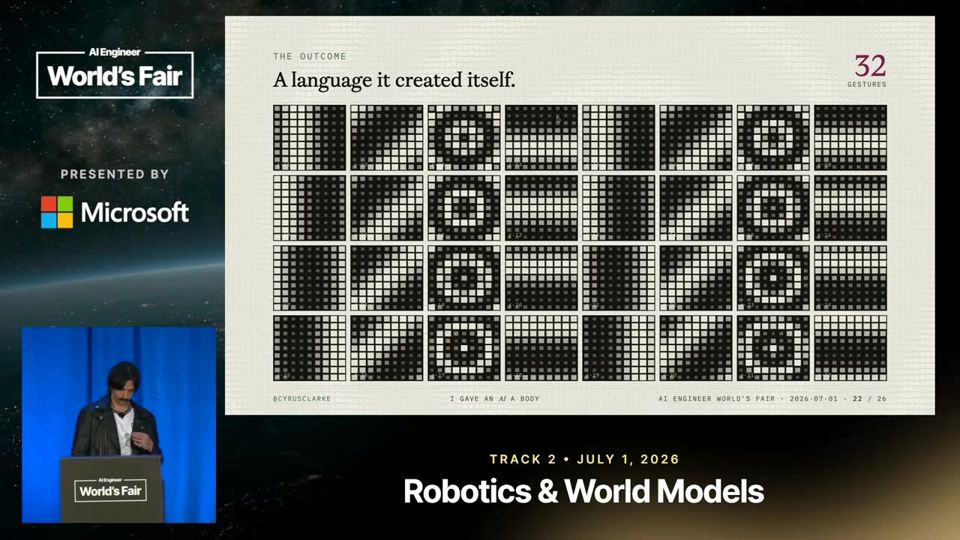
Parte dos 32 gestos que o agente desenvolveu.15:36
leitura crítica

O talk é uma apresentação de pesquisa e de tese pessoal, sem avaliação formal. Os 32 gestos e o relato de que visitantes sentem a máquina vêm só do autor, sem amostra, grupo de controle ou medida de legibilidade. O vídeo viral e os comentários entram como sinal de interesse, não como evidência. Clarke também admite que o comportamento inicial pode vir do prompt sobre estar vivo. O autor tem interesse em promover a comunidade Hard Mode e a própria tese.

O que fazer com isso

  • Teste dar ao seu agente um canal de resposta rápida e barato, como um sinal curto de status, enquanto a resposta completa do modelo demora.
  • Ao construir gerações automáticas, monte um loop com validação automática, pontuação por agente e aprovação humana no final, como no fluxo do talk.
  • Ao avaliar a interface de uma IA, observe se o modelo só tenta agradar o usuário e defina critérios de legibilidade antes de aceitar o resultado.
Physical AI's Next Bottleneck Is Finding the Right Video

Robô aprende com vídeo da web, mas só se você achar o trecho certo antes de baixar tudo.

Dados e RAG 16:31 nível ●●○○○ Rafael Levi, Bright Data Assistir no YouTube (abre em nova aba)

Em 3 frases

Rafael Levi, da Bright Data, diz que o modelo de IA para robôs já existe e que o gargalo agora são os dados: há trilhões de palavras para LLMs, mas só cerca de um milhão de vídeos de robôs.

Gravar pessoas sob instrução gera movimento artificial, simulação ainda erra a física e teleoperação não escala, então ele propõe usar os bilhões de horas de vídeo real da web.

A proposta da empresa é buscar primeiro e coletar depois: indexar mais de 1 bilhão de vídeos por ação e devolver por API clipes já cortados, com timestamp, nota de similaridade e contagem de quadros.

Antes de ler

Mais 1 termo

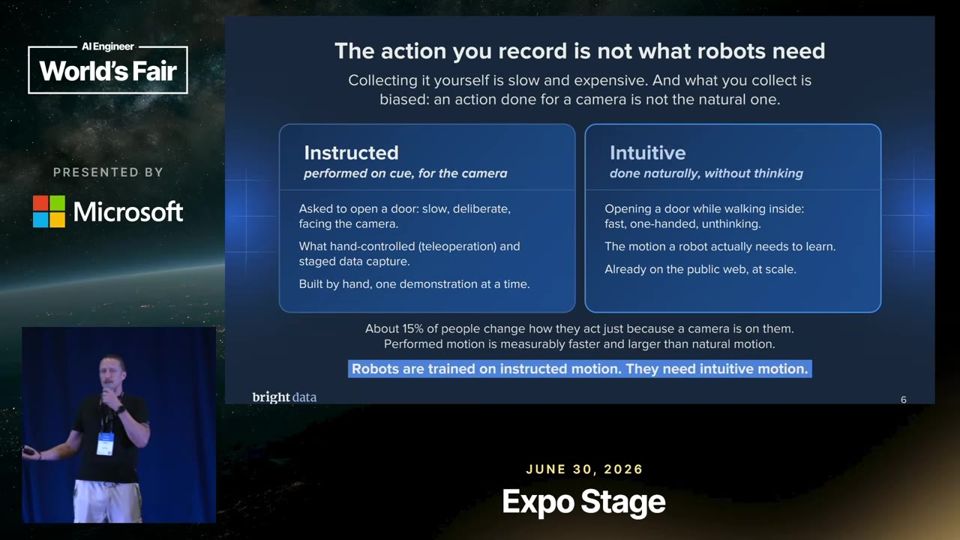
Dado gravado sob instrução sai enviesado

Empresas pagam pessoas para gravar ações como abrir uma porta. Levi argumenta que quem recebe a ordem de se filmar não se move como quem entra em casa no dia a dia. Ele chama isso de dado instruído e presume que o robô treinado com ele rende menos. É uma hipótese dele, sem teste mostrado no palco.

Contraste entre movimento instruído e movimento espontâneo.03:15

Vídeo público reduz a necessidade de dado de robô

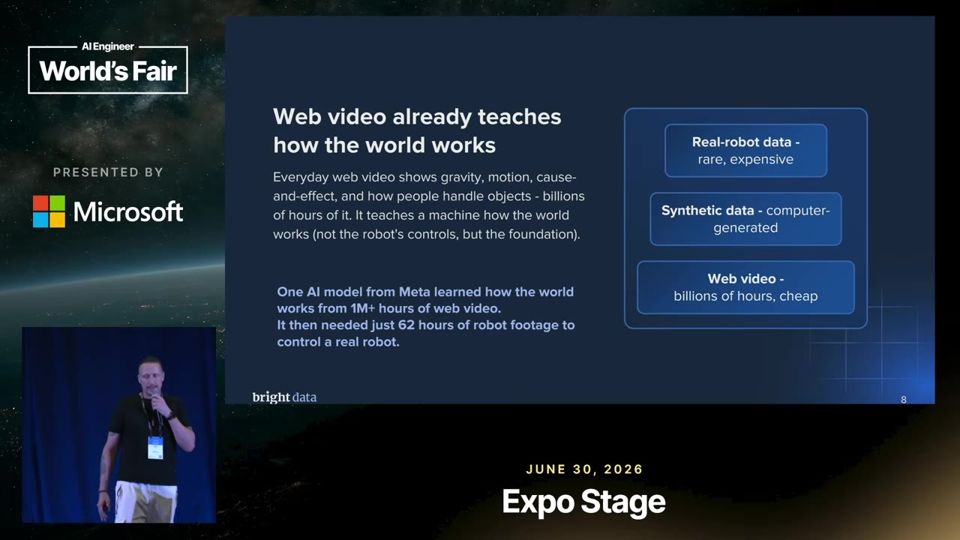
Levi cita um modelo da Meta treinado com cerca de um milhão de horas de vídeo do mundo real. Depois disso, bastaram 62 horas de dados reais de robô para controlar um robô de verdade. A conclusão dele é que vídeo aberto ensina o geral e pouca teleoperação basta para o ajuste final.

Um milhão de horas de vídeo contra 62 horas de robô.06:17

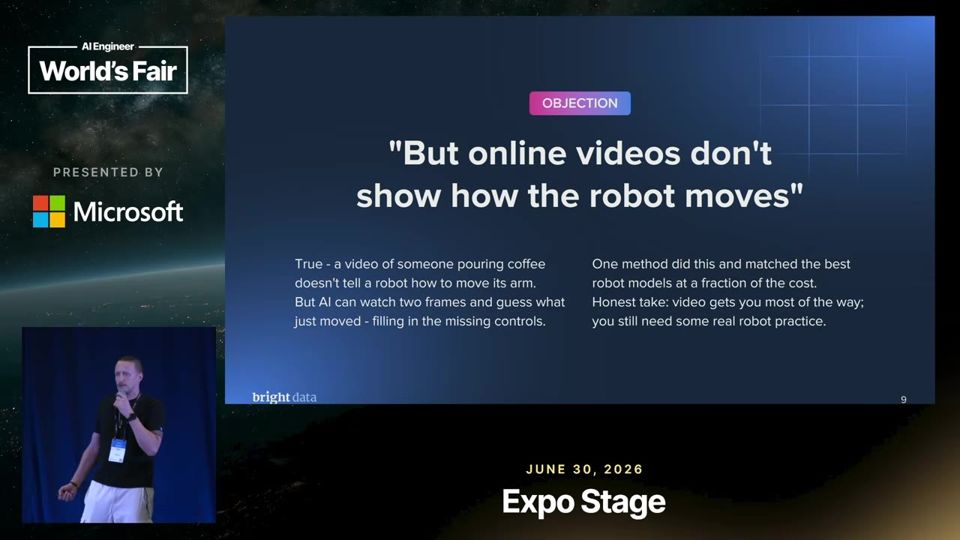
A IA extrai movimento comparando quadros

Vídeo não traz sensores do robô. Levi explica que a IA compara dois quadros seguidos, mede a pequena diferença entre eles e repete isso no vídeo inteiro para estimar ângulos e distâncias. Ele admite que o vídeo bruto não leva a 100% e ainda exige processamento extra.

Movimento entre quadros substitui o dado de sensor.07:00
Mais 2 ideias deste talk

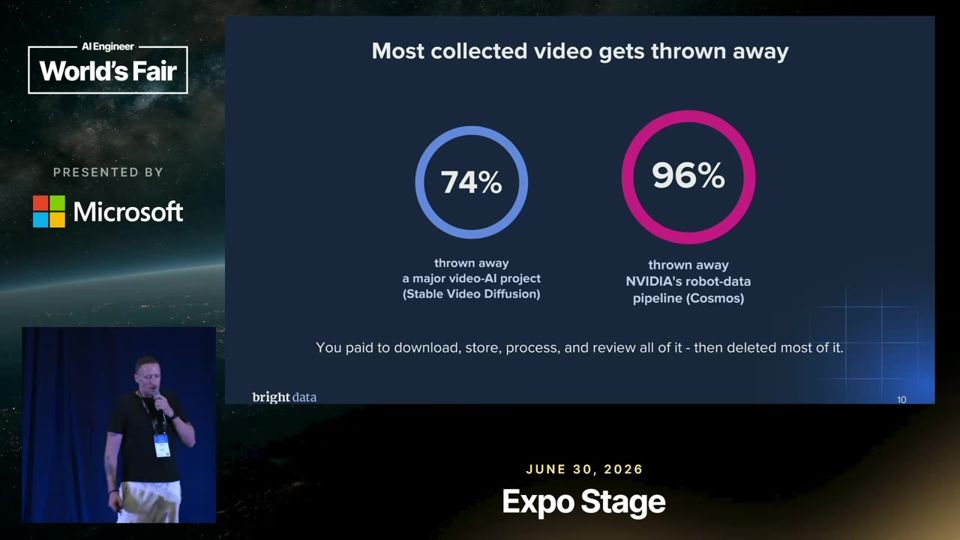
Baixar tudo e descartar é caro

Segundo Levi, a NVIDIA descarta cerca de 96% do vídeo que baixa para treinar o Cosmos, e o Stable Video Diffusion descarta 74%. Isso gasta processamento, banda e armazenamento. A saída que ele vende é buscar o trecho da ação antes de coletar, em vez de filtrar depois.

96% e 74% do vídeo baixado vão para o lixo.07:58

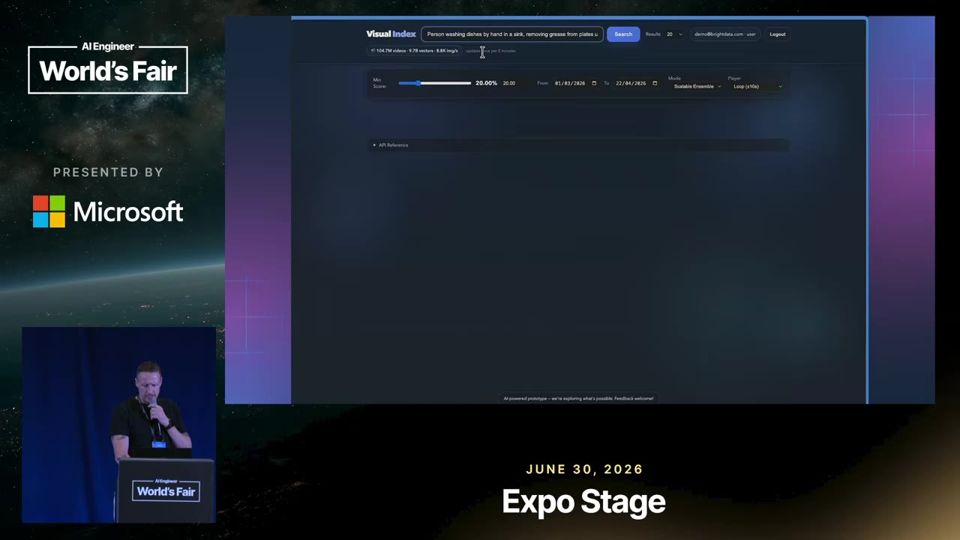
Busca por ação devolve clipes prontos

Na demo, ele digita uma descrição como pessoa lavando louça à mão e o sistema devolve trechos de vídeo cortados. A busca cobre 1,1 bilhão de vídeos indexados por ação, não por título. Ele avisa que alguns resultados fogem do pedido e que descrição mais detalhada melhora o retorno.

A demo mostra clipes achados pela ação, com alguns fora do alvo.10:03
leitura crítica

É palestra de produto da Bright Data. Os números de descarte (96% e 74%) e o caso da Meta vêm sem fonte no palco. A promessa de que dado de vídeo natural supera o gravado sob instrução é suposição declarada ("in my assumption"), sem teste. Faltam medidas de precisão da busca: a própria demo admite resultados fora do tema. Não há discussão de direitos de uso dos vídeos nem de custo.

O que fazer com isso

  • Se você compra ou coleta dados de treino, meça a fração descartada depois do filtro antes de escalar o download.
  • Peça a qualquer fornecedor de busca de vídeo uma amostra com taxa de acerto por consulta, não só uma demo.
  • Antes de usar vídeo público como dado de treino, verifique com o jurídico os termos das plataformas de origem.

One Operator, Many Drones: Inside Skydio's Autonomy Stack

Para um operador comandar uma frota de drones, a Skydio divide a inteligência entre borda e nuvem e dá ferramentas a um agente.

Agentes 20:47 nível ●●●○○ Suchet Bargoti, Skydio Assistir no YouTube (abre em nova aba)

Em 3 frases

Suchet Bargoti abre com uma demonstração ao vivo em que lança drones em docas na Califórnia e no Colorado a partir de um laptop e manda todos voltarem para a base.

Ele explica a pilha de autonomia da Skydio, com reação rápida no drone, planejamento pesado na nuvem, mapas que a frota atualiza e um modelo de visão e linguagem que acha e segue um alvo usando ferramentas.

Ele defende que aprendizado end-to-end (de ponta a ponta) ainda falha em observabilidade e garantia de confiabilidade, então a empresa troca regras escritas à mão por agentes com ferramentas de alto nível.

Antes de ler

Mais 2 termos

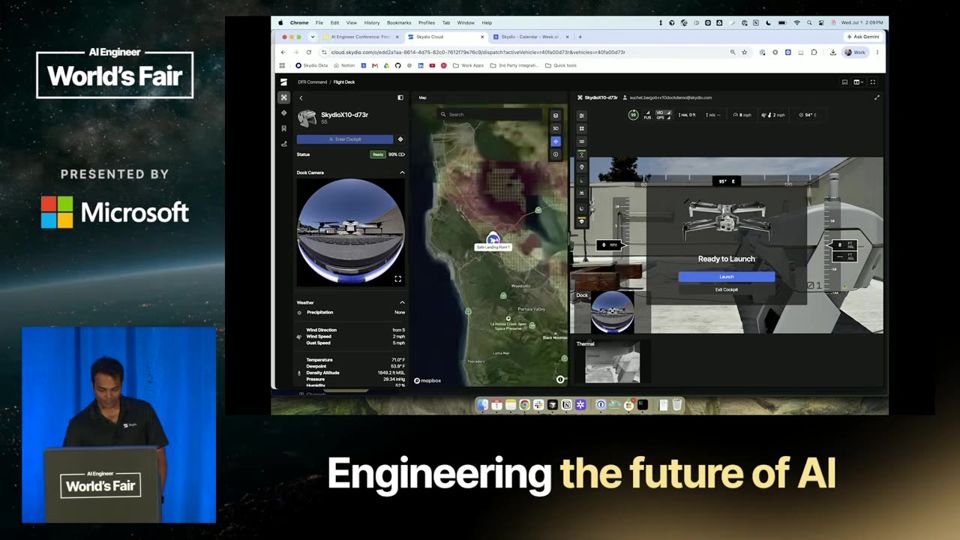
Um operador, vários drones ao mesmo tempo

Do laptop, Bargoti lança um drone perto de San Mateo, outro no Colorado e um terceiro na sede, e manda um deles seguir um carro sozinho. Ele diz que pilotar um drone por pessoa não escala quando chegam mais chamadas e alertas. A proposta é comandar a frota por objetivo, sem se preocupar com o voo.

Um operador controla drones em estados diferentes ao mesmo tempo.00:44

Inteligência dividida entre borda e nuvem

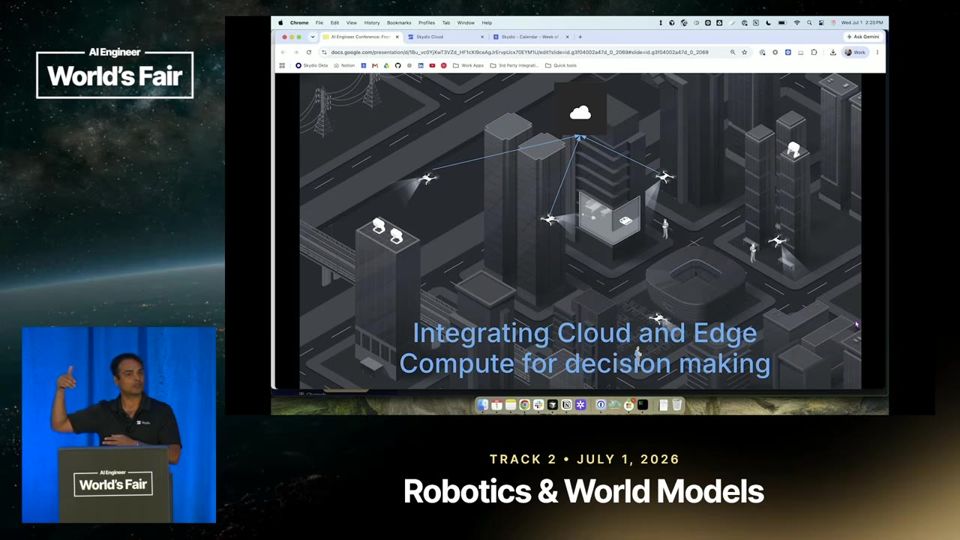
As ações imediatas acontecem no drone, o chamado edge (borda). O vídeo e a telemetria sobem para servidores na nuvem, onde GPUs rodam planejamento de prazo mais longo. O talk mostra que isso exige comprimir vídeo com boa qualidade em redes de pouca banda.

O que roda no drone e o que roda nos servidores.11:42

Mapas como modelos do mundo mantidos pela frota

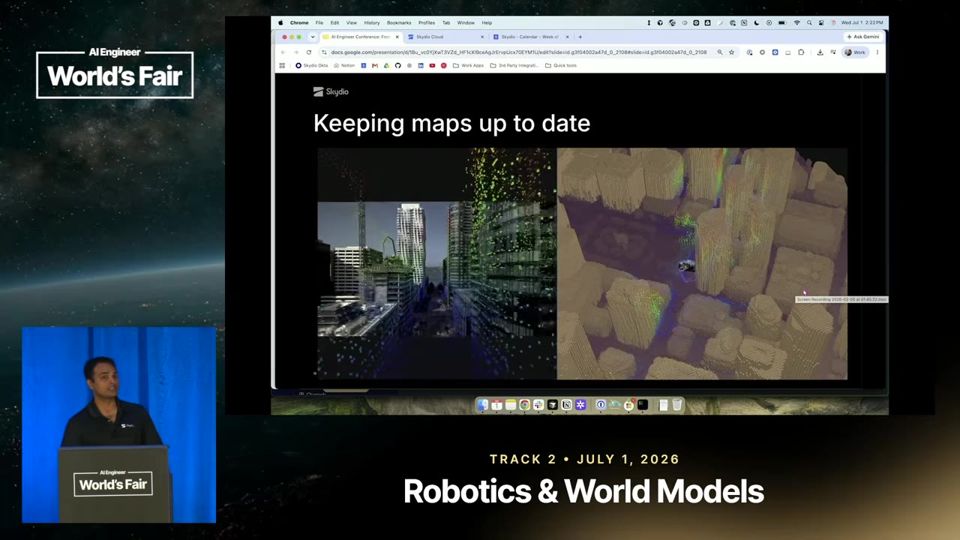
O drone navega sobre um mapa que junta dados de prédios e dados vetoriais, como linhas de energia e estradas. Quando o voo revela algo novo, como um canteiro de obras, a observação volta para o processo de sincronização e toda a frota recebe o mapa atualizado na iteração seguinte.

O mapa desatualizado aparece como desalinhamento no vídeo.13:51
Mais 2 ideias deste talk

Agente com modelo de visão e linguagem acha e segue alvo

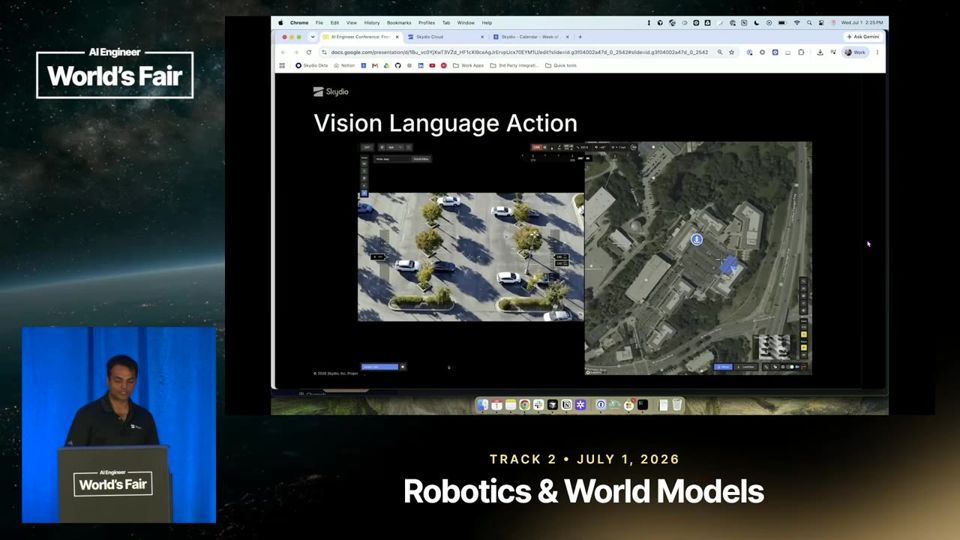
O usuário digita 'look for a white jeep' e o VLM (modelo de visão e linguagem) usa uma API do drone para definir a trajetória, detecta o carro e chama ferramentas de rastreamento. Nenhuma regra específica foi codificada para esse caso. O agente recebe as ferramentas e o contexto e decide.

Um pedido em texto vira busca e perseguição sem regras escritas à mão.16:58

Por que o end-to-end ainda não basta

Bargoti diz que a Skydio testa aprendizado por reforço e entrada de sensor bruta, mas sistemas físicos exigem muitos noves de confiabilidade. Num modelo end-to-end fica difícil observar o que deu errado e garantir o comportamento. A empresa migra por partes, começando pelos trechos cheios de regras feitas à mão, como a busca e resgate.

O limite atual do aprendizado de ponta a ponta em máquinas físicas.18:31
analogia

End-to-end learning (aprendizado de ponta a ponta, do sensor à ação). Aprendizado de ponta a ponta é como um cozinheiro que aprende a fazer o prato só provando o resultado final, sem receita escrita nem etapas separadas que alguém possa conferir no meio.

  1. Um sistema tradicional divide a tarefa em etapas separadas, como enxergar, planejar e agir, e pessoas escrevem regras para cada uma.
  2. No end-to-end learning (aprendizado de ponta a ponta), um único modelo recebe o dado bruto do sensor, como a imagem da câmera, e devolve direto a ação, como para onde o drone vai.
  3. O modelo aprende sozinho com muitos exemplos ou por reinforcement learning (aprendizado por reforço), em que ganha recompensa quando acerta e ajusta o próprio comportamento.
  4. O problema em máquinas físicas é a observabilidade: quando algo dá errado, fica difícil saber em qual parte interna do modelo o erro nasceu.
  5. Por isso a Skydio migra por partes, trocando primeiro os trechos cheios de regras escritas à mão, como a busca e resgate, por agentes com ferramentas de alto nível.
SENSOR BRUTOImagem e dados da câmera do drone
MODELO ÚNICOAprende tudo junto, difícil de auditar
AÇÃOPara onde o drone vai ou aponta

Ajuda saber antes: Rede neural, Aprendizado por reforço, Sistema modular, Observabilidade

leitura crítica

O talk funciona como pitch da Skydio. A demonstração ao vivo impressiona, mas mostra um caso que deu certo, sem taxa de falha, sem custo por missão e sem número de intervenções humanas. A meta de 99,9999% de confiabilidade vem sem detalhe do método de simulação. O exemplo do jipe branco é uma demo curta e não prova robustez em cenas difíceis. O 16 milhões de pessoas mede alcance geográfico, não resultado de segurança. O palestrante também vende vagas ao final.

O que fazer com isso

  • Ao desenhar um agente, liste as ferramentas de alto nível que ele precisa (buscar, seguir, pousar) em vez de escrever regras para cada caso.
  • Separe o que precisa de resposta imediata local do que aceita 1 a 2 segundos de espera numa nuvem mais potente.
  • Registre os casos em que o sistema fez algo diferente do esperado e use esses registros como base de reavaliação, como no ciclo de dados descrito.
  • Antes de adotar um modelo end-to-end em processo crítico, exija forma de observar falhas e medir confiabilidade.

Robot Demos Are Easy. Reliability Is Hard

Robô que acerta 80% rende bom vídeo e produto ruim. Um modelo de recompensa achou os erros e levou o Dyna-1 a 99,4%.

Modelos 26:41 nível ●●●○○ Jason Ma, Dyna Robotics Assistir no YouTube (abre em nova aba)

Em 3 frases

Jason Ma, da Dyna Robotics, diz que robôs generalistas hoje acertam de 80 a 90% das tentativas, o que basta para vídeo de demonstração e não basta para uso comercial.

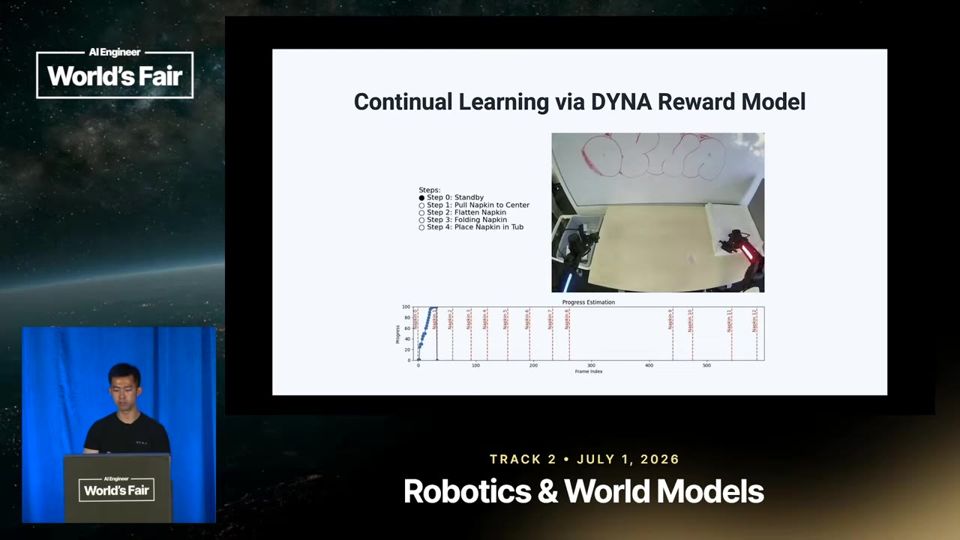
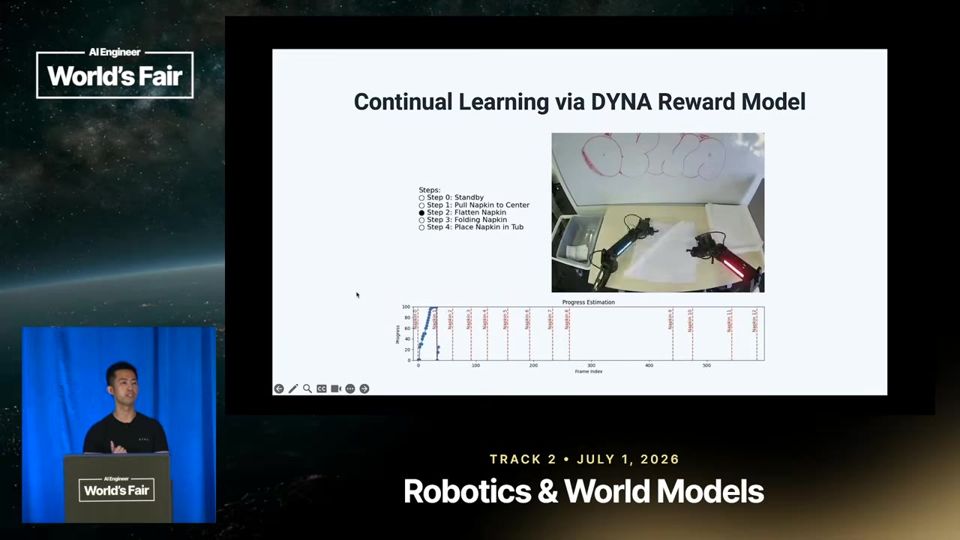
A Dyna treinou um reward model (modelo de recompensa) que assiste ao robô e dá uma nota de progresso. Quando a nota cai, há um erro, e a equipe coleta dados de recuperação só para aquele caso e refaz o fine-tuning (ajuste fino).

Com esse ciclo, o Dyna-1 dobrou guardanapos de restaurante com 99,4% de sucesso em 24 horas, e a mesma receita já roda em restaurantes, numa lavanderia e num evento com 3 dias de camisetas sem dados do local.

Antes de ler

Mais 2 termos

Pirâmide de dados de pré-treino

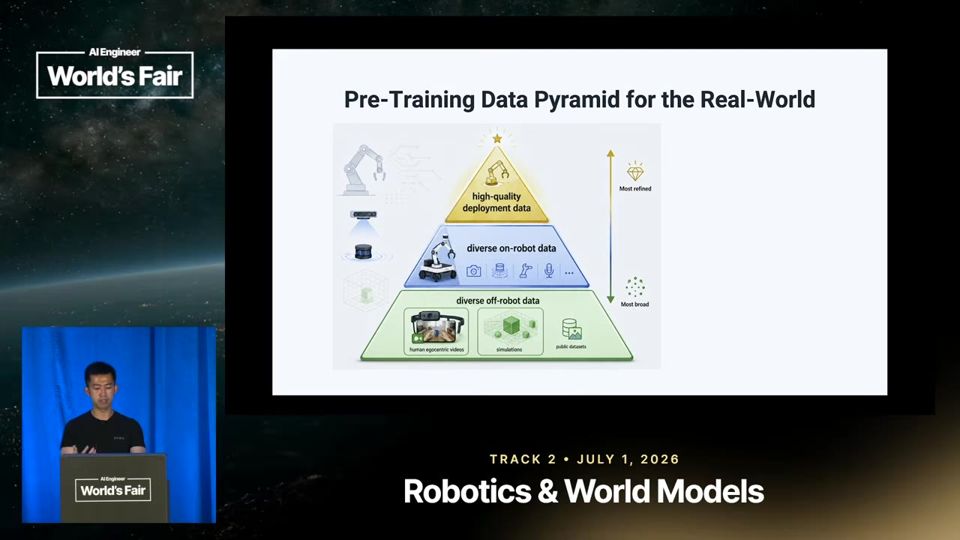
Dados de robô são raros, então a Dyna mistura três camadas. Na base, dados sem robô, como vídeos de humanos com câmera, bases públicas e simulação. No meio, tarefas variadas feitas no robô. No topo, dados de implantação real, que reduzem a diferença entre o laboratório e o cliente. O pipeline soma mais de 200 mil horas.

As três fontes de dado que sustentam o pré-treino do modelo.03:20

A nota de progresso cai quando o robô erra

O reward model olha o vídeo e dá uma nota de 0 a 1 para o avanço da tarefa. Enquanto o robô dobra bem, a curva sobe de forma constante. Quando ele erra, como no nono guardanapo, a curva mostra uma queda. Essa queda vira o sinal automático de falha.

A queda na curva marca o instante exato do erro do robô.12:32

Supervisão escalável e active learning

Acima de 90% de acerto, vigiar o robô à mão fica ineficiente. O reward model roda em segundo plano e sinaliza os vídeos em que o modelo falha. A equipe grava dados de recuperação só para esses casos, refaz o fine-tuning e repete. Depois de alguns ciclos, o modelo se recupera de erros variados.

O ciclo que sai de 80% e chega perto de 100% de sucesso.13:32
Mais 2 ideias deste talk

Recuperação de erro que ninguém gravou

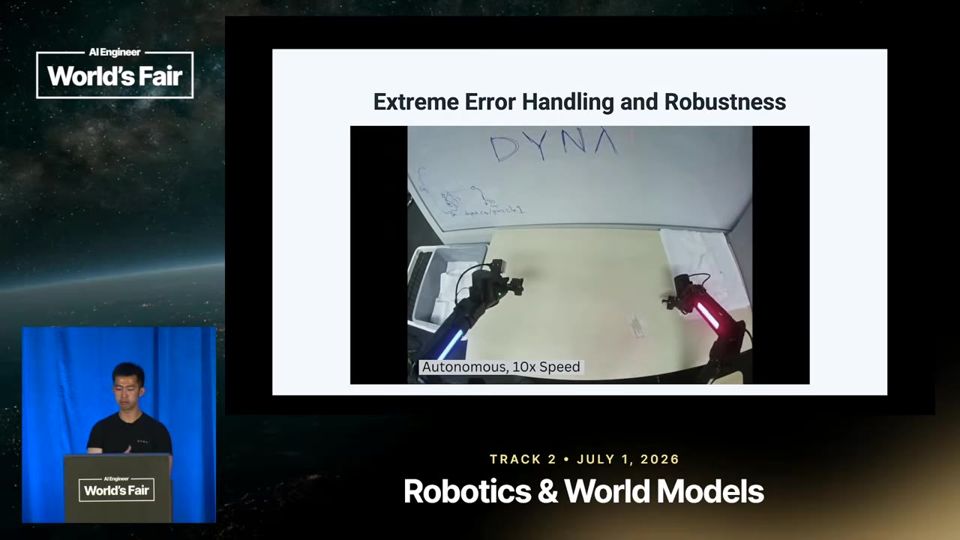
Um guardanapo é um objeto deformável, com estados quase infinitos, e não dá para coletar dado de todo erro possível. Mesmo assim, o robô derrubou a pilha inteira e se recuperou puxando e esticando os guardanapos. Ma atribui isso à generalização de comportamentos de recuperação aprendidos em outras tarefas.

O robô se recupera de um erro grande que não aparece nos dados de treino.15:05

Três dias de camisetas num local novo

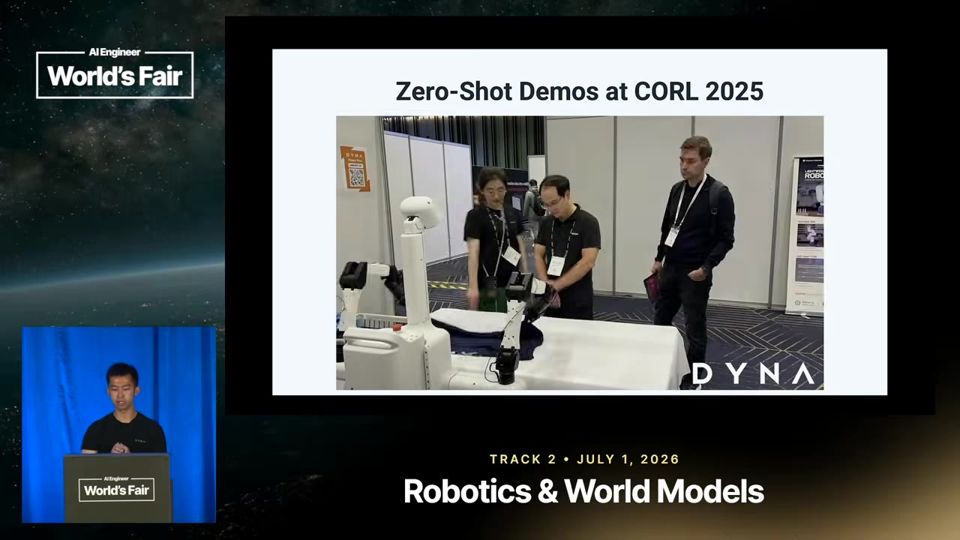
Até aqui a Dyna coletava dados no próprio cliente. No CoRL 2025, na Coreia, o robô foi posto no estande e dobrou camisetas por 3 dias sem dados do local, mesmo com visitantes tentando atrapalhar e cobrindo a câmera. A meta de mercado é ligar o robô no cliente e ele funcionar.

A demonstração mostra generalização para um ambiente que o robô nunca viu.17:15
analogia

World action model (modelo de mundo e ação). Um world action model é como as mãos de um cozinheiro experiente, que ajustam o corte a cada segundo prevendo como o alimento vai ceder, enquanto o chefe só decide qual prato sai agora.

  1. Para fazer uma tarefa física, o robô precisa entender o que fazer e também mover braços e dedos com precisão. A Dyna separa esses dois trabalhos em duas partes do modelo.
  2. A parte de cima é um modelo de raciocínio (reasoning model). Ela olha a cena, entende a tarefa e decide o próximo passo, como pegar o guardanapo de cima da pilha.
  3. A parte de baixo é o world action model (modelo de mundo e ação). Ela recebe esse objetivo e gera os movimentos finos das mãos, muitas vezes por segundo.
  4. Em geral, o nome junta duas ideias. Um world model (modelo de mundo) aprende a prever como as coisas mudam após um gesto, e o lado de ação transforma essa previsão em comandos para os motores.
  5. A alta frequência importa porque um tecido muda de forma a cada toque. O robô corrige o gesto em frações de segundo, e o modelo de raciocínio seria lento demais para esse ajuste.
CÂMERA E SENSORESImagem da cena e pedido da tarefa
MODELO DE RACIOCÍNIOEntende a cena e escolhe o passo
WORLD ACTION MODELPrevê o efeito e calcula o gesto
MÃOS EM MOVIMENTOGestos precisos em alta frequência

Ajuda saber antes: Foundation model de robótica, World model (modelo de mundo), Política de controle de robô

leitura crítica

É a apresentação da própria empresa, que está captando investimento e contratando. Os vídeos são escolhidos por quem os mostra, e os 99,4% vêm de uma tarefa só, com quatro testes de 24 horas no escritório. O talk não dá número de erros nem custo de coleta. A conta do 80 a 90% também não fecha: 0,8 elevado a 10 dá cerca de 11%, e 0,9 elevado a 10 dá cerca de 35%, bem acima dos 0,1% citados. Não há dados sobre o reward model errar ao dar a nota.

O que fazer com isso

  • Ao avaliar um agente ou automação, meça a taxa de sucesso em muitas repetições da mesma tarefa. Uma demo que funciona uma vez esconde a confiabilidade real.
  • Crie um sinal automático de falha, como um avaliador ou uma checagem de resultado, para achar os casos que dão errado sem ler cada execução.
  • Use os erros achados para montar exemplos novos e dirigidos, e refaça o teste. Repita o ciclo em vez de coletar dado em volume sem foco.
  • Ao ler vídeo de robô ou de agente, peça a taxa de acerto e o número de tentativas por trás da cena mostrada.

Robotics Has Been Stuck for 70 Years

Robótica travou por falta de dados e de um cérebro geral, e um modelo para qualquer corpo pode criar essa escala.

Modelos 28:18 nível ●●●○○ Deepak Pathak, Skild AI Assistir no YouTube (abre em nova aba)

Em 3 frases

Deepak Pathak diz que a robótica parece quase pronta há 70 anos porque foi tratada como problema de hardware, sem um cérebro geral e sem uma internet de dados de robôs.

A Skild AI propõe um único modelo para qualquer robô e qualquer tarefa, pré-treinado com simulação e vídeo humano, refinado com teleoperação e alimentado por dados de implantação.

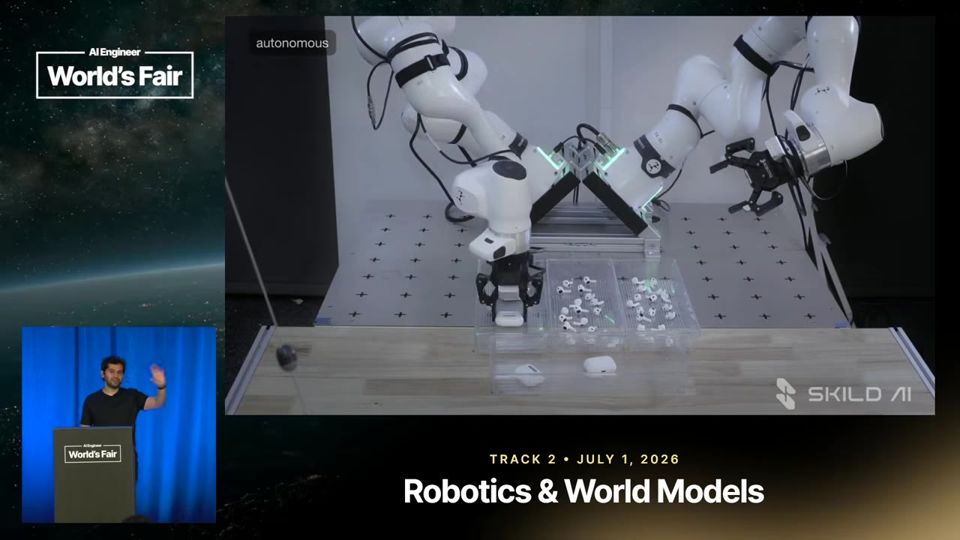
Ele mostra demos de AirPods, omelete, escadas, montagem de GPU e robôs que se adaptam a pernas quebradas, mas sem números de desempenho que permitam comparar.

Antes de ler

Mais 2 termos

Demos de 1957 e de hoje parecem iguais

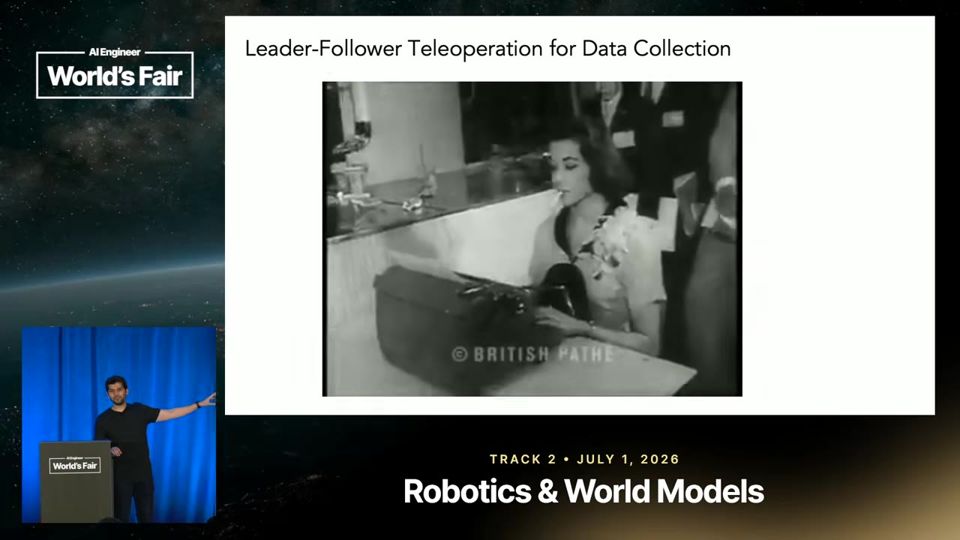
Pathak mostra uma demo de teleoperação de 1957 e outra dos anos 1960 (MIT copy demo) para argumentar que os vídeos de robótica quase não mudaram em 70 anos. Para ele, o gargalo nunca foi o braço mecânico. Faltava um cérebro geral que entendesse o mundo.

A teleoperação usada hoje segue o princípio de 1957.02:40

Três propriedades dos dados de robô

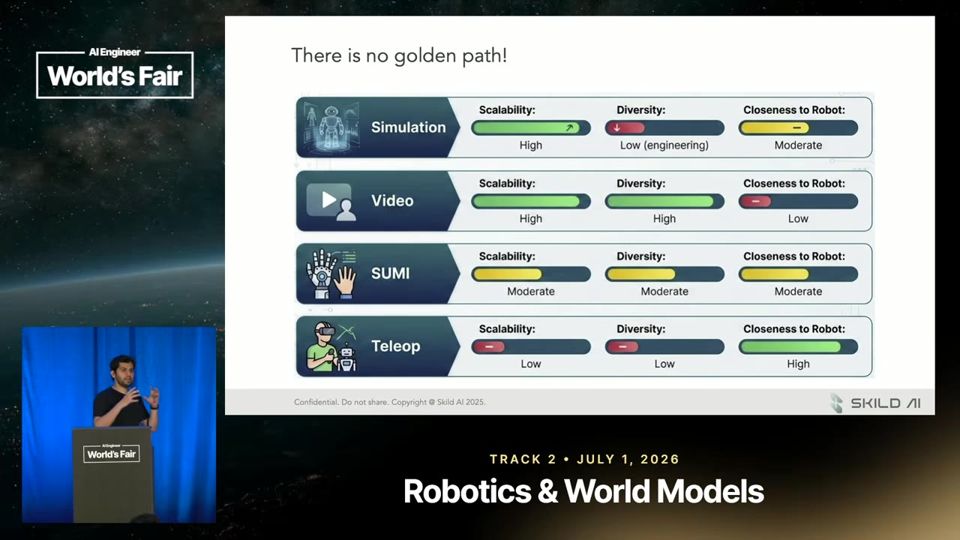
Segundo Pathak, só três coisas importam nos dados de robótica: escalabilidade, diversidade e proximidade dos ângulos das juntas do robô. Simulação escala bem, mas tem pouca diversidade. Vídeo humano escala e diversifica, mas fica longe do robô. Teleoperação fica no meio. Nenhuma fonte resolve sozinha, mas os pontos fracos delas não coincidem.

Cada fonte de dados falha em um eixo diferente.12:25

Pré-treino, pós-treino e o volante de dados

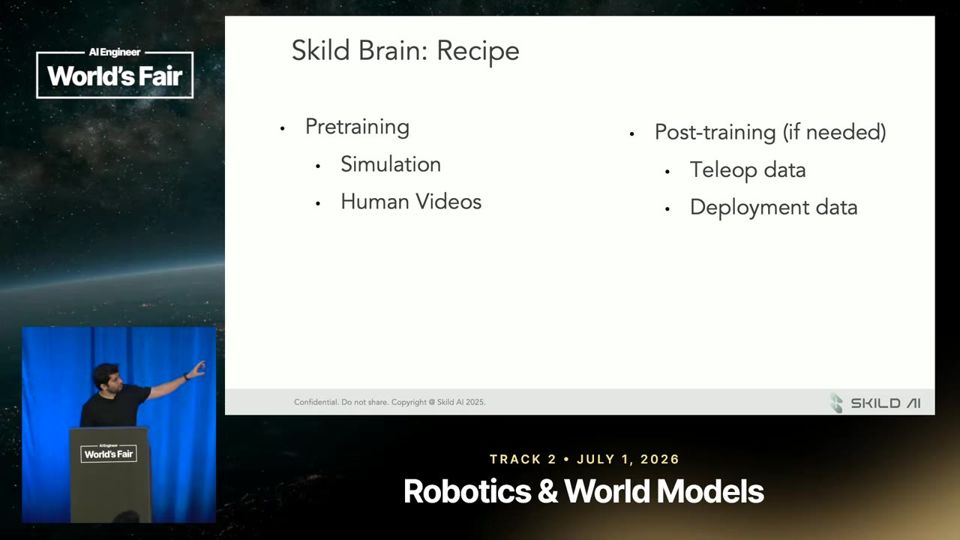
A receita da Skild copia a dos modelos de linguagem. Pré-treina com dados baratos e diversos (simulação, vídeo humano), pós-treina com teleoperação de alta qualidade e coleta dados de implantação, que voltam ao pré-treino. Pathak diz que o cérebro para qualquer corpo é o que torna esse ciclo possível, porque nenhum robô fica parado numa única versão.

O ciclo de dados de implantação é a aposta central da empresa.14:00
Mais 2 ideias deste talk

Dobrar roupa é fácil, inserir AirPods é difícil

Pathak afirma que dobrar camiseta tolera erro alto e por isso é fácil para robótica baseada em aprendizado, embora seja difícil para a robótica clássica. Já inserir AirPods falsos, sem ímã, com garra paralela, exige orientar a peça e inseri-la com precisão. Ele usa o contraste para mostrar o que mede inteligência de verdade.

Precisão numa tarefa difícil, com garra simples e sem ímã.16:30

Escada é mais difícil que mortal para trás

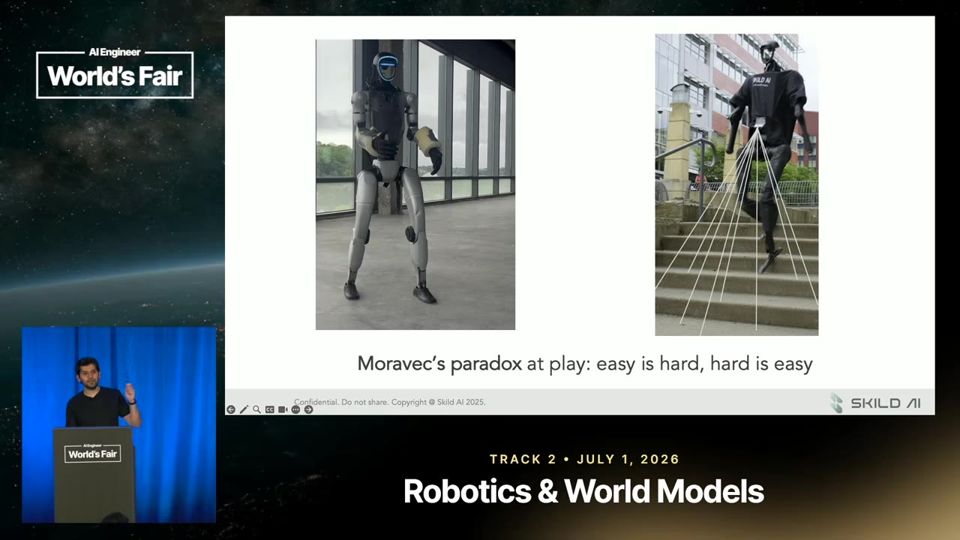
Pathak aplica o paradoxo de Moravec. Um mortal exige conhecer só o próprio corpo, o que o computador simula bem. Subir escada exige ver e se ajustar a perturbações, e isso pede compreensão do ambiente. Segundo ele, o robô sobe escadas usando só a câmera do tronco, sem mapa 3D nem planejamento.

Escada aparece como teste real de percepção, mais que mortal.22:40
analogia

Zero-shot transfer (transferência sem treino adicional). Zero-shot transfer é como um motorista experiente que aluga um carro que nunca dirigiu, numa cidade que não conhece, e sai dirigindo bem sem nenhuma aula extra.

  1. Zero-shot transfer (transferência sem treino adicional) quer dizer colocar um modelo numa situação nova e ele funcionar sem receber nenhum exemplo novo antes.
  2. O caminho comum é outro. Um robô treinado numa sala costuma precisar de mais exemplos para funcionar em outra sala, com outro piso, outra luz e outros objetos.
  3. No zero-shot, o modelo aprendeu padrões gerais durante o treino, com dados muito variados. Por isso ele reconhece o que importa mesmo num cenário que nunca viu.
  4. No talk, Pathak mostra robôs de empresas e hardwares diferentes, todos controlados pelo mesmo cérebro da Skild AI, colocados em cenários novos e resistindo a empurrões sem treino extra.
  5. O teste separa decorar de generalizar. Um modelo que só decorou os exemplos falha no primeiro cenário diferente, e um modelo que generaliza continua funcionando.
TREINO AMPLODados variados de muitos robôs
MODELO GERALAprende padrões que se repetem
CENÁRIO NOVOLugar ou robô nunca visto
AGE SEM AJUSTEFunciona sem exemplos extras

Ajuda saber antes: Generalização, Pre-training e post-training, Omni-bodied brain, Dados de treino variados

leitura crítica

O talk é em boa parte pitch da Skild AI, da qual Pathak é CEO. As demos são vídeos escolhidos pela empresa, sem taxa de sucesso, número de tentativas ou comparação com outros sistemas. Ele mesmo diz que alguns resultados têm mais de um ano e que pulou trechos. A conta de um século para chegar à escala do GPT-3 é uma estimativa dele, sem detalhes do cálculo. A tese de que o corpo importa menos que o cérebro é debatida no campo e aqui aparece sem contraponto.

O que fazer com isso

  • Ao ler anúncios de robôs, pergunte quantas tentativas o vídeo mostra, em quantos ambientes e com quantas horas de dados, antes de aceitar a demo como prova.
  • Use as três propriedades (escala, diversidade e proximidade do robô) como checklist para avaliar qualquer fonte de dados de treino, também fora da robótica.
  • Se sua empresa avalia automação física, priorize tarefas em ambiente bagunçado e com tolerância a erro, onde o talk indica que modelos aprendidos funcionam melhor.

World Models Need Causality, Not Pretty Pixels

Para robôs planejarem, o world model precisa de objetos e causalidade escritos em código; vídeo gerado bonito só imita a aparência.

Pesquisa 51:35 nível ●●●○○ Christopher Manning, Moonlake AI Assistir no YouTube (abre em nova aba)

Em 3 frases

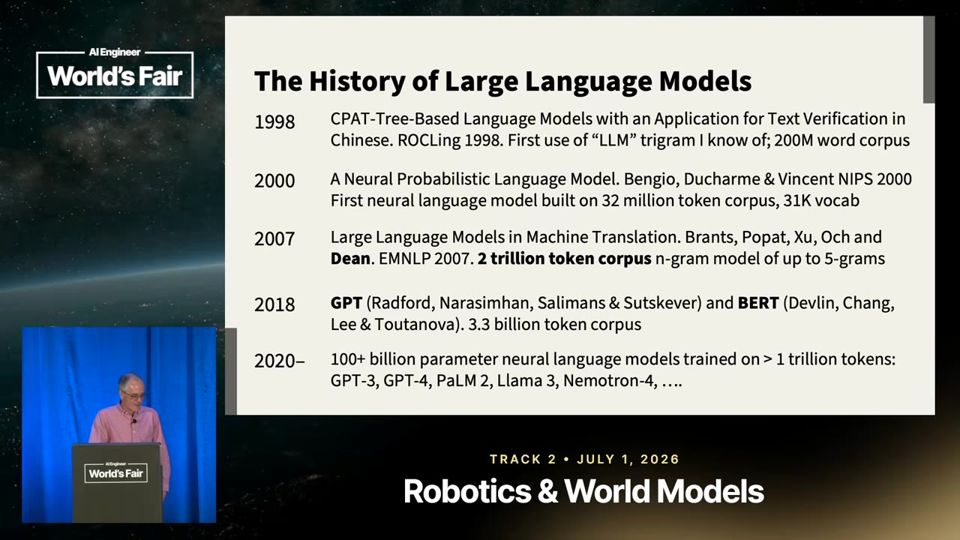
Christopher Manning, professor de Stanford e hoje na Moonlake AI, conta a história da IA e lembra que o Google já tinha um modelo de linguagem com 2 trilhões de tokens em 2007.

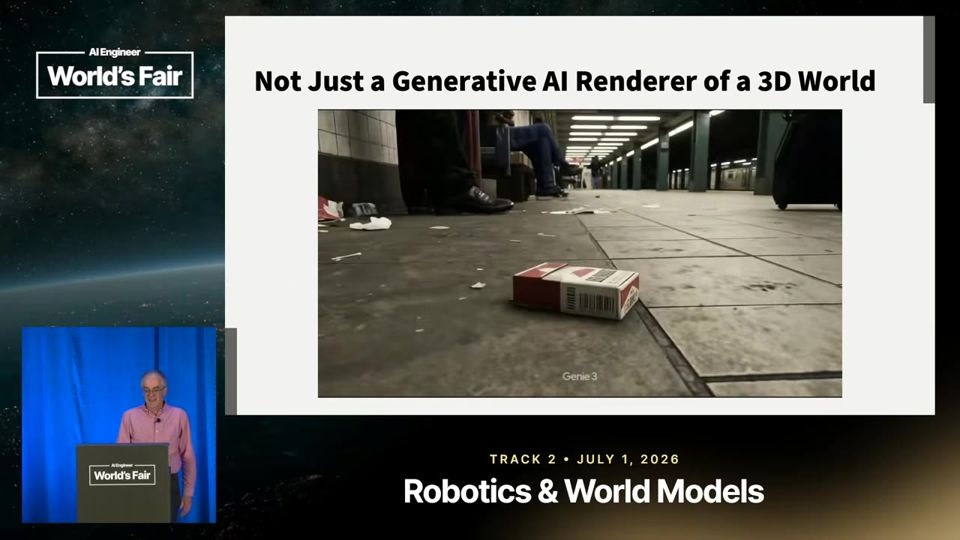
Ele defende que geradores de vídeo como o Genie 3 simulam só a imagem e não servem para planejar ações, porque não representam os objetos e as regras por trás da cena.

A Moonlake transforma uma foto ou um vídeo curto em um mundo simulado em código, com objetos manipuláveis, para trocar milhares de horas de teleoperação de robôs por simulação.

Antes de ler

Mais 2 termos

Escala de dados já existia em 2007

Manning lembra que o Google treinou em 2007 um modelo de linguagem com 2 trilhões de tokens, na mesma ordem de grandeza dos modelos atuais. Faltava arquitetura flexível. O transformer só chegou em 2018, e o primeiro GPT usou bem menos dados. Dados, computação e arquitetura só se juntaram a partir do GPT-3, em 2020.

Os dados em escala vieram antes da arquitetura certa14:47

Treinar robô no mundo real custa caro

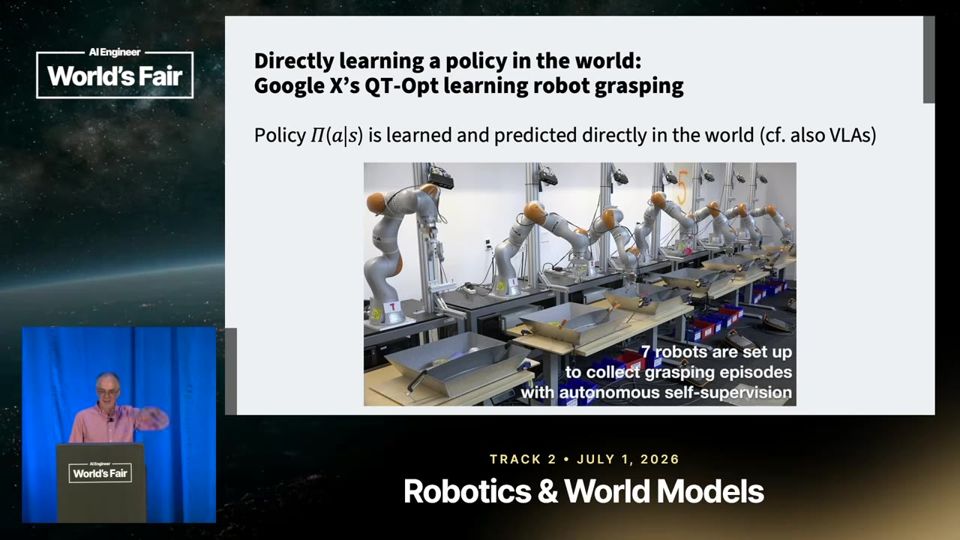
Uma forma de ensinar robôs é coletar dados no mundo físico, como fez o Google X com fileiras de braços robóticos. Isso exige cerca de 10.000 horas de teleoperação (um humano guiando o robô). Manning diz que esse ritmo não leva à robótica geral e propõe simular o mundo no lugar.

Coleta física de dados é lenta e depende de operador humano20:10

Pixels bonitos não bastam para planejar

Um world model (modelo de mundo) útil prevê qual novo estado surge quando uma ação é tomada. O Genie 3 gera vídeo fluido e bonito, mas só simula a observação. Sem uma representação dos objetos e da causalidade por baixo, o sistema não dá base para um robô planejar.

Vídeo gerado convence o olho mas não carrega regras do mundo24:00
Mais 2 ideias deste talk

Completar o que a câmera não vê

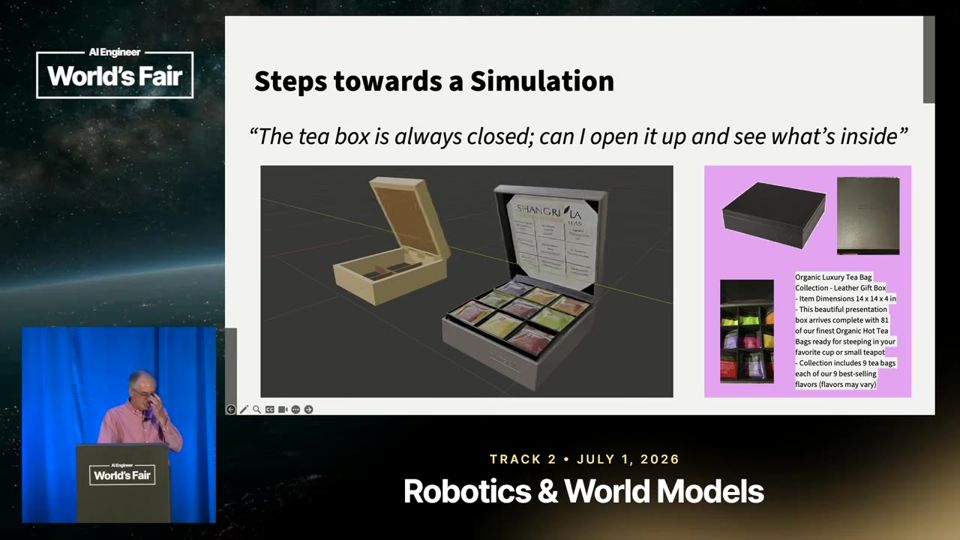
A partir de uma foto de cozinha, o sistema separa o fundo dos objetos que podem ser movidos. Para saber o que há dentro de uma caixa de chá fechada, ele pesquisa o produto na web em estilo RAG (busca de informação para alimentar o modelo), acha fotos e medidas e modela os sachês como objetos que se pode tirar da caixa.

Busca na web preenche partes ocultas da cena simulada29:40

Mundo em código com loop de correção

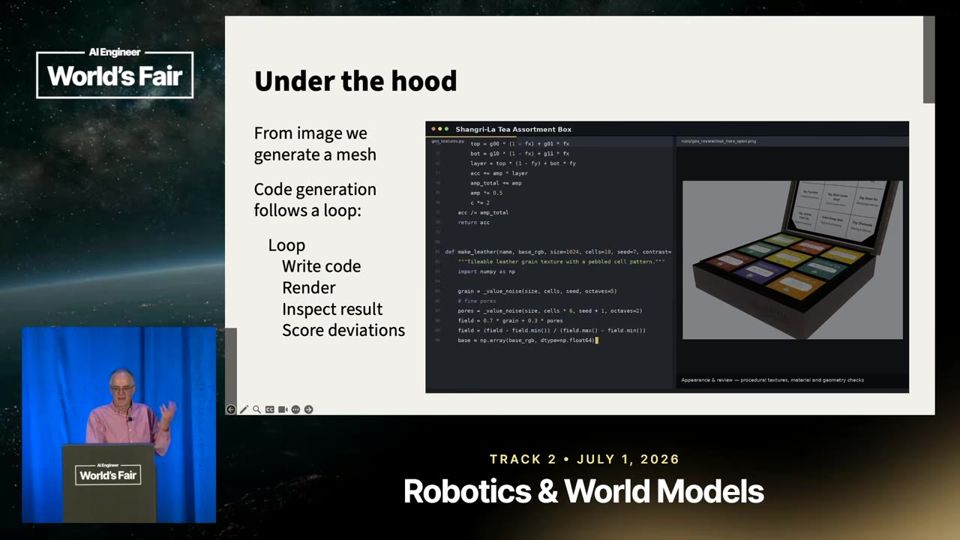
A Moonlake escreve em código as partes controláveis do mundo e aplica texturas geradas por difusão. Um loop inspirado no Claude Code renderiza a cena, compara com a realidade, mede os desvios e revisa o código. A parte simbólica fica fácil de editar e inspecionar por humanos.

O loop de código reduz a distância entre simulação e realidade31:45
analogia

Action-conditioned world model (modelo de mundo condicionado a ações). Um modelo de mundo condicionado a ações é como um motorista experiente que, antes de virar o volante, já imagina onde o carro vai parar.

  1. Pense em empurrar um copo na beira da mesa. Você prevê a queda sem precisar empurrar de verdade.
  2. Um world model (modelo de mundo) faz isso para uma máquina. Ele guarda por dentro uma descrição resumida de como o mundo está agora, chamada estado.
  3. A versão condicionada a ações recebe duas entradas, o estado atual e uma ação, e prevê qual novo estado vai surgir depois dessa ação.
  4. Com essa previsão, o robô testa várias ações na cabeça e escolhe a melhor antes de agir. A ideia vem do reinforcement learning (aprendizado por reforço).
  5. Manning critica geradores de vídeo como o Genie 3 porque eles preveem só a imagem. Sem objetos e regras por baixo, a previsão não serve de base para planejar.
ESTADO ATUALobjetos e onde cada um está
AÇÃOo que o robô pretende fazer
PREVISÃO DO MODELOcalcula o que muda na cena
NOVO ESTADObase para escolher o plano

Ajuda saber antes: World model, Reinforcement learning, Estado e ação, Planejamento

analogia

Neuro-simbólico (rede neural combinada com representação simbólica, como código). Um sistema neuro-simbólico é como uma reforma em que o arquiteto desenha a planta com medidas exatas e o decorador escolhe cores e texturas à vontade.

  1. Uma máquina pode guardar conhecimento de dois jeitos. Um usa regras escritas que qualquer pessoa lê. O outro aprende padrões com exemplos, sem regras explícitas.
  2. O jeito com regras escritas se chama simbólico, como código ou lógica. O jeito que aprende com exemplos se chama neural, feito com redes neurais.
  3. Um sistema neuro-simbólico junta os dois. Na Moonlake, o código descreve os objetos que podem ser movidos, e um modelo de difusão (gerador de imagens) cria as texturas.
  4. Um loop renderiza a cena, compara com a realidade, mede os desvios e revisa o código, no mesmo padrão de agentes de programação como o Claude Code.
  5. Manning destaca que a parte simbólica fica fácil de ler, controlar, editar e manter por humanos, algo difícil de fazer numa rede neural pura.
CÓDIGO DOS OBJETOSparte simbólica, fácil de editar
TEXTURA POR DIFUSÃOparte neural cria a aparência
RENDER E COMPARAÇÃOcena comparada com a realidade
REVISÃO DO CÓDIGOcorrige os desvios medidos
MUNDO MANIPULÁVELobjetos que o robô pode usar

Ajuda saber antes: Rede neural, Modelo de difusão, World model

leitura crítica

Metade do talk é história da IA e a outra metade é apresentação da Moonlake, empresa onde o palestrante trabalha. A demo da cozinha e o vídeo da esteira aparecem sem métricas de transferência para robôs reais. A promessa de 10.000 horas de simulação de graça não vem com resultado medido. A crítica ao Genie 3 e ao Marble compara com produtos concorrentes. O loop que fecha a lacuna com a realidade é descrito, mas não demonstrado.

O que fazer com isso

  • Ao avaliar uma ferramenta de vídeo ou 3D gerado por IA, teste se ela permite agir sobre os objetos da cena antes de usá-la para planejamento.
  • Quando o modelo precisar de informação que não está na entrada, adicione uma etapa de busca na web, como a Moonlake faz com a caixa de chá.
  • Use um loop de gerar, comparar com uma referência real e corrigir para melhorar saídas de IA, no mesmo padrão dos agentes de código.
  • Desconfie de promessas de simulação que substitui dados reais quando o fornecedor não mostra números de transferência para o mundo físico.

Fim da edição

Termos novos no glossário: Action-conditioned world model, End-to-end learning, Neuro-simbólico, World action model, Zero-shot transfer.