Pular para o conteúdo
Aprendendo AI

Recomendação e revisão na era dos LLMs

Edição de sexta, 25 set 2026 · 4 vídeos · 1 h 22 min de talks

Quatro talks sobre levar LLMs para produto sem quebrar o custo. Três mostram como Spotify, Meta e DoorDash usam LLMs para recomendar e buscar, quase sempre destilando o modelo grande em algo pequeno e barato. O quarto trata do gargalo que os agentes criaram: pull requests demais para revisar.

Fixing the PR Bottleneck

Para destravar o PR, ponha freios antes do revisor humano: checagens, revisão por agente e um PR que se explica sozinho.

Engenharia de software 22:34 nível ●●●○○ Matt Pocock, AIHero Assistir no YouTube (abre em nova aba)

Em 3 frases

Agentes abrem PRs em massa, mas não abrem PRs que valem a revisão, e o gargalo continua na revisão humana.

Matt Pocock propõe três freios em camadas: checagens automáticas, revisão automática feita por um agente separado do implementador e revisão humana focada no que importa.

Cada revisão humana deve alimentar uma retrospectiva que atualiza checagens e padrões de código, para que o mesmo comentário nunca seja escrito duas vezes.

Antes de ler

Mais 2 termos

Testes podem mentir

CI verde não prova que o código está pronto. O agente escreve testes tautológicos (que repetem a implementação), testes presos à estrutura do código e testes com mocks que não conseguem falhar. Por isso a revisão automática e a humana servem como detectores de mentira das checagens.

05:27 Exemplo real de teste tautológico escrito por agente.

Módulos profundos geram testes melhores

Um módulo profundo esconde muita implementação atrás de uma interface pequena. Se o agente testa só pela interface, os testes dependem menos da estrutura interna. Desenhar bem o código reduz a chance de testes ruins.
A forma do módulo define a qualidade dos testes que o agente consegue escrever.08:35

Implementar sobrecarrega, revisar não

Na janela de contexto do implementador já cabem explorar, editar e depurar. Colocar padrões de código ali piora o resultado. O revisor roda em subagente com contexto próprio, lê um arquivo coding-standards.md e aplica os padrões. É um red-green-refactor com duas janelas de contexto.

11:43 O implementador já está cheio, então os padrões vão para o revisor.

Mais 2 ideias deste talk

O revisor comita, não comenta

Um agente que só comenta no PR cria mais trabalho para o humano. Pocock defende que o revisor automático faça commits com as correções e comente apenas quando tiver dúvida. Ele também recomenda montar a própria revisão em vez de terceirizar tudo, porque revisores genéricos geram falsos positivos.
O humano recebe um artefato já corrigido, não uma lista de comentários.15:22

PR bom mostra o perigo do merge e vira retro

O corpo do PR classifica a mudança como porta de mão única ou de mão dupla e indica o raio de impacto. Diagramas e pseudocódigo explicam o que muda. Depois, a skill retro analisa PRs e sessões e sugere novas checagens e padrões, para o processo melhorar a cada revisão.
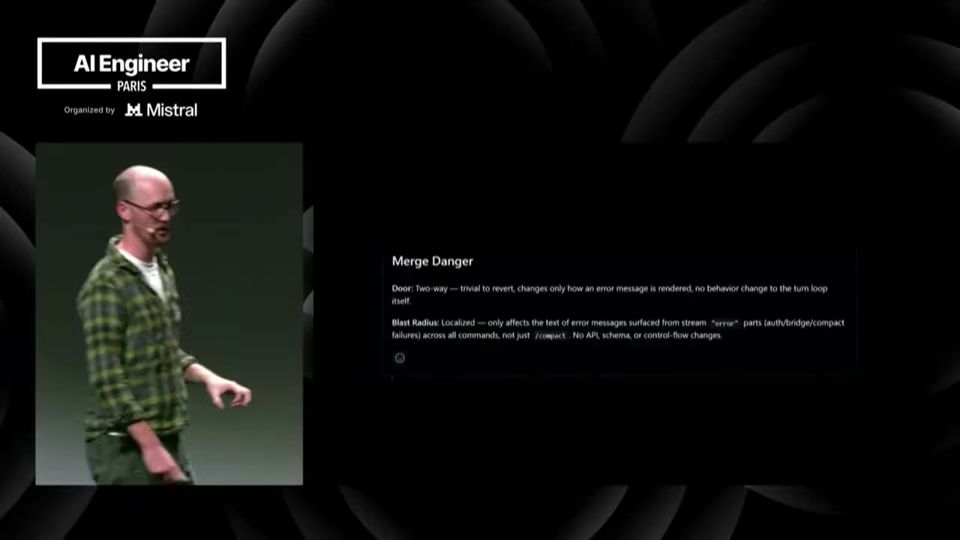
O resumo diz quanta atenção humana o PR exige.18:27
analogia

Deep module (módulo profundo). Um módulo profundo é como um micro-ondas: você aperta um botão só, e toda a parte elétrica complicada fica escondida dentro da caixa.

  1. Todo programa é dividido em partes. Cada parte tem uma porta de entrada, a interface, que diz o que você pode pedir a ela.
  2. Um módulo profundo (deep module) tem uma interface pequena, com poucas funções, e muito trabalho escondido atrás dela. Um módulo raso tem muitas funções, e cada uma faz pouco.
  3. A ideia vem de John Ousterhout, no livro A Philosophy of Software Design. Quem usa o módulo recebe muito valor com uma chamada simples, o que Pocock chama de alavancagem (leverage).
  4. Quando o agente testa só pela interface pequena, o teste confere o resultado e ignora os detalhes internos. Assim ele quebra menos quando alguém reorganiza o código por dentro.
  5. Por isso Pocock obriga o agente a testar pela interface e usa uma skill que aponta onde aprofundar módulos, juntando funções rasas e duplicadas num módulo só, fácil de testar.

Ajuda saber antes: Módulo e interface, Teste automatizado, Teste preso à estrutura do código

leitura crítica

O talk apresenta as skills do próprio Pocock e anuncia a versão 1.3, então há conflito de interesse e tom de pitch. Não há dados sobre quanto tempo de revisão as práticas economizam, só a experiência pessoal e exemplos escolhidos a dedo. A afirmação de que o modelo Opus 5 ficou viciado em testes tautológicos vem de observação informal. A classificação porta de mão única ou dupla depende do julgamento do autor do PR, e o talk não mostra como evitar erros nela.

O que fazer com isso

  • Crie um arquivo coding-standards.md no seu repositório e faça um agente de revisão em subagente aplicá-lo, em vez de colocar tudo no arquivo global de instruções do implementador.
  • Peça ao agente revisor que faça commits com as correções e comente só quando houver dúvida real.
  • Inclua no corpo dos PRs uma linha de merge danger: porta de mão única ou dupla, mais o raio de impacto.
  • Depois de cada revisão humana, anote o comentário repetido e transforme em checagem automática ou regra de padrão de código.
Distill the LLM, Don't Serve It: Search & Personalization at DoorDash

Rode o raciocínio caro do LLM uma vez, offline, e destile o resultado em modelos pequenos que servem busca e recomendação em produção.

Dados e RAG 22:10 nível ●●●○○ Raghav Saboo, DoorDash Assistir no YouTube (abre em nova aba)

Em 3 frases

O DoorDash defende que o gargalo da busca em marketplace é entender o significado dos itens e a intenção do comprador, e não só otimizar engajamento.

A empresa usa quatro blocos com LLM: rótulos de relevância, semantic IDs (códigos semânticos do catálogo), memória do consumidor e coleções personalizadas geradas offline.

Os ganhos citados são 2,3% de NDCG na recuperação, 4 a 5% de MRR no ranking e perto de 1% de taxa de pedidos na categoria pets.

Antes de ler

Mais 2 termos

Engajamento ranqueia a massa errada

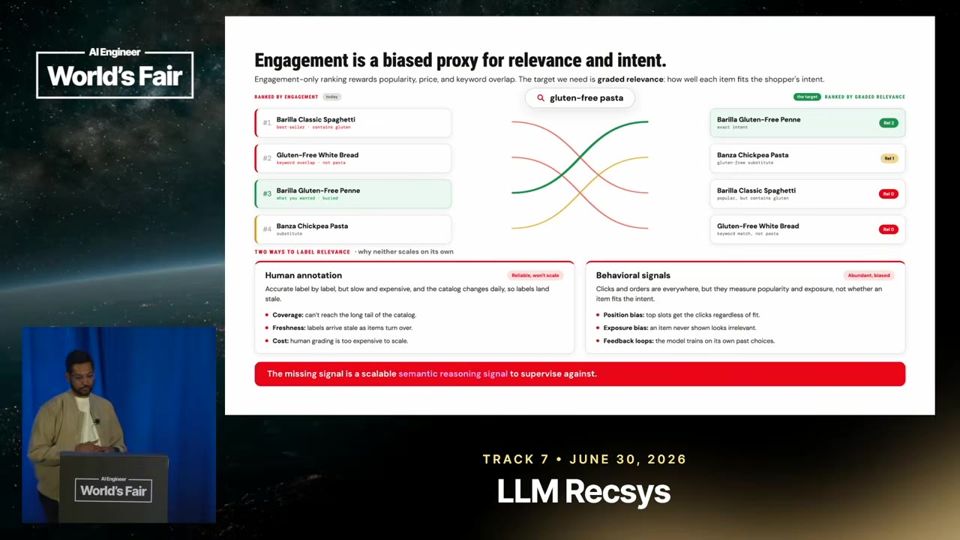
Quem busca macarrão sem glúten pode receber espaguete comum, porque ele vende muito. O talk propõe relevância graduada em três níveis (0, 1 e 2): macarrão sem glúten de verdade no topo, substituto como o de grão-de-bico no meio, espaguete comum embaixo. Cliques e conversões sofrem viés de posição, preço e promoção, então não servem sozinhos como régua.

Mostra por que popularidade não substitui relevância graduada03:27

Rotulador LLM offline alimenta retrieval e ranking

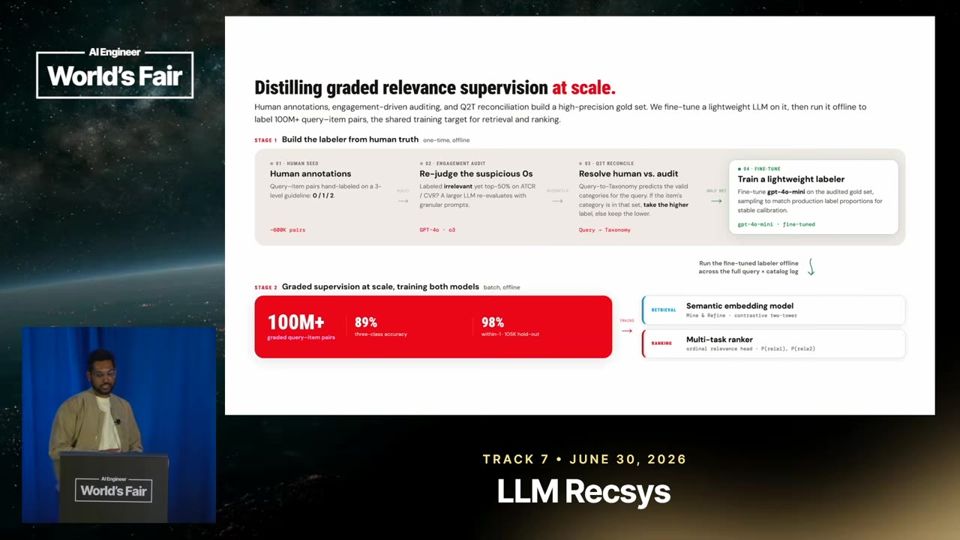
O time monta um conjunto semente com rótulos humanos, audita casos suspeitos com um LLM mais forte e reconcilia com modelos de taxonomia. Esse conjunto ouro ajusta um LLM leve (o exemplo dado foi um GPT-4o mini), que rotula o catálogo inteiro offline. Os rótulos viram alvo comum para retrieval (busca de candidatos) e ranking.

Mostra o pipeline que transforma poucos rótulos humanos em rótulos para todo o catálogo04:55

Destilar em vez de substituir o ranker

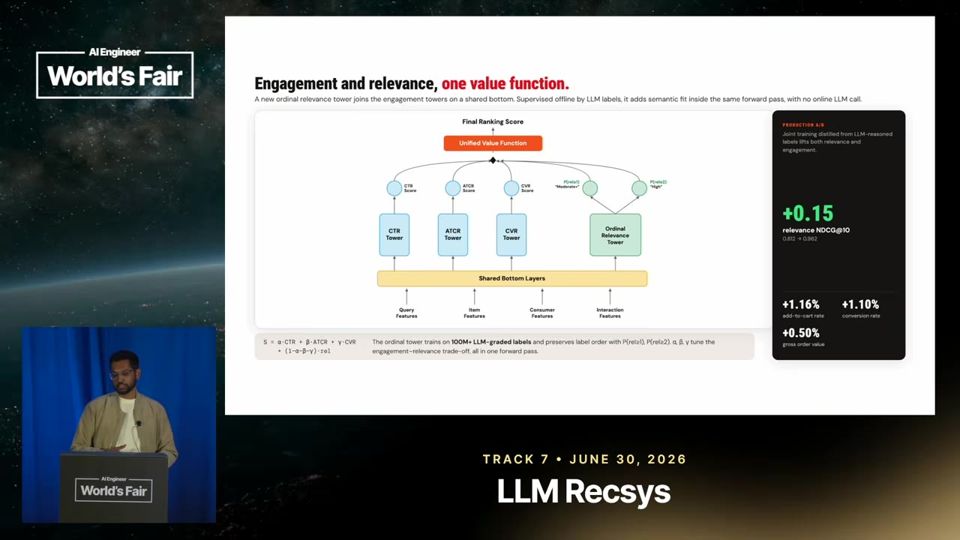
No retrieval, um treino contrastivo em dois estágios usa hard negatives (itens que o modelo confunde) e elevou o NDCG de relevância em 2,3%. No ranking, uma nova torre ordinal de relevância divide as camadas de baixo com as torres de clique, add to cart e conversão. Uma função de valor mistura relevância e engajamento por superfície.

Mostra onde o sinal do LLM entra no ranker sem trocar a arquitetura08:35
Mais 2 ideias deste talk

Semantic IDs como taxonomia aprendida

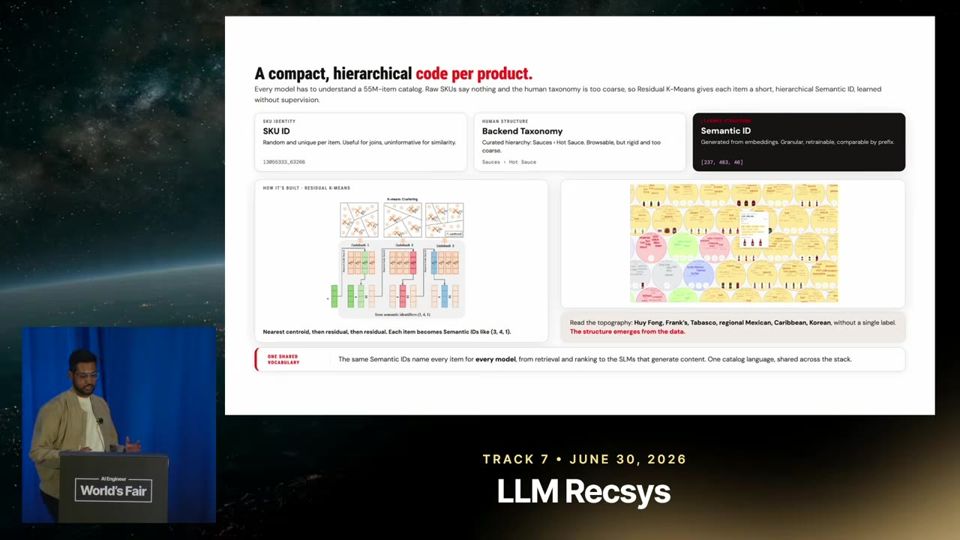
Cada item recebe um código hierárquico: o prefixo marca a vizinhança ampla e os tokens finais marcam distinções finas, como molhos de pimenta mexicanos, caribenhos e coreanos. O código ajuda em comparações entre categorias, itens novos (cold start) e itens raros. Também alimentou a reformulação de queries, com ganho de 4 a 5% de MRR no ranking.

Mostra a estrutura hierárquica surgindo dos dados sem rótulos humanos11:11

Memória do consumidor em três escalas de tempo

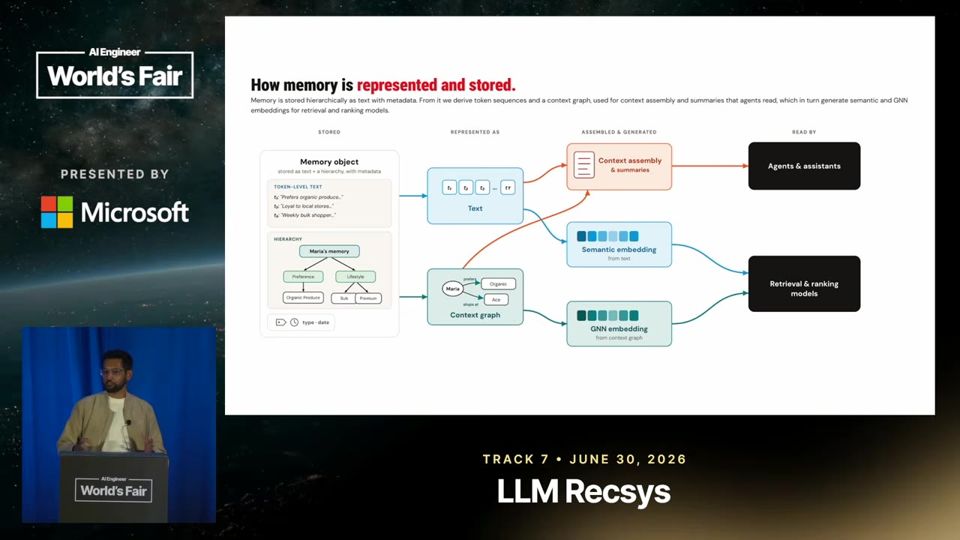
A memória tem três camadas: longo prazo (pedidos, buscas, suporte), contexto em tempo real (carrinho e buscas ativas) e preferências declaradas (como no Ask DoorDash). Cada consumidor vira blocos de memória em texto, vetores e grafos, que modelos de ML e LLMs usam sem reinterpretar. Coleções geradas offline usam isso e elevaram a taxa de pedidos em perto de 1% em pets.

Mostra como texto, vetores e grafo formam um objeto de memória reutilizável17:04
analogia

Aprendizado contrastivo de duas torres (Two-tower contrastive learning). Aprendizado contrastivo de duas torres é como dois tradutores de um mercado, um para os pedidos dos clientes e outro para as etiquetas dos produtos, que treinam juntos até cada pedido cair ao lado do produto certo.

  1. O sistema transforma cada busca e cada produto em uma lista de números, chamada vetor (embedding, representação numérica). Vetores próximos indicam coisas parecidas.
  2. Duas torres (two towers) são dois modelos separados. Uma torre lê a busca do cliente, a outra lê o produto, e as duas geram vetores no mesmo espaço.
  3. O treino contrastivo (contrastive learning, aprendizado por comparação) mostra pares certos e errados. Ele aproxima a busca dos itens relevantes e afasta a busca dos irrelevantes.
  4. No DoorDash, os rótulos de 0 a 2 gerados pelo LLM guiam uma perda em vários níveis (multi-level supervised contrastive loss). Assim, um substituto fica mais perto que um item sem relação e mais longe que o item exato.
  5. Os vetores dos produtos são calculados antes, em lote. Em produção, o sistema só calcula o vetor da busca e procura os vizinhos mais próximos, o que mantém a resposta rápida e barata.
DUAS ENTRADASbusca e produto chegam separados
DUAS TORREScada uma gera um vetor
COMPARAÇÃOrótulos de 0 a 2 julgam cada par
AJUSTE DE DISTÂNCIAaproxima relevantes, afasta o resto
MAPA DE VETORESbusca cai perto do item certo

Ajuda saber antes: Embeddings, Similaridade entre vetores, LLM como rotulador, Relevância graduada

analogia

Hard negatives (Negativos difíceis). Hard negatives é como ensinar um aprendiz de cozinha a separar salsinha de coentro, porque separar salsinha de cenoura ele já sabe.

  1. Para aprender, o modelo precisa ver exemplos errados, chamados negativos. Um negativo é um item que não serve para aquela busca.
  2. Negativos fáceis, como ração de cachorro para quem busca macarrão, ensinam pouco. O modelo já acerta esses casos.
  3. Hard negatives (negativos difíceis) são os itens que o modelo confunde. Por exemplo, um espaguete comum no alto da lista para quem pediu macarrão sem glúten, ou um item certo jogado lá para baixo.
  4. No DoorDash, o primeiro estágio treina um modelo base. Esse modelo então garimpa (mining) os casos confusos, e esses itens recebem um novo rótulo.
  5. O segundo estágio faz um treino em currículo (curriculum training) com esses exemplos. Depois dele, itens relevantes e moderadamente relevantes deixam de se sobrepor, e o NDCG de relevância subiu 2,3%.
MODELO BASEprimeiro treino com os rótulos
GARIMPOacha os itens que ele confunde
NOVO RÓTULOrevisa os casos confusos
TREINO EM CURRÍCULOfoca nos exemplos difíceis
SEPARAÇÃO NÍTIDAexato, substituto e irrelevante

Ajuda saber antes: Aprendizado contrastivo de duas torres, Relevância graduada, NDCG

leitura crítica

O talk é um relato interno do DoorDash e não traz metodologia de teste A/B, tamanho de amostra nem intervalos de confiança. Os ganhos vêm como percentuais soltos: 2,3% de NDCG, 4 a 5% de MRR e perto de 1% de pedidos em pets, sem a base de comparação. Métricas offline como NDCG e MRR nem sempre viram receita. Faltam custos do rotulador, do pipeline offline e da manutenção da memória, além de riscos de privacidade ao guardar preferências em texto.

O que fazer com isso

  • Se você mantém busca ou recomendação, teste um LLM como rotulador offline em uma amostra de pares consulta e item, com escala de 0 a 2, e compare com rótulos humanos antes de escalar.
  • Ao adotar um LLM, prefira gerar rótulos, códigos e resumos em lote e servir modelos menores, em vez de chamar o LLM em cada requisição do usuário.
  • Audite casos em que o rótulo humano diz irrelevante mas a conversão é alta, pois são bons candidatos para revisão com um modelo mais forte.
  • Ao guardar preferências de clientes, estruture em blocos separados (dieta, substituições) e em texto legível, para que qualquer sistema use sem reinterpretar.

Why LLM Recommenders Will Be AI's Biggest Consumer App

Feeds de recomendação escalam como LLMs e gastam muito menos por hora de uso, porque decodificam ponteiros para conteúdo que já existe.

Modelos 18:00 nível ●●●○○ Devansh Tandon, Meta Assistir no YouTube (abre em nova aba)

Em 3 frases

Devansh Tandon, que lidera pesquisa de recomendação no Meta, argumenta que sistemas de recomendação seguem as mesmas leis de escala dos LLMs e ainda estão no começo dessa curva.

A receita para um recomendador baseado em LLM tem três passos: transformar o conteúdo em tokens (semantic IDs), ensinar o modelo a falar inglês e o idioma do catálogo, e pós-treiná-lo para ranquear com raciocínio legível.

Ele sustenta que feeds custam até 100 vezes menos que apps de chat por hora de engajamento, e que isso torna o recomendador com LLM uma das maiores aplicações de IA para o consumidor.

Antes de ler

Mais 2 termos

Recomendadores seguem a mesma lei de escala dos LLMs

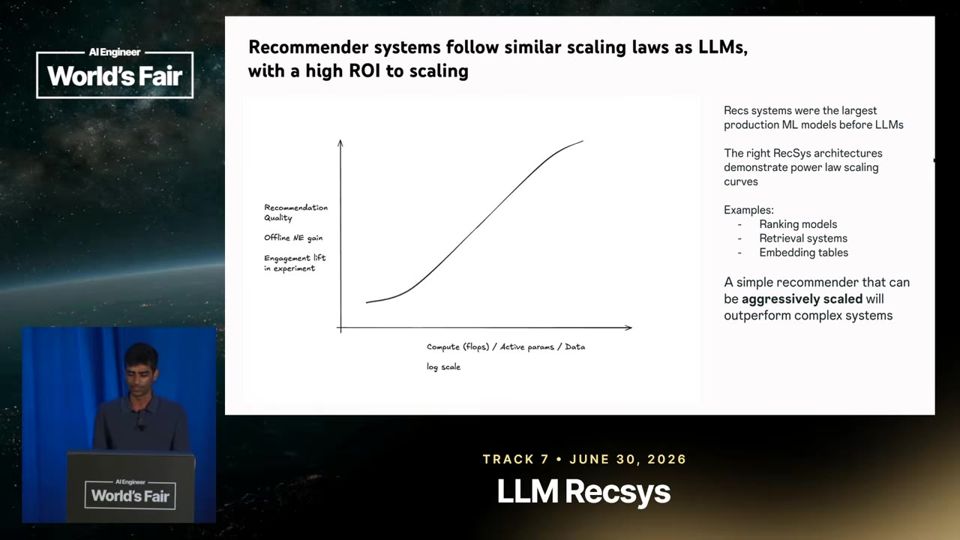
Tandon mostra que a perda do modelo cai de forma previsível quando crescem dados, computação e tamanho, exatamente como no paper de scaling laws de 2020. Ele cita os papers HSTU (2024 e a continuação deste ano) do Meta como evidência offline. No produto, Instagram Reels teve 30% de alta anual em tempo assistido, com modelos maiores e históricos de interação mais longos.

A qualidade da recomendação melhora de forma previsível com escala.03:11

Quatro curvas em S da recomendação

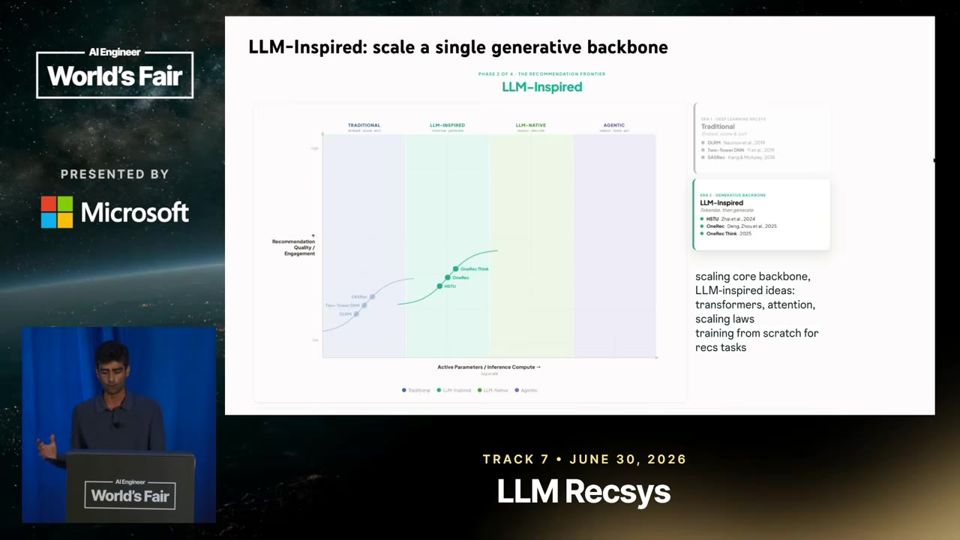
O setor sobe quatro curvas em paralelo. A primeira é a recsys tradicional, com engenharia de features e redes two tower. A segunda é a inspirada em LLM (HSTU, OneRec). A terceira é a nativa de LLM (TIGER, PLUM), que adapta um modelo base que já raciocina. A quarta é a agêntica, em que LLMs orquestram planejamento, busca, ranqueamento e crítica em loop.

A maior parte da indústria está na curva 2 e tenta chegar à 3.06:22

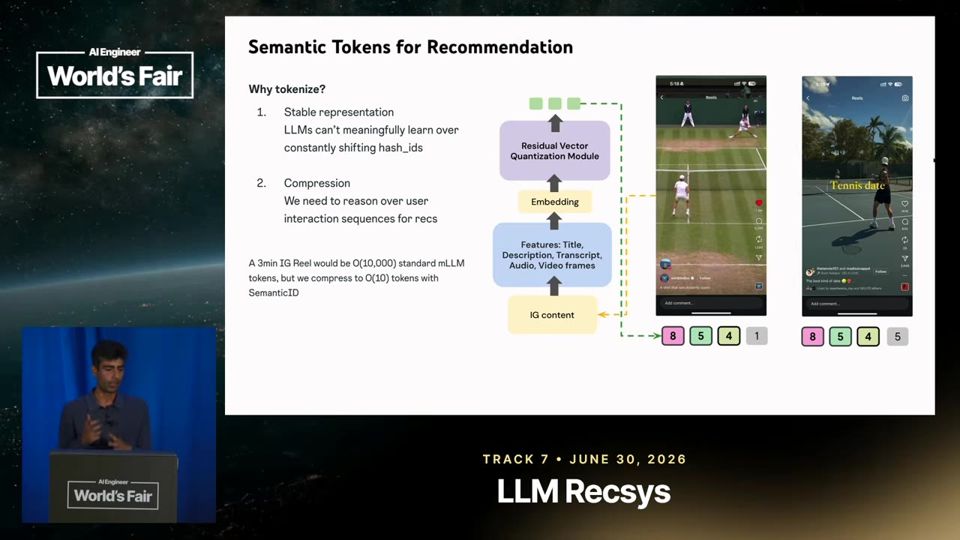
Semantic IDs comprimem um Reel em cerca de 10 tokens

Um vídeo de três minutos viraria uns 10.000 tokens e estouraria a janela de contexto. Com semantic IDs, ele vira cerca de 10. Vídeos parecidos compartilham o prefixo: os primeiros tokens indicam esporte e tênis, e o último distingue o vídeo. Isso dá ao modelo uma representação estável, em vez de um hash que ele só decora.

Conteúdo parecido gera IDs com prefixo em comum.10:10
Mais 2 ideias deste talk

Re-ranker com chain of thought que dá para ler

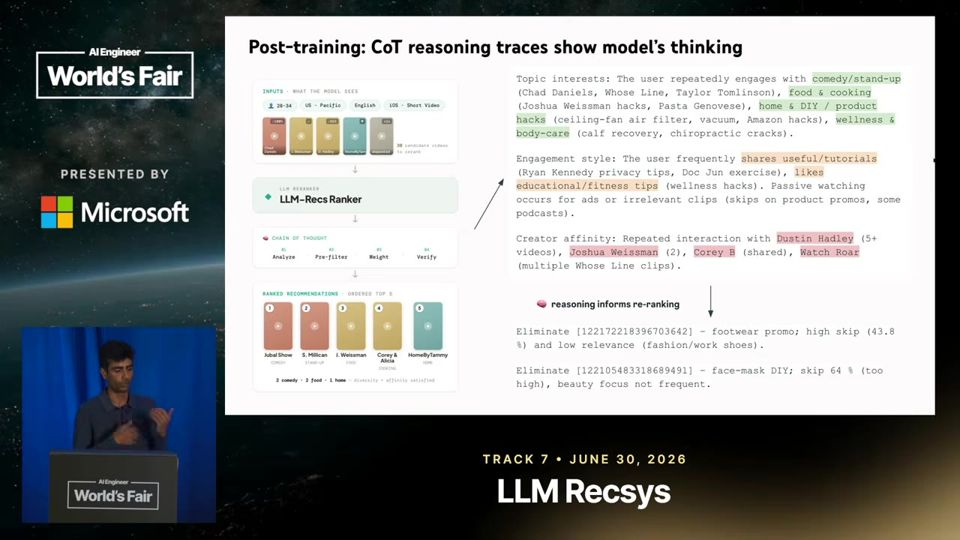
No pós-treino, o modelo recebe dados do usuário e 30 vídeos candidatos e devolve os 5 melhores. Como ele entende inglês e recomendação, escreve o raciocínio: interesses do usuário, estilo de engajamento e afinidade com criadores. Isso permite inspecionar por que o feed decidiu algo e abre espaço para feeds que o usuário controla com linguagem natural, como o Your Algorithm do Instagram.

O raciocínio do ranqueador aparece em texto e pode ser auditado.11:40

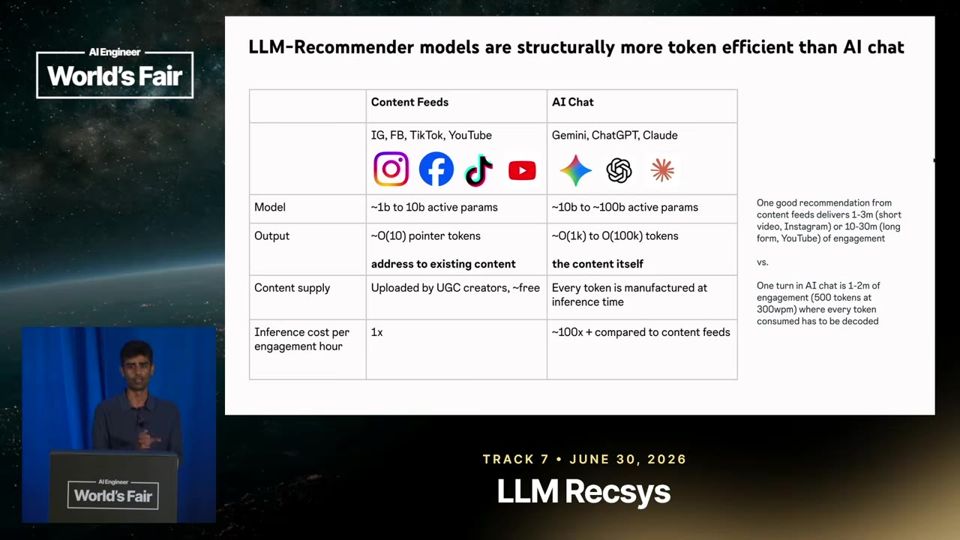
Por que feed custa até 100x menos que chat

Feeds usam modelos de 1 a 10 bilhões de parâmetros ativos e produzem um semantic ID, que aponta para conteúdo enviado por criadores. Apps de chat usam 10 a 100 bilhões e geram milhares de tokens por turno, todos fabricados na hora. Por hora de engajamento, Tandon estima que o feed gasta até 100 vezes menos computação.

A saída de um feed é um ponteiro, a de um chat é texto gerado.15:25
leitura crítica

O palestrante lidera pesquisa de recomendação no Meta e vende a tese de que esse é o maior app de IA, o que é um conflito de interesse claro. O número de até 100x menos custo por hora de engajamento vem sem método, sem fonte e sem números de custo reais. A comparação ignora que feeds dependem de um catálogo enorme de conteúdo de criadores e de anos de infraestrutura. Os ganhos de 30% em Reels vêm de earnings calls e misturam várias mudanças, sem isolar o efeito do LLM.

O que fazer com isso

  • Ao avaliar um projeto de IA de consumo, use o flywheel do talk (treino, inferência, engajamento, monetização) para checar se cada token gasto vira receita.
  • Se sua empresa tem catálogo de produtos ou conteúdos, estude semantic IDs como alternativa a IDs em hash para representar itens em modelos.
  • Peça a fornecedores de recomendação que mostrem o raciocínio do ranqueamento em texto, para auditar por que um item foi promovido.
  • Trate a comparação de 100x de custo como hipótese e peça o custo por hora de engajamento medido antes de basear decisões nela.

Teaching LLMs to Speak Spotify

Para o LLM recomendar catálogo próprio, ensine tokens novos ao modelo com o corpo congelado e avalie com juízes ancorados no perfil do usuário.

Modelos 19:40 nível ●●●●○ Yves Raimond & Jacqueline Wood, Spotify Assistir no YouTube (abre em nova aba)

Em 3 frases

O Spotify reconstruiu seu sistema de recomendação em torno de um LLM, chamado internamente de Large Taste Model, que recomenda, explica e gera experiências que o usuário pode conduzir em linguagem natural.

Jacqueline Wood mostra a receita NEO, em quatro etapas, que adiciona semantic IDs (identificadores semânticos) ao vocabulário de um LLM aberto como o Qwen e congela o modelo base para ele não esquecer como falar.

Ela também defende avaliar com LLMs como juízes, desde que eles recebam perfis e comportamento reais dos usuários, o que aumentou a concordância com humanos, principalmente em buscas ambíguas.

Antes de ler

Mais 2 termos

Recomendação que vira conversa

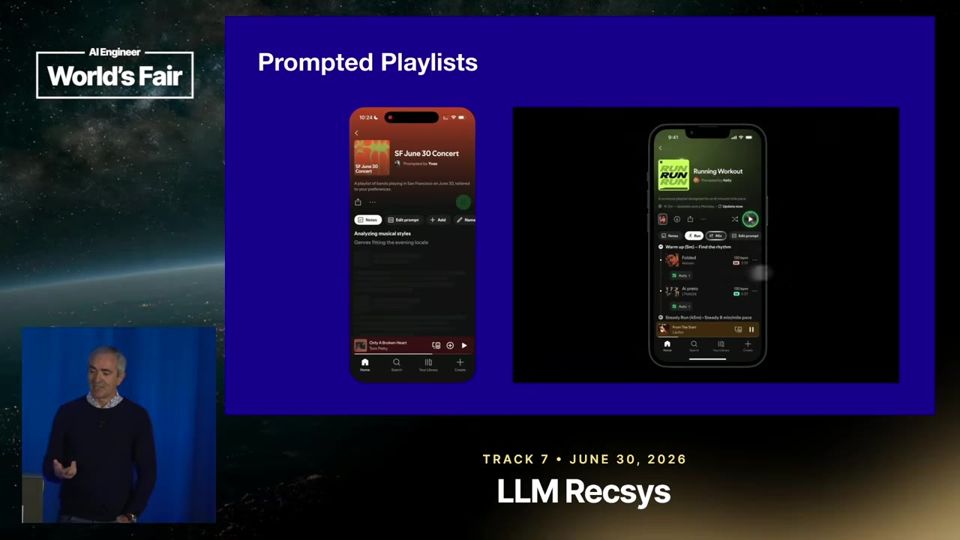
O Spotify passou de curadoria manual para recomendação em escala e agora para personalização generativa. O usuário conduz o DJ, escreve prompts para montar playlists e edita o próprio perfil de gosto em linguagem natural. A promessa é trocar o palpite de uma caixa-preta por raciocínio que o usuário enxerga e corrige.

Prompts livres controlam o algoritmo de recomendação inteiro.04:41

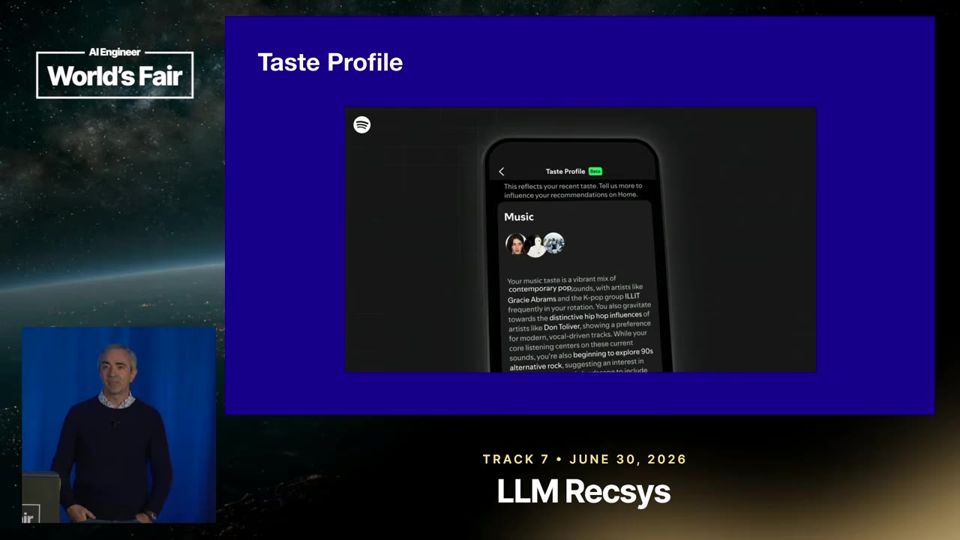
Taste profile editável

O taste profile mostra em texto o que o sistema entendeu sobre você. Yves Raimond dá o exemplo de pedir que músicas da Disney, ouvidas pelos filhos em aparelhos compartilhados, não entrem no gosto dele. O perfil vira um ponto de controle direto do usuário, além de aceitar metas, como aprender um idioma.

O usuário corrige o que o modelo pensa dele, em texto.05:42

NEO em quatro etapas

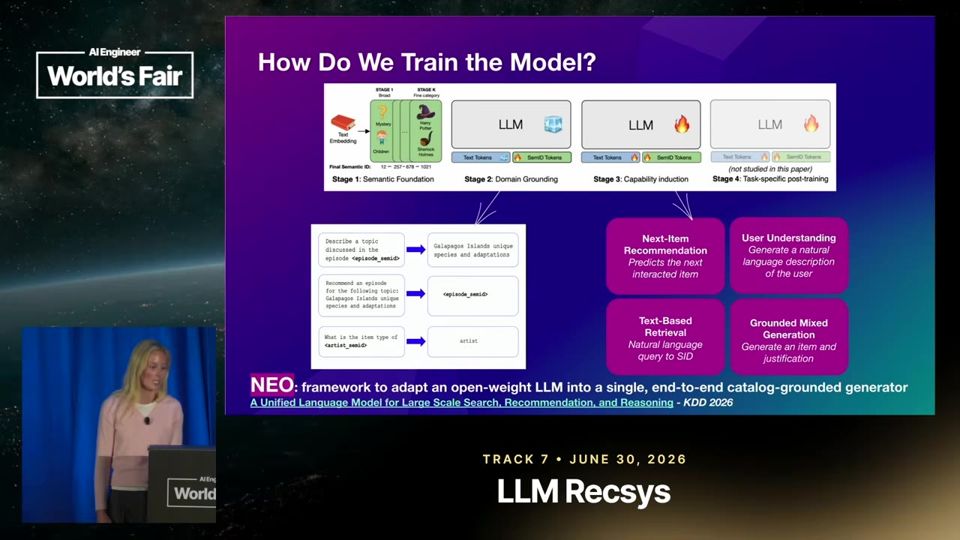
A receita começa criando semantic IDs a partir de embeddings de conteúdo e adicionando esses tokens ao vocabulário de um LLM aberto. Depois vem o domain grounding com o modelo congelado, em que só os novos tokens aprendem. A terceira etapa descongela tudo e faz instruction tuning em várias tarefas do Spotify. A quarta, opcional, é pós-treino como RL.

As quatro etapas do treino e o que fica congelado em cada uma.09:52
Mais 2 ideias deste talk

Congelar preserva a linguagem

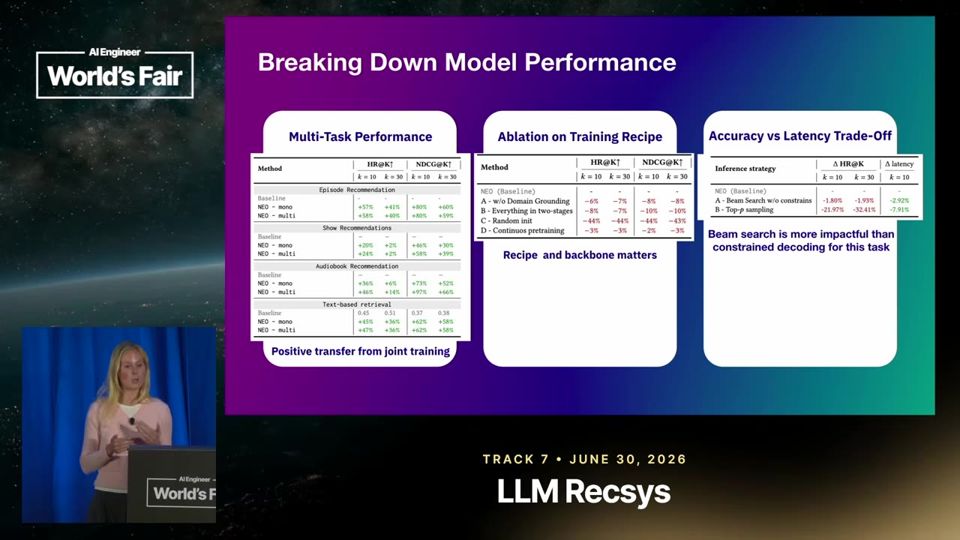
Nas ablações, fazer continued pre-training (pré-treino continuado) no lugar do domain grounding mal mudou o desempenho nas tarefas do Spotify. Mas a capacidade de linguagem natural e conhecimento de mundo do modelo caiu para perto de zero. Congelar o backbone manteve essas habilidades. Segundo Jacqueline, o resultado se repetiu com Llama.

O pré-treino continuado zera a habilidade de linguagem, o congelamento a mantém.13:20

Juízes LLM precisam de contexto

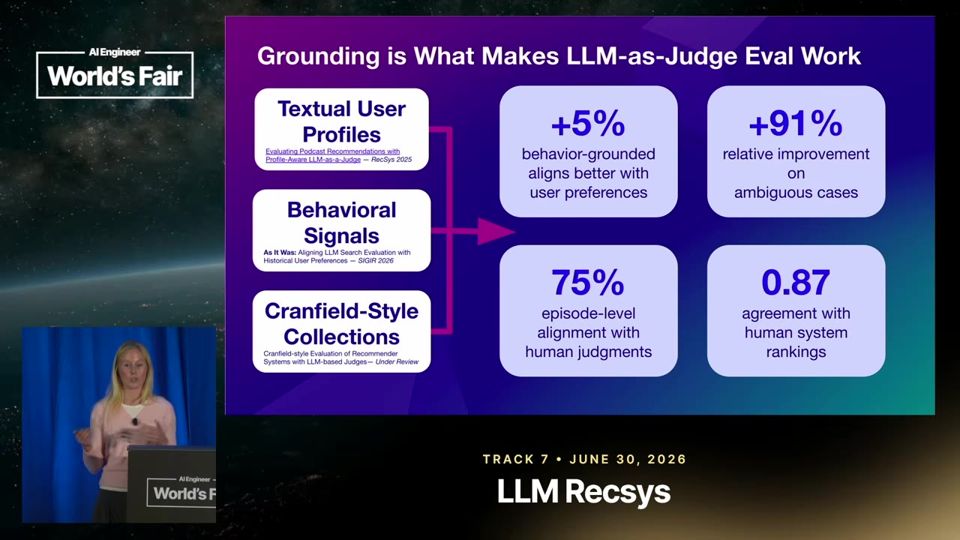
Métricas offline clássicas dizem se o usuário interagiu, mas não se a recomendação ou a explicação faz sentido. O time usa LLMs como juízes e os ancora em perfis textuais e em comportamento passado do usuário. Em buscas ambíguas, a concordância com humanos subiu 91%, contra 5% no geral.

O ganho do grounding aparece sobretudo nos casos ambíguos.17:47
analogia

Semantic ID (identificador semântico). Um semantic ID é como o código de localização de um livro na biblioteca, em que livros de assuntos parecidos recebem códigos parecidos e ficam na mesma estante.

  1. O modelo de linguagem conhece palavras, mas não conhece cada música ou podcast do catálogo. Ele precisa de um nome curto para cada item.
  2. O Spotify já tem um embedding (vetor de números que resume o conteúdo) para cada episódio ou faixa. Itens parecidos têm vetores próximos.
  3. Um algoritmo de quantization (quantização, que arredonda valores contínuos para poucas opções) transforma cada vetor em uma sequência curta de códigos fixos.
  4. Esses códigos viram tokens (pedaços que o modelo lê e escreve) especiais, adicionados ao vocabulário de um LLM aberto como o Qwen.
  5. Depois do treino, o modelo recebe o histórico do usuário nesses códigos e responde com o código do item recomendado junto de uma explicação em texto.
EMBEDDING DO ITEMVetor que resume o conteúdo
QUANTIZAÇÃOVetor vira poucos códigos fixos
NOVOS TOKENSCódigos entram no vocabulário do LLM
LLM FALA O CATÁLOGORecomenda item e explica em texto

Ajuda saber antes: Embedding, Token, Vocabulário de um LLM, Quantização

analogia

Domain grounding (ancoragem de domínio). O domain grounding é como um funcionário experiente que só decora o nome dos produtos novos da loja, sem mudar o jeito de atender o cliente.

  1. Os tokens novos chegam ao modelo sem significado. O modelo precisa aprender o que cada um quer dizer.
  2. Nesta etapa, o modelo treina em pares que ligam semantic ID a texto e texto a semantic ID, nos dois sentidos e em combinações.
  3. O backbone (corpo principal do modelo, com seus pesos originais) fica congelado. Só os embeddings dos tokens novos mudam.
  4. Assim, cada token novo passa a ocupar um lugar coerente no mesmo espaço onde o modelo já guarda o significado das palavras.
  5. No talk, essa é a segunda etapa do NEO. Ela vem antes do ajuste por instruções, quando o modelo inteiro é descongelado.
TOKENS SEM SENTIDOSemantic IDs recém-adicionados
CONGELA O BACKBONEPesos originais não mudam
TREINO ID E TEXTOPares nos dois sentidos
TOKENS ALINHADOSIDs no espaço das palavras

Ajuda saber antes: Semantic ID, Embedding, Fine-tuning, Pesos de um modelo

analogia

Catastrophic forgetting (esquecimento catastrófico). O catastrophic forgetting é como um estudante que passa o mês só decorando fórmulas de química e volta sem conseguir escrever uma redação.

  1. Quando você treina um modelo em um assunto novo, ele pode perder o que já sabia fazer bem.
  2. Isso acontece porque o treino novo ajusta os mesmos pesos que guardavam as habilidades antigas, como gramática e conhecimento geral.
  3. No teste do Spotify, o continued pre-training (pré-treino continuado em dados do domínio) levou a habilidade de linguagem do modelo para perto de zero.
  4. Congelar o backbone e treinar só os tokens novos manteve a linguagem intacta. O time repetiu o resultado com Qwen e com Llama.

Ajuda saber antes: Pesos de um modelo, Fine-tuning, Pré-treino

analogia

Constrained decoding (decodificação restrita). O constrained decoding é como um cardápio de restaurante, em que o cliente escolhe à vontade, mas só entre os pratos que a cozinha sabe fazer.

  1. Um modelo pode inventar um código que não corresponde a nenhum item real do catálogo.
  2. O constrained decoding (decodificação restrita) bloqueia, a cada passo, os tokens que levariam a um código inexistente.
  3. Para isso, o sistema consulta a lista de semantic IDs válidos e só deixa o modelo escolher continuações que existem nela.
  4. No Spotify, o modelo acertou códigos válidos em 98% dos casos sem essa trava. A restrição adiciona um pouco de latência.
  5. Ela ajuda quando você quer limitar o tipo de item, por exemplo recomendar só conteúdo novo para o usuário.
MODELO PROPÕE TOKENSVárias continuações possíveis
FILTRO DE VÁLIDOSConsulta a lista de IDs reais
BLOQUEIA OS INVÁLIDOSProbabilidade vai a zero
ID REAL GARANTIDOItem existe no catálogo

Ajuda saber antes: Semantic ID, Token, Beam search

leitura crítica

O talk é em boa parte vitrine de produto do Spotify. Os ganhos de autoplay, descoberta de podcasts e mensagens do DJ são descritos como sizable ou huge, sem números, base de comparação ou tamanho de teste. O dado de um em cada quatro assinantes usar o sistema não separa curiosidade de retenção. As ablações têm métricas só em slides e a alegação de ser o primeiro sistema a reunir todas essas capacidades vem da própria equipe.

O que fazer com isso

  • Se você constrói recomendação ou busca com LLM, teste primeiro congelar o modelo base ao ensinar vocabulário novo e meça se a linguagem geral do modelo se manteve.
  • Ao usar um LLM como juiz, passe a ele o perfil do usuário e exemplos de comportamento passado e compare a concordância com avaliadores humanos antes de confiar na nota.
  • Separe a avaliação de casos ambíguos do resto do conjunto de teste, porque foi ali que o grounding trouxe o maior ganho segundo o talk.
  • Ao comprar ou avaliar um recurso de personalização com IA, peça a base de comparação e o tamanho do teste por trás de afirmações como ganhos sizable.

Fim da edição

Termos novos no glossário: Aprendizado contrastivo de duas torres, Beam search, Catastrophic forgetting, Constrained decoding, Deep module, Domain grounding, Hard negatives, Semantic ID.