Pular para o conteúdo
Aprendendo AI

Gerar código ficou fácil, o gargalo mudou de lugar

Edição de quarta, 30 set 2026 · 4 vídeos · 1 h 24 min de talks

Quatro talks sobre o que trava as equipes depois que a IA passou a escrever código. A DX mostra com dados de 200 mil engenheiros que o ganho mediano fica em 7,7%, e Laurie Voss explica por que a revisão humana virou o novo gargalo. Antes, Rania Khalaf conta como organiza o cargo de Chief AI Officer e por que não mede tokens. No fim, a Band defende que agentes precisam de uma rede própria para colaborar.

The Chief AI Officer: Scientist, Architect, Coach

O Chief AI Officer cobre três papéis (cientista, arquiteto, coach) e cada empresa regula esses três controles de um jeito, então meça fluência, não tokens.

Carreira e equipes 22:21 nível ●●○○○ Rania Khalaf, WSO2 Assistir no YouTube (abre em nova aba)

Em 3 frases

Rania Khalaf, Chief AI Officer da WSO2, divide o cargo em três focos: Scientist (explora e constrói), Architect (define estratégia e produto) e Coach (educa dentro e fora da empresa).

Cada foco funciona como um controle deslizante, e a regulagem muda conforme o tipo de empresa, a maturidade em IA e o perfil de quem ocupa o cargo.

Ela recusa medir tokens porque o número é fácil de inflar. Mede fluência da equipe, profundidade de adoção, visibilidade em buscadores de IA, produtos usáveis por agentes e receita de produtos de IA.

Antes de ler

Mais 2 termos

Três chapéus: cientista, arquiteto e coach

Scientist explora, experimenta e constrói. Architect também constrói, mas com foco em estratégia de produto, receita nova e relatório ao conselho. Coach gasta tempo evangelizando, educando e repetindo a mensagem, para funcionários e clientes. Khalaf diz que a parte de coach foi a que mais a surpreendeu depois de 20 anos na IBM Research.
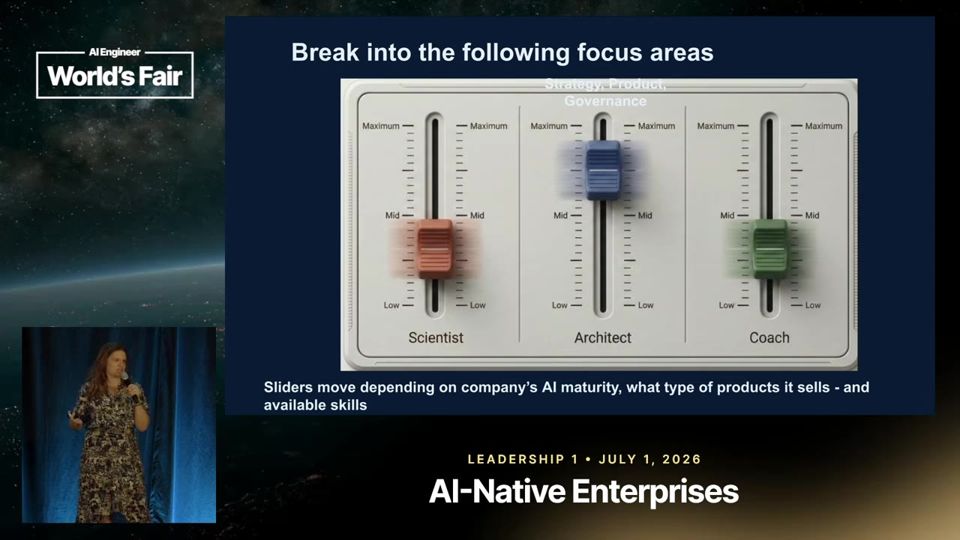
O cargo se divide em três focos de trabalho.03:03

Cada chapéu é um slider

Em um extremo do Architect está o administrador de orçamento, que prioriza projetos e não precisa de conhecimento profundo de IA. No outro, quem reinventa a estratégia da empresa. O Coach olha para dentro quando a empresa não vende IA e para fora quando vende. Ela também usou Claude e Gemini para classificar currículos e vagas do cargo nesses sliders.
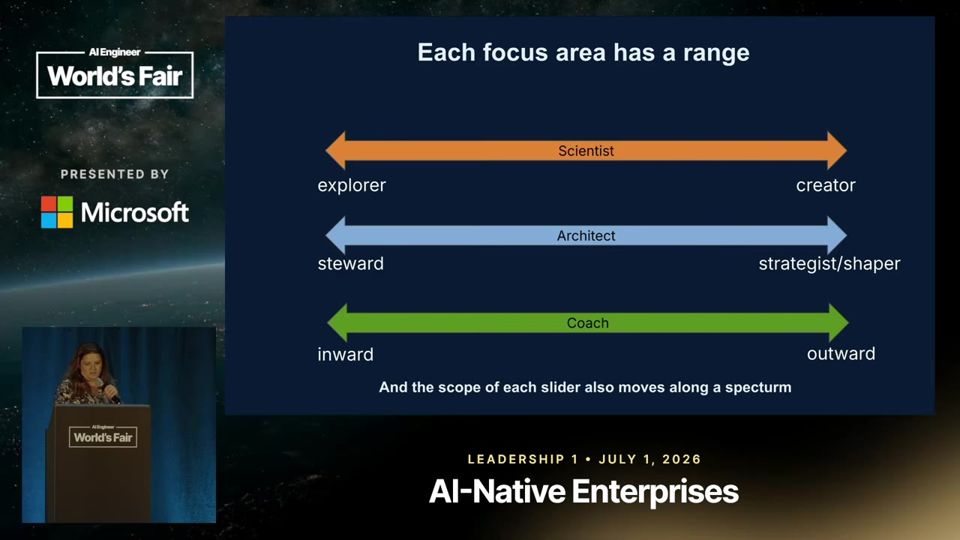
Cada foco tem uma faixa, e a empresa define onde o cargo cai.05:47

Regulagens reais: biotech e WSO2

Na WSO2 ela se descreve com 20% scientist, 60% architect e 20% coach, e faz coaching sobretudo para fora, porque a equipe já é técnica e curiosa. Na biotech agrícola o trabalho era limpar dados e montar infraestrutura. Para medir o tamanho do embrião de milho, bastou detecção de blobs (manchas), sem aprendizado de máquina.
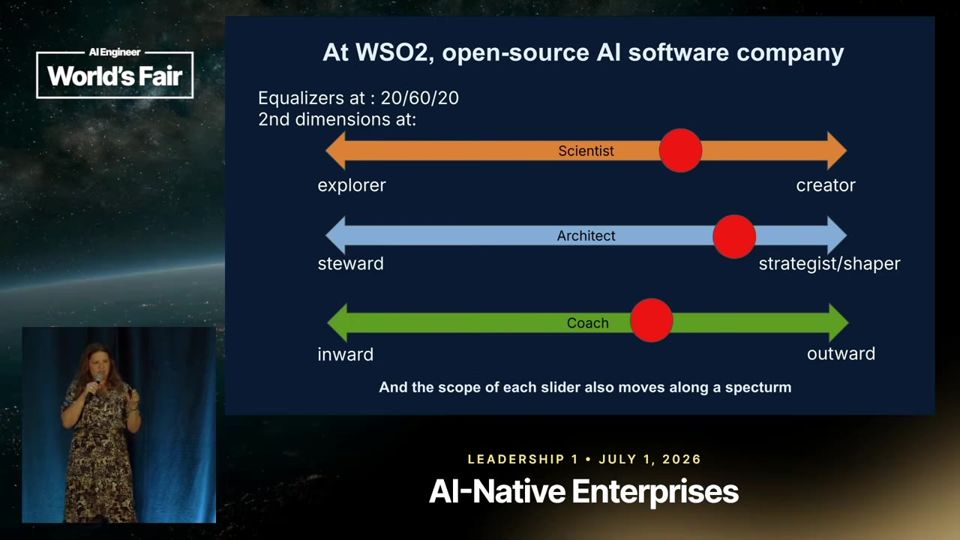
Exemplo de regulagem do cargo na empresa atual dela.10:18
Mais 2 ideias deste talk

Por que ela não mede tokens

Pediram a ela que medisse tokens para saber quanto de IA a empresa usa. Ela recusou, porque o número é fácil de inflar. Prefere medir fluência da equipe (se só um centro de excelência sabe IA), profundidade de adoção (tarefa simples ou fluxo inteiro refeito), disponibilidade de ferramentas e visibilidade em buscadores de IA. Ela lembra que quem mede algo passa a otimizar aquilo.
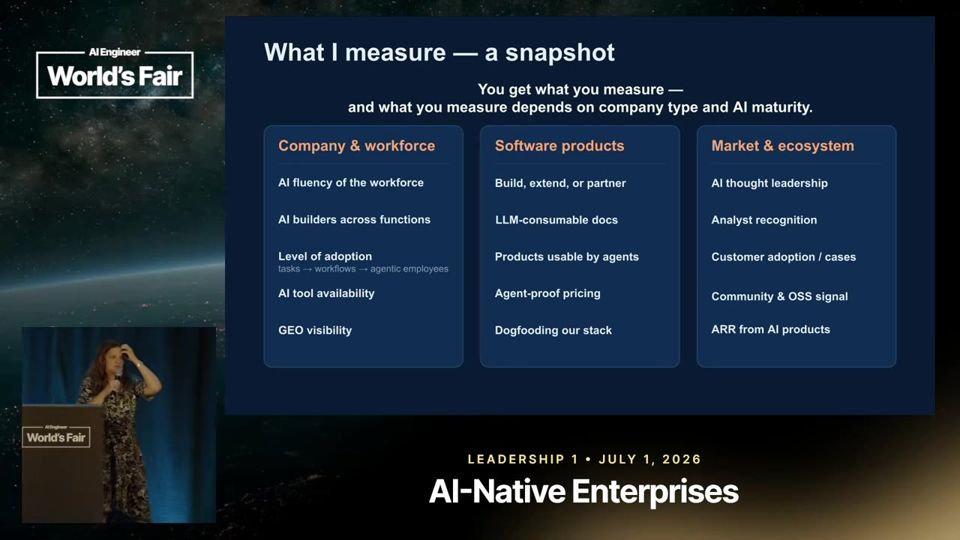
Métricas escolhidas no lugar de contagem de tokens.12:57

Produto feito para agentes consumirem

A WSO2 quer que todo produto seja usável por agentes. Isso significa documentação legível por LLM, servidor MCP, skills e CLI em cada produto. O preço é por consumo, para que agentes não estourem um modelo por assento. Fora do produto, ela acompanha reconhecimento de analistas, participação da comunidade open source e receita de produtos de IA.
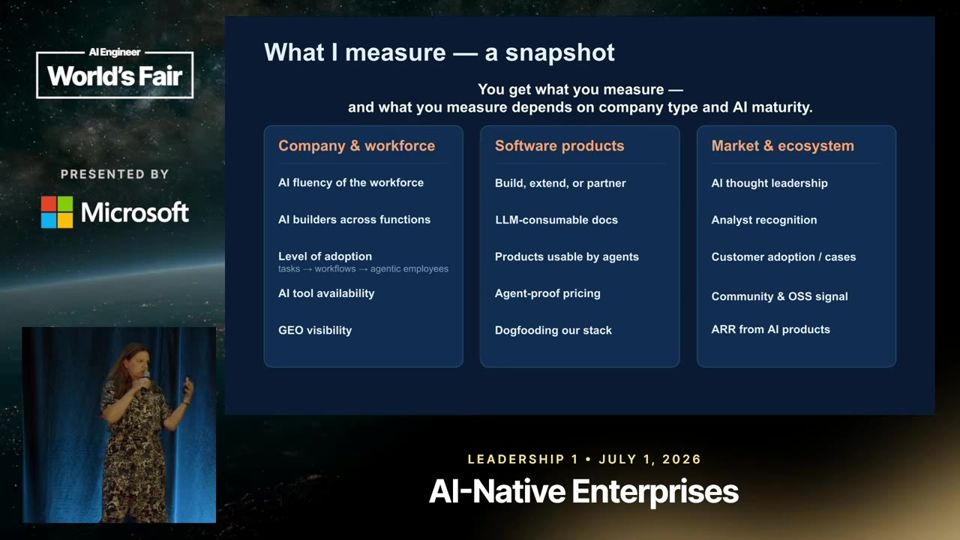
Métricas de produto e de mercado que ela usa no lugar de tokens.15:33
analogia

AI gateway (camada que governa chamadas a modelos). Um AI gateway é como a portaria de um prédio comercial, onde todo visitante se identifica, é registrado e só sobe ao andar permitido.

  1. Empresas usam modelos de IA por meio de chamadas pela internet. Sem controle, cada time chama o modelo que quiser, do jeito que quiser.
  2. O AI gateway (portal de entrada para IA) é um ponto único por onde passam todas as chamadas a modelos. Os aplicativos falam com ele, e ele fala com o modelo.
  3. Nesse ponto, a empresa define regras: quem pode usar qual modelo, quanto pode gastar, quais dados podem sair e o que fica registrado.
  4. Na WSO2, a palestrante explica que chamadas a modelos são APIs (interfaces de programação), mas exigem gestão diferente. Por isso a empresa pôs um gateway de IA dentro da plataforma de APIs que já tinha.
APLICATIVO OU AGENTEPede uma resposta a um modelo
AI GATEWAYConfere regras, limites e registro
MODELO DE IARecebe só chamadas autorizadas
USO GOVERNADOCusto, acesso e dados sob controle

Ajuda saber antes: API, LLM, Token, Gerenciamento de APIs

leitura crítica

O talk descreve uma experiência pessoal, sem dados comparativos nem estudo sobre qual regulagem do cargo funciona melhor. A palestrante é executiva da WSO2 e as métricas que defende (servidor MCP, preço por consumo, open source) coincidem com o que a empresa vende, o que cria conflito de interesse. Ela admite que a visibilidade em buscadores de IA ainda não está resolvida e que a receita de IA é pequena. A análise de currículos com Claude e Gemini aparece sem método ou amostra. As cifras dos estudos da IBM aparecem sem descrição do que mediram.

O que fazer com isso

  • Troque a contagem de tokens por indicadores de fluência: quantas áreas têm alguém que constrói com IA e quantos fluxos inteiros foram refeitos, em vez de tarefas soltas.
  • Se você lidera IA, defina em percentuais quanto do seu tempo vai para explorar, desenhar estratégia e ensinar, e reveja esses números a cada trimestre.
  • Antes de contratar um modelo de aprendizado de máquina, teste se um método simples de visão computacional ou regra resolve o problema.
  • Se você vende software, verifique se seu produto tem documentação legível por LLM e interface para agentes, como servidor MCP ou CLI.
The State of AI in Software Development: Data from 400+ Orgs

A IA acelera a escrita de código, mas o gargalo das equipes está em outro lugar, e por isso os ganhos medidos ficam bem abaixo do prometido.

Engenharia de software 19:09 nível ●●○○○ Justin Reock, DX Assistir no YouTube (abre em nova aba)

Em 3 frases

A DX analisou cerca de 200 mil engenheiros e viu a frequência de deploy subir, mas a taxa de falha de mudanças ficou muito mais instável e a confiança em mudar código caiu.

O ganho mediano de throughput (volume entregue) de PRs foi de 7,7%, e nenhuma empresa chegou a 2x, porque gerar código ocupa só 14% a 16% do fluxo de valor.

Para medir de verdade, o talk propõe olhar uso, impacto e custo, comparar grupos de usuários nas métricas que a equipe já confia e preparar a plataforma para agentes.

Antes de ler

Mais 2 termos

Velocidade sobe, mas a percepção quase não mexe

A frequência de deploy (métrica DORA) cresce de forma constante, mesmo com variação entre regiões. Já a sensação dos engenheiros de entregar mais rápido subiu só cerca de 4,5% em um ano. O palestrante lembra o estudo da METR, com 16 engenheiros, em que a produtividade real caiu e a percepção subiu.

01:44 Deploy frequency cresce, mas a curva já começa a achatar.

Qualidade fica volátil

Cada linha do gráfico é uma empresa. Algumas aumentaram a taxa de falha de mudanças em até 2 pontos percentuais, sobre um benchmark de mercado de cerca de 4%. Isso equivale a até 50% mais defeitos em produção. O padrão já existia sem IA, mas a amplitude aumentou.

04:52 Algumas empresas pioram bastante a taxa de falha, outras melhoram.

Código mais fácil de entender, mudança mais assustadora

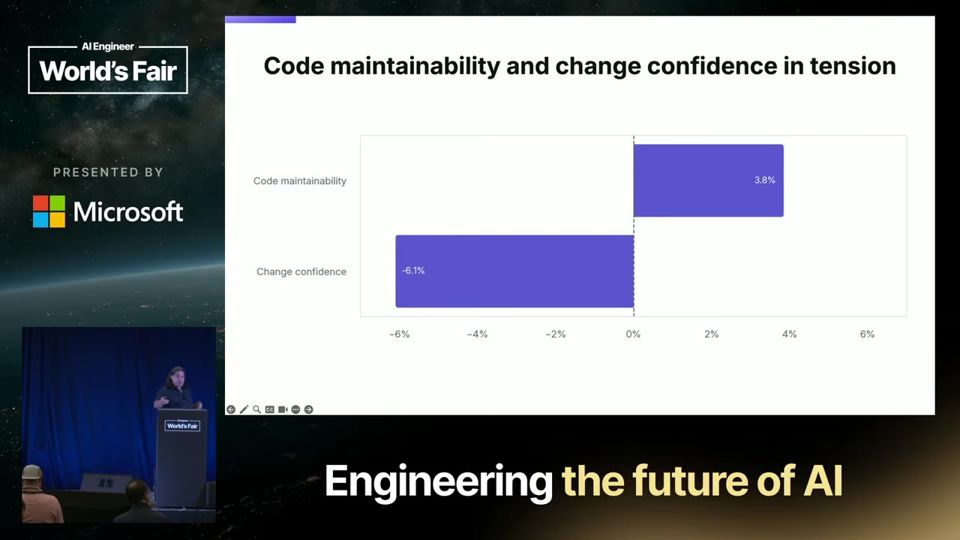
A manutenibilidade percebida subiu quase 4%, mas a confiança para mudar código caiu 6%. Os dois indicadores costumavam andar juntos. O palestrante liga isso ao tamanho dos PRs, que passou de cerca de 44 para 72 linhas, e à queda de 10% na sensação de entrega incremental.

Dois indicadores que andavam juntos agora se separam.06:24
Mais 2 ideias deste talk

Medir uso, impacto e custo

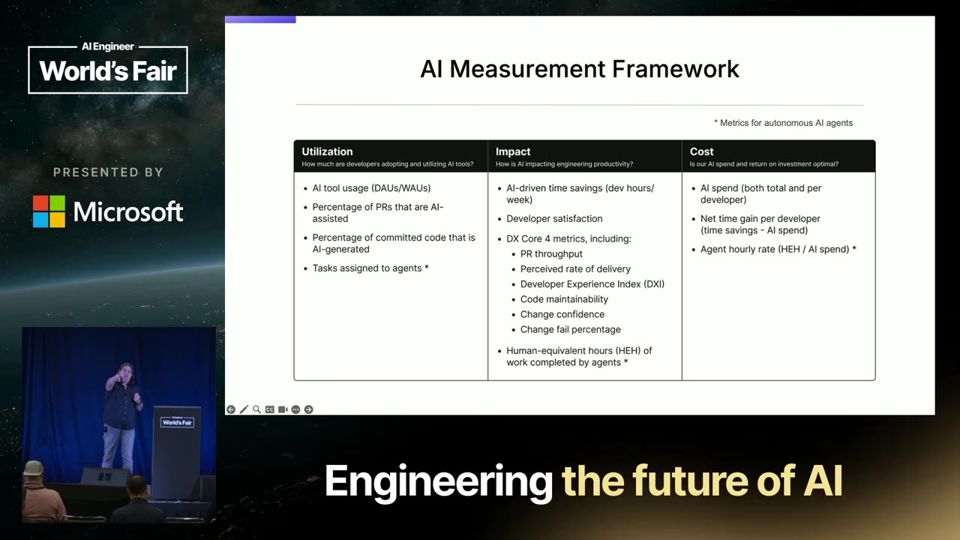
O AI Measurement Framework da DX tem três dimensões. Utilização mostra quem usa e com que frequência. Impacto cruza esse uso com métricas já confiáveis, como tempo de ciclo do PR e tamanho do PR. Custo acompanha o gasto com tokens. A recomendação é comparar grupos de usuários, sem criar métricas novas.

Framework de medição em três dimensões, da utilização ao custo.12:07

Gerar código nunca foi o gargalo

Mesmo com código perfeito e instantâneo, a IA atacaria só 14% a 16% do fluxo de valor. O ganho mediano medido foi de 7,7% em throughput, a média de 13%, e os melhores ficaram na faixa de 70%. Reuniões, troca de contexto e atrito no ambiente consomem o tempo economizado.

15:11 Mediana de 7,7% e nenhum caso chegando a 2x.

leitura crítica

A DX vende plataforma de medição de produtividade, então tem interesse em mostrar que medir é difícil e necessário. Os dados vêm de clientes da própria empresa, sem grupo de controle descrito. Boa parte dos indicadores de confiança e manutenibilidade é percepção de engenheiros em pesquisa. O talk também cita um estudo de 16 pessoas para ilustrar a distância entre percepção e realidade. Os casos de Morgan Stanley, Zapier e Spotify são relatos públicos, sem método de cálculo apresentado.

O que fazer com isso

  • Meça a taxa de falha de mudanças e o tamanho médio dos PRs da sua equipe antes e depois de ampliar o uso de IA.
  • Compare grupos de quem usa muito e pouco IA nas métricas que você já acompanha, como tempo de ciclo e tamanho de PR.
  • Peça PRs pequenos aos agentes, para manter entrega incremental e revisão viável.
  • Procure o gargalo real do seu fluxo, como reuniões, CI lenta ou revisão, antes de comprar mais ferramenta de geração de código.

The Death of the Code Review: What the Data Actually Says

Agentes geram código mais rápido do que humanos revisam. A saída é construir o sistema que revisa, e o humano passa a desenhá-lo.

Engenharia de software 24:40 nível ●●●○○ Laurie Voss, Arize AI Assistir no YouTube (abre em nova aba)

Em 3 frases

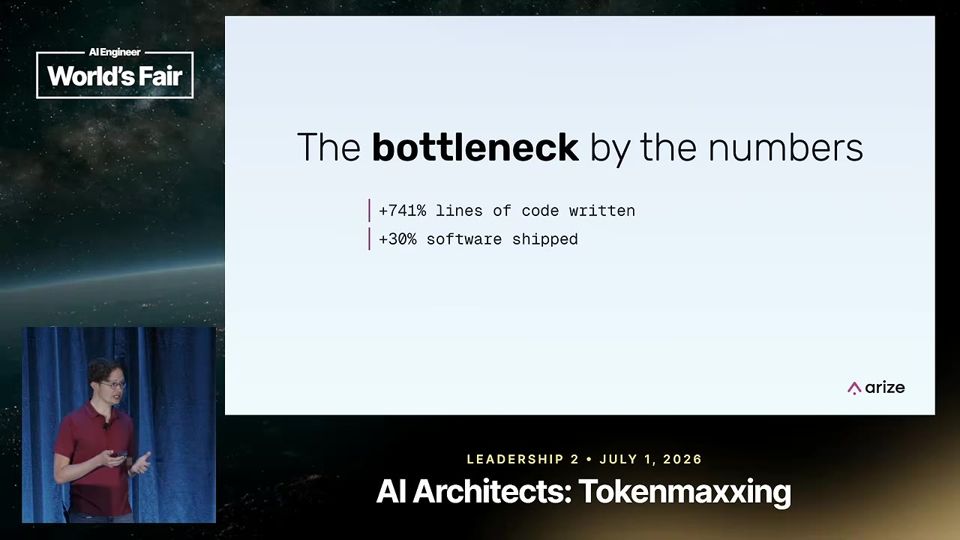
Quem usou agentes autônomos escreveu 741% mais código, mas entregou só 30% mais software, porque a revisão humana virou o gargalo.

Passar nos testes não garante que o código seria aceito: metade dos PRs aprovados no SWE-bench seria recusada por mantenedores, e revisores automáticos caem em prompt injection.

Laurie Voss recomenda parar de revisar PR linha a linha e investir em um review harness (estrutura de revisão automatizada) com regras, contexto da empresa e evals (testes de qualidade), mantendo o humano nos pontos de risco.

Antes de ler

Mais 2 termos

Código sobe 741%, entrega sobe 30%

Um estudo com mais de 100 mil desenvolvedores do GitHub comparou o antes e o depois do uso de agentes autônomos. Escrever código ficou quase oito vezes mais rápido, mas o software entregue cresceu só um terço. Os autores apontam a revisão como o gargalo, porque o caminho até a produção ainda passa por pessoas.

A distância entre os dois números mostra onde o trabalho trava.01:40

Revisar mais não escala

Um estudo da Cisco, com 2.500 revisões e 3,2 milhões de linhas, mostra que a eficácia do revisor despenca acima de 400 linhas por sessão e 450 linhas por hora. Nesse ritmo, um PR de 10 mil linhas leva de três a quatro dias úteis. E um desenvolvedor já roda uma dúzia de agentes em paralelo.

O limite humano de leitura inviabiliza revisar PRs de agentes.03:42

Testes passam, mas o PR não seria aceito

A METR pediu a mantenedores de projetos open source que avaliassem PRs que já passavam no SWE-bench. Só cerca de metade seria aceita, por qualidade de código e por quebrar coisas fora da suíte de testes. O FrontierCode, da Cognition, mostra a mesma lacuna: 88% no SWE-bench Pro contra 29% na fatia mais difícil de aceitabilidade.

O mesmo modelo cai 59 pontos quando a pergunta é se o PR seria aceito.08:25
Mais 2 ideias deste talk

Como Cursor e GitHub revisam em produção

O Cursor roda várias passadas de revisão sobre o mesmo diff e embaralha a ordem, para filtrar falsos positivos. Também precisou instruir o modelo a desconfiar do código por padrão. Um estudo independente da Universidade de Pequim viu até 44% de ganho com várias passadas. O revisor do Copilot, do GitHub, já fez 60 milhões de revisões.

Várias passadas e desconfiança por padrão reduzem falsos positivos.11:40

Tirar o humano tem custo escondido

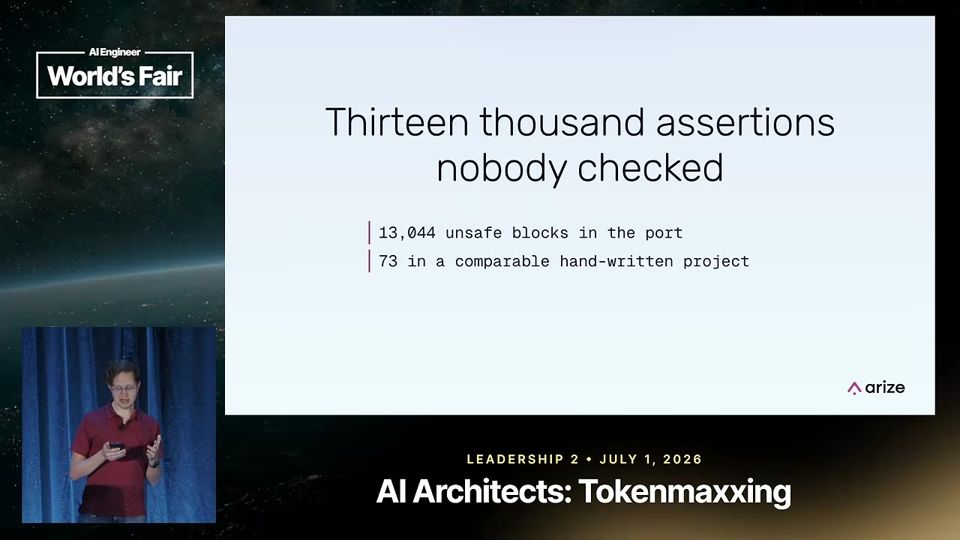
No port do Bun de Zig para Rust, 99,8% dos testes passaram, mas o código tem 13.044 blocos unsafe, contra cerca de 74 num projeto humano comparável. Um teste de prompt injection enganou o agente revisor em 88% das tentativas, contra 35% para humanos. O humano migra para cima, e a produção vira o último revisor.

Os testes certificam o comportamento, mas não a segurança de memória.16:45
leitura crítica

Laurie Voss trabalha na Arize AI, empresa de observabilidade e evals, e as conclusões favorecem esse mercado, embora ela diga que não fará pitch. Boa parte das fontes são posts de blog e relatos de empresas sobre os próprios produtos (OpenAI, Cursor, GitHub), sem dados independentes. O estudo da Cisco tem duas décadas e não envolveu código de agentes. As amostras da METR (quatro mantenedores) e do Bun (um caso) são pequenas.

O que fazer com isso

  • Meça quantas linhas têm os PRs gerados por agentes na sua equipe e defina um limite, em torno de 400 linhas, acima do qual o PR é dividido.
  • Escreva em um arquivo as regras de aceitação do seu time (escopo, regressão, manutenção, segurança) e use esse arquivo como instrução de um agente revisor.
  • Configure o revisor automático para desconfiar do código por padrão e rodar mais de uma passada, e registre quantos alertas humanos aceitam.
  • Mantenha revisão humana obrigatória em código de segurança, de grande impacto ou com responsável nomeado, e monitore o comportamento em produção depois do deploy.

Your Agents Are in Solitary Confinement: Why MCP & A2A Aren't Enough

Agentes só colaboram de verdade com uma camada de rede própria. Hoje o desenvolvedor faz o papel de roteador entre eles, e MCP e A2A não resolvem isso.

Agentes 17:34 nível ●●●○○ Vlad Luzin, Band Assistir no YouTube (abre em nova aba)

Em 3 frases

Vlad Luzin, da Band, diz que quem usa duas sessões de agente (uma executa, outra revisa) já trabalha como roteador manual, copiando mensagens entre elas.

Segundo ele, MCP e A2A são baixo nível: chamadas sem estado, cliente e servidor em um só sentido, sem descoberta de agentes, e filas e timeouts ficam por sua conta. Ele define o problema como sistema distribuído.

A solução proposta é a plataforma da própria Band, com salas, participantes, roteamento, persistência e governança, mostrada em duas demos com Codex, Claude Code e LangGraph.

Antes de ler

Mais 2 termos

Você virou o roteador entre os agentes

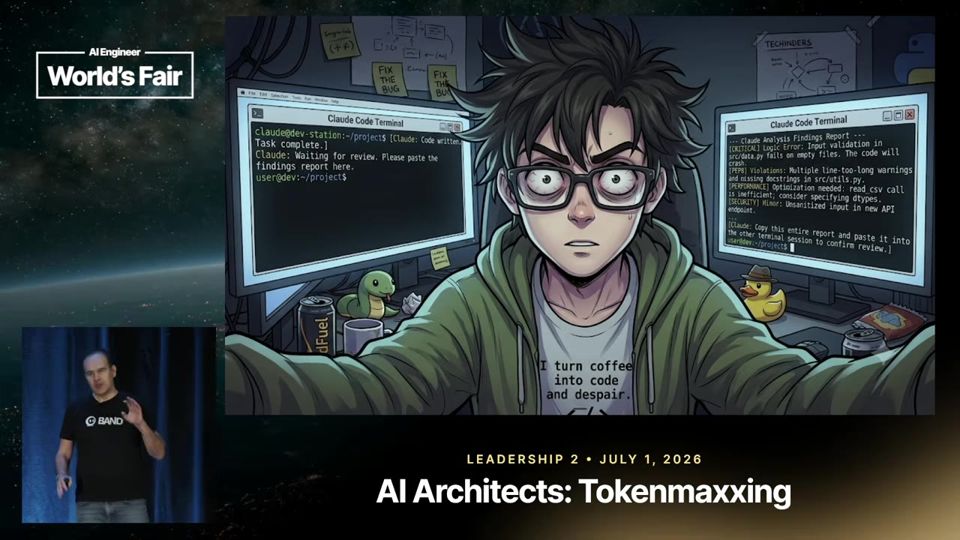
Quem mantém uma sessão de código que implementa e outra que revisa passa mensagens entre as duas à mão. Os agentes guardam estado, mas não conversam entre si. Luzin chama isso de fazer o trabalho de um roteador de rede e diz que a coordenação multiagente já é problema de hoje.

O humano faz o papel de roteador entre dois agentes com estado.03:09

Por que MCP e A2A ficam curtos

Na visão do palestrante, o MCP chama agentes como ferramentas e não guarda estado. O A2A é cliente-servidor, então dois agentes que se enviam tarefas precisam ser os dois lados. Encadear agentes por REST traz timeouts, e filas com persistência e descoberta de agentes ficam fora do protocolo.

Lista das lacunas: sem estado, cliente-servidor, timeouts, filas e descoberta.04:11

Apps de mensagem deixam o agente isolado

Conectar um agente ao Telegram, Discord, Slack ou WhatsApp exige de 5 a 11 passos manuais. O resultado é um agente que fala com uma pessoa, mas não enxerga outros agentes. Luzin chama esse estado de confinamento solitário digital.

Cada plataforma exige passos manuais e entrega só um canal agente-humano.05:44
Mais 2 ideias deste talk

Multiagente é um problema de sistemas distribuídos

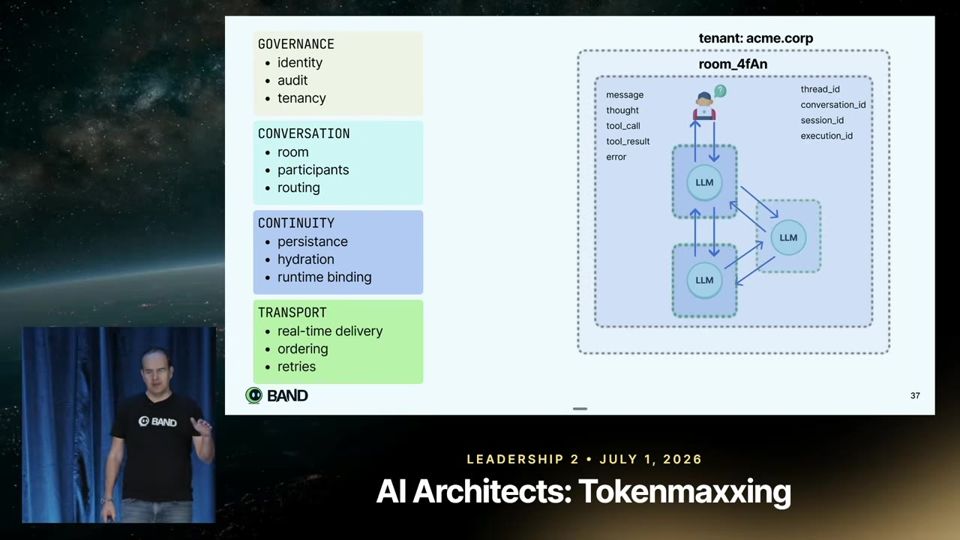
Cada agente é um processo remoto, então valem os problemas clássicos: entrega ordenada, retentativas, recuperação após queda e mapeamento de IDs entre frameworks. Cada agente ainda é não determinístico. Luzin pede abstrações de conversa (salas, canais, participantes, roteamento) e uma camada de governança com identidade e auditoria.

As camadas que o palestrante diz serem necessárias para agentes remotos.08:17

Demo: painel de custo e atribuição de agentes

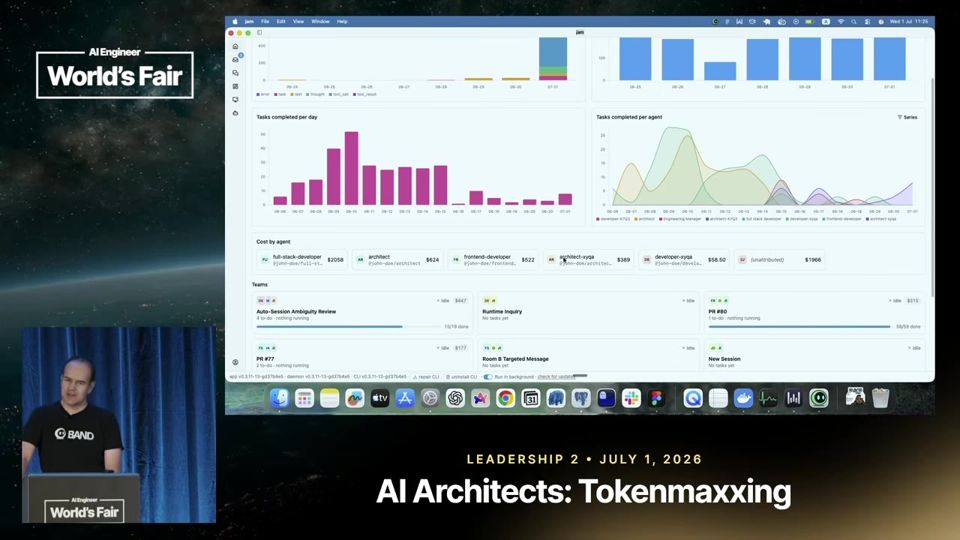
Na segunda demo, instâncias de Claude Code atuam como gerente de engenharia, desenvolvedor e arquiteto e revisam documentos sem um loop codificado à mão. O painel mostra custo em tokens por agente, atribuição por desenvolvedor ou time e as sessões conectadas. O palestrante diz que os modelos já sabem se comunicar por mensagens.

Painel com custo, atribuição e sessões de agentes locais e remotos.14:43
analogia

Runtime binding (ligação de IDs entre frameworks em tempo de execução). Runtime binding é como a recepção de um prédio com vários andares, que guarda qual crachá de visitante corresponde a qual funcionário para cada pessoa achar o destino certo.

  1. Cada ferramenta de agente numera suas conversas do seu jeito. Uma chama de thread ID, outra de conversation ID, outra de execution ID.
  2. Quando dois agentes de ferramentas diferentes precisam conversar, nenhum entende o número do outro. Eles falam da mesma conversa com nomes distintos.
  3. O runtime binding (ligação em tempo de execução) cria uma tabela que liga esses números. Ela diz que o thread X de um lado é o execution Y do outro.
  4. Essa ligação acontece enquanto os agentes rodam, não na hora de programar. Assim, um agente novo entra na conversa sem ninguém reescrever código.
  5. Luzin lista isso como uma das camadas que a rede de agentes precisa resolver para os frameworks interagirem.
AGENTE AUsa thread ID
AGENTE BUsa execution ID
TABELA DE LIGAÇÃOLiga os IDs em tempo real
MESMA CONVERSAOs dois se entendem

Ajuda saber antes: Agente de IA, Framework de agentes, ID de conversa, Sistema distribuído

analogia

Rehydration (reidratação, retomada do estado de um agente após queda). Rehydration é como salvar o jogo antes de a luz acabar: ao voltar, você carrega o save e continua do mesmo ponto, sem recomeçar a fase.

  1. Programas às vezes caem. O computador reinicia, o servidor falha, a máquina virtual some. O que estava na memória se perde.
  2. Um agente que cai no meio de uma tarefa esquece o que fez e com quem falava. Sem proteção, o trabalho recomeça do zero.
  3. Para evitar isso, o estado do agente fica guardado fora dele, em um armazenamento durável. Estado é o histórico da conversa e o ponto da tarefa.
  4. Rehydration (reidratação) é ler esse estado guardado e entregar a um agente novo. Ele retoma de onde o anterior parou.
  5. Luzin chama essa necessidade de continuidade. Agentes rodam em pods e containers Docker, que caem com frequência.
AGENTE TRABALHAEstado salvo a cada passo
QUEDAContainer ou pod falha
AGENTE NOVOSobe vazio no lugar
ESTADO RESTAURADORetoma do ponto onde parou

Ajuda saber antes: Estado de um agente, Container (Docker), Persistência de dados

leitura crítica

O talk é pitch da Band e do Jam, ambos vendidos pelo palestrante, que termina convidando o público ao estande. O CTO anônimo de uma empresa de 10 bilhões serve de espantalho. Não há dados de latência, falhas ou ganho de produtividade, e a demo é interna, sem comparação com MCP ou A2A somados a filas comuns. A afirmação de que os modelos dispensam loops codificados não vem com teste.

O que fazer com isso

  • Liste quantas sessões de agente você roda em paralelo e onde copia mensagens à mão entre elas. Esses pontos mostram onde falta coordenação.
  • Antes de contratar uma plataforma de agentes, teste se um chat compartilhado simples com um agente revisor resolve o seu caso.
  • Peça aos fornecedores de ferramentas multiagente respostas sobre persistência, entrega ordenada, identidade e auditoria de cada agente.
  • Registre o custo em tokens por sessão e por tarefa, para saber quanto cada agente gasta antes de escalar o uso.

Fim da edição

Termos novos no glossário: AI gateway, Rehydration, Runtime binding.