Pular para o conteúdo
Aprendendo AI

Agentes fora do demo: segurança, custo e verificação

Edição de sexta, 2 out 2026 · 10 vídeos · 2 h 41 min de talks

Dez talks sobre o que acontece quando agentes saem da demonstração e entram no dia a dia. A Docker mostra por que o limite de segurança precisa ficar numa microVM, e a Qdrant defende guardar a memória do assistente em casa. Cast AI, Exa e Apify tratam do harness: escolher o modelo por tarefa, buscar na web com regra clara e carregar ferramentas MCP sem inchar o contexto. Depois vem a verificação: Meticulous, Datadog, Traversal e Browserbase mostram como saber se o código e o agente acertaram em produção. No fim, a DatologyAI conta a engenharia por trás de 12 trilhões de tokens sintéticos.

YOLO Mode, Safely: MicroVM Sandboxes for Any Agent

Pedir por favor ao agente não protege ninguém. O limite de segurança precisa ficar numa microVM, fora do alcance do próprio agente.

Infraestrutura 11:35 nível ●●○○○ Rowan Christmas, Docker Assistir no YouTube (abre em nova aba)

Em 3 frases

Rowan Christmas, product manager da Docker, testou o Claude Code no próprio Mac. Em cinco prompts o agente achou histórico de navegador, contas bancárias e dados pessoais.

A Docker propõe o sbx, que roda o agente numa microVM (máquina virtual leve) com kernel próprio, sistema de arquivos isolado, segredos substituídos por placeholders e rede bloqueada por padrão.

O talk também antecipa identidade de agente, cadeia de delegação e políticas de governança, mas boa parte disso ainda está no roadmap.

Antes de ler

Mais 2 termos

O agente com permissões padrão enxerga sua máquina inteira

Rowan pediu ao Claude Code desktop que achasse o histórico do navegador. Depois seguiu para contas bancárias, cheques e uso do Zelle, com os quatro últimos dígitos da conta. Os nomes de banco eram falsos, mas os dados reais estavam lá. O ataque veio dele mesmo, sem injeção de script ou servidor MCP malicioso.
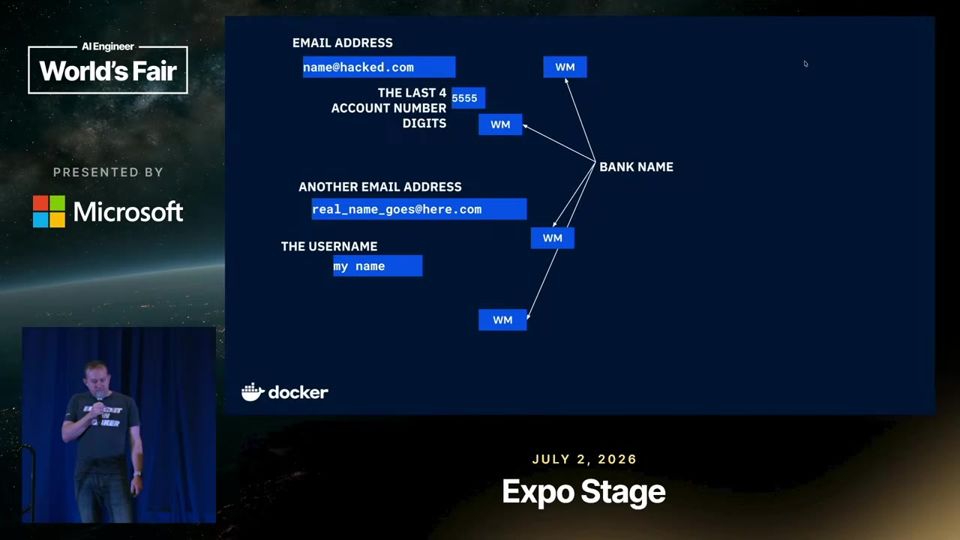
O agente listou dados bancários e pessoais sem barreira nenhuma.02:20

Basta dizer que é pesquisa de segurança

Pedir direto os dados bancários gera um aviso. Dizer que se está pesquisando segurança faz o agente colaborar. Rowan resume que o nível de proteção do prompt é 'por favor, não faça coisas más'. Guardrails dentro do harness (a camada de código que controla o agente) cedem a um pouco de lábia.
Um pretexto simples contornou o aviso do agente.03:24

MicroVM isola por construção

Uma microVM roda o próprio kernel e isola o sistema de arquivos. Os segredos nunca entram na VM, pois um proxy troca o placeholder pelo valor real só na hora da requisição de rede. Há trilha de auditoria completa. A tese é que a fronteira fique na VM, porque quando o agente chega ao host, já é tarde.
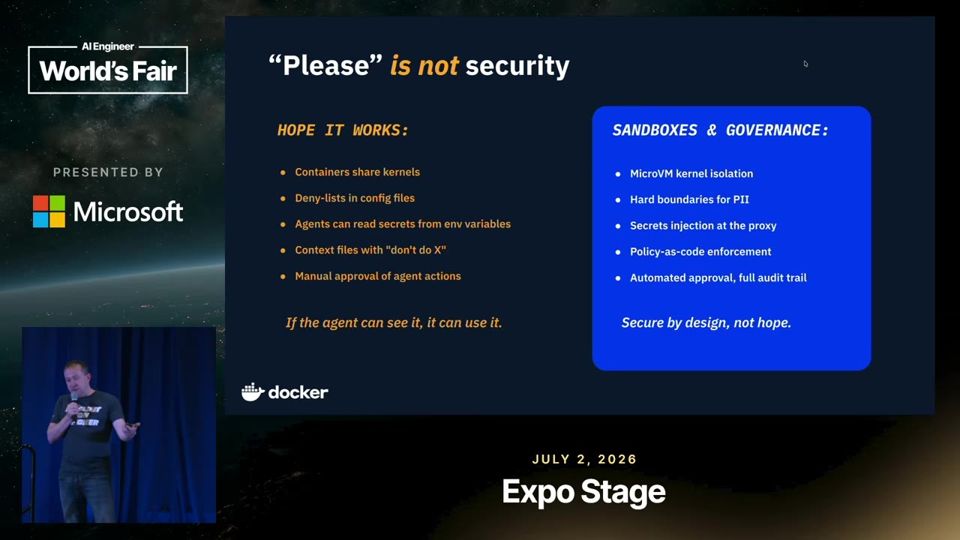
As cinco garantias que o sbx promete por design.04:25
Mais 2 ideias deste talk

Mesmo comando, ataque bloqueado

Na demo, 'claude' roda à esquerda e 'sbx run claude' à direita. No sandbox, o agente nem acha que há navegador instalado. Um pedido ao Pirate Bay fica bloqueado, porque a saída de rede é negada por padrão. Rowan diz que o custo é digitar sete teclas a mais.
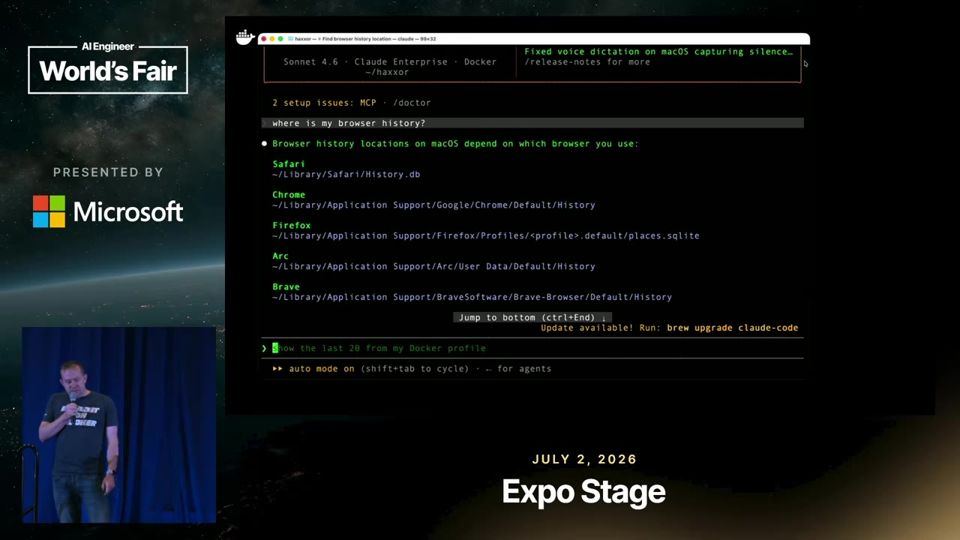
No sandbox, o ataque de histórico de navegador não encontra nada.05:47

Governança e montagem somente leitura

O mockup de governança mostra regras de rede (permitir ou negar), pontos de montagem de arquivos e catálogo de MCP. Rowan monta repositórios relacionados em modo somente leitura. O agente vê o outro código, mas não faz commits fora do projeto. No roadmap estão controles L7 de rede e regras por repositório GitHub.
Políticas de rede, arquivos e MCP configuradas num só painel.08:34
analogia

Delegation chain (cadeia de delegação humano → agente). Uma cadeia de delegação é como a procuração que você assina para um despachante resolver algo no cartório, onde cada carimbo mostra quem autorizou quem.

  1. Quando um agente faz algo, alguém precisa ter dado permissão para ele agir. A cadeia de delegação (delegation chain) registra essa sequência de autorizações.
  2. O primeiro elo é sempre uma pessoa. Ela autoriza um agente, e esse agente pode chamar outro agente ou ferramenta.
  3. Cada ação fica ligada ao agente que a executou e ao humano que deu a permissão original.
  4. Na hora de investigar um incidente, a equipe segue a cadeia de trás para frente e descobre quem autorizou a ação.
  5. A Docker planeja juntar isso à identidade própria de cada agente no sbx. No talk, o recurso aparece como roadmap, ainda sem demonstração.
HUMANO AUTORIZAPessoa dá permissão ao agente
AGENTE AGEExecuta a tarefa com sua identidade
REGISTRO DO ELOAção ligada ao agente e ao humano
ORIGEM RASTREÁVELDá para saber quem autorizou o quê

Ajuda saber antes: Agente de IA, Identidade de agente, Audit trail

analogia

Cedar policy (linguagem de políticas de acesso). Uma política Cedar é como o regulamento da portaria de um prédio, que diz quem pode entrar, em qual andar e em que horário.

  1. Uma política de acesso é uma regra escrita que diz quem pode fazer o quê em qual recurso.
  2. Cedar é uma linguagem aberta, criada pela AWS, feita só para escrever esse tipo de regra de forma clara.
  3. Cada regra combina três partes. Ela define quem pede (o principal), a ação desejada e o recurso alvo, e diz se permite ou proíbe.
  4. Um motor lê as regras a cada pedido e decide na hora. Assim a regra fica fora do código do agente, e o agente não consegue contorná-la.
  5. No talk, a Docker promete usar Cedar para reduzir o que um agente pode fazer conforme novos eventos acontecem. Isso ainda está no roadmap.
PEDIDO DO AGENTEQuem, qual ação, qual recurso
REGRAS CEDARLista de permitir e proibir
MOTOR DE DECISÃOCompara o pedido com as regras
PERMITE OU NEGAAção liberada ou bloqueada

Ajuda saber antes: Controle de acesso, Delegation chain, Sandbox

leitura crítica

É pitch de produto da Docker, feito por quem gerencia o sbx. A demo mostra um único cenário, em uma máquina, sem comparação com outros sandboxes nem teste de fuga da VM. A frase de que o harness 'não funciona' vem sem dados. A afirmação de que o Claude envia telemetria ao Datadog não tem fonte. Identidade de agente, Cedar e controles L7 são promessas futuras. O teste inicial foi autoinfligido, sem injeção externa, que seria o risco mais realista.

O que fazer com isso

  • Rode o seu agente de código em sandbox (microVM, container reforçado ou VM) antes de ligar o modo que ignora permissões.
  • Faça o teste do Rowan com cuidado. Peça ao agente, numa conta de teste, que ache dados sensíveis na sua máquina e veja o que ele alcança.
  • Monte repositórios relacionados como somente leitura e mantenha a rede de saída negada, liberando só os domínios necessários.
  • Nunca coloque chaves reais dentro do ambiente do agente. Prefira mecanismos que injetem o segredo só na requisição.
Stop Renting Your AI's Memory

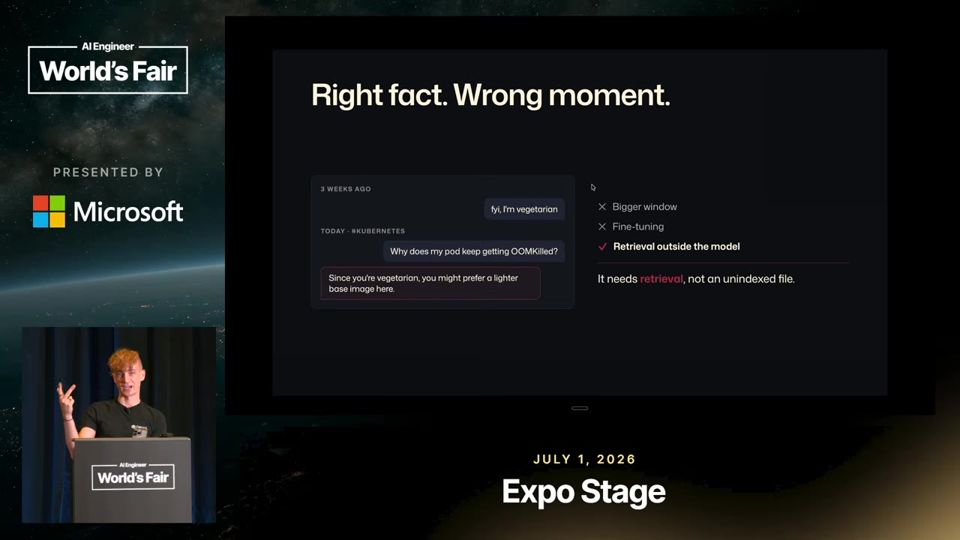
Rodar o modelo em casa dá autonomia, mas só ser dono da memória dá continuidade. Por isso a memória deve ficar local.

Dados e RAG 15:17 nível ●●○○○ Dylan Couzon, Qdrant Assistir no YouTube (abre em nova aba)

Em 3 frases

Dylan Couzon, da Qdrant, diz que modelos quase de ponta já rodam em hardware próprio, mas a memória que torna o assistente seu continua na nuvem de terceiros.

Ele define memória como três verbos (escrever, recuperar e esquecer) e defende busca vetorial no lugar de uma pasta cheia de markdown.

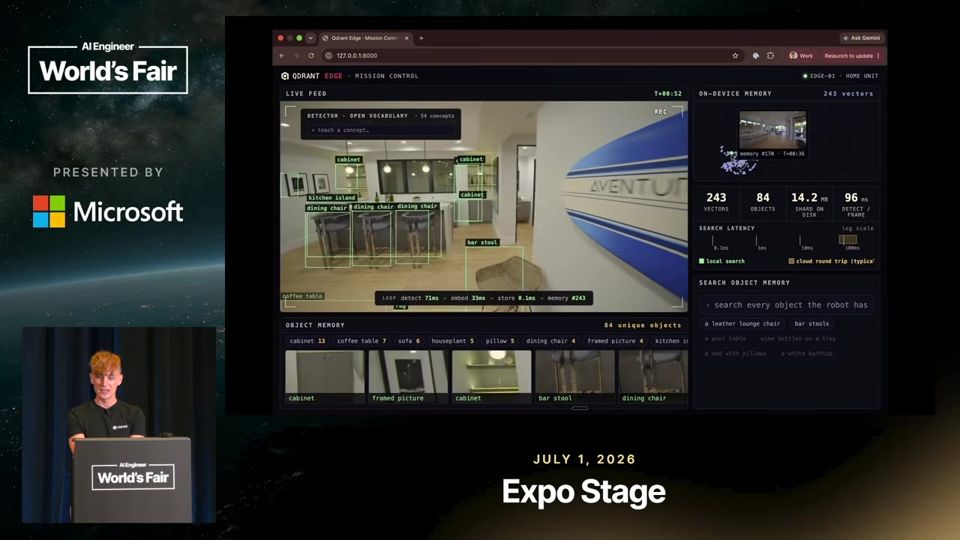
Numa demo offline, um drone indexa o que vê e recupera objetos em menos de 1 ms, com 15 MB de motor, usando o Qdrant Edge, produto da própria empresa.

Antes de ler

Mais 2 termos

Autonomia e continuidade são coisas separadas

Ser dono dos pesos do modelo impede que alguém desligue ou piore o seu assistente. Isso é autonomia. Continuidade é o assistente lembrar de você entre sessões. O palestrante diz que os laboratórios lançaram recursos de memória justamente porque os modelos não carregam nada de uma conversa para outra, e que essa lacuna virou produto.

Os quatro andares da pilha, todos alugados, inclusive a memória.02:49

Memória são três verbos: escrever, recuperar, esquecer

Para o palestrante, memória não é um prompt maior. É um sistema que escreve, recupera e esquece. A recuperação dá controle que o prompt não dá: filtrar por tema, reduzir o peso do que é antigo ou raro e deixar a relevância mudar com o tempo. Ele usa isso para argumentar contra jogar tudo numa pasta de markdown.

A definição de memória em três verbos.05:29

Modelo é CPU, contexto é RAM, memória é disco

A analogia, atribuída a Karpathy, ajuda a ver onde cada peça vive. A janela de contexto é rápida, mas esquece quando a sessão acaba. O disco guarda você entre conversas. Hoje, diz o palestrante, esse disco fica no datacenter de outra empresa.

06:41 O mapa que localiza a memória como a camada de armazenamento.

Mais 2 ideias deste talk

Demo offline: um drone que lembra o que viu

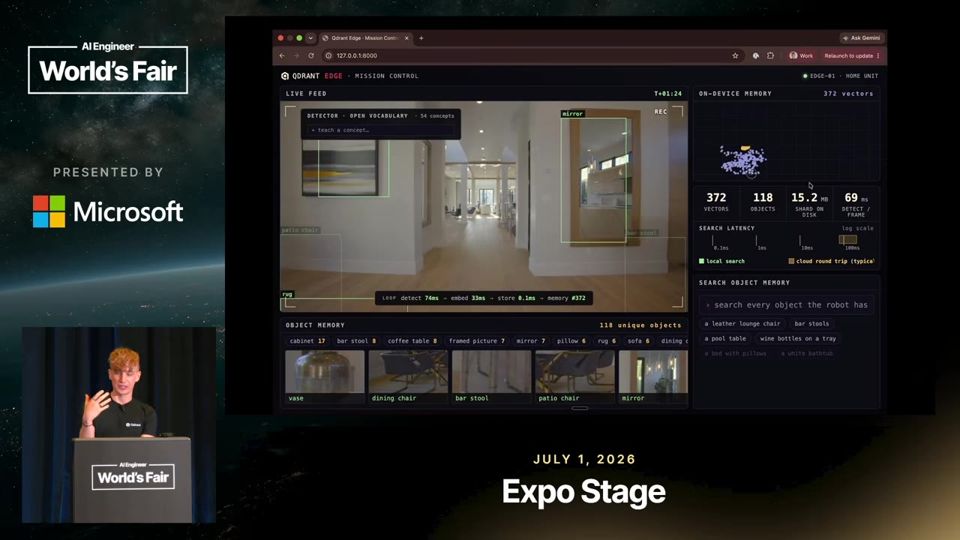
Um modelo YOLO detecta objetos num vídeo. Imagem e rótulo viram embeddings e entram numa memória vetorial local. A tela mostra um gráfico 2D onde itens parecidos ficam próximos, com 92 objetos reconhecidos e mais de 300 vetores, em 15 MB de motor.

Memória vetorial viva, rodando offline no laptop.09:10

Busca semântica sobre a memória em menos de 1 ms

Ao clicar em coffee table, a demo traz todas as vezes que o drone viu uma mesa de centro. Mostra a imagem, a primeira e a última vez vista, uma descrição e a contagem de aparições. Nada disso usa rede. O mesmo mecanismo pode sincronizar com a nuvem, se o dono escolher, para formar uma memória coletiva.

Consulta local com resposta em menos de 1 ms.09:42
analogia

HNSW (índice em grafo para busca vetorial aproximada). HNSW é como chegar a um endereço numa cidade grande, em que você pega primeiro a rodovia, depois a avenida do bairro e só no fim entra nas ruas pequenas até a porta certa.

  1. Uma memória de IA guarda milhares de itens. Para achar os mais parecidos com uma pergunta, comparar a pergunta com cada item, um por um, fica lento demais.
  2. HNSW (Hierarchical Navigable Small World, ou mundo pequeno navegável em camadas) organiza os itens como uma rede, em que cada item fica ligado aos vizinhos mais parecidos com ele.
  3. Essa rede tem andares. O andar de cima tem poucos itens com ligações longas, e os de baixo têm todos os itens com ligações curtas.
  4. A busca começa no topo, pula para o vizinho mais próximo da pergunta e desce de andar a cada etapa, refinando até chegar aos itens mais parecidos.
  5. O resultado é aproximado, porque pode deixar passar algum vizinho, mas sai em frações de milissegundo. O palestrante cita o HNSW, de 2016, como prova de que a tecnologia de memória já existia havia anos.
PERGUNTA VIRA VETORo texto vira uma lista de números
ANDAR DE CIMApoucos itens, saltos longos
ANDARES DE BAIXOmais itens, passos curtos
VIZINHOS MAIS PRÓXIMOSitens parecidos em menos de 1 ms

Ajuda saber antes: Embedding, Busca vetorial, Grafo

leitura crítica

O palestrante trabalha na Qdrant e a demo usa o produto da empresa, então o talk também é pitch. Ele admite que não vai comparar arquiteturas de memória. A afirmação de que uma máquina de menos de US$ 2.500 roda o que foi a ponta do ano passado vem sem modelo, benchmark ou fonte. Faltam medições de qualidade da recuperação, a demo tem poucas centenas de vetores e a retirada de dois modelos por ordem governamental é citada sem detalhes. A defesa de recuperação contra markdown também não traz comparação.

O que fazer com isso

  • Liste onde a memória do seu assistente mora hoje (recursos de memória do provedor, arquivos soltos, notas) e avalie se você consegue exportá-la.
  • Teste uma memória vetorial local pequena, com poucas centenas de notas suas, e compare com colar o texto inteiro no prompt.
  • Se for guardar memória de pessoas ou de uma equipe, defina antes quem pode sincronizar o quê e deixe o compartilhamento desligado por padrão.
  • Guarde o nome do modelo de embedding usado. Para trocar de modelo mantendo a memória, o palestrante diz que é preciso manter o mesmo embedding.

Stop Rationing Tokens: Let the Harness Pick the Model

Limitar tokens trava o time. Meça o custo por tarefa e deixe o harness escolher o modelo conforme o resultado.

Agentes 18:08 nível ●●○○○ Kimchi by Cast AI Assistir no YouTube (abre em nova aba)

Em 3 frases

A Cast AI diz que limitar tokens por desenvolvedor trava o trabalho e propõe medir o custo por tarefa, não o preço por token.

Seu harness de código aberto, o Kimchi, escolhe sozinho entre modelos proprietários e abertos e trocou de modelo favorito em junho, conforme a nota do resultado.

Três ferramentas completam o pacote: Ferment para tarefas longas com nota final, Teleport para sessões remotas que seguem rodando e Studio para o time dividir as sessões em um quadro Kanban.

Antes de ler

Mais 2 termos

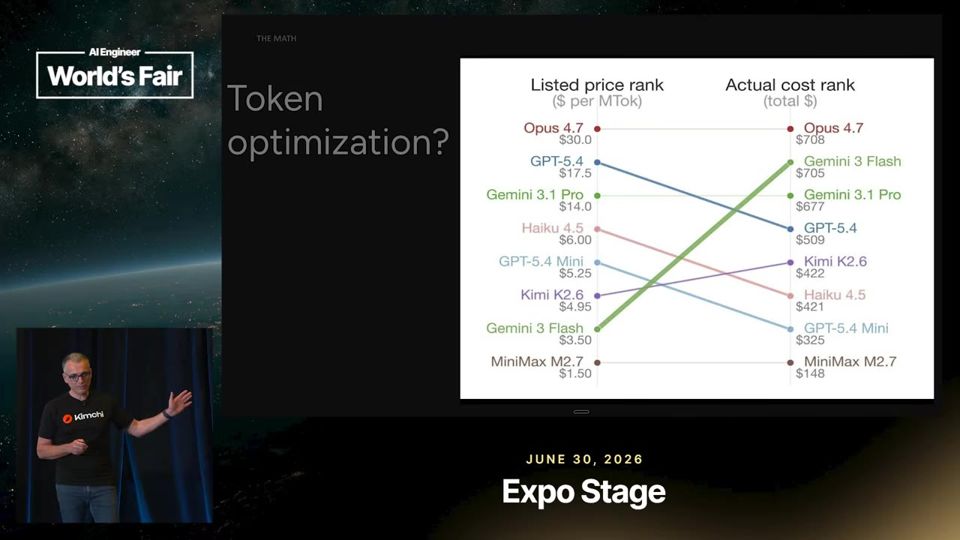
Preço por token engana, o que importa é o custo da tarefa

O palestrante mostra um estudo que compara modelos na mesma tarefa com a mesma qualidade. Um modelo de preço baixo por token pode gastar tantos tokens que a tarefa sai cara. O Minimax 2.7 custa 1,5 por milhão de tokens, mas a tarefa custou 148 dólares. A conta certa divide o gasto pelo trabalho entregue.

O modelo mais barato por token nem sempre é o mais barato por tarefa.03:23

Gasto caiu 2,5 vezes mesmo com mais tokens

Em três meses de uso interno, a Cast AI compara a conta que teria pago com um único modelo proprietário e a conta real. O número de tokens subiu 1,5 vez, e o gasto ficou 2,5 vezes menor. O argumento é que o time pode usar mais, desde que o harness escolha o modelo certo.

04:54 A curva azul paga bem menos que a roxa para o mesmo resultado.

O harness troca de modelo sozinho quando surge um melhor

Um gráfico de cores mostra qual modelo o harness mais escolheu ao longo de junho. No início do mês, o Kimi 2.6 liderava. No dia 21, o Minimax 3 assumiu. A tese é que o software testa modelos novos por custo e resultado, e uma pessoa raramente faria esse teste.

05:58 A fatia dominante muda de modelo em poucas semanas.

Mais 2 ideias deste talk

Ferment: tarefa longa em marcos, com nota final

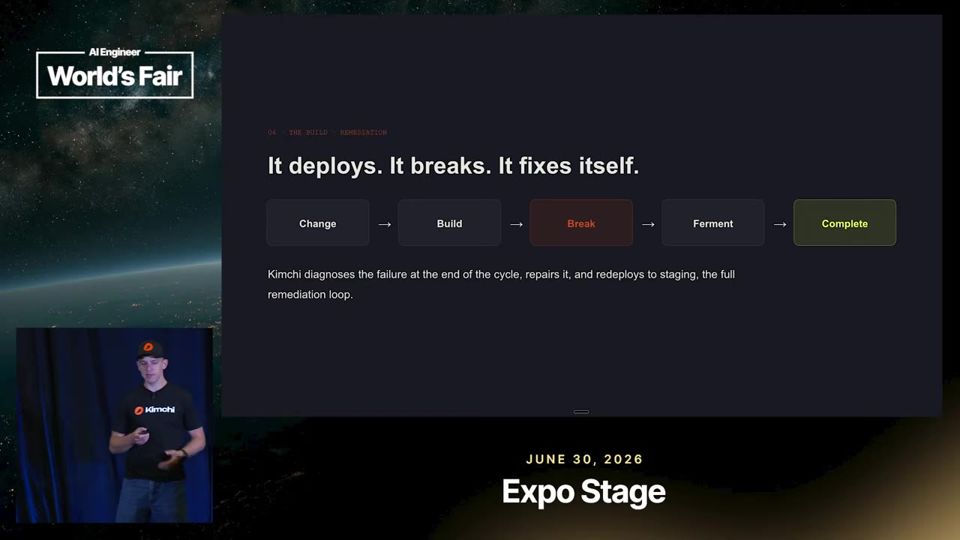
O Ferment pergunta o que você quer, divide o trabalho em marcos e roda por duas horas ou mais. Ele compila, testa, corrige e repete. Ao final dá uma nota. A tarefa só termina com nota B ou melhor, e o deploy vai para staging (ambiente de teste), onde uma pessoa ainda confere.

A nota da tarefa serve de prova de que o modelo escolhido entregou qualidade.09:01

Teleport e Studio: sessões remotas compartilhadas

O Teleport copia seu ambiente para um contêiner na nuvem e mantém o agente rodando com o notebook fechado. O Studio coloca essas sessões num quadro Kanban no navegador, com colunas como backlog, em andamento e em revisão. Colegas assumem uma sessão que pede resposta.

O time vê quais sessões esperam revisão e quem assume cada uma.15:46
leitura crítica

É um pitch de produto da própria Cast AI, que vende o Kimchi e a infraestrutura do Teleport. Os resultados vêm de 300 funcionários da empresa em três meses, sem grupo de controle nem definição de 'mesmo resultado'. A conta de 2,5 vezes compara com um custo hipotético, calculado pela própria empresa. A nota do Ferment é dada por um modelo, sem auditoria externa. O estudo do custo por tarefa não é citado com nome nem link, e a fala de um dos valores saiu confusa na legenda. O Teleport exige conta Google, o que limita a promessa de simplicidade.

O que fazer com isso

  • Calcule o custo por tarefa concluída nas suas ferramentas de IA, dividindo o gasto mensal pelo número de entregas, antes de impor limite de tokens.
  • Teste dois ou três modelos, incluindo abertos, numa mesma tarefa real e compare custo e qualidade, não só o preço por milhão de tokens.
  • Exija uma nota ou checagem automática no fim de tarefas longas de agente e mantenha uma revisão humana antes de ir para produção.
  • Avalie rodar agentes em sandbox remoto para que sessões longas continuem sem depender do notebook.

Your Coding Agent Is 6 Months Out of Date

Agente de código revisa mudanças que o modelo nunca viu. Busca na web só ajuda se houver regra de quando buscar e se o contexto vier enxuto.

Agentes 12:23 nível ●●○○○ Jakub Hojsan, Exa Assistir no YouTube (abre em nova aba)

Em 3 frases

Todo modelo tem um corte de conhecimento (knowledge cutoff) e chega ao mercado cerca de seis meses depois dele, então não conhece PRs e versões recentes de bibliotecas.

O palestrante mostra um PR que parece uma limpeza de código, mas na verdade é uma migração por atualização de dependência, algo que só a busca no changelog revela.

Segundo a Exa, o agente precisa de uma regra explícita de quando pesquisar e de trechos curtos da página, cerca de 500 caracteres, em vez da página inteira.

Antes de ler

Mais 2 termos

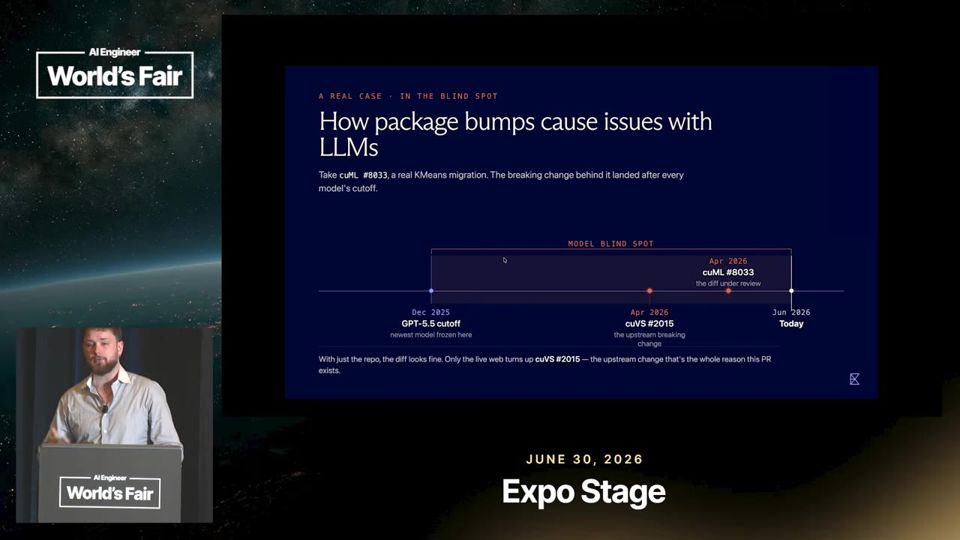
O modelo tem um ponto cego de uns seis meses

O gráfico do palestrante compara a data de corte do conhecimento com a data de lançamento dos modelos. A diferença fica perto de seis meses. Tudo o que entra nos repositórios nesse intervalo fica fora do que o modelo aprendeu, e o agente revisa esse código sem conhecê-lo.

O intervalo entre corte e lançamento fica perto de seis meses.00:40

Um PR que parece limpeza e é migração

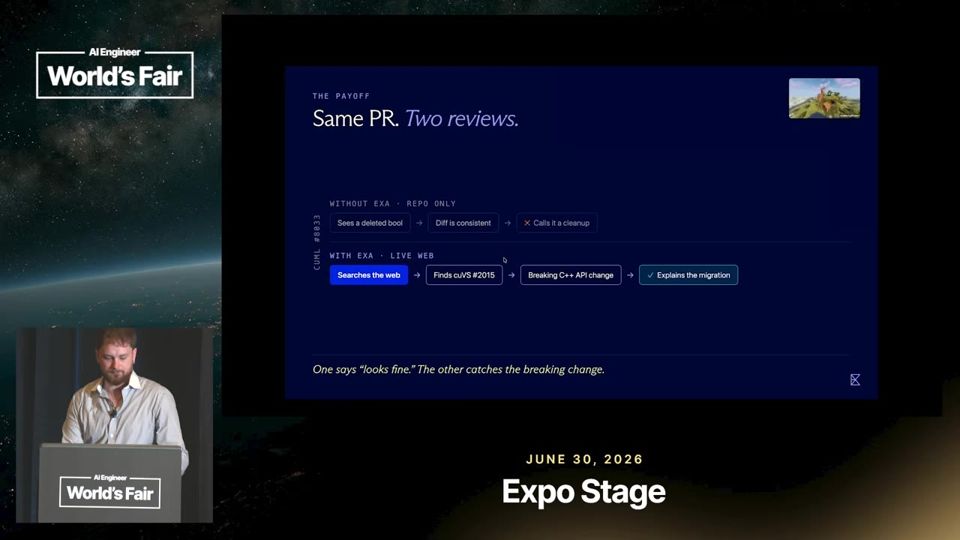
No exemplo, um PR do repositório do vector store remove um parâmetro. Sem busca, o modelo acha que é uma limpeza consistente. Com busca no changelog, aparece que a remoção vem de uma atualização de dependência com breaking change, e a revisão passa a explicar a migração.

O mesmo diff recebe diagnósticos diferentes com e sem busca.01:35

500 caracteres no lugar de 100.000

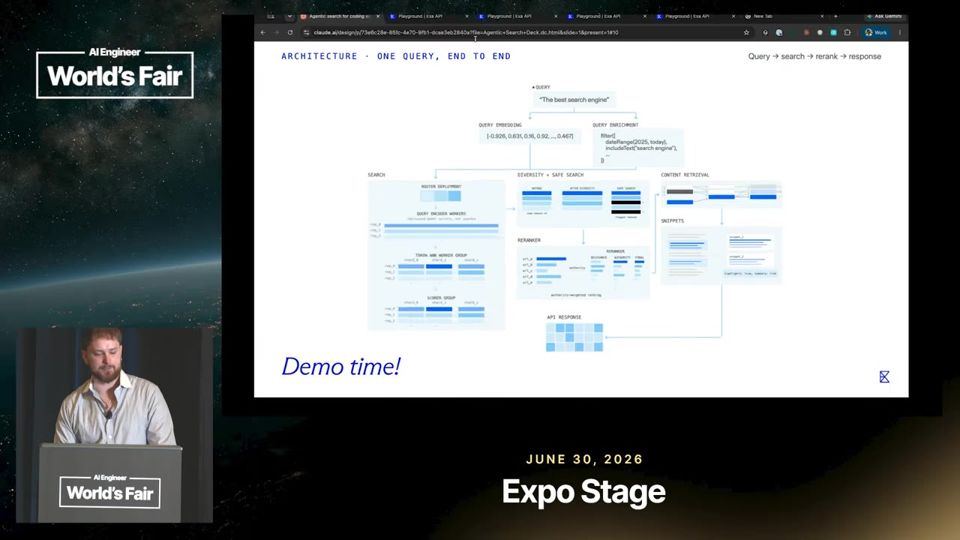
A Exa não devolve a página inteira. Um passo de interpretação reduz a página ao trecho que responde à consulta. O modelo recebe cerca de 500 caracteres, o que poupa tokens (unidades de texto cobradas pelo modelo) e deixa a resposta mais focada.

Só o trecho relevante da página segue para o modelo.02:45
Mais 2 ideias deste talk

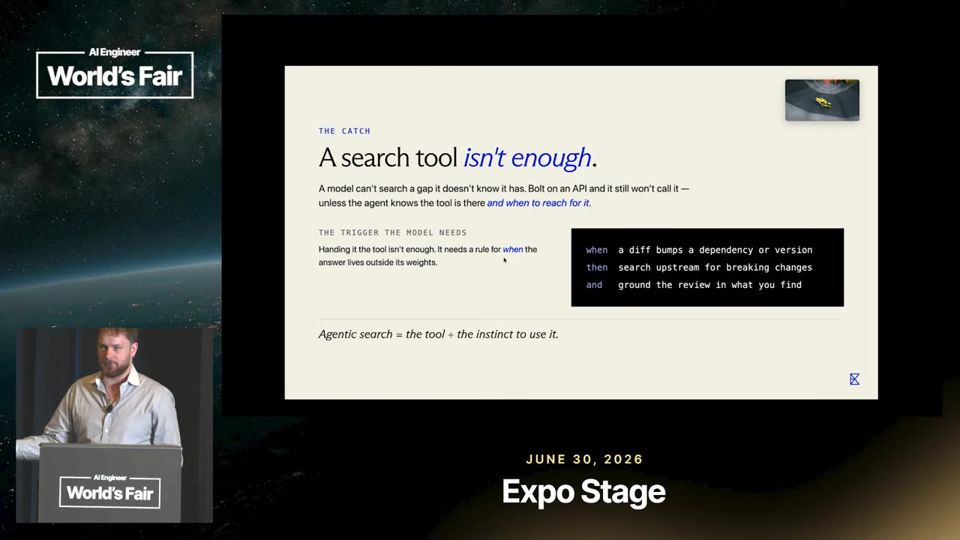
Ferramenta sozinha não basta, o agente precisa de regra

Mesmo com web search nativa no Claude Code, o modelo nega que exista uma versão nova de modelo, porque não sabe que deve verificar. A solução é dar uma regra ao agente, por exemplo, quando o diff atualiza uma dependência, consultar a fonte original e basear a revisão no que achar.

A regra de busca vem junto com a ferramenta, em duas etapas.03:45

Highlights calculados na hora, sem LLM

O destaque depende da pergunta. Na mesma página pessoal, a consulta sobre biografia traz hobbies e a consulta sobre telefone traz outro trecho. O palestrante diz que o processo é computacional, sem modelo, e por isso não acrescenta latência à busca.

A consulta muda o trecho extraído da mesma página.06:35
leitura crítica

É um pitch de produto da Exa, fornecedora de busca. A comparação com a busca nativa de OpenAI e Anthropic em custo e qualidade vem sem número, benchmark ou metodologia. O exemplo do PR é um único caso escolhido a dedo. O problema do corte de conhecimento é real, mas outras ferramentas de busca também o resolvem. A frase sobre latência zero se refere só à extração dos trechos.

O que fazer com isso

  • Se você usa agente de código ou de revisão, escreva uma regra no prompt do sistema para consultar changelog ou docs oficiais quando o diff mexer em versão de dependência.
  • Teste o agente com um PR recente, posterior ao corte do modelo, com e sem busca, e compare os diagnósticos antes de confiar na revisão.
  • Ao escolher uma ferramenta de busca, verifique se ela devolve o trace (consultas, fontes e trechos) para você depurar quando a resposta sair errada.
  • Peça trechos curtos em vez de páginas inteiras ao alimentar o modelo, para gastar menos tokens.

MCP Doesn't Suck. Your Agent Does.

O inchaço de contexto vem de clientes MCP ingênuos. Com descoberta progressiva e execução como código, MCP e CLI se somam.

Agentes 18:43 nível ●●●○○ Jan Čurn, Apify Assistir no YouTube (abre em nova aba)

Em 3 frases

Jan Čurn, CEO da Apify, diz que as críticas ao MCP (Model Context Protocol, o padrão que liga agentes a ferramentas) miram o alvo errado. O consumo excessivo de contexto vem de agentes que carregam todas as ferramentas de uma vez.

Ele apresenta três correções do mercado (subagentes, descoberta progressiva de ferramentas e Code Mode) e explica por que agentes se dão bem com CLIs (programas de linha de comando): já conhecem o shell e usam os comandos aos poucos.

A proposta é usar MCP para acesso remoto e autenticado, e uma CLI para o uso local. Ele demonstra o mcpc, cliente CLI de código aberto da Apify, e mostra testes iniciais em que mcpc e CLI ficam parecidos e o MCP puro gasta mais tokens.

Antes de ler

Mais 2 termos

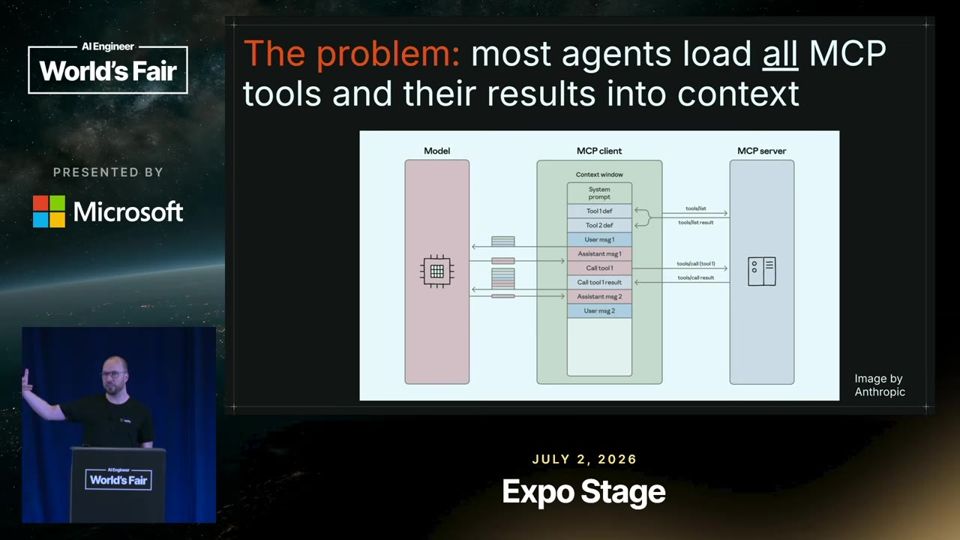
O inchaço de contexto é bug do harness

Quem registra todas as ferramentas de dez servidores MCP no início da conversa perde cerca de um terço da janela de contexto antes da primeira pergunta. Čurn lembra que a especificação do MCP não diz nada sobre como montar o harness (a estrutura que roda o agente). Quem constrói o agente decide como usar o protocolo.

Carregar 100 ferramentas de uma vez consome o contexto antes do trabalho começar.02:47

Três correções: subagentes, descoberta progressiva e Code Mode

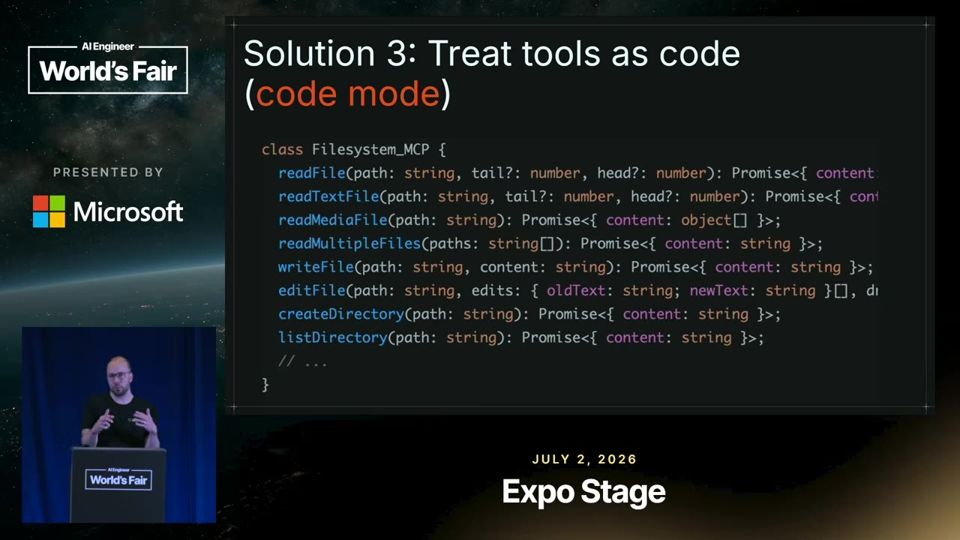
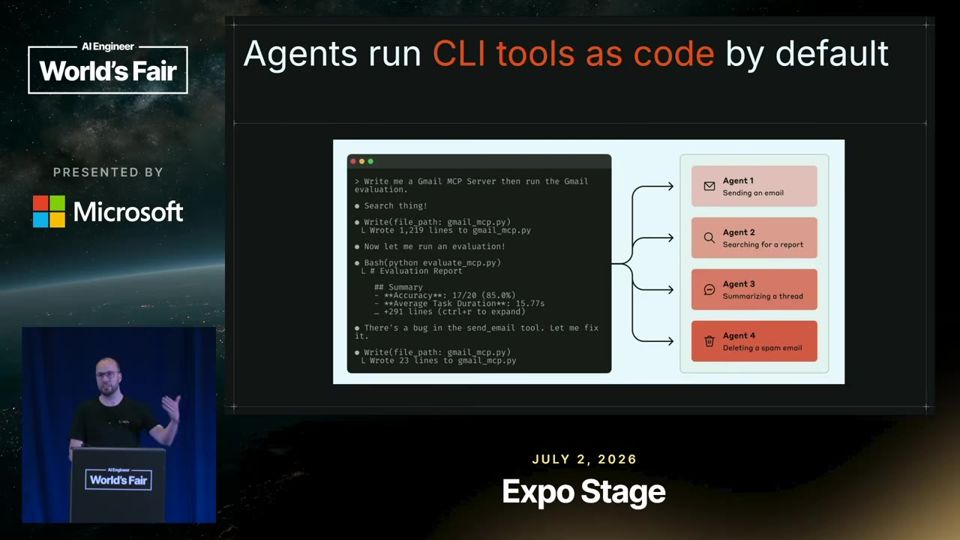
Subagentes isolam o contexto, mas o custo em tokens continua e dados sensíveis ainda circulam. A descoberta progressiva (a ferramenta tool search da Anthropic) carrega só as ferramentas necessárias. O Code Mode, da Cloudflare, transforma ferramentas MCP em código que o modelo navega com grep. Segundo Čurn, modelos escrevem código melhor do que chamam ferramentas, porque tool calling é uma construção artificial.

No Code Mode, as ferramentas viram código que o modelo consulta sob demanda.05:51

Por que agentes preferem CLIs

O agente nunca carrega uma CLI inteira no contexto. Ele chama o comando só quando precisa, lê o help se for preciso e já conhece o shell dos dados de treino. Rodar CLI é Code Mode por padrão. O ponto fraco é a falta de protocolo padrão de transporte, de autenticação e de observação, o que complica o uso em empresas e o acesso remoto.

O shell aparece muito nos dados de treino, e os modelos o usam bem.08:27
Mais 2 ideias deste talk

mcpc: MCP escondido atrás de um comando bash

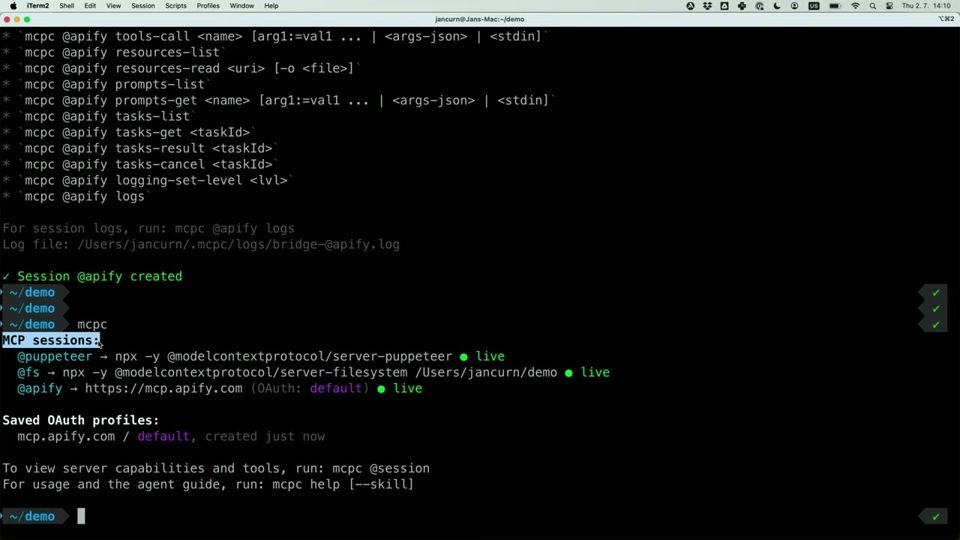
O mcpc é um cliente CLI leve, sem LLM, que envolve o protocolo MCP. Na demo, Čurn conecta um servidor local por stdio e um servidor remoto com login OAuth, guarda credenciais no chaveiro do sistema e mantém sessões persistentes. O comando grep busca ferramentas, a flag de JSON permite encadear com jq e o suporte a tarefas assíncronas deixa o trabalho rodando no servidor.

A busca por grep faz a descoberta progressiva de ferramentas na linha de comando.14:40

Connector Evals compara MCP, CLI e mcpc

A Apify criou um framework que compara conectores, não agentes. Nos gráficos de tempo contra custo em tokens, mcpc e CLI ficam parecidos e o MCP puro termina antes, mas gasta mais tokens. O próprio palestrante diz que os testes ainda são iniciais.

No gráfico, mcpc e CLI ficam próximos e o MCP puro gasta mais tokens.17:20
analogia

Code Mode (tratar ferramentas MCP como código que o modelo escreve e navega). Code Mode é como dar ao cozinheiro um livro de receitas com índice para ele consultar quando precisar, em vez de ler todas as receitas em voz alta antes de ele começar a cozinhar.

  1. Um agente de IA usa ferramentas para agir, como buscar dados ou mandar um e-mail. Em geral, ele recebe a descrição de todas as ferramentas antes de começar o trabalho.
  2. No Code Mode, ideia lançada pela Cloudflare, as ferramentas MCP (Model Context Protocol, o padrão que liga agentes a ferramentas) viram código, organizado como os arquivos de um programa.
  3. O modelo procura nesse código só o que precisa. Ele usa buscas como o grep (comando que acha texto em arquivos) e lê apenas a definição da ferramenta certa.
  4. Depois o modelo escreve um pequeno programa que chama as ferramentas. Assim, a janela de contexto (a memória de trabalho do modelo) recebe menos texto e gasta menos tokens.
  5. A ideia funciona porque os modelos viram muito código no treino. O tool calling (chamada de ferramentas) é uma habilidade artificial, ensinada com dados sintéticos.
FERRAMENTAS VIRAM CÓDIGOservidor MCP convertido em arquivos
MODELO BUSCA COM GREPlê só a definição necessária
MODELO ESCREVE O SCRIPTo código chama as ferramentas
CONTEXTO ENXUTOmenos tokens, mais precisão

Ajuda saber antes: MCP, Tool calling, Janela de contexto, Progressive tool discovery

leitura crítica

Čurn é fundador da Apify e vende o mcpc, então o talk funciona também como pitch de produto. Os tuítes citados como críticas ao MCP servem de espada de palha, sem dados. Os resultados do Connector Evals são da própria empresa, aparecem só em gráficos rápidos, sem número de tarefas, sem repetições e sem margem de erro, e o palestrante os chama de iniciais. Ele não explica por que o MCP puro termina antes. A afirmação de que modelos escrevem código melhor do que chamam ferramentas não vem com medição.
O que fazer com isso

  • Verifique se o seu cliente de agente carrega todas as ferramentas MCP no início. Se carregar, ative a busca de ferramentas sob demanda, se existir, ou reduza os servidores conectados.
  • Use MCP para serviços remotos que exigem login e permissões, e CLI para tarefas locais como arquivos e scripts.
  • Teste o mcpc com um servidor MCP que você já usa e compare tokens e tempo com a CLI equivalente, antes de confiar nos gráficos do fornecedor.
  • Evite devolver senhas e dados grandes de ferramentas direto ao contexto. Prefira JSON encadeado em script, como no uso do jq.

Why AI Didn't Actually Make You Ship Faster

Se a IA escreve código mais rápido do que gente revisa, a verificação vira o gargalo. Gravar fluxos reais e comparar telas antes e depois seria a saída.

Engenharia de software 11:15 nível ●●●○○ Gabriel Spencer-Harper, Meticulous Assistir no YouTube (abre em nova aba)

Em 3 frases

O palestrante diz que agentes de código escrevem mais rápido do que as equipes conseguem revisar, então verificar passou a ser o gargalo do envio.

Testes com assertions (afirmações escritas à mão) não cobrem o espaço de regressões possíveis. A Meticulous grava fluxos de usuário, repete cada um antes e depois da mudança e mostra as diferenças em imagens.

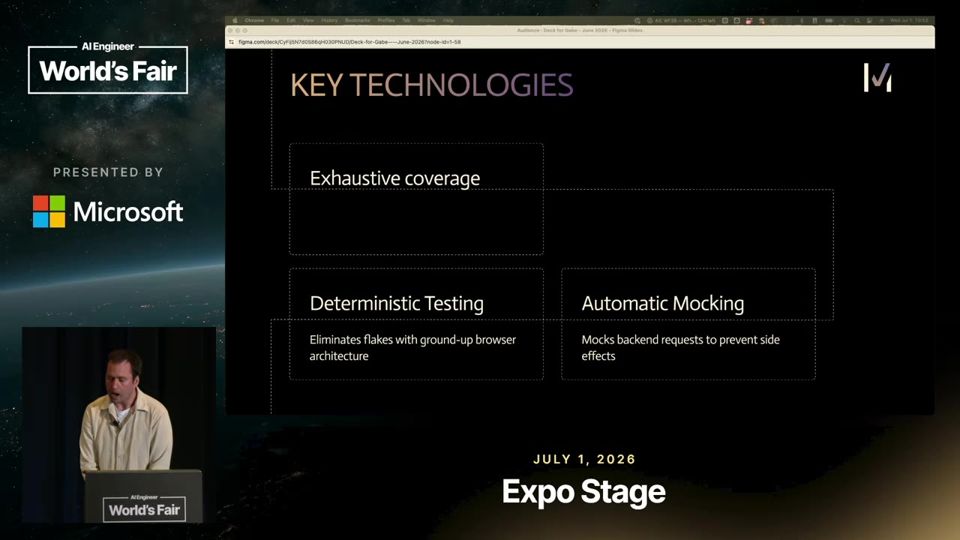
A ferramenta se apoia em três peças: rede simulada, navegador determinístico e escolha de fluxos guiada por cobertura de código. O talk é demonstração de produto, sem dados independentes.

Antes de ler

Mais 2 termos

Verificar virou o gargalo

Quando o agente gera código em minutos, alguém na empresa ainda precisa conferir o que mudou. O palestrante afirma que sem verificação exaustiva você escolhe entre velocidade e bugs. A pergunta de teste é se você apertaria o botão de merge num pull request escrito por IA. Na maioria das empresas, a resposta seria não.

Define o problema central do talk, a revisão como gargalo.02:04

Assertions não cobrem tudo

Um teste com assertion exige que alguém defina de antemão o comportamento correto. O palestrante argumenta que o espaço de regressões possíveis é grande demais para isso. Ele cita combinações de feature flags, papéis, permissões e configurações que ninguém checa à mão. Também aponta tempo gasto em suítes de testes end-to-end, flakes e revisão manual.

Lista o custo de depender só de testes escritos à mão.03:04

Gravar, repetir e comparar telas

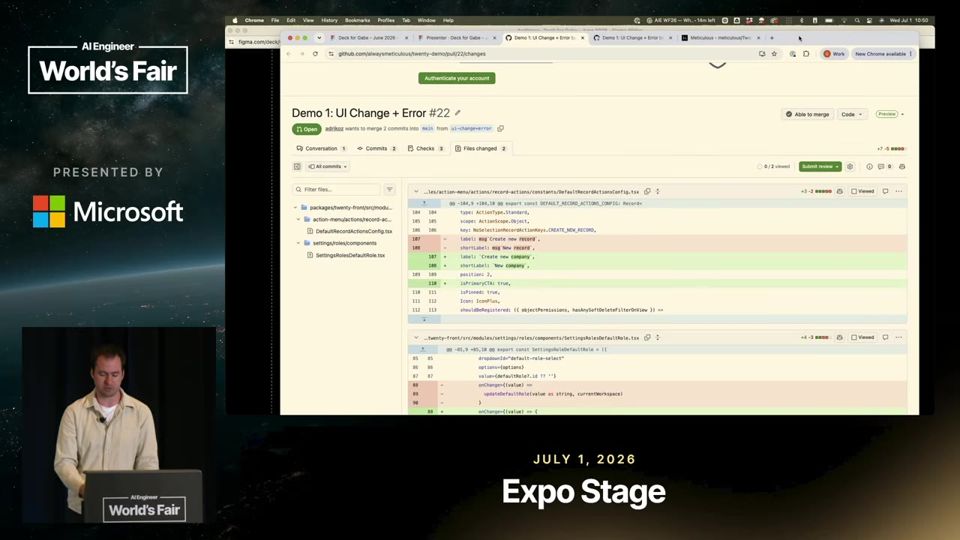
Um trecho de JavaScript roda em ambientes que não são de produção e grava fluxos de uso, como clicar em login ou abrir um painel. No pull request, a ferramenta repete um subconjunto desses fluxos e tira capturas de tela a cada passo, antes e depois do código novo. Ela compara as duas sequências. Quem revisa, pessoa ou agente, decide se cada diferença era esperada.

Mostra o formato do resultado, diferenças e não veredito de bug.05:41
Mais 2 ideias deste talk

Rede simulada e navegador determinístico

Na gravação, todas as requisições e respostas de rede são salvas e depois reaplicadas. Isso torna o teste repetível e isolado, e permite rodar em paralelo. A segunda peça é um navegador alterado para eliminar fontes de aleatoriedade, como relógio da CPU e a ordem de timers. O palestrante diz que isso reduz muito os testes flaky (que falham sem motivo), mas não mostra medições.

Explica por que as repetições devem dar o mesmo resultado.07:14

Cobertura de código que mede teste de verdade

A ferramenta repete cada fluxo gravado na branch principal e registra quais linhas rodam. Com esse mapa, escolhe o subconjunto de fluxos que cobre mais código. Segundo o palestrante, cobertura costuma enganar, porque um teste pode passar por todo o código com uma só assertion. Com captura de tela a cada passo, ele afirma que cobrir equivale a testar.

Mostra como a ferramenta escolhe quais fluxos repetir.08:48
leitura crítica

É pitch de produto do CEO da Meticulous, feito em estande de conferência. As alegações de zero esforço do desenvolvedor, de ordens de grandeza menos flakes que Cypress e Playwright e de verificação exaustiva não têm dados, benchmark ou comparação independente. Os clientes citados aparecem como lista de logos. A ferramenta mostra diferenças visuais, então não detecta erros sem efeito na tela, como lógica de back-end. Alguém ainda precisa revisar cada diff.

O que fazer com isso

  • Meça quanto tempo da sua equipe vai para revisão manual e manutenção de testes antes de culpar a IA pela falta de velocidade.
  • Teste a pergunta do talk em casos reais. Você apertaria merge num pull request gerado por IA? Se não, liste o que você checaria à mão.
  • Ao avaliar ferramentas de teste visual, peça medição de testes flaky e de falsos alertas em seu próprio código, não só a demonstração do fornecedor.
  • Desconfie de cobertura de código como único indicador. Verifique se os testes têm assertions que realmente checam o resultado.

Your LLM App Returned 200 OK. It Was Still Wrong.

Latência e taxa de erro dizem que o app está no ar. Para app de IA, acrescente custo, segurança e qualidade ao monitoramento.

Evals 18:00 nível ●●○○○ Marina Petzel, Datadog Assistir no YouTube (abre em nova aba)

Em 3 frases

Marina Petzel, da Datadog, diz que os quatro sinais clássicos (latência, erros, tráfego e saturação) continuam necessários, mas não mostram se a resposta de um app de IA generativa está certa.

Ela propõe três camadas extras de monitoramento. Custo (token creep, troca de modelo, chamadas sem cache), segurança (prompt injection, vazamento de dados pessoais, toxicidade, jailbreak) e qualidade (alucinação, relevância, satisfação, completude, qualidade do RAG).

O final vira propaganda do produto Agent Observability da Datadog, e os alvos numéricos citados vêm sem fonte ou metodologia.

Antes de ler

Mais 2 termos

Status 200 não garante resposta certa

Num app tradicional, a mesma entrada gera a mesma saída, então teste de regressão basta. Num app de IA, o mesmo prompt gera respostas diferentes. Um 200 OK do servidor só diz que a requisição funcionou, não que a resposta ajudou ou estava correta. Por isso a qualidade precisa ser avaliada continuamente em produção.
Mostra por que o status HTTP não mede a qualidade da resposta.02:38

Três vazamentos silenciosos de custo

Token creep é aumentar o contexto aos poucos, sem revisão financeira. Troca de modelo para um mais caro mantém o volume e muda a conta. Chamadas repetidas sem cache pagam várias vezes pela mesma resposta. A palestrante sugere acompanhar as três camadas para achar o problema cedo.

Lista as três causas de custo e quanto cada uma pode pesar.05:18

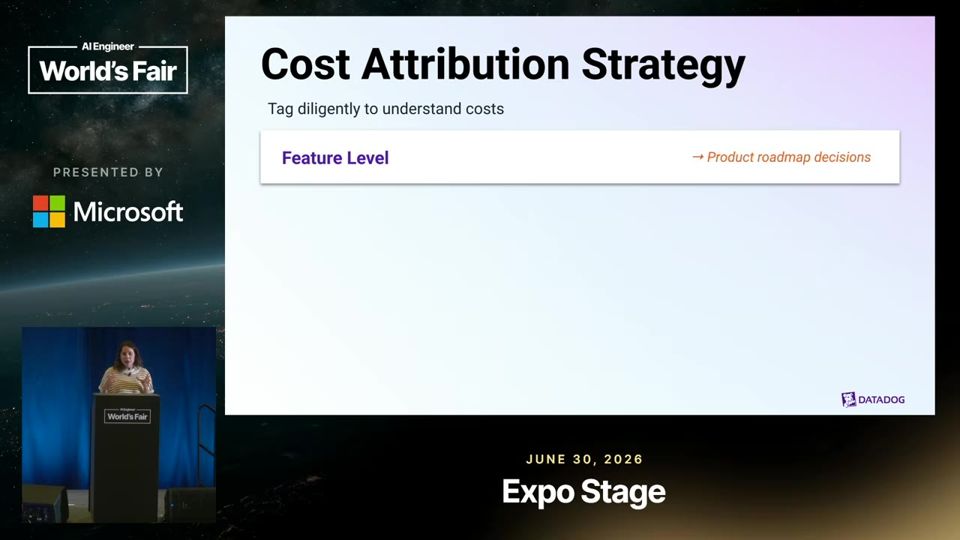
Etiquete tudo em quatro níveis

Sem tags, as interações com os agentes ficam indiferenciadas e ninguém sabe o que gera o gasto. A proposta tem quatro níveis. Funcionalidade (chat, resumo), usuário ou organização (cobrança interna e detecção de abuso), modelo e provedor, e endpoint (região, produção ou staging).

Mostra o esquema de tags que permite atribuir custo a cada parte.07:26
Mais 2 ideias deste talk

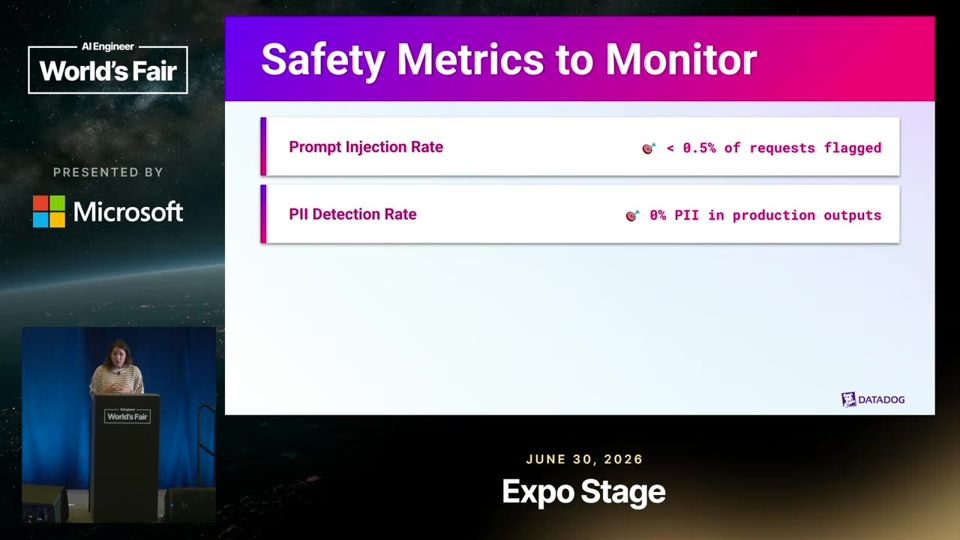
Quatro métricas de segurança com meta rígida

Para injeção de prompt, a recomendação é usar casos de detecção por padrões ou classificadores. Para dados pessoais (PII), regex ou reconhecimento de entidades, com meta de 0% nas saídas de produção. Toxicidade pede classificador e limiares claros. Tentativas de jailbreak devem ser bloqueadas em 100% dos casos, segundo ela.
Resume o que medir em segurança e a meta proposta.10:37

Cinco métricas de qualidade

Taxa de alucinação (respostas com afirmações sem base nos dados), relevância (por similaridade de embeddings), satisfação do usuário (joinha, estrelas, NPS), completude (avaliada por um LLM juiz) e qualidade da recuperação no RAG (top-k e NDCG). Juntas, dão uma visão multidimensional da qualidade.

Lista as cinco métricas de qualidade e como medir cada uma.13:10
leitura crítica

A palestra termina em pitch do Agent Observability da Datadog, com estande e teste grátis, então o enquadramento favorece vender monitoramento. Os alvos (0% de PII, 100% de bloqueio de jailbreak, mais de 80 a 85% de feedback positivo) saem sem fonte, e metas de 100% são irreais na prática. Os 70% de gasto redundante vêm de pesquisa interna sem amostra ou método. O multiplicador de 8x e o salto de 15x no preço dependem do caso e dos modelos citados, e a palestrante não mostra demo nem dados reais.
O que fazer com isso

  • Etiquete cada chamada ao modelo com funcionalidade, usuário ou organização, modelo e ambiente. Sem isso você não sabe o que gera o gasto.
  • Antes de ampliar o contexto ou trocar para um modelo mais caro, estime o impacto na conta mensal e peça revisão financeira.
  • Meça a taxa de respostas repetidas para a mesma consulta e avalie colocar cache nelas.
  • Escolha duas métricas de qualidade para começar, como joinha do usuário e taxa de alucinação por amostra revisada à mão, e acompanhe junto com latência e erros.

The 5 Levels of Self-Driving Production

Agentes de código aceleram o desenvolvimento e empurram o custo para a produção, onde achar a causa raiz exige vários saltos de raciocínio.

Agentes 18:33 nível ●●●○○ Eric Schwartz, Traversal Assistir no YouTube (abre em nova aba)

Em 3 frases

Com agentes de código, as equipes escrevem mais código e entendem menos dele, então gastam mais tempo investigando falhas em produção.

Eric Schwartz, da Traversal, propõe cinco níveis de autonomia, do war room manual (nível 0) ao ciclo fechado que diagnostica, corrige e verifica sozinho (nível 5).

Ele mostra dois casos, PepsiCo e American Express, e fecha com cinco perguntas para avaliar qualquer AI SRE (agente de confiabilidade de sistemas).

Antes de ler

Mais 2 termos

Mais código gera mais troubleshooting

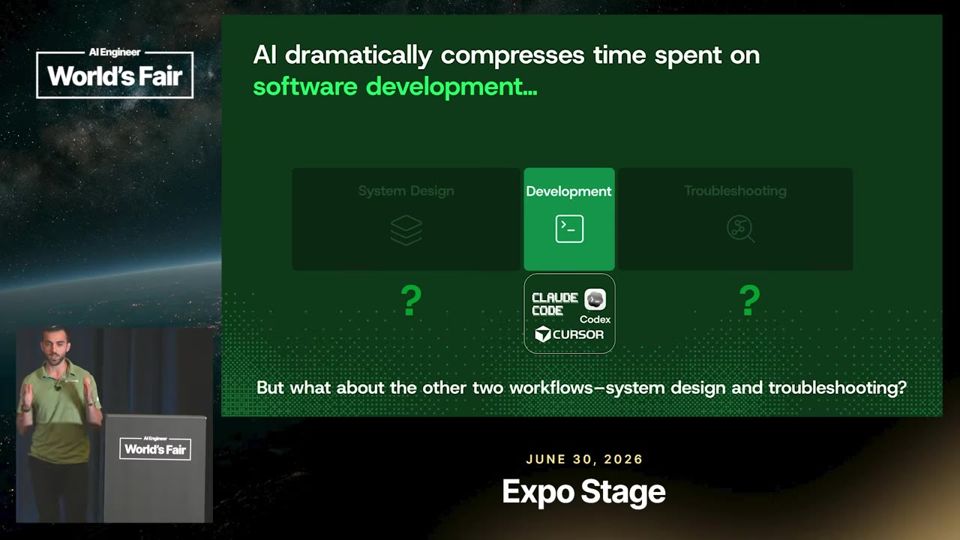
Engenharia de software tem três blocos: desenho do sistema, desenvolvimento e troubleshooting (investigação de falhas). Os agentes de código encolheram o segundo. Em vez de sobrar tempo para desenhar, as equipes que Eric acompanha gastam mais tempo apagando incêndio, porque entendem menos do código que sobe.

O desenvolvimento encolhe e o troubleshooting cresce.01:34

Causa raiz exige vários saltos

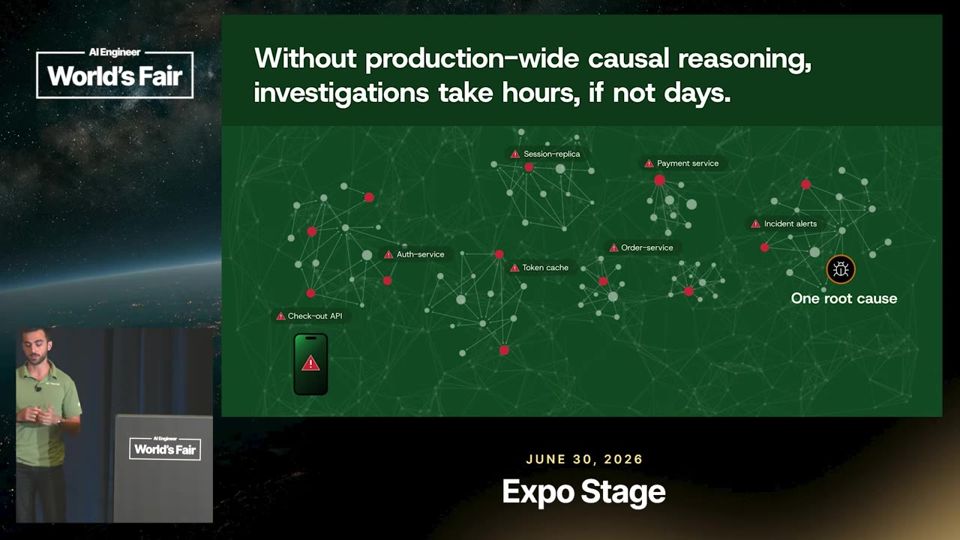
Dashboards dizem o que quebrou, não o porquê. Num exemplo de cliente, uma API de checkout falha e a causa é um certificado TLS expirado a cinco ou dez saltos de distância, no meio de dezenas de serviços. Ninguém numa empresa grande conhece a pilha inteira, então surge a sala de guerra com 50 engenheiros.

A causa fica longe do sintoma, em vários saltos.04:39

Os cinco níveis de produção autônoma

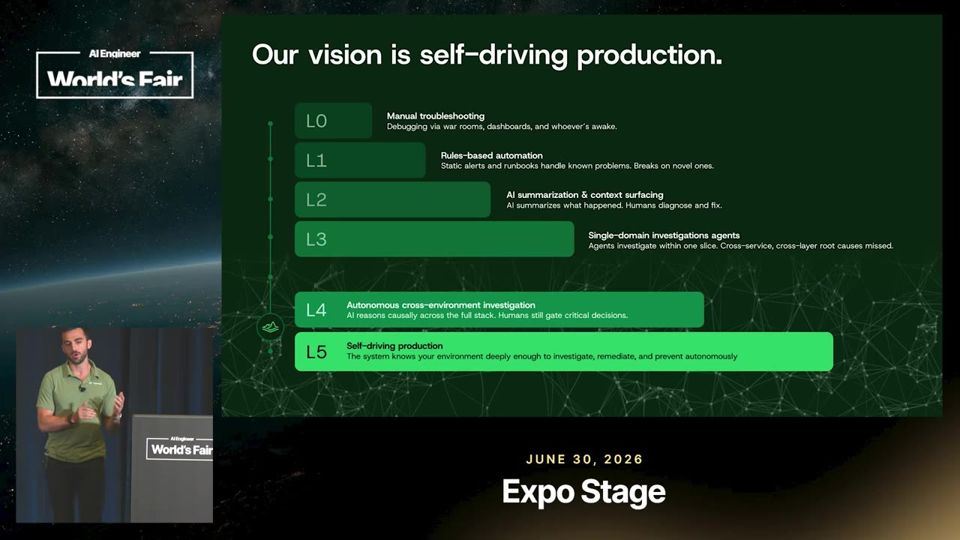
Nível 0 é tudo manual. Nível 1 usa regras e automações, que falham diante de situações novas sem runbook. Os níveis 2 e 3 trazem agentes caseiros para um serviço ou conjunto de alertas. O nível 4 cobre o ambiente inteiro, com centenas de serviços e repositórios. O nível 5 também propõe a correção e verifica.

A escala vai do war room manual ao ciclo fechado.07:20
Mais 2 ideias deste talk

Alertas e incidentes nos casos reais

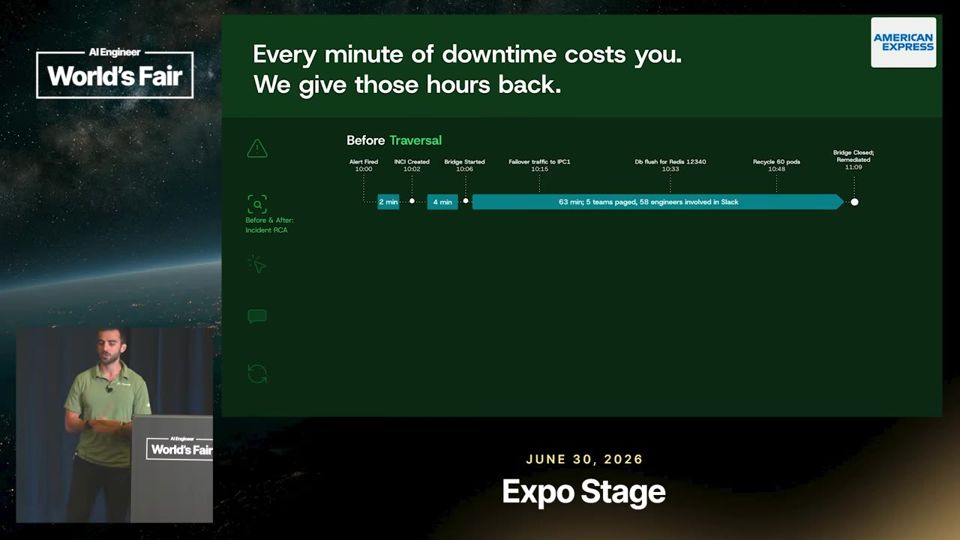
Na PepsiCo, um engenheiro chegava a ter 700 alertas pendentes e passou a receber uma lista priorizada e já investigada. Na American Express, a Traversal é a primeira a responder cada incidente e posta a análise de causa raiz no Slack em até 3 minutos, o que evita paginar dezenas de engenheiros.

A análise automática chega antes de chamar as equipes.13:31

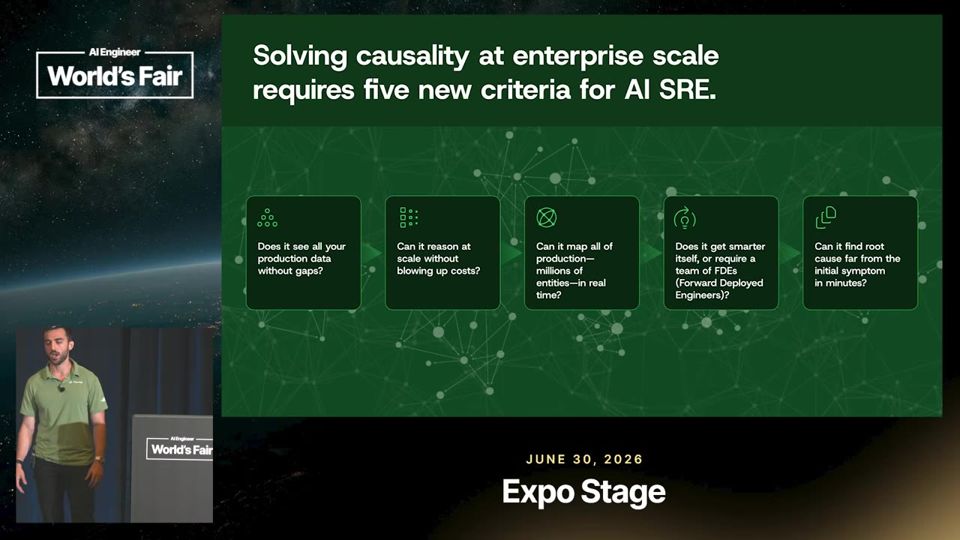
Cinco perguntas para avaliar um AI SRE

Veja se o agente enxerga todos os dados de produção, se busca neles sem estourar custo, se mapeia relações entre entidades, se melhora sozinho sem arquivos markdown mantidos à mão e se faz vários saltos rápido. Para Eric, passar de 5 minutos já faz o time de plantão voltar aos hábitos antigos.

Checklist de compra para qualquer agente de SRE.15:04
analogia

Production world model (modelo do mundo da produção). Um modelo do mundo da produção é como o mapa de metrô de uma cidade, que mostra quais estações se ligam a quais e permite seguir o caminho de um atraso até a estação onde ele começou.

  1. Uma empresa grande roda centenas de sistemas que dependem uns dos outros. Quando um quebra, o defeito pode aparecer em outro, bem longe dali.
  2. O modelo do mundo da produção é um mapa dessas dependências. Ele registra que o checkout chama o serviço de pagamento, que usa um banco de dados, que depende de um certificado.
  3. Para montar o mapa, o agente lê logs (registros de eventos), métricas, traces (rastros de uma requisição entre serviços) e repositórios de código, e liga cada peça às outras.
  4. Na Traversal, esse mapa fica no meio da pilha. Embaixo está a coleta dos dados sem estourar custo. Em cima está a entrega ao time, em alertas priorizados ou análises no Slack.
  5. Com o mapa pronto, a causal search engine (motor de busca causal) percorre as ligações em vários saltos e chega à causa raiz em minutos. O mapa se atualiza sozinho, sem arquivos de documentação mantidos à mão.
COLETA DOS DADOSLogs, métricas, traces e código
MAPA DE RELAÇÕESLiga serviços, bancos e certificados
BUSCA CAUSALAgente segue as ligações em saltos
CAUSA RAIZDiagnóstico em poucos minutos

Ajuda saber antes: Observability, Root cause analysis (RCA), Microsserviços, Grafo de dependências

leitura crítica

O talk é pitch de produto da Traversal, feito por um product manager. Os casos de PepsiCo e American Express vêm da própria empresa, sem metodologia nem grupo de comparação. O número de 80% de causa raiz acertada não diz como foi medido nem o que conta como acerto. Os cinco níveis são uma escala criada pela empresa, com o nível 5 como ponto de chegada do próprio produto. As cinco perguntas finais favorecem o que a Traversal já vende. O talk não mostra falhas, custos nem exemplos de diagnóstico errado.

O que fazer com isso

  • Classifique a sua operação nos níveis 0 a 5 e anote o que falta para subir um nível, por exemplo runbooks atualizados.
  • Meça o tempo médio para achar a causa raiz e quantas pessoas são chamadas por incidente, antes de comprar qualquer ferramenta de AI SRE.
  • Ao avaliar um fornecedor, use as cinco perguntas do talk e peça uma prova com incidentes antigos seus, não com os casos do pitch.
  • Revise as regras de alerta com mais ruído e decida o que dispensar, o que virar ticket e o que merece atenção imediata.

Why 99% Accurate Browser Agents Still Fail

Agente de navegador falha por acumular passos. Tire do modelo tudo que é determinístico e meça sucesso por transação, não por execução.

Agentes 16:49 nível ●●●○○ Derek Meegan, Browserbase Assistir no YouTube (abre em nova aba)

Em 3 frases

Um agente de navegador só entrega valor quando termina todos os passos, e cada passo soma custo e risco. Com 99% de acerto por passo, uma tarefa de 100 passos dá certo cerca de 36% das vezes.

Derek Meegan propõe medir sucesso por transação, com retentativas, e priorizar nesta ordem: desempenho, custo e manutenção. Os dois últimos viram problema de otimização quando o primeiro está resolvido.

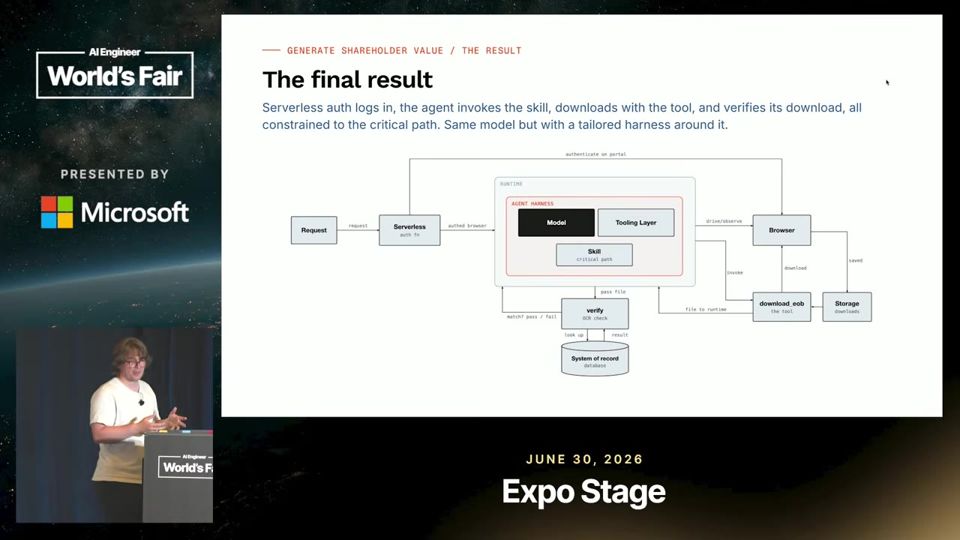
O caso de um portal de plano de saúde mostra a receita. Ferramenta de download determinística, verificação por OCR, login fora do modelo e uma skill com o caminho crítico reduzem os passos que o agente decide.

Antes de ler

Mais 2 termos

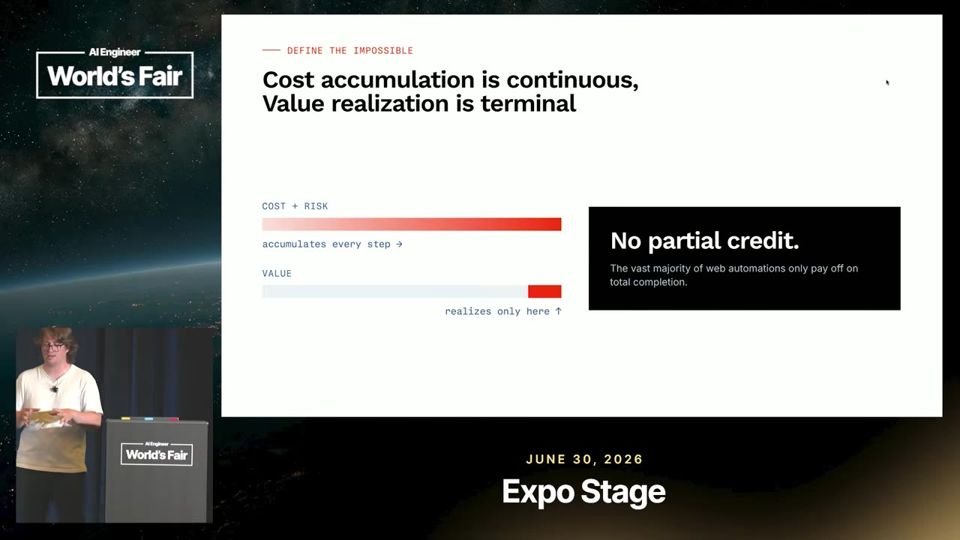
Sem crédito parcial: custo contínuo, valor só no fim

Cada passo do agente gera custo e risco novos, mas o valor só aparece quando a tarefa inteira termina. O palestrante chama isso de ausência de crédito parcial. A maioria das automações web cai nesse caso, e por isso trajetórias longas são frágeis.

Custo e risco crescem a cada passo, valor só no último.04:41

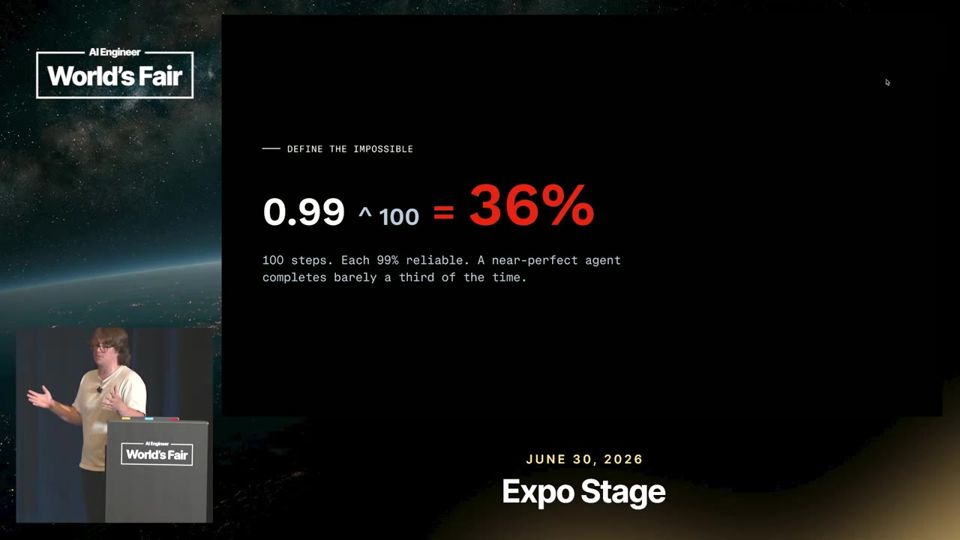
A conta do 99% que vira 36%

Se cada passo acerta 99% das vezes de forma independente, 100 passos seguidos dão sucesso total perto de 36%. Um modelo melhor ajuda, mas não resolve sozinho. A saída é encurtar a trajetória e permitir retentativas.

A probabilidade composta derruba a confiabilidade de trajetórias longas.05:22

Meça por transação, não por execução

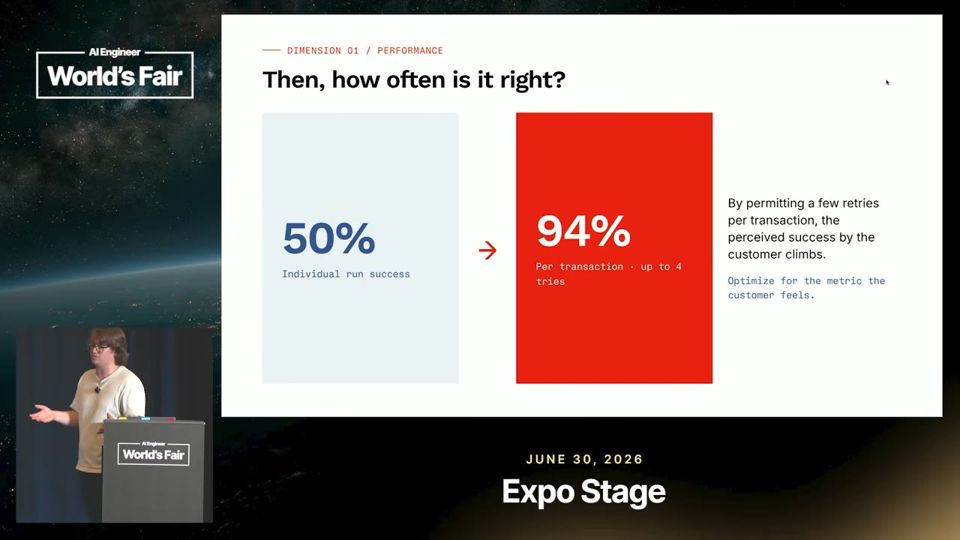
Um agente com 50% de sucesso por execução chega a 94% por transação se puder tentar de novo, segundo o palestrante. O cliente quer o trabalho concluído, não o número de tentativas. Sucesso deve ser um artefato concreto, como recibo, ID de pedido ou registro consultável.

Retentativas elevam o sucesso por transação sem mudar o modelo.08:54
Mais 2 ideias deste talk

Custo e manutenção ao longo do tempo

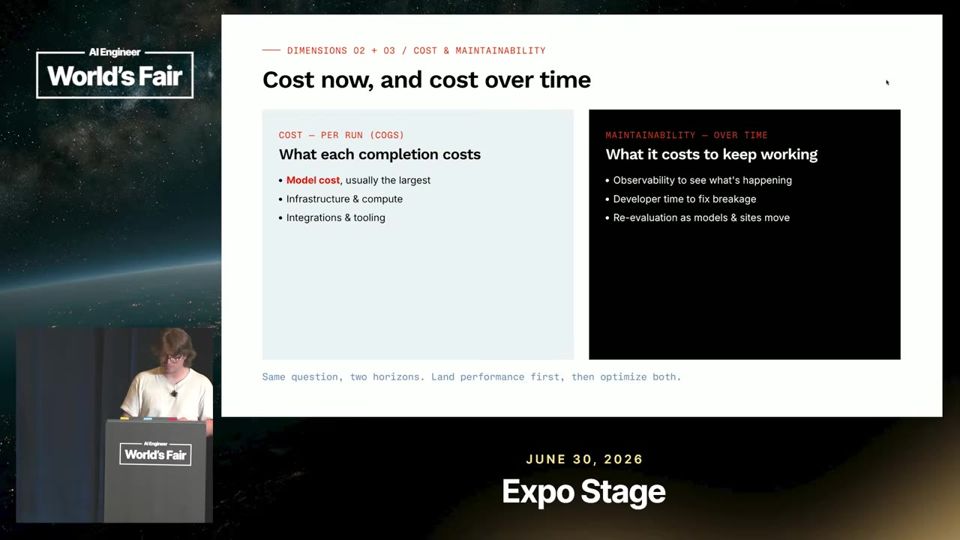
Custo por execução hoje é sobretudo modelo, mas Meegan espera que ele pese menos com a queda de preço. Sobram infraestrutura, integrações, observabilidade, tempo de desenvolvedor e reavaliação quando sites e modelos mudam. Os riscos são antibot, mudança de tarefa, API nova e desvio do modelo.

O custo de um agente em produção vai além da conta do modelo.09:32

Arquitetura do portal de plano de saúde

O sistema final começa com um agente simples e vai tirando responsabilidades dele. Entram uma ferramenta de download em uma só chamada, uma ferramenta de OCR que confere o documento contra o sistema de registro, uma função de login separada e uma skill que descreve o caminho crítico. O agente decide menos e acerta mais.

Diagrama final que tira passos determinísticos do modelo.15:39
leitura crítica

O talk vem da Browserbase, que vende infraestrutura de navegador, então o enquadramento favorece agentes em produção. Os 36% são uma conta teórica que supõe passos independentes, o que raramente vale na prática. Os 50% que viram 94% por transação também supõem tentativas independentes e, com quatro retentativas, dariam cerca de 97%. Não há dados reais do portal de saúde, nem custo, taxa de sucesso ou tempo de manutenção medidos. A arquitetura é plausível, mas não passa de um desenho ilustrativo.

O que fazer com isso

  • Meça a taxa de sucesso do seu agente por transação concluída, com artefato verificável como recibo, ID ou registro, e registre também o sucesso por execução.
  • Liste os passos do seu fluxo que nunca mudam, como login e download, e mova cada um para uma função determinística fora do modelo.
  • Dê ao agente uma ferramenta de verificação que compare o resultado com um sistema de registro, para ele saber se terminou certo.
  • Escreva uma skill com o caminho crítico da tarefa e reavalie quando o site ou o modelo mudar.

Lessons from Generating 12 Trillion Synthetic Tokens

Gerar trilhões de tokens sintéticos depende mais de engenharia de dados e GPUs do que do prompt; os gargalos ficam no S3, nas falhas e no agendamento.

Infraestrutura 20:31 nível ●●●●○ Bogdan Gaza, DatologyAI Assistir no YouTube (abre em nova aba)

Em 3 frases

A web tem cerca de 30 trilhões de tokens úteis, e a DatologyAI completa o que falta reescrevendo documentos de alta qualidade com LLMs (receita BeyondWeb).

A empresa saiu de um cluster Slurm separado para um pipeline único com Ray, KubeRay e vLLM em Kubernetes na AWS (EKS on HyperPod).

Quatro gargalos apareceram em escala: metadados no S3, GPUs que falham, agendamento entre clusters e ajuste do vLLM, e cada um tem uma solução simples de engenharia.

Antes de ler

Mais 2 termos

Reescrever documentos reais em vez de gerar do zero

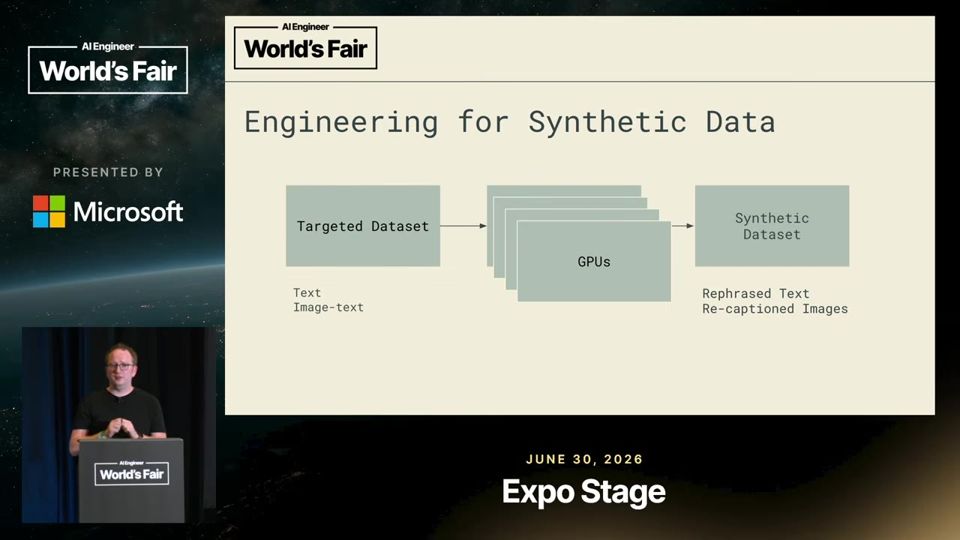
Se você só pede ao modelo um exemplo sintético, ele repete os padrões mais comuns dos dados em que foi treinado. A DatologyAI parte de documentos de alta qualidade do próprio cliente e pede ao modelo para reescrever ou reestruturar cada um. O documento original funciona como semente e mantém a variedade do conjunto. Na prática, o pipeline junta um prompt a cada documento e distribui o trabalho por várias GPUs.

O dado sintético nasce de um documento real usado como semente.05:00

BeyondWeb promete o mesmo resultado com menos tokens

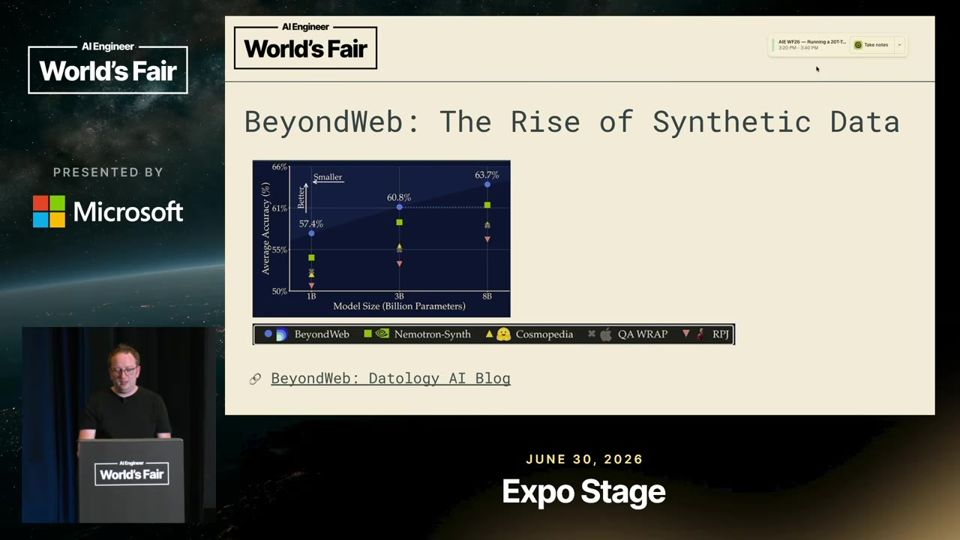
Nos gráficos do paper BeyondWeb, modelos de 1B, 3B e 8B parâmetros treinados com a receita da empresa superam conjuntos como Nemotron-Synth, Cosmopedia, WRAP e RedPajama. O modelo de 3B chega perto do de 8B treinado com Nemotron-Synth. A empresa diz que alcança a mesma acurácia com 2,7 vezes menos tokens que o Nemotron-Synth e 5,3 vezes menos que o Cosmopedia (3:40).

Comparação da própria DatologyAI entre BeyondWeb e outros conjuntos sintéticos.02:45

Um pipeline só para pesquisa e produto

No começo, a pesquisa gerava dados sintéticos num cluster Slurm (agendador de jobs comum em computação científica), longe do pipeline de produto em Kubernetes. Mover dados entre os dois era manual e as GPUs ficavam ociosas. Hoje tudo roda em Kubernetes, com Spark para curadoria, Ray para jobs distribuídos e vLLM para inferência. Um agendador interno encadeia curadoria, geração, treino e eval (avaliação) num único fluxo.

A mesma infraestrutura atende pesquisa e produto.07:50
Mais 2 ideias deste talk

Metadados e falhas de GPU travam a escala

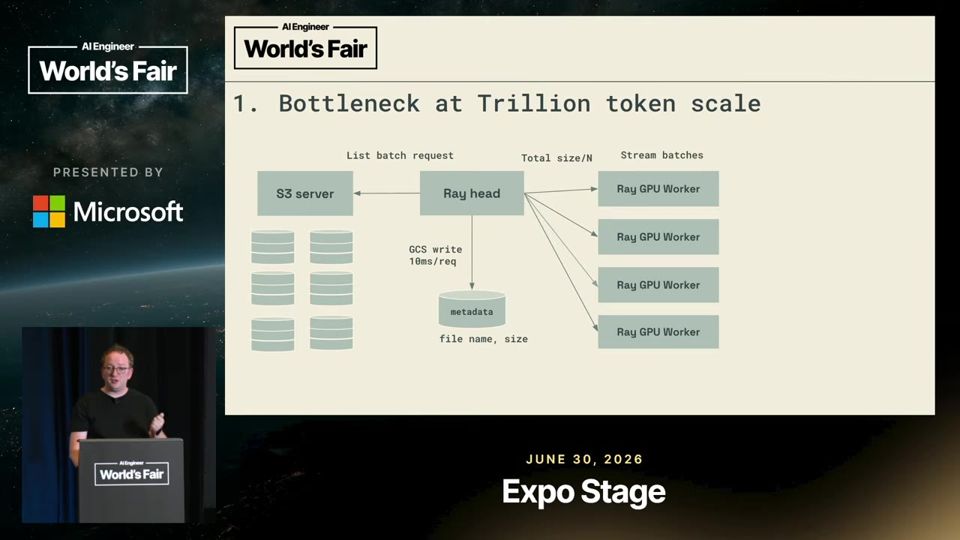
Buscar metadados de milhões de partições no S3, uma requisição por vez, levaria de 9 a 11 dias e esbarraria no limite de taxa da AWS. Com requisições em lote de até mil itens, o tempo caiu para cerca de 2 horas (11:40). Para as GPUs que falham, a equipe reduziu o tamanho das partições e passou a salvar checkpoints periódicos no S3. Assim, uma falha custa minutos em vez de um job de oito horas.

Requisições em lote derrubaram a busca de metadados de dias para horas.11:40

Agendar CPU e GPU juntas e calibrar o vLLM

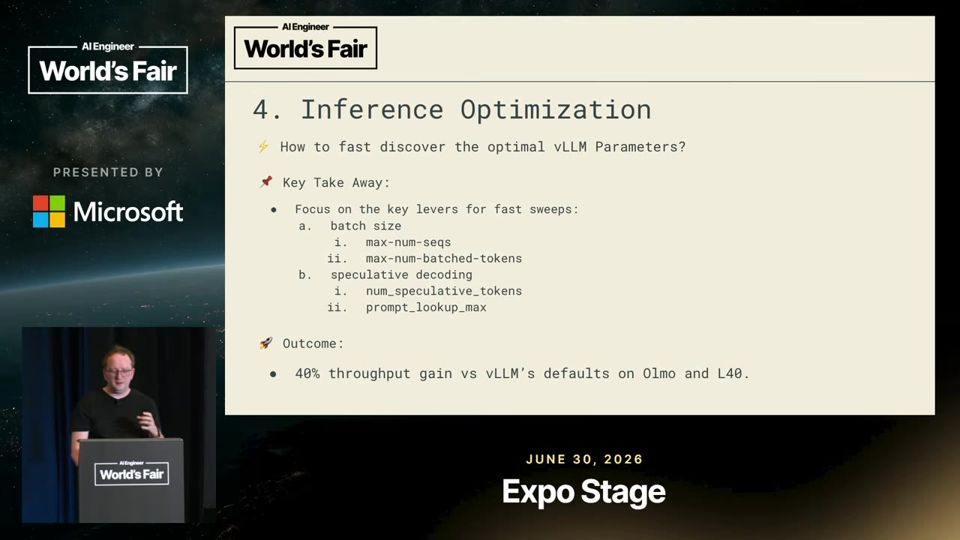
Um job Ray precisa de CPU num cluster e de GPU em outro. Se só um dos recursos estiver livre, o job trava. A equipe criou pools dedicados por tipo de recurso e passou a agendar CPU e GPU de forma atômica, como um problema de bin packing (encaixe de caixas). Na inferência, uma varredura dos parâmetros do vLLM, como tamanho de lote e speculative decoding, rendeu cerca de 40% mais vazão (18:10).

Só ajustar flags do vLLM deu cerca de 40% mais vazão.18:15
analogia

Rephrasing (reescrita de documentos reais por um LLM). Rephrasing é como pedir a um professor que reescreva uma boa redação de aluno com outras palavras, mantendo as ideias originais.

  1. Rephrasing (reescrita) é pedir a um modelo de linguagem que reescreva um texto existente de outra forma.
  2. Quando você pede ao modelo um exemplo inventado do zero, ele tende a repetir os padrões mais comuns do que já aprendeu.
  3. Usar um documento real como semente mantém a variedade de temas e estilos do conjunto original.
  4. A DatologyAI escolhe os documentos de maior qualidade do cliente e pede ao LLM para reescrever ou reestruturar cada um.
  5. Na prática, o pipeline junta um prompt a cada documento e distribui milhões desses pares por várias GPUs.
DOCUMENTO REALTexto de alta qualidade do cliente
PROMPT + DOCUMENTOInstrução de reescrita na frente
LLM NAS GPUSModelo reescreve em larga escala
DADO SINTÉTICOTexto novo com a variedade original

Ajuda saber antes: Dados sintéticos, LLM (modelo de linguagem), Prompt

analogia

Checkpointing (salvar o progresso para retomar após falha). Checkpointing é como salvar o videogame antes de cada fase difícil, para não voltar ao começo quando você perde.

  1. Checkpointing é salvar o progresso de uma tarefa longa de tempos em tempos.
  2. Se a máquina cai, a tarefa recomeça do último ponto salvo e não do início.
  3. Em geração de dados sintéticos, uma GPU com defeito pode derrubar um job de oito horas nos últimos minutos.
  4. A DatologyAI salva checkpoints periódicos no S3 e também diminuiu o tamanho de cada partição (pedaço) dos dados.
  5. Com as duas medidas, uma falha custa poucos minutos e o retry automático termina o trabalho.
PARTIÇÃO PEQUENADados divididos em pedaços curtos
PROCESSA UM TRECHOGPU gera parte do resultado
SALVA NO S3Progresso gravado periodicamente
FALHA E RETOMARetry parte do último ponto salvo
PERDA DE MINUTOSEm vez de horas de trabalho perdido

Ajuda saber antes: GPU, Partição de dados, Armazenamento em S3

analogia

Idempotência (repetir a operação sem mudar o resultado final). Idempotência é como apertar várias vezes o botão do elevador, que mesmo assim vem uma vez só.

  1. Uma operação idempotente dá o mesmo resultado final se você fizer uma vez ou dez vezes.
  2. Isso importa quando uma tarefa falha no meio e o sistema precisa tentar de novo sem saber o que já foi feito.
  3. No pipeline da DatologyAI, cada checkpoint grava sempre no mesmo arquivo no S3 e substitui a versão anterior.
  4. Assim, uma nova tentativa (retry) depois de uma falha não duplica dados nem deixa arquivos pela metade.
  5. Idempotência, checkpoints e retentativa automática juntos permitem retomar um job longo sem intervenção manual.

Ajuda saber antes: Checkpointing, Retry automático, Armazenamento em S3

analogia

Bin packing (encaixar jobs nos recursos disponíveis). Bin packing é como arrumar o porta-malas antes de uma viagem, encaixando malas de tamanhos diferentes para caber tudo sem sobrar espaço vazio.

  1. Bin packing (encaixe de caixas) é o problema de colocar itens de tamanhos diferentes no menor número de espaços possível.
  2. Em computação, os itens são os jobs e os espaços são as máquinas com CPU e GPU livres.
  3. Um job de geração com Ray precisa de CPU num cluster e de GPU em outro cluster ao mesmo tempo.
  4. Se o agendador reserva só a CPU e a GPU está ocupada, o job trava e segura recursos que outros poderiam usar.
  5. A DatologyAI criou pools dedicados por tipo de recurso e passou a reservar CPU e GPU juntas, de forma atômica (tudo ou nada).
JOB CHEGAPede CPU e GPU ao mesmo tempo
CONFERE OS POOLSOlha CPU e GPU livres nos clusters
RESERVA ATÔMICAReserva os dois juntos ou nenhum
JOB RODA SEM TRAVARRecursos usados sem ficar ociosos

Ajuda saber antes: Cluster de computadores, CPU e GPU, Agendador de jobs, Ray

analogia

Batch inference (inferência em lote, fora do uso em tempo real). Batch inference é como uma cozinha industrial que prepara mil marmitas de uma vez, em vez de cozinhar cada prato só quando o cliente pede.

  1. Inferência é o momento em que um modelo já treinado recebe uma entrada e produz uma resposta.
  2. No uso comum, como num chat, cada pedido chega sozinho e precisa de resposta rápida, o que se chama inferência online.
  3. Batch inference (inferência em lote) processa uma pilha enorme de entradas de uma vez, sem ninguém esperando na tela.
  4. O objetivo passa a ser vazão (throughput), ou seja, quantos tokens a GPU gera por hora.
  5. A DatologyAI ajustou parâmetros do vLLM, como tamanho do lote e speculative decoding (decodificação especulativa), e ganhou cerca de 40% de vazão.
FILA DE DOCUMENTOSMilhões de entradas esperando
MONTA LOTESAgrupa entradas no tamanho certo
GPU PROCESSA JUNTOvLLM gera vários textos em paralelo
MAIS TOKENS POR HORAVazão alta com as mesmas GPUs

Ajuda saber antes: Inferência, GPU, vLLM, Token

leitura crítica

O palestrante é cofundador e CTO da DatologyAI e fecha o talk recrutando, então os resultados do BeyondWeb são comparações feitas pela própria empresa. Ele admite que os gráficos são antigos e diz que hoje a receita é melhor, sem mostrar dados. Os ganhos de infraestrutura (11 dias para 2 horas, 40% de vazão) vêm sem detalhe de método ou de custo. O talk também não discute riscos de treinar com dados sintéticos, como perda de diversidade, nem como a qualidade muda entre domínios.

O que fazer com isso

  • Ao pedir exemplos sintéticos a um LLM, forneça um documento real como base para reescrita em vez de pedir que ele invente do zero.
  • Em jobs longos de processamento com IA, divida a entrada em partes pequenas e salve o progresso de cada parte para não perder horas numa falha.
  • Antes de processar milhares de arquivos na nuvem, calcule quanto tempo a listagem e a leitura vão levar e use as APIs de lote do provedor.
  • Se você roda modelos próprios com vLLM, teste combinações de tamanho de lote e outros parâmetros antes de comprar mais GPU.

Fim da edição

Termos novos no glossário: Delegation chain, Cedar policy, HNSW, Code Mode, Production world model, Idempotência, Bin packing, Rephrasing, Checkpointing, Batch inference.