Pular para o conteúdo
Aprendendo AI

Quando o usuário vira agente: interface, memória e infraestrutura

Edição de sábado, 3 out 2026 · 7 vídeos · 2 h 05 min de talks

Sete talks sobre o que muda quando quem usa o software é um agente. A Composio decreta o fim do dashboard, e um Raspberry Pi pendurado no pescoço mostra um agente pessoal com memória em grafo. A Oracle ensina a decidir onde cada saber mora: prompt, memória ou pesos. O Google DeepMind redesenha a API para agentes com estado no servidor, e o VS Code conta como passou a lançar toda semana refazendo o sistema em volta dos agentes. No fim, a pilha de baixo: Nebius explica como servir modelos abertos rápido e barato, e a Crusoe mostra treino que se cura sozinho quando uma GPU morre.

Dashboards Are Dead

Se o usuário passa a ser o agente, o produto precisa de uma interface feita para ele, e só expor um servidor MCP não resolve.

Agentes 10:41 nível ●●●○○ Sarah Simionescu, Composio Assistir no YouTube (abre em nova aba)

Em 3 frases

Sarah Simionescu, da Composio, conta que usou o Datadog por seis meses sem abrir o dashboard, porque o agente consulta os dados por ela.

Ela diz que o MCP sozinho falha por três motivos: o agente não aprende, ferramentas demais afogam o modelo e cada app vive isolado dos outros.

A solução da Composio é busca de ferramentas com plano de execução e resultados guardados fora do contexto, mostrada em duas demos e em um gráfico de resultados ainda não publicado.

Antes de ler

Mais 2 termos

Dashboards e linguagens de consulta eram tradutores

Em 2022, resolver um bug pedia cinco ferramentas, cinco interfaces e cinco linguagens de consulta, como a sintaxe do Datadog, o JQL do Jira e os filtros de busca do Slack. Para a palestrante, tudo isso existia porque a máquina não entendia o que a pessoa queria. O usuário sempre quis a resposta, não a tela.

01:40 Cada ferramenta cobra uma interface e uma linguagem de consulta próprias.

Três motivos para o MCP sozinho virar bagunça

MCP é só um protocolo, um canal entre agente e serviço. Cabe ao serviço decidir como falar com o agente. Ligar uma dúzia de servidores gera três problemas. O agente começa cada conversa do zero. Centenas de definições de ferramentas lotam o contexto. Cada servidor só conhece a si mesmo, então tarefas que cruzam apps ficam com o humano.

04:00 Os três motivos que a palestrante lista contra o MCP puro.

Busca de ferramentas devolve também um plano de uso

Na demo do bug vindo do Slack, o Claude chama a busca da Composio e declara três tarefas: ler mensagens do Slack, buscar issues no Sentry e buscar logs no Datadog. Para cada uma, a Composio devolve as ferramentas certas e um plano. Exemplo do plano: achar o ID do canal antes de consultar as mensagens. O PR com a correção sai em menos de cinco minutos.

05:35 A busca retorna ferramentas e a ordem de uso, sem skill escrita à mão.

Mais 2 ideias deste talk

Resultados grandes ficam fora do contexto

Na análise entre PostHog e Metabase, o agente guarda a lista de IDs de usuários sem carregá-la no contexto. Depois gera uma consulta SQL com regex em um ambiente remoto (Remote Workbench) para cruzar os IDs com o banco. O contexto do modelo continua pequeno, e os dados vêm das duas fontes.

08:10 O agente cruza duas fontes sem carregar o resultado completo no contexto.

Projetar produto para um usuário sem olhos

A conclusão é que startups preparam o site para GEO, mas poucas preparam o aplicativo para agentes. O agente chega com uma meta e um conjunto de ferramentas, não clica em botão de brilho e julga o produto por uma coisa só, se conseguiu terminar a tarefa. Segundo ela, clientes já pedem para usar os serviços por meio dos próprios agentes.
Fecha a tese de que o agente é o próximo usuário a ser projetado.09:44
leitura crítica

Palestra de produto da Composio, que vende justamente a camada que ela propõe. Os resultados contra os MCPs nativos foram chamados de iniciais e não publicados, e o trecho não mostra tarefas, métricas nem número de execuções. As duas demos são curadas, uma delas descrita como mockup. A afirmação de que dashboards morreram vem de uma experiência pessoal e ignora casos em que humanos precisam ver gráficos e auditar dados. Cabe notar que a palestrante trabalha no dashboard da Composio.

O que fazer com isso

  • Conte quantas ferramentas seus servidores MCP expõem ao agente. Se passarem de algumas dezenas, teste uma busca de ferramentas em vez de carregar todas.
  • Em tarefas que cruzam apps, deixe o agente guardar resultados grandes fora do contexto, por exemplo em arquivos ou em um ambiente de execução, e passar adiante só os IDs ou resumos.
  • Se você mantém um produto, teste uma tarefa real pedindo a um agente que a execute pela sua API ou MCP, e anote onde ele erra por falta de documentação.
  • Peça números ao avaliar fornecedores como esse. Compare o mesmo modelo e as mesmas tarefas nos seus próprios casos antes de adotar.
I Built a Personal AI Agent on a Raspberry Pi

Um agente pessoal pequeno, num Raspberry Pi velho e com memória em grafo, ensina mais do que um agente cheio de recursos no notebook.

Agentes 20:10 nível ●●●○○ Jeremy Adams, Neo4j Assistir no YouTube (abre em nova aba)

Em 3 frases

Jeremy Adams, da Neo4j, monta ao vivo um agente pessoal num Raspberry Pi 4B que ele usa pendurado no pescoço. O agente roda NanoClaw, recebe mensagens pelo WhatsApp e usa o Claude na nuvem para pensar.

Ele dá memória ao agente com um banco de grafos Neo4j, usando o esquema POLE (pessoa, objeto, local, evento). Depois adiciona voz com microfone USB, um botão físico e um Neo4j local para funcionar offline.

Na feira AI Engineer, ele grava notas de estandes, sobe tudo para a nuvem e descobre temas em comum entre as empresas. No fim, troca a memória caseira pelo serviço Neo4j Agent Memory.

Antes de ler

Mais 2 termos

Agente pequeno e hackeável

Jeremy vem de sysadmin e DevOps e não quis um agente solto no notebook. Ele queria barato, aberto e fácil de entender. Escolheu o NanoClaw, com cerca de 15 arquivos de código, e o Docker isola cada processo do agente. Todo o raciocínio do modelo acontece na nuvem. O Pi só orquestra.

08:08 O hardware e o projeto escolhidos para o agente pequeno.

Arquitetura: WhatsApp, NanoClaw, Claude

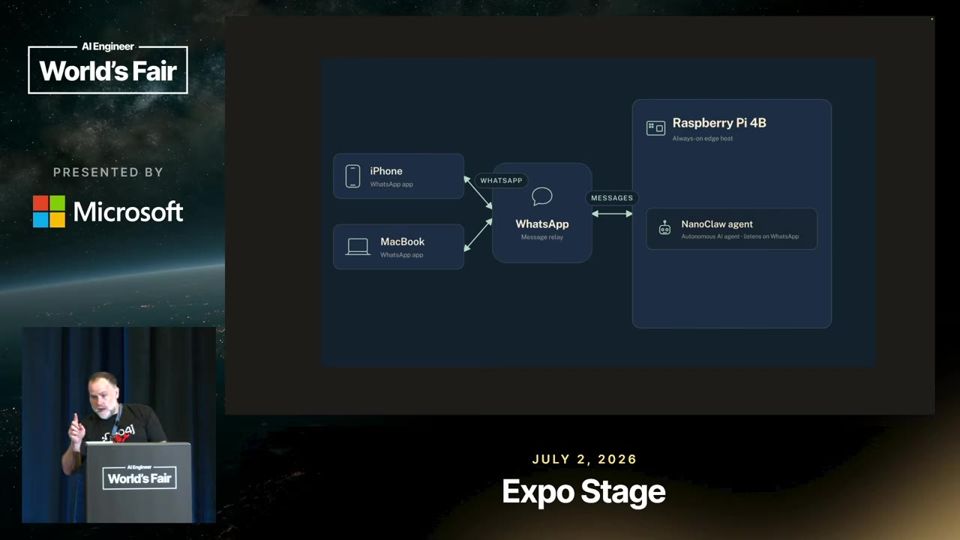
A mensagem sai do iPhone ou do MacBook pelo WhatsApp, chega ao NanoClaw no Pi e segue para o Claude via Agent SDK. Não há inferência de modelo no aparelho. Um servidor MCP liga o agente ao Neo4j, e a resposta volta pelo mesmo canal.

O caminho de uma mensagem do celular até o modelo e de volta.09:09

Grafo 101 e consulta via MCP

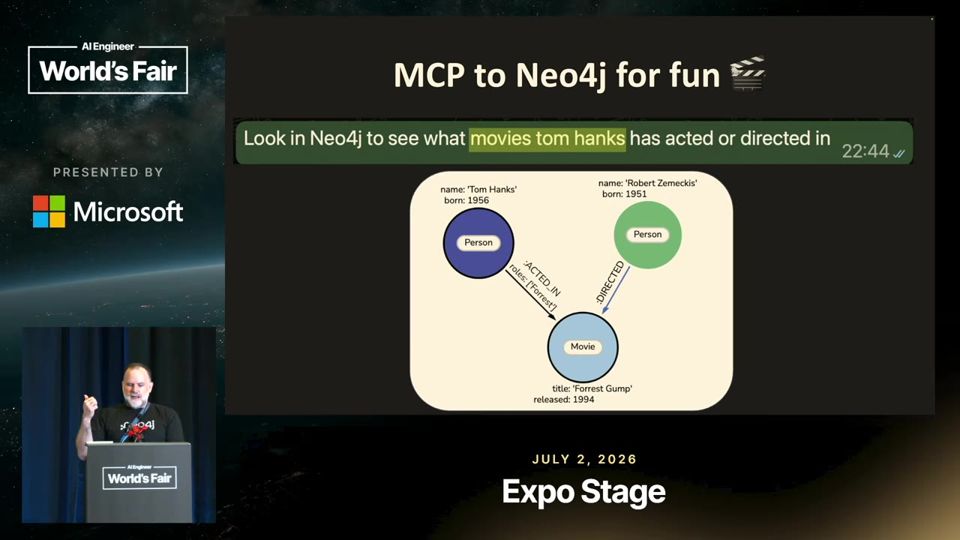
Um grafo tem nós (círculos) e relações (arestas). No exemplo, Tom Hanks atuou em Forrest Gump, e Robert Zemeckis dirigiu o filme. Jeremy perguntou pelo WhatsApp quais filmes Tom Hanks fez. O agente consultou o banco pelo MCP e respondeu com os dados reais.

O que é nó e o que é relação num banco de grafos.09:41
Mais 2 ideias deste talk

Memória em grafo com o esquema POLE

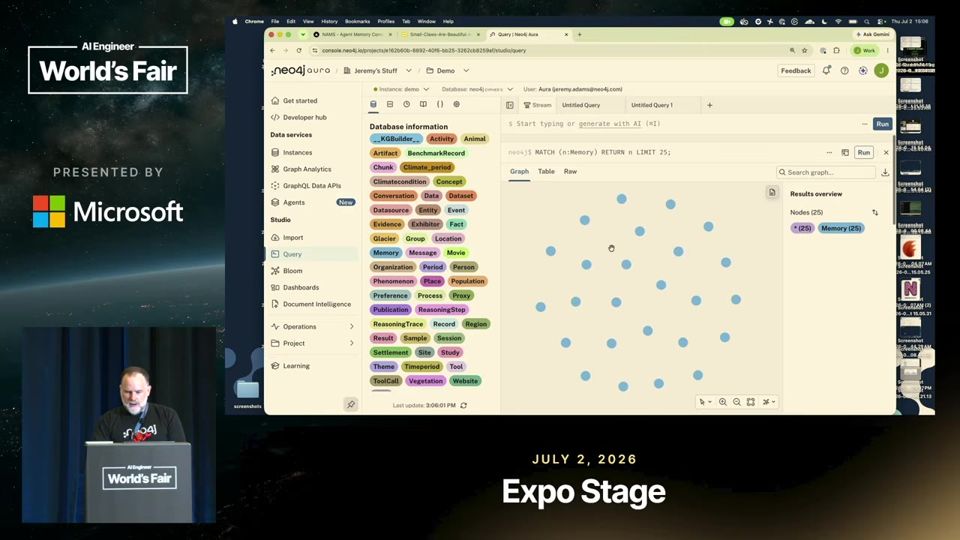
Num voo, Jeremy pediu ao agente que criasse um sistema de memória no esquema POLE, que vem do trabalho policial europeu: pessoa, objeto, local e evento, mais organização. O agente criou a skill e guardou o banco num ponto de montagem que sobrevive a reinícios. No Neo4j Aura, os nós mostram reuniões, lugares e pessoas ligados entre si.

Memórias do agente guardadas como grafo navegável.12:48

Notas de estandes viram grafo de temas

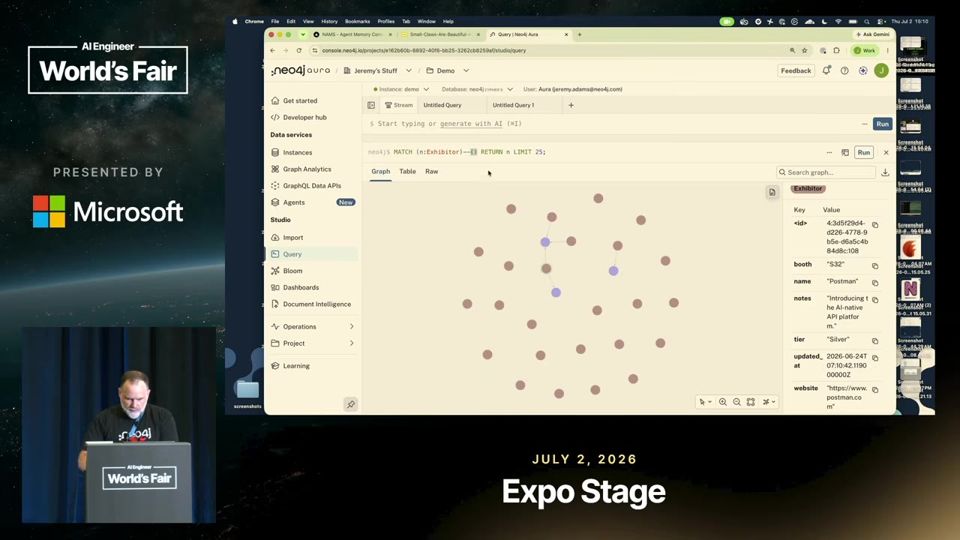
Com microfone USB, botão físico e Neo4j local, Jeremy gravou notas nos estandes mesmo com o Wi-Fi ruim da feira. Depois subiu os dados para a nuvem e os enriqueceu. O grafo mostrou temas compartilhados, como avaliação e observabilidade, ligando várias empresas.

Expositores conectados por temas em comum no grafo da nuvem.17:32
analogia

Cypher (linguagem de consulta do Neo4j). Cypher é como pedir ao bibliotecário um caminho desenhado num papel, do tipo "autor escreveu livro", e receber de volta todos os livros que se encaixam nesse desenho.

  1. Para tirar informação de um banco de dados, você precisa fazer uma pergunta numa língua que ele entende. Cypher é a língua usada para conversar com o Neo4j, um banco de dados em grafo.
  2. Num grafo, os dados ficam guardados como pontos (nós) ligados por setas (relações). Uma pergunta em Cypher descreve o desenho que você procura, como "pessoa atuou em filme".
  3. O desenho vira texto com parênteses para os nós e setas para as relações. Por exemplo, MATCH (p:Pessoa)-[:ATUOU_EM]->(f:Filme) RETURN f busca todos os filmes ligados a uma pessoa pela relação ATUOU_EM.
  4. Os comandos principais são MATCH (encontrar um padrão), CREATE (criar nós e relações) e RETURN (devolver o resultado). No talk, Jeremy usa um cypher-shell, um programa de linha de comando, para listar os expositores gravados no Neo4j que roda no Raspberry Pi.
  5. Um agente de IA também pode escrever a query (consulta) em Cypher sozinho. Ele recebe a pergunta em linguagem comum, monta a consulta e envia ao banco por uma ferramenta como o MCP.
PERGUNTAQuais filmes Tom Hanks fez?
PADRÃO EM CYPHERMATCH (pessoa)-[ATUOU]->(filme)
BUSCA NO GRAFONeo4j segue as setas que batem
RESULTADOLista de filmes encontrados

Ajuda saber antes: Banco de dados em grafo, Nós e relações, Neo4j

leitura crítica

O palestrante é developer advocate da Neo4j e o talk termina com convite ao estande e ao curso gratuito da empresa, então é pitch de produto. Não há medição de qualidade da memória, de latência nem de custo. A descoberta de temas vem de poucos estandes e de notas pessoais, sem método comparável. Ele mesmo chama o banco de depósito bagunçado. O offline depende de regex e de um Neo4j local em hardware limitado, sem teste de falhas.

O que fazer com isso

  • Teste um agente pessoal pequeno, em máquina isolada ou em Docker, antes de dar acesso ao seu notebook com arquivos e senhas.
  • Desenhe a memória do seu agente como entidades e relações (pessoa, local, evento) antes de escolher uma ferramenta.
  • Conecte uma base de consulta ao agente por MCP e peça respostas que citem os dados, para verificar se ele não inventa.
  • Se for avaliar o Neo4j Agent Memory, compare com guardar o histórico em arquivos de texto simples e meça se a recuperação melhora.

Stop Fine-Tuning to Fix Retrieval Problems

Prompt guarda comportamento, memória guarda fatos, pesos guardam reflexos. Decida onde cada saber mora antes que o acaso decida por você.

Dados e RAG 20:11 nível ●●●○○ Anant Srivastava Assistir no YouTube (abre em nova aba)

Em 3 frases

Anant Srivastava, da Oracle, diz que times de IA decidem sem perceber onde o conhecimento mora, porque cada edição de prompt, documento indexado e amostra de treino é uma decisão de arquitetura.

Ele propõe uma pergunta de diagnóstico por camada: prompt para comportamento pequeno e estável, memória para conhecimento atual, grande, citável ou com controle de acesso, e pesos só para reflexos que pararam de mudar.

Fine-tuning para ensinar fatos gera respostas velhas e nomes de produto inventados. O ideal é um ciclo em que o conhecimento circula entre contexto, memória e pesos conforme o agente trabalha.

Antes de ler

Mais 1 termo

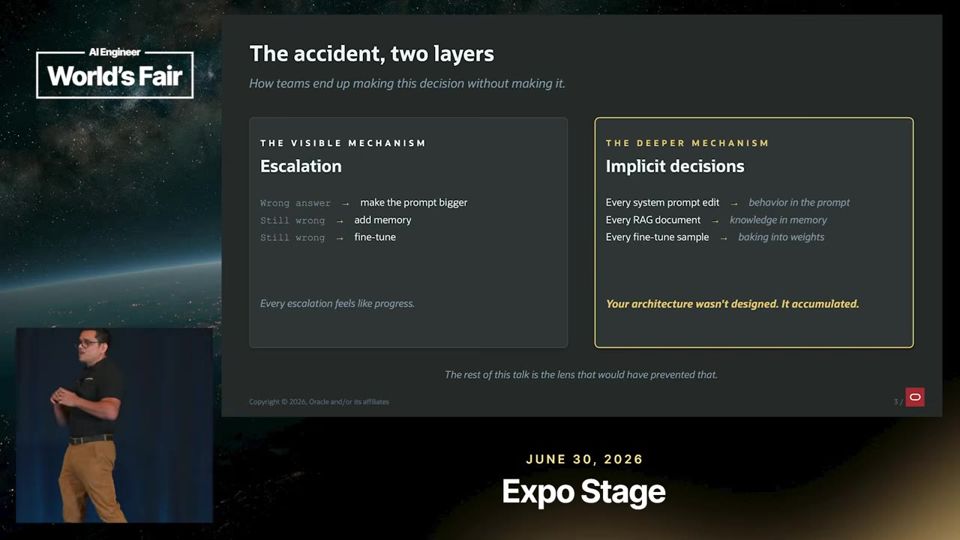
A arquitetura se acumula por acidente

No caso do assistente de suporte, o PM ajustou o tom no prompt, o suporte indexou políticas de reembolso, um engenheiro jogou o catálogo no prompt e o time de ML fez fine-tuning com tickets antigos. Cada passo parecia razoável. Juntos, o catálogo vazou para os pesos e o agente passou a citar produtos que não existem.

Quatro decisões isoladas somam uma arquitetura que ninguém desenhou.02:40

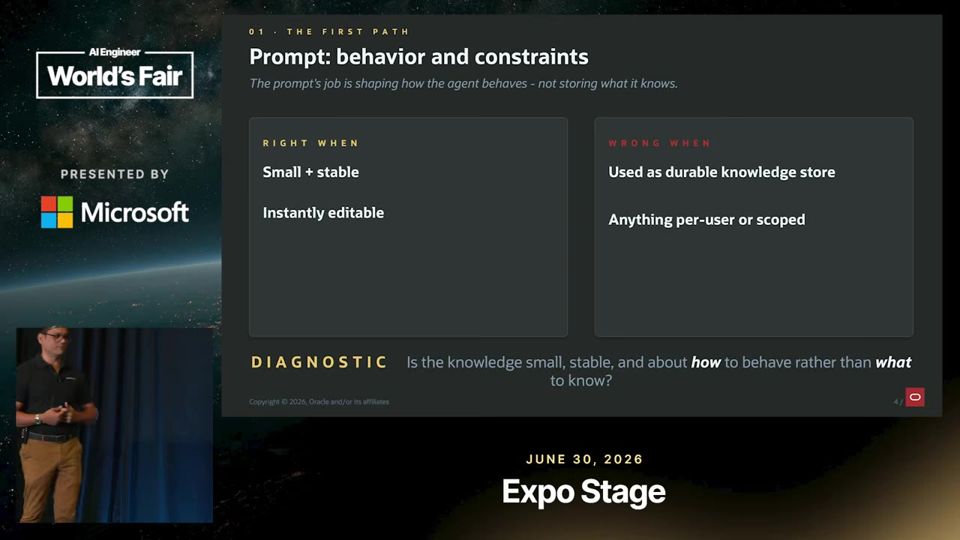
Prompt é para comportamento, não para fatos

O prompt serve para tom, persona e regras pequenas e estáveis, como escalar para um humano após três falhas. Colocar catálogo ali custa tokens e ainda causa o problema de lost in the middle (perda de informação no meio de contextos longos). Arquivos de instrução como MD também contam como prompt.

Tom profissional e escalonamento humano pertencem ao prompt.05:49

Memória: atual, grande, citável e com acesso controlado

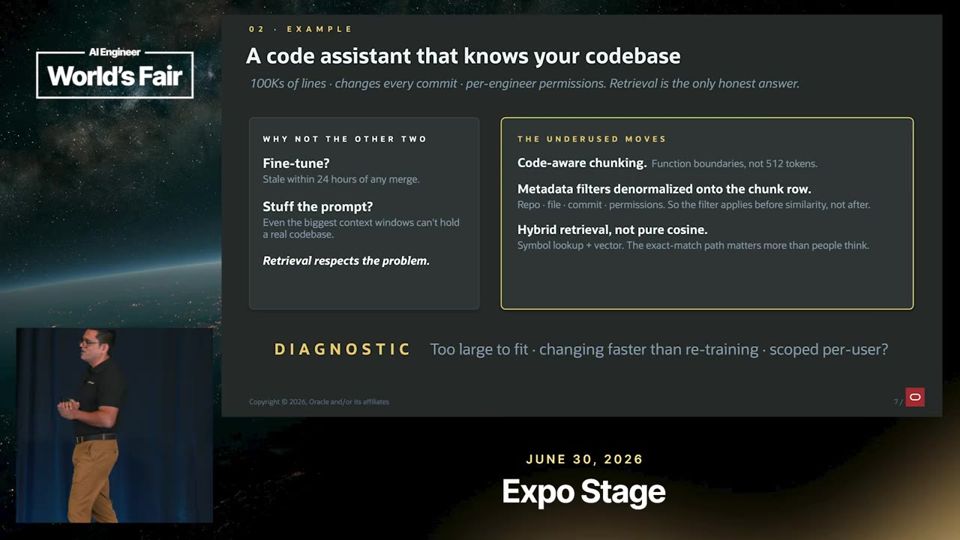
Conhecimento que muda mais rápido que o retreino, não cabe no prompt, precisa de fonte ou tem escopo por usuário vai para a memória, seja externa (RAG) ou do agente. No exemplo do assistente de código, ele pede chunking (divisão em trechos) que entenda código e metadados como repositório e permissões, para não devolver uma papa de trechos.

Metadados filtram o que o modelo recebe e respeitam quem pode ver o quê.10:04
Mais 2 ideias deste talk

Fine-tune de reflexo, não de fato

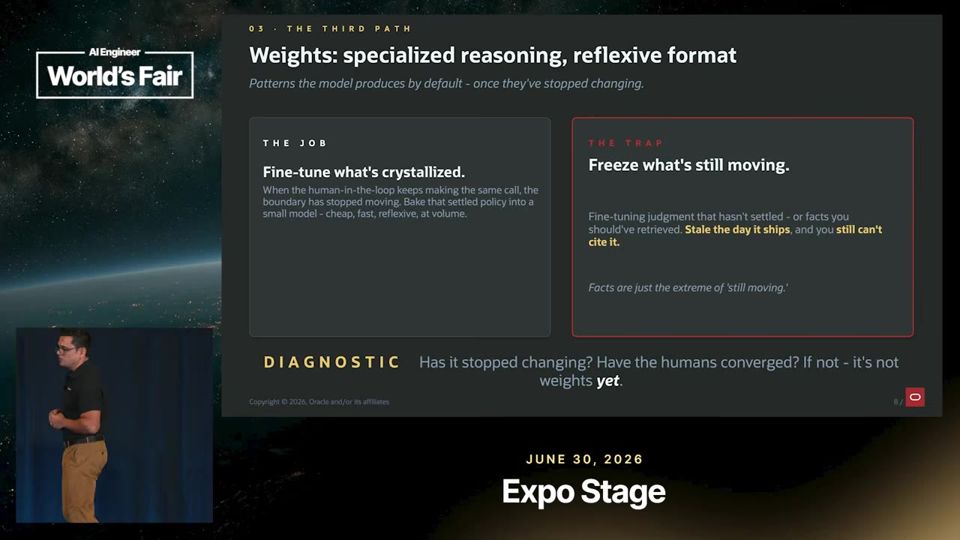
Um assistente de documentos com fine-tuning em runbooks passa a responder com informação velha. O problema real era recuperar os trechos certos. Já em codificação médica, o modelo aprende o reflexo de entender formatos e escolher entre eles, e a lista de códigos fica na memória. Fine-tuning também faz sentido para baixar custo com um modelo menor.

Documentação é fato e vai para a memória. Formato e seleção viram reflexo.12:40

Arquitetura circulante e o modelo como parte fácil

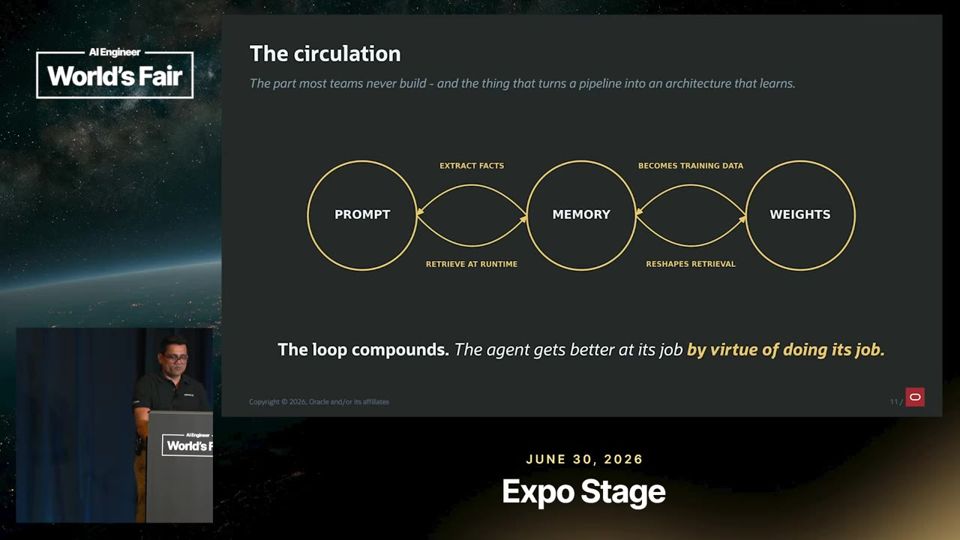
Contexto gera sinais, parte deles vira memória durável, a memória volta ao contexto em novas sessões e padrões estáveis migram da memória para os pesos. Depois do fine-tuning, deixa de ser preciso recuperar exemplos de formato. O trabalho difícil é o harness (a estrutura ao redor do modelo) que move o saber entre as camadas.

O agente melhora ao trabalhar porque o saber circula entre as três camadas.17:33
analogia

Drift (deriva dos dados ao longo do tempo). Drift é como um GPS com mapa antigo, que funcionou bem no começo mas erra mais a cada rua nova que a prefeitura abre.

  1. Um modelo aprende com exemplos de uma época. O mundo continua mudando depois disso.
  2. Drift (deriva) é a distância que cresce entre o que o modelo aprendeu e o que acontece hoje. As respostas pioram aos poucos, sem nenhum aviso.
  3. No talk, o time usa fine-tuning (ajuste fino) no centro estável de um problema, como moderação de conteúdo, onde as correções humanas já pararam de mudar.
  4. Esse centro também pode se mover. Novas regras, novos produtos ou novos casos fazem os humanos voltarem a corrigir o modelo.
  5. Por isso o time monitora a taxa de correções humanas e a qualidade das respostas. Quando elas pioram, o time revisa os dados e treina o modelo de novo.
PADRÃO ESTÁVELHumanos param de corrigir o modelo
FINE-TUNINGModelo aprende o centro estável
MUNDO MUDARegras e casos novos aparecem
MONITORARCorreções humanas voltam a subir
RETREINOModelo volta a acertar o padrão

Ajuda saber antes: Fine-tuning, Dados de treino, Avaliação de modelos

leitura crítica

O talk é um framework conceitual, sem medições. Os casos (assistente de suporte, codificação médica) são ilustrações, e os números citados são poucos. A tabela de decisão é útil, mas o próprio palestrante admite exceções. A ideia de mover conhecimento da memória para os pesos tem pouco detalhe prático, como quando retreinar e como medir ganho. O palestrante trabalha na Oracle, que vende plataformas de dados e IA, o que favorece a tese de investir em camada de memória.

O que fazer com isso

  • Liste o que está hoje no prompt, no índice de retrieval e nos dados de fine-tuning do seu assistente e classifique cada item como comportamento, fato ou reflexo.
  • Antes de pensar em fine-tuning para corrigir respostas erradas, meça se o retrieval traz os trechos certos.
  • Em RAG de código ou documentos internos, guarde metadados como repositório, dono e permissão em cada trecho e filtre por eles na busca.
  • Considere fine-tuning de um modelo menor só quando o padrão de trabalho estiver estável e o objetivo for reduzir custo, com monitoramento de drift.

An Interaction Is All You Need

Agentes pedem uma API com estado no servidor e sandbox persistente. O Google guarda o contexto e o ambiente, e você só devolve dois IDs.

Agentes 17:03 nível ●●●○○ Ivan Leo, Google DeepMind Assistir no YouTube (abre em nova aba)

Em 3 frases

Ivan Leo, do Google DeepMind, apresenta a Interactions API do Gemini, que guarda o estado da conversa no servidor e devolve um interaction ID a cada resposta.

Os Managed Agents rodam o harness Antigravity em um sandbox remoto persistente, que você retoma com um environment ID, e um proxy injeta credenciais para o modelo nunca ver o token.

O talk é uma apresentação de produto do Google, com demos curtas e sem comparação com concorrentes nem dados de custo ou desempenho.

Antes de ler

Mais 2 termos

Estado no servidor com interaction ID

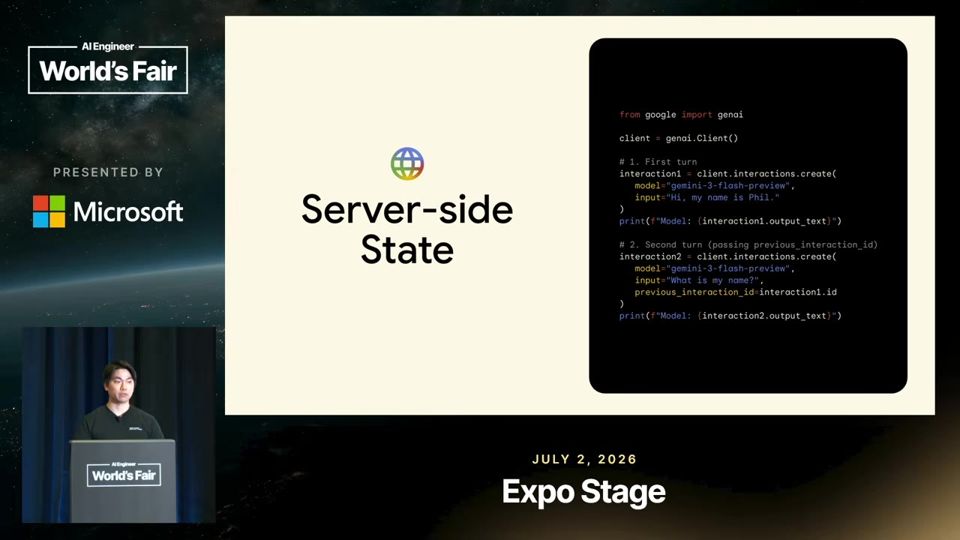
Antes, quem usava o Gemini precisava reenviar o histórico e as thought signatures, códigos opacos do raciocínio do modelo. Um espaço em branco a mais podia quebrar o cache. Agora a resposta traz um interaction ID e você o devolve em previous_interaction_id no turno seguinte. O servidor preserva o contexto, e sem as signatures o desempenho cai.

O ID da primeira resposta carrega o contexto para o segundo turno.05:51

Encadear imagem, vídeo e áudio com o mesmo contexto

Com o mesmo interaction ID, uma imagem gerada em um modelo vira ponto de partida para um vídeo em outro. O exemplo gera uma foto em Veneza e passa o ID ao modelo Omni Flash. A saída de cada etapa vem com tipo explícito (image, audio), então o código só precisa tratar cada tipo.

06:52 Duas chamadas bastam para ir de imagem a vídeo no mesmo contexto.

Ferramentas nativas e customizadas na mesma chamada

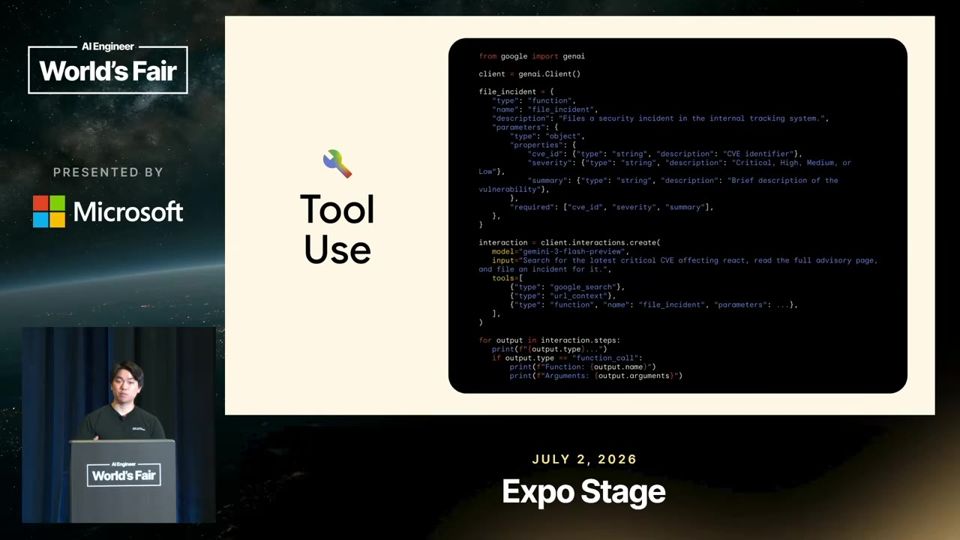
O exemplo combina Google Search, leitura de páginas (URL context) e uma função própria chamada file_incident. O modelo decide sozinho quais usar e responde em uma única chamada de API. O formato de steps substitui o antigo array de outputs e marca cada passo: raciocínio, chamada de função e conteúdo.

Ferramentas nativas e custom convivem em uma só requisição.08:23
Mais 2 ideias deste talk

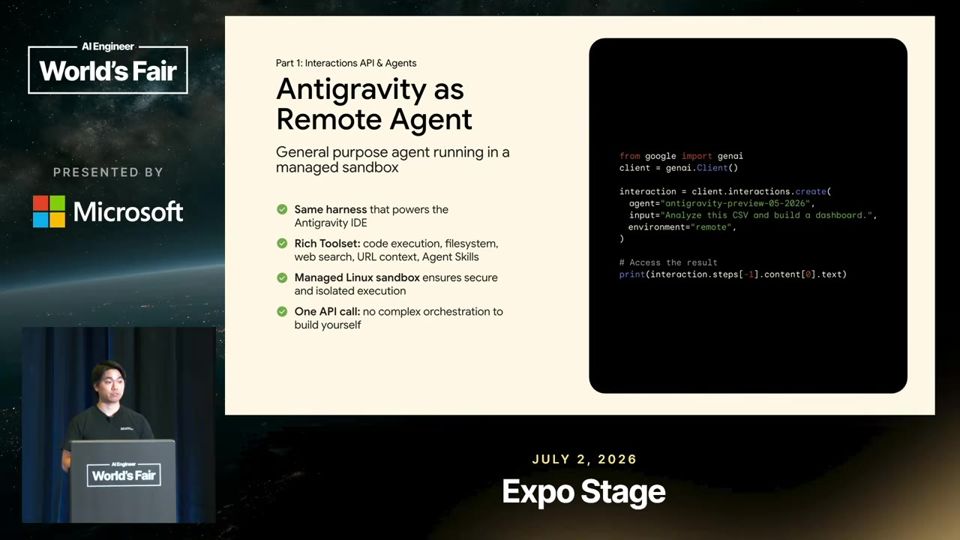
Managed Agent: sandbox persistente em uma chamada

O agente Antigravity sobe um sandbox remoto, lista arquivos, lê o repositório e gera um relatório sem intervenção. O interaction ID preserva o contexto e o environment ID devolve você ao mesmo sandbox, com pacotes e arquivos intactos. Fontes podem vir de GCS, GitHub ou arquivos inline.

Um agente investiga um repositório inteiro dentro de um sandbox remoto.10:36

Proxy que injeta o token no lugar do modelo

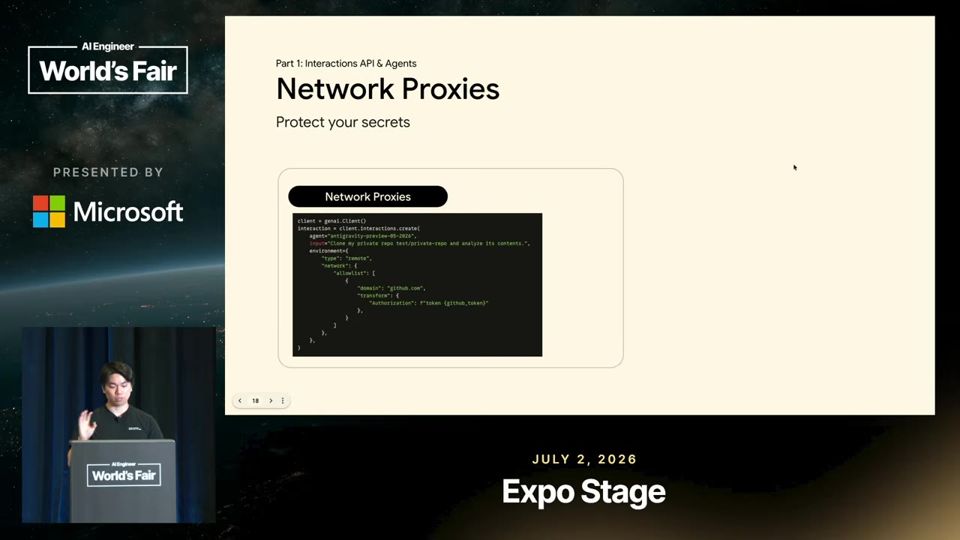
Um proxy man-in-the-middle fica entre o agente e as APIs externas e troca cabeçalhos nas chamadas de saída. O token do GitHub entra na requisição depois, fora do alcance do modelo. Se houver prompt injection, o agente não tem o segredo para vazar.

O token é injetado fora do modelo, então não há segredo para vazar.14:06
analogia

Thought signatures (assinaturas de raciocínio). Thought signatures são como o caderno de passagem de turno de um plantão, e se o colega perde uma folha ele recomeça sem saber o que já foi pensado.

  1. Antes de responder, alguns modelos pensam em etapas, como quem faz contas num rascunho.
  2. O Gemini resume esse rascunho num código fechado, a thought signature (assinatura de raciocínio), que nenhuma pessoa consegue ler.
  3. A cada resposta ou chamada de função, o modelo devolve essas assinaturas junto com o texto.
  4. No turno seguinte, o programa precisa reenviar as assinaturas intactas. Um espaço a mais já pode quebrar o cache, e sem elas o desempenho do modelo cai.
  5. Com a Interactions API, o servidor guarda as assinaturas. Você só devolve o interaction ID no campo previous_interaction_id.
MODELO PENSARaciocina antes de responder
GERA ASSINATURACódigo opaco do raciocínio
VOLTA NO PRÓXIMO TURNOReenviada ou guardada no servidor
RACIOCÍNIO CONTINUAModelo mantém o desempenho

Ajuda saber antes: Modelo de raciocínio, Janela de contexto, Cache de prompt, Interaction ID

analogia

Steps data model (modelo de dados em passos). O steps data model é como o extrato do banco, em que cada linha diz se foi depósito, saque ou tarifa, e você não precisa adivinhar o que aconteceu.

  1. Quando você pede algo a um agente, ele faz várias coisas antes da resposta final.
  2. Ele pode pensar, chamar ferramentas, consultar a internet e gerar texto, imagem ou áudio.
  3. A API antiga juntava tudo num array (lista) de outputs, com objetos aninhados difíceis de ler.
  4. O steps data model (modelo de dados em passos) registra cada etapa como um passo com tipo explícito, chamado discriminador. Os tipos incluem raciocínio, chamada de função e conteúdo.
  5. O código só confere o tipo de cada passo e trata cada caso, o que facilita fluxos com ferramentas assíncronas e várias mídias.
PEDIDO DO USUÁRIOUma única chamada de API
PASSO DE RACIOCÍNIOTipo marca o pensamento do modelo
PASSO DE FUNÇÃOTipo marca a ferramenta chamada
PASSO DE CONTEÚDOTexto, imagem ou áudio com tipo
LISTA DE PASSOSCódigo trata cada tipo com clareza

Ajuda saber antes: Function calling, JSON, Thought signatures

analogia

Proxy man-in-the-middle (proxy intermediário que injeta credenciais). O proxy man-in-the-middle é como a portaria de um prédio que recebe a encomenda do estagiário e coloca a assinatura do chefe antes de entregar, sem que o estagiário veja a assinatura.

  1. Um agente de IA às vezes precisa acessar serviços externos, como baixar um repositório privado do GitHub.
  2. Para isso ele precisaria de um token, uma senha de acesso. Se o token fica com o agente, um ataque pode fazê-lo vazar a senha.
  3. Um proxy (intermediário) fica no caminho entre o agente e a internet e vê toda chamada que sai.
  4. Na técnica man-in-the-middle (homem no meio), o proxy lê o cabeçalho da chamada e insere o token ali, depois que ela sai do agente.
  5. Mesmo sob prompt injection (instrução maliciosa escondida no texto), o modelo não tem o token para entregar. Ele ainda pode usar o acesso de forma indevida.
AGENTE FAZ A CHAMADAPedido sai sem nenhum token
PROXY INTERCEPTALê o cabeçalho da requisição
INJETA O TOKENCredencial entra fora do modelo
API RESPONDEAcesso feito e segredo protegido

Ajuda saber antes: API, Token de acesso, Prompt injection, Sandbox

leitura crítica

É um talk de lançamento feito por um funcionário do Google, então tudo é demo escolhida a dedo. Não há comparação com a API de outros provedores, nem dados de latência, custo por tarefa ou taxa de erro. O ganho de desempenho por preservar thought signatures é afirmado sem medição. A frase sobre pagar só pelo modelo e não pelo sandbox merece checagem na tabela de preços. O proxy reduz o risco de vazamento, mas não impede o agente de usar o token indevidamente contra a API.

O que fazer com isso

  • Se você usa Gemini via API, teste o interaction ID em um fluxo multi-turno e compare com reenviar o histórico, medindo erros e custo.
  • Nunca coloque tokens no prompt ou no sandbox do agente. Use um proxy ou um cofre que injete a credencial fora do alcance do modelo.
  • Avalie se o seu agente de código precisa de um sandbox persistente. Se sim, compare o Managed Agent com montar o seu próprio.
  • Teste a skill da Interactions API em um agente de código para migrar um projeto, e revise o diff antes de aceitar.

How VS Code Went from Monthly to Weekly Releases with AI

Agente rápido só rende se você refaz o sistema em volta: CI, revisão, triagem, rollout e evals precisam acompanhar o ritmo.

Engenharia de software 19:35 nível ●●●○○ Harald Kirschner Assistir no YouTube (abre em nova aba)

Em 3 frases

O time do VS Code saiu de releases mensais, que duraram 10 anos, para releases semanais, com uma equipe pequena atendendo mais de 50 milhões de usuários.

Para isso, o time deixou o código pronto para agentes, deixou os agentes usarem o app, tornou a revisão por IA obrigatória e automatizou a triagem de issues e de erros em PRs de correção.

Depois de escrever código mais rápido, o gargalo passou para qualidade e aprendizado. O time respondeu com rollout em etapas, evals próprios (VSC-Bench) e protótipos diários.

Antes de ler

Mais 2 termos

Code survival mede a confiança no agente

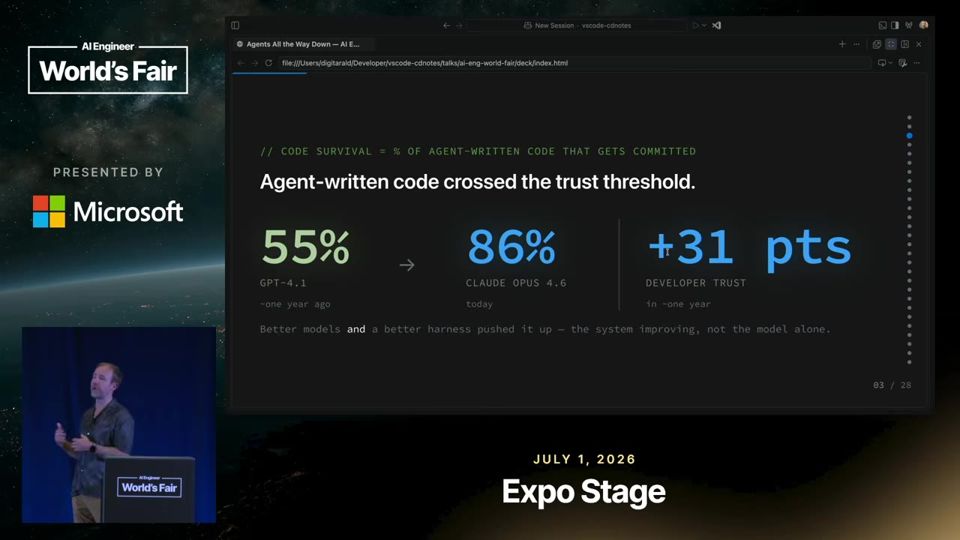
O time acompanha a fatia do código escrito por agente que chega a ser commitado. Código jogado fora indica que o agente errou ou que ninguém confiou nele. A métrica subiu de 55% com o GPT 4.1 para 86% com o Claude Opus 4.6, segundo o palestrante. Ele atribui a alta ao modelo novo e a melhorias no harness (a estrutura em volta do modelo).

Mostra a evolução da taxa de código de agente que sobrevive ao commit.01:15

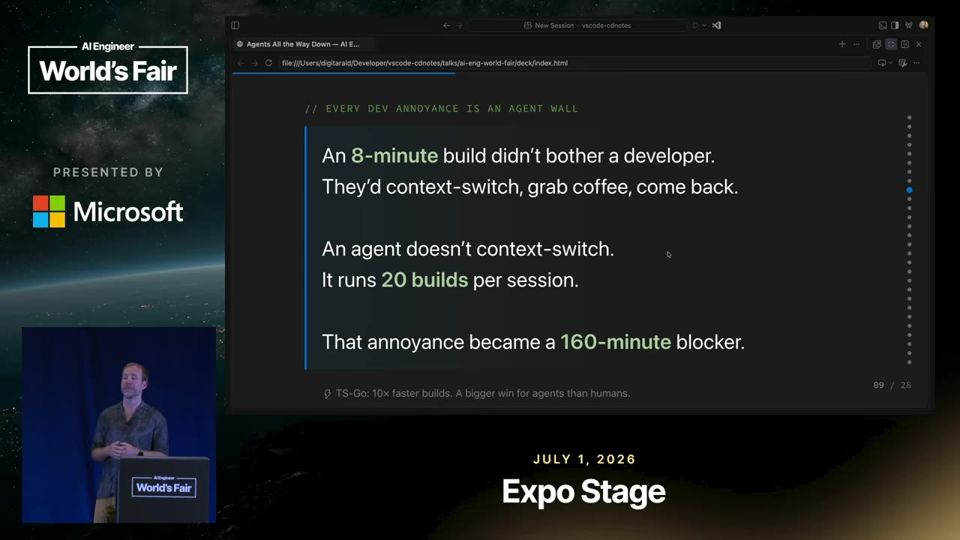
CI lento se multiplica com vários agentes

Com uma pessoa, build e testes lentos são incômodo contornável: ela revisa outro PR enquanto espera. Com 10 ou 20 agentes batendo no mesmo CI, cada lentidão se acumula. A migração para TypeScript Go deu builds 10 vezes mais rápidos, e o ciclo de feedback dos PRs automáticos depende disso.

Ilustra por que o tempo de CI vira o gargalo quando há muitos agentes.07:28

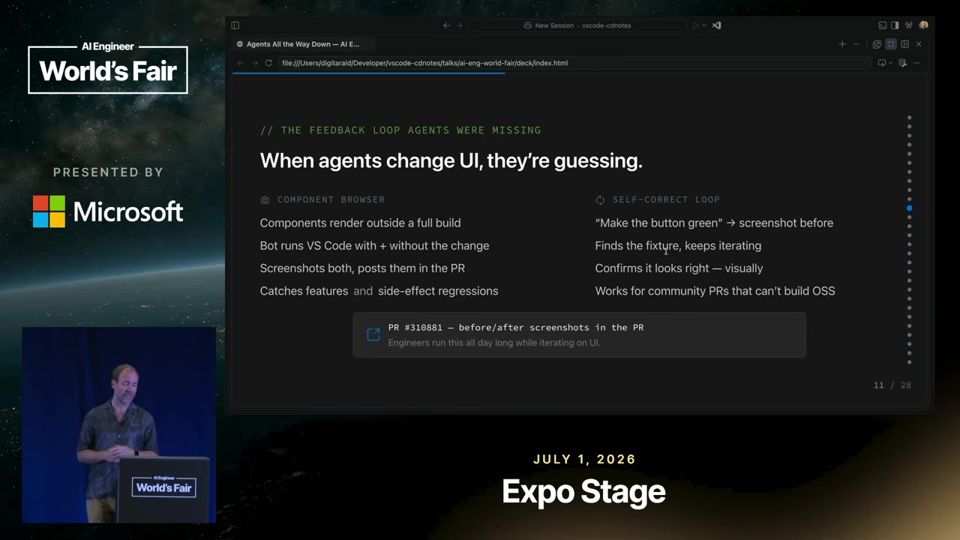
Deixe o agente usar o app para se corrigir

Agentes entregam UI desalinhada e dizem que está perfeita. O time criou um component browser, que tira screenshots de cada componente a cada mudança e aponta diferenças, e uma skill /launch com Playwright que abre o VS Code e percorre um cenário. O agente verifica o próprio trabalho antes de devolver a tarefa.

Comparação automática de screenshots mostra o efeito colateral de cada PR.09:06
Mais 2 ideias deste talk

De stack de erro a PR de correção

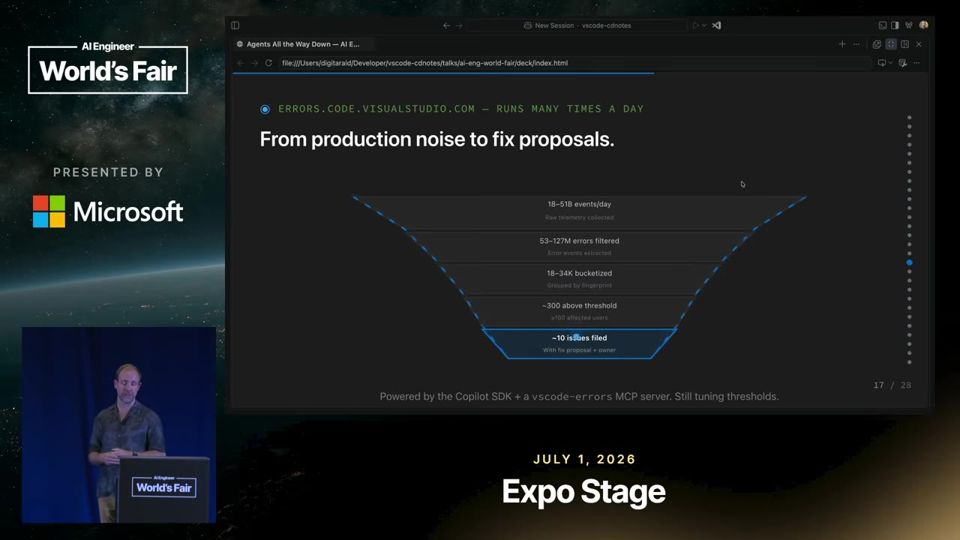
O pipeline parte de 51 bilhões de eventos de telemetria por dia. Filtra os que têm stack completo, agrupa por fingerprint (impressão digital do erro) e chega a cerca de 10 issues atribuídas a donos de área. Um agente abre o PR com a correção, e um humano aprova. O exemplo mostrado era um cancelamento que faltava no protocolo RPC.

Funil que reduz bilhões de eventos a poucas issues com PR automático.13:48

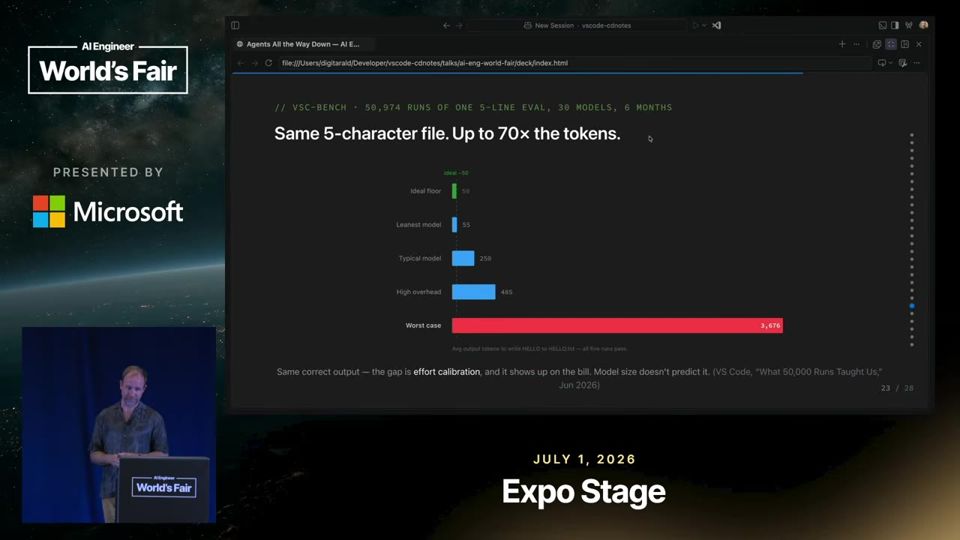
Entenda como cada modelo reage ao seu harness

Um eval de uma linha, escrever um arquivo com hello world, serviu para testar o harness de ponta a ponta. O mesmo arquivo de cinco caracteres custou 70 vezes mais tokens no modelo mais caro, e não era o modelo de raciocínio alto. O resultado mostra que custo e comportamento variam por combinação de modelo e harness.

Mostra a diferença de custo em tokens para a mesma tarefa trivial.16:58
leitura crítica

O palestrante é product manager da Microsoft e mostra o próprio produto, com stand na conferência, então o tom é de caso de sucesso. A subida de 55% para 86% mistura troca de modelo com melhoria de harness, e o talk não separa as duas causas nem define como mede o commit. Não há dados sobre bugs, regressões ou tempo de recuperação depois de passar para releases semanais. O contexto também pesa, porque o time é pequeno, mas tem telemetria de 51 bilhões de eventos por dia e acesso direto ao GitHub Copilot. Pouca coisa se transfere sem essa infraestrutura.

O que fazer com isso

  • Crie ou revise o AGENTS.md do seu repositório com um mapa curto do código e atualize o arquivo sempre que o agente errar.
  • Meça quanto do código gerado por IA você realmente mantém e acompanhe o número ao longo do tempo, como o code survival.
  • Dê ao agente um jeito de rodar o app e conferir o resultado, como screenshots ou Playwright, antes de pedir sua revisão.
  • Teste seu harness com um eval mínimo em cada modelo que você usa e compare o gasto de tokens, antes de escolher o modelo padrão.

What Makes Open Models Fast in Production

Modelo aberto rápido e barato depende de uma pilha de truques de servir: roteamento, cache, decodificação especulativa e quantização.

Infraestrutura 20:32 nível ●●●●○ Sujee Maniyam, Nebius Assistir no YouTube (abre em nova aba)

Em 3 frases

A Nebius defende que modelos abertos já chegam perto dos fechados e que o difícil é servi-los rápido e barato em produção.

Sujee Maniyam percorre as camadas de otimização de inferência: hardware NVFP4, escolha de engine, roteamento ciente de cache, decodificação especulativa, KV cache com offload, separação de prefill e decode, e quantização.

O talk também vende a Token Factory, plataforma que une inferência, dados, pós-treino e deploy num ciclo só.

Antes de ler

Mais 2 termos

Modelos abertos chegaram perto dos fechados

Sujee mostra um benchmark da Artificial Analysis em que modelos abertos (azul) competem com os proprietários (preto), às vezes superando vários. Para o cliente, isso significa escolha de provedor, menos dependência de um fornecedor e custo menor por token.

Modelos abertos aparecem lado a lado com os fechados no ranking de inteligência.10:33

Roteador que sabe onde está o cache

Balanceador de carga aleatório espalha requisições parecidas por GPUs diferentes e desperdiça cache. O roteador ciente de cache manda pedidos com o mesmo prefixo para a GPU que já guarda aquele trecho. Isso importa mais quando os prompts são enormes, como bases de código inteiras enviadas por agentes.

Roteamento ciente de cache agrupa o cache em vez de fragmentá-lo.13:39

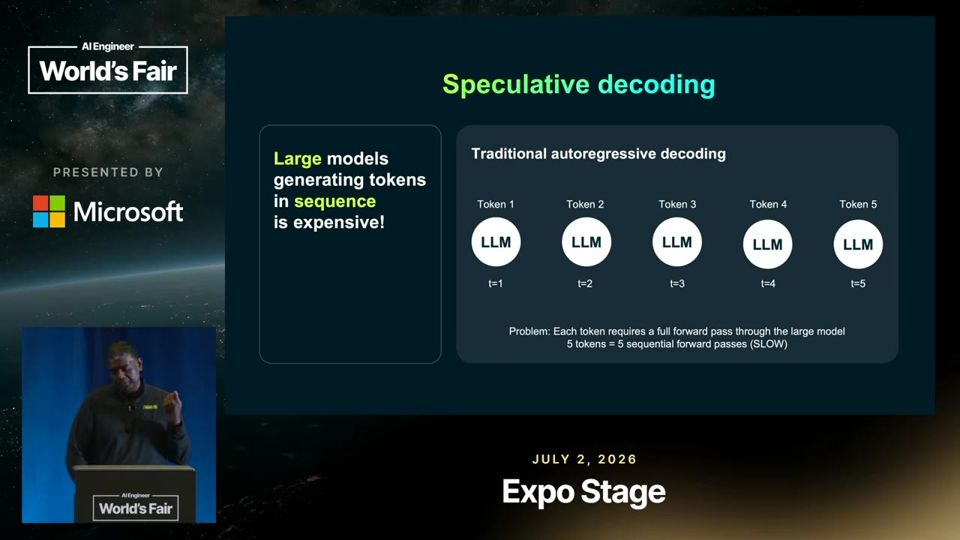
Decodificação especulativa: júnior rascunha, sênior confere

Um modelo pequeno gera os tokens rápido e o modelo grande só verifica. Se discordar, o grande regenera. A analogia é um engenheiro sênior que delega a um júnior e revisa. Treinar o modelo rascunho com o tráfego real do cliente melhora o resultado, e a empresa promete treino com um clique.

O modelo grande verifica o rascunho do pequeno em vez de gerar tudo sozinho.14:41
Mais 2 ideias deste talk

KV cache: não recalcule o que já foi calculado

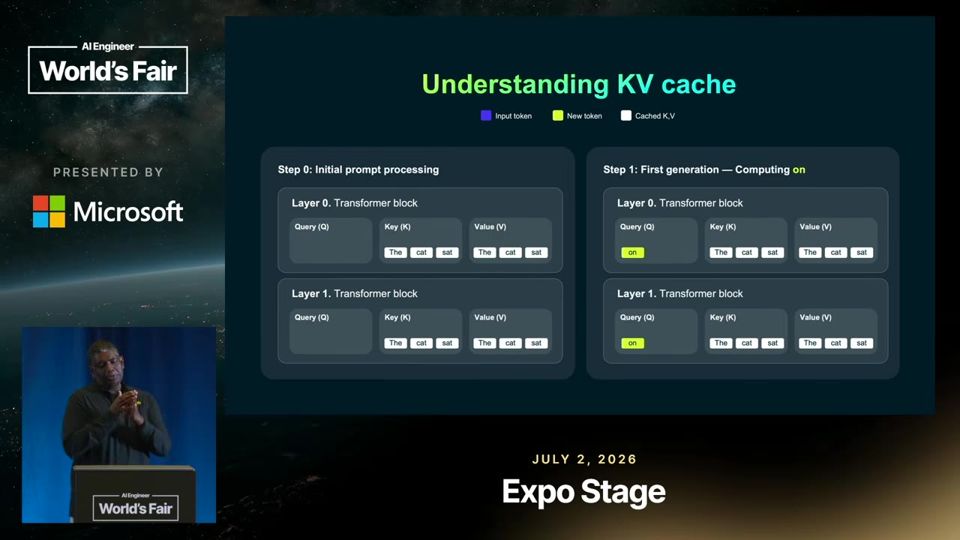
O KV cache guarda o trabalho já feito sobre o prompt, como em 'the cat sat on', para não recalcular. Como a memória da GPU é cara, a plataforma move o cache para a memória comum e o traz de volta quando precisa, sem o cliente gerenciar nada.

Tokens já processados ficam em cache e são consultados em vez de regenerados.16:15

Prefill e decode em GPUs separadas

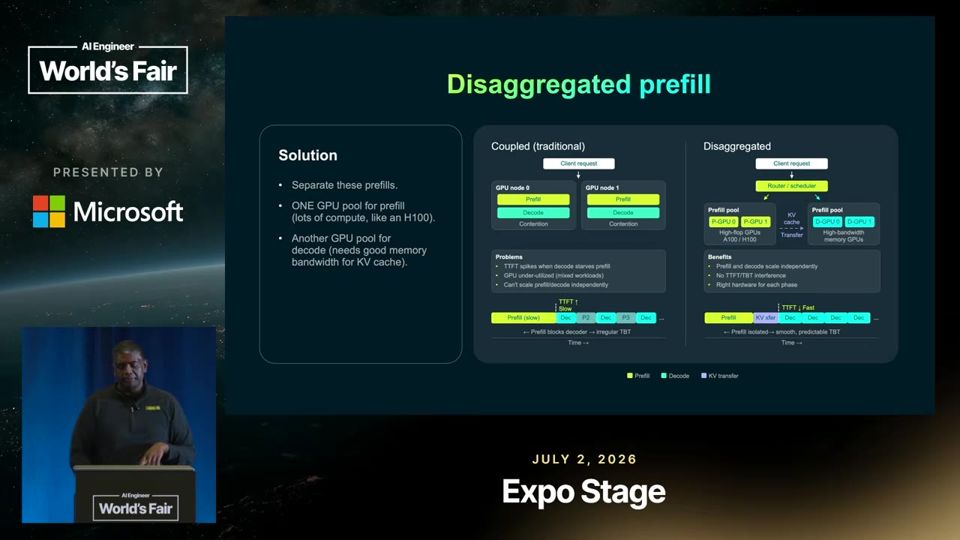
A fase de prefill (ler o contexto) pesa em computação. A fase de decode (gerar tokens) pesa em memória. Na mesma GPU elas competem por recursos. A Nebius separa as duas em grupos de GPUs diferentes e transfere o KV cache entre eles.

Duas fases com gargalos diferentes rodam em hardware dedicado a cada uma.17:48
analogia

KV cache (cache de chaves e valores da atenção). O KV cache é como as anotações que um aluno faz na margem do livro para não precisar reler o capítulo inteiro toda vez que responde uma nova questão.

  1. A IA escreve a resposta um token (pedaço de texto) por vez. Para escolher cada novo token, ela olha para todo o texto anterior.
  2. Sem cache, o modelo refaria os cálculos de todo o texto anterior a cada novo token. Isso desperdiça tempo, porque o texto anterior não muda.
  3. O KV cache (cache de chaves e valores) guarda o resultado desses cálculos para cada token já lido. No próximo passo, o modelo só consulta o que guardou.
  4. No talk, a Nebius cita ganhos de 5 a 10 vezes em velocidade. O custo é memória, que cresce com o tamanho do prompt.
  5. Como a memória da GPU é cara, a plataforma move o cache para a memória comum do servidor e o traz de volta quando o mesmo contexto aparece de novo.
PROMPTex. the cat sat on
CALCULA UMA VEZchaves e valores de cada token
GUARDA NO CACHEna GPU ou na memória comum
PRÓXIMO TOKENconsulta em vez de recalcular
GERAÇÃO MAIS RÁPIDA5 a 10x segundo o talk

Ajuda saber antes: Token, Mecanismo de atenção, GPU

analogia

Speculative decoding (decodificação especulativa). Speculative decoding é como um estagiário que escreve o rascunho de um e-mail e o chefe só lê e aprova, corrigindo apenas a primeira frase que estiver errada.

  1. Um modelo de linguagem escreve a resposta um pedaço por vez. Cada pedaço se chama token (fragmento de palavra), e modelos grandes demoram para gerar cada um.
  2. Speculative decoding (decodificação especulativa) coloca um modelo pequeno e rápido para chutar os próximos tokens, vários de uma vez.
  3. O modelo grande confere todos esses chutes numa única passada. Conferir vários tokens juntos custa quase o mesmo que gerar um só.
  4. O modelo grande aceita os chutes até o primeiro erro. No ponto do erro, ele coloca o token que ele mesmo escolheria e o ciclo recomeça dali.
  5. A resposta final sai igual à que o modelo grande daria sozinho. O ganho de velocidade depende de quantos chutes o modelo pequeno acerta.
RASCUNHO RÁPIDOmodelo pequeno chuta vários tokens
CONFERÊNCIA EM LOTEgrande checa todos numa passada
ACEITA OU CORRIGEcorta no primeiro erro e corrige
RESPOSTA MAIS RÁPIDAmesmo texto, menos espera

Ajuda saber antes: Token, Draft model, Inferência

analogia

Draft model (modelo rascunho). O draft model é como o auxiliar de cozinha que já deixa os pratos montados para o chef só conferir e finalizar.

  1. Draft model (modelo rascunho) é um modelo de IA pequeno que trabalha junto com um modelo grande.
  2. A função dele é adivinhar os próximos tokens (pedaços de texto) bem rápido, para o modelo grande apenas conferir.
  3. Ele precisa usar o mesmo vocabulário de tokens do modelo grande. Assim os dois falam a mesma língua na hora da conferência.
  4. Quanto mais o rascunho acerta, mais tempo o sistema economiza. No talk, um rascunho treinado com dados genéricos rendeu até 30% de ganho.
  5. Treinar o rascunho com o tráfego real do cliente aumenta a taxa de acerto, porque ele aprende o estilo de pedido daquele uso específico.
TRÁFEGO REALpedidos que o cliente já fez
TREINO DO RASCUNHOmodelo pequeno imita o grande
MAIS ACERTOSgrande aceita mais chutes
GERAÇÃO MAIS RÁPIDAmenos trabalho para o grande

Ajuda saber antes: Speculative decoding, Token, Fine-tuning

analogia

Prefill e decode (leitura do contexto e geração de tokens). Prefill e decode são como uma prova em que o aluno primeiro lê o enunciado inteiro de uma vez e depois escreve a resposta palavra por palavra.

  1. Quando você manda uma pergunta para a IA, ela trabalha em duas etapas. Primeiro lê tudo o que você enviou e depois escreve a resposta.
  2. A primeira etapa se chama prefill (pré-preenchimento). O modelo processa todos os tokens do prompt ao mesmo tempo, o que exige muito cálculo da GPU (placa de processamento).
  3. A segunda etapa se chama decode (decodificação). O modelo gera um token por vez e, a cada passo, precisa reler muitos dados da memória. Aqui o gargalo é a memória.
  4. Na mesma GPU, as duas etapas disputam recursos e uma atrasa a outra. Por isso a Nebius usa um grupo de GPUs só para prefill e outro só para decode.
  5. O grupo de prefill entrega ao grupo de decode o KV cache, que guarda o que já foi calculado sobre o prompt. Assim o decode começa sem refazer a leitura.
PROMPT CHEGAtexto enviado pelo usuário
PREFILLlê tudo junto, pesa em cálculo
TRANSFERE O KV CACHEpassa a leitura para outra GPU
DECODEum token por vez, pesa em memória
RESPOSTAfases sem disputar a mesma GPU

Ajuda saber antes: Token, GPU, KV cache

analogia

NVFP4 (formato de ponto flutuante de 4 bits da NVIDIA). NVFP4 é como anotar as medidas de uma receita com números arredondados e escrever no topo de cada grupo de ingredientes a escala certa para voltar ao tamanho real.

  1. Um modelo de IA é feito de bilhões de números. Guardar cada número com muita precisão ocupa memória e deixa o modelo lento.
  2. NVFP4 é um formato da NVIDIA que guarda cada número em só 4 bits, em ponto flutuante (número com vírgula). Isso reduz bastante o espaço ocupado.
  3. Com 4 bits sobram poucos valores possíveis. Para compensar, o formato agrupa os números em blocos pequenos e cada bloco ganha um fator de escala próprio.
  4. Os chips mais novos da NVIDIA, da linha Blackwell, calculam direto nesse formato. O modelo roda mais rápido e cabe em menos memória.
  5. A troca é perder um pouco de precisão. Por isso vale testar a qualidade do modelo depois de converter para NVFP4.
PESOS EM ALTA PRECISÃOnúmeros do modelo em 16 bits
BLOCOS PEQUENOSagrupa valores vizinhos
4 BITS + ESCALAcada bloco ganha seu fator
MODELO MENOR E RÁPIDOmenos memória, roda no Blackwell

Ajuda saber antes: Quantization, GPU, Bit

leitura crítica

O talk é pitch da Nebius Token Factory, e os dois palestrantes são funcionários da empresa. Não há metodologia nem gráfico próprio de desempenho. A única medida concreta é o ganho de 5 a 10 vezes com cache e de até 30% com modelo rascunho, ditos sem carga de trabalho, modelo ou hardware de referência. O benchmark de modelos abertos vem da Artificial Analysis, mas o recorte de modelos não é detalhado. Também falta comparação de custo com concorrentes. O ponto sobre quantização sem perda de qualidade não traz dado.

O que fazer com isso

  • Ao comparar provedores de modelo aberto, pergunte qual engine, qual chip e qual nível de quantização cada um usa, pois o mesmo modelo pode render custo e latência bem diferentes.
  • Se você envia prompts longos com prefixo repetido, como instruções fixas ou bases de código, estruture o início igual entre chamadas para aproveitar cache de prompt.
  • Antes de adotar um modelo quantizado, rode seu próprio eval (avaliação) comparando qualidade com a versão original.
  • Teste um modelo aberto em uma tarefa de baixo risco, medindo custo por token e qualidade contra o modelo fechado atual.

GPU Died. Training Didn't: Self-Healing Training at Scale

Em milhares de GPUs a falha é rotina. Slurm sobre Kubernetes troca o plantão de madrugada por um fluxo automático de troca de nó e retomada.

Infraestrutura 16:54 nível ●●●●○ Crusoe Assistir no YouTube (abre em nova aba)

Em 3 frases

A Crusoe explica que, em treinos com milhares de GPUs, falhas de hardware são certas e o conserto manual não escala.

A solução deles roda o Slurm (agendador de jobs de treino) dentro do Kubernetes, e o sistema AutoClusters detecta a GPU com defeito, troca o nó e recoloca o job na fila.

Na demo, uma falha simulada de GPU (XID 79) derruba o treino, e ele volta a rodar a partir do checkpoint em menos de 15 minutos, sem ação humana.

Antes de ler

Mais 2 termos

Slurm é bom em treino, fraco em dinamismo

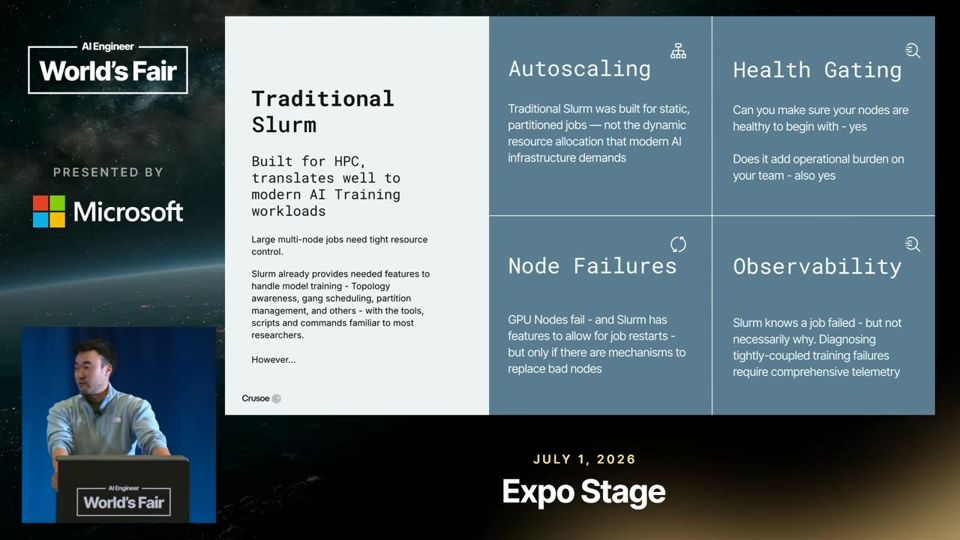
O Slurm nasceu há mais de 20 anos para computação de alto desempenho. Ele traz gang scheduling (todos os nós do job começam juntos), consciência de topologia de rede e scripts familiares aos pesquisadores. Mas é estático em partições, deixa a detecção e o dreno de nós para o operador e diz que o job falhou sem explicar bem o porquê.

Onde o Slurm serve ao treino e onde deixa lacunas operacionais.03:11

Duas pilhas custam o dobro

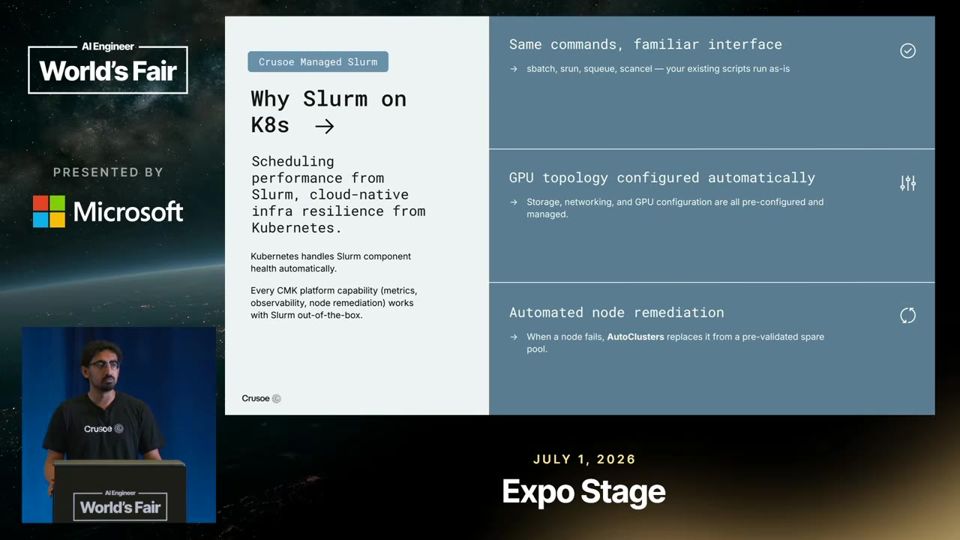
Times que já usam Kubernetes para inferência sofrem para operar um cluster Slurm, e times de treino em Slurm estranham o Kubernetes. O resultado são duas infraestruturas, com observabilidade, plantão e runbooks separados. A Crusoe propõe um operador que cria o cluster Slurm dentro do Kubernetes com um comando.

Arquitetura de Slurm como serviço dentro do Kubernetes.07:35

GPUs migram entre treino e inferência

Como o nó de GPU é um nó Kubernetes primeiro e o Slurm é só uma carga de trabalho, dá para tirar hardware do treino quando a inferência dispara e devolver depois. Quando o job de treino acaba, o nó não fica ocioso esperando outro job.

08:58 Hardware compartilhado entre treino e inferência numa única pilha.

Mais 2 ideias deste talk

Fluxo automático após um XID 79

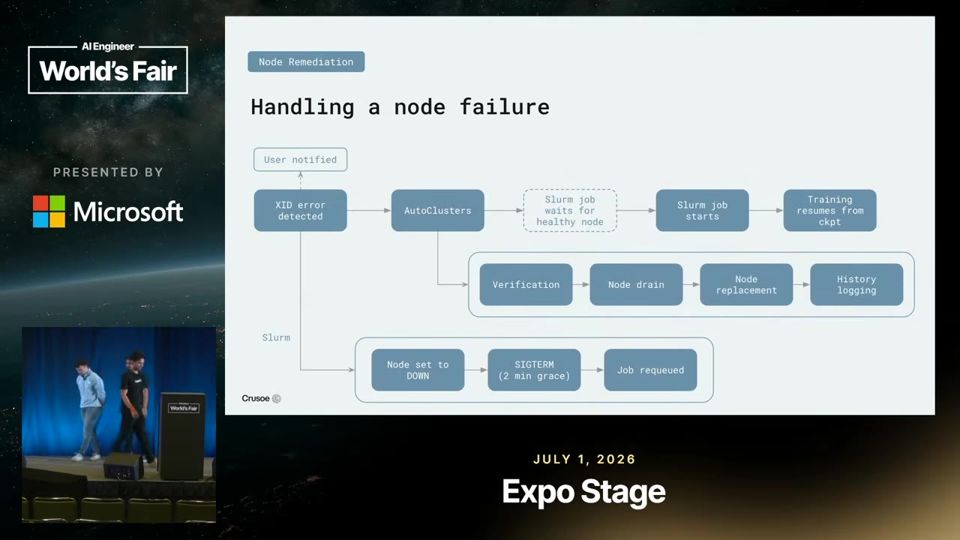
A sequência é notificar o usuário, marcar o nó como down no Slurm, enviar SIGTERM ao processo (com até 2 minutos para salvar checkpoint), reenfileirar o job, isolar e drenar o nó no Kubernetes, trocar por um nó saudável do estoque e registrar o alerta. Só então o job reinicia e carrega o checkpoint.

As etapas da remediação, da notificação ao reinício do job.10:03

Demo: GPU cai, treino volta sozinho

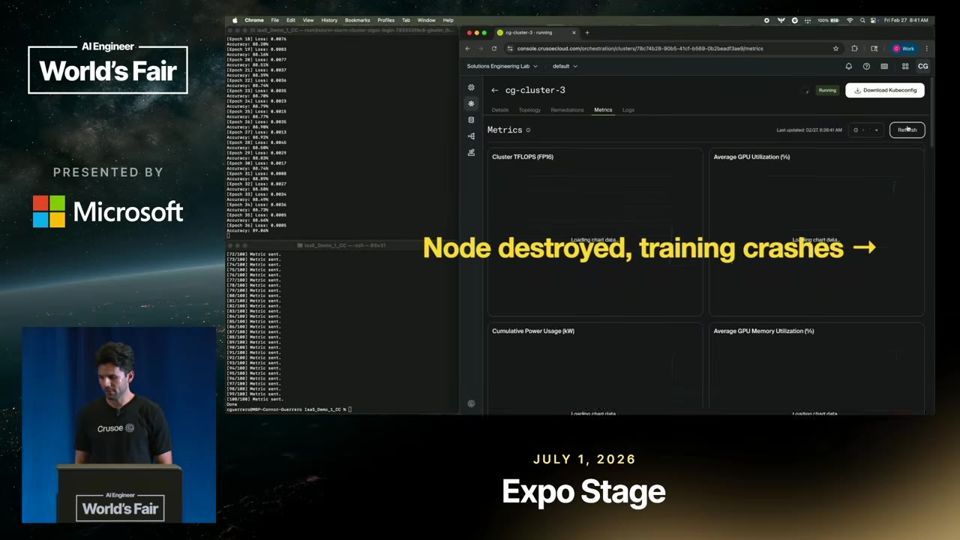
Connor lança um treino PyTorch com sbatch em um pool de dois nós A100 e injeta um alerta de XID 79 no monitoramento. A utilização da GPU despenca, a troca de nó começa na hora e o treino retoma do checkpoint. A troca de hardware leva cerca de 5 minutos, e o resto do tempo é código da aplicação.

A queda e a recuperação da utilização de GPU na demo.12:07
analogia

Slurm (agendador de jobs para clusters de computação). O Slurm é como o controlador de uma quadra esportiva que recebe os pedidos de horário, organiza a fila e libera a quadra para cada time na sua vez.

  1. Laboratórios têm muitas máquinas potentes e muitas pessoas querendo usá-las. Alguém precisa organizar quem usa o quê e quando.
  2. O Slurm é um agendador de jobs (tarefas de computação). O pesquisador escreve um script, envia com o comando sbatch, e o job entra numa fila.
  3. Quando há máquinas livres, o Slurm reserva os nós, inicia o job e acompanha até o fim.
  4. Ele nasceu há mais de 20 anos para supercomputação e traz gang scheduling, noção da topologia da rede e scripts de checagem antes e depois do job.
  5. As limitações apontadas no talk são partições estáticas, detecção e dreno de nós ruins por conta do operador, e pouca explicação sobre por que um job falhou.
SCRIPT SBATCHPesquisador descreve o job
FILAJob espera recursos livres
ALOCA NÓSReserva as máquinas pedidas
JOB RODATreino executa até o fim

Ajuda saber antes: Cluster de computação, Job, Fila de tarefas

analogia

Kubernetes (orquestrador de contêineres e serviços). O Kubernetes é como o gerente de um restaurante que garante sempre o número certo de cozinheiros nas bancadas e chama um substituto quando alguém sai.

  1. Empresas rodam muitos programas ao mesmo tempo em muitas máquinas, e alguém precisa decidir onde cada um roda.
  2. O Kubernetes é um orquestrador de contêineres (pacotes que levam o programa com tudo de que ele precisa). Você diz o que quer rodando, e ele distribui pelas máquinas.
  3. Ele compara o tempo todo o estado desejado com o real. Se um programa cai, ele sobe outro sozinho, recurso chamado self-healing (autocura).
  4. Também faz balanceamento de carga e autoscaling (ajuste automático de capacidade), e tem um ecossistema grande de extensões para rede, segurança e observabilidade.
  5. No talk, o Slurm vira apenas mais uma carga dentro do Kubernetes. Assim treino e inferência dividem as mesmas GPUs e a mesma operação.
ESTADO DESEJADOVocê declara o que deve rodar
COMPARA COM O REALVerificação contínua
CORRIGE DIFERENÇASSobe, move ou remove cargas
SERVIÇO ESTÁVELSistema volta ao desejado

Ajuda saber antes: Contêiner, Nó de computação, Cluster de computação

analogia

Gang scheduling (agendamento em grupo: todos os nós do job iniciam juntos). Gang scheduling é como um time de remo que só sai da margem quando os oito remadores estão sentados no barco.

  1. Um treino grande de IA usa vários computadores ao mesmo tempo, e cada um faz uma parte do trabalho.
  2. Essas partes conversam o tempo todo. Se uma máquina começa e a outra ainda não chegou, a primeira fica parada esperando.
  3. Gang scheduling (agendamento em grupo) resolve isso. O agendador só libera o job quando todos os nós pedidos estão livres, e então inicia todos juntos.
  4. Sem isso, nós ficam reservados e ociosos à espera dos colegas, e dois jobs podem travar um ao outro segurando metade das máquinas cada um.
  5. O Slurm traz esse recurso de fábrica, e por isso se encaixa bem em treinos com comunicação coletiva entre GPUs.
JOB PEDE N NÓSEx.: 16 máquinas com GPU
AGENDADOR ESPERASó age com todos os N livres
INÍCIO SIMULTÂNEOTodos os nós começam juntos

Ajuda saber antes: Nó de computação, Job de treino distribuído, Agendador de jobs

analogia

XID 79 (código de erro da NVIDIA para GPU que saiu do barramento e ficou inutilizável). XID 79 é como a luz do painel do carro avisando que o motor parou de vez, sem chance de seguir viagem.

  1. Placas de vídeo da NVIDIA (GPUs) registram problemas usando códigos numéricos, chamados XID.
  2. Cada número indica um tipo de falha. Alguns são leves, outros são graves.
  3. O XID 79 significa que a GPU "caiu do barramento": o computador perdeu a conexão com ela e a placa ficou inutilizável.
  4. Esse erro não se resolve sozinho. O job que usava a GPU para, e a máquina precisa de reinício ou troca.
  5. Na Crusoe, o sistema AutoClusters vigia esse código e, ao vê-lo, dispara a troca automática do nó e a retomada do treino.
GPU SAI DO BARRAMENTOMáquina perde contato com a placa
DRIVER REGISTRA XID 79Código de erro grave da NVIDIA
MONITOR DISPARA ALERTAAutoClusters detecta o erro
NÓ TROCADOTreino retoma do checkpoint

Ajuda saber antes: GPU, Nó de computação, Monitoramento

analogia

Cordon e drain de nó (isolar o nó e remover dele as cargas de trabalho). Cordon e drain é como fechar um caixa do supermercado com a plaquinha "caixa fechado" e atender os últimos clientes da fila antes de desligar.

  1. Num cluster, cada máquina (nó) recebe tarefas para executar. Às vezes uma máquina precisa sair de serviço.
  2. Cordon (isolar) é o primeiro passo. O Kubernetes marca o nó para não receber nenhuma tarefa nova.
  3. Drain (drenar) vem em seguida. O Kubernetes retira as tarefas que ainda rodam no nó e as recoloca em outras máquinas.
  4. Com o nó vazio, dá para removê-lo e colocar outro no lugar sem pegar nenhuma tarefa no meio do caminho.
  5. Na Crusoe, o AutoClusters faz isso sozinho após um XID 79, mas antes confere se algum pod tem um rótulo que proíbe a troca automática.
CORDONNó para de receber tarefas novas
DRAINTarefas atuais saem do nó
REMOVE DO POOLNó com defeito sai do grupo
NÓ SAUDÁVEL ENTRAReserva assume o lugar

Ajuda saber antes: Kubernetes, Nó de computação, Pod

leitura crítica

O talk é pitch de produto da Crusoe, apresentado por três funcionários. A demo usa uma falha simulada por script no monitoramento interno, não uma GPU que realmente quebrou. Os 15 minutos valem para um caso com dois nós A100, e o palestrante diz que a maior parte do tempo vem do código da aplicação, que muda de job para job. Faltam taxa de sucesso em falhas reais, falhas parciais (rede degradada, GPU lenta) e custo do estoque de nós reserva.

O que fazer com isso

  • Cheque se seu código de treino salva checkpoint com frequência e trata o SIGTERM, pois o tempo de retomada depende mais disso do que da troca de hardware.
  • Se você opera treino e inferência em pilhas separadas, liste o custo de plantão, observabilidade e runbooks duplicados antes de decidir unificar.
  • Ao avaliar um provedor de GPU, pergunte qual fluxo automático existe para detectar, drenar e substituir nós, e quanto tempo ele leva em falhas reais.

Fim da edição

Termos novos no glossário: Cypher, Drift, Thought signatures, Steps data model, Proxy man-in-the-middle, Speculative decoding, Draft model, Prefill e decode, NVFP4, KV cache, Gang scheduling, XID 79, Cordon e drain de nó, Slurm, Kubernetes.