Pular para o conteúdo
Aprendendo AI

Agentes no mundo real: catálogo, suporte, código e espera

Edição de domingo, 4 out 2026 · 5 vídeos · 1 h 25 min de talks

Cinco talks sobre o que acontece quando o agente sai da demo e encontra sistemas de verdade. O PayPal mostra por que catálogos feitos para palavra-chave confundem agentes de compra, e a AssemblyAI conta como um agente próprio de suporte saltou de 10% para 80% de tickets resolvidos. A Sourcegraph olha para quem cuida de dezenas de milhares de repositórios e defende visibilidade do código como infraestrutura. A AWS mostra um agente que escreve as próprias ferramentas em tempo de execução, e a Temporal fecha com o agente que precisa esperar dias por um humano sem perder o estado.

Keyword Search Is Dying. Is Your Catalog Ready for AI Agents?

Agentes de compra buscam pelo significado do pedido. Catálogo com dado estruturado e de qualidade ganha, e texto a mais atrapalha.

Dados e RAG 16:05 nível ●●○○○ PayPal Assistir no YouTube (abre em nova aba)

Em 3 frases

O PayPal diz que a compra passa da era da busca (palavras-chave) para a era da intenção (descrever a necessidade) e depois para a era da delegação (o agente compra por você).

Catálogos feitos para anúncios e SEO (otimização para buscadores) não são legíveis para agentes, e os modelos por trás deles funcionam como caixa-preta, então o PayPal rodou experimentos enriquecendo dados de lojistas.

Enriquecer ajudou, sobretudo catálogos magros, mas encher o produto de texto genérico diluiu o sinal e fez o agente alucinar. A recomendação é avaliar o próprio catálogo e priorizar conteúdo estruturado e de qualidade.

Antes de ler

Mais 2 termos

Três eras da compra: busca, intenção, delegação

Na era da busca, o cliente digita palavras-chave e navega pelo catálogo. Na era da intenção, ele descreve a necessidade com as próprias palavras, como a filha entrando no quinto ano, e a IA traz as marcas até ele. Na era da delegação, o cliente confia nas recomendações e passa a deixar o agente executar a compra.
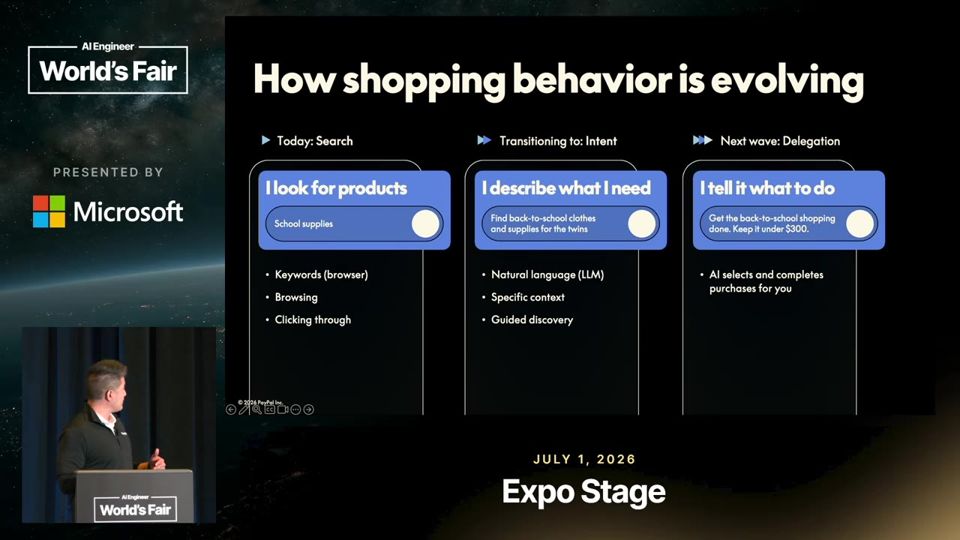
O PayPal propõe um modelo de três eras para o comportamento de compra.02:38

Catálogo feito para humanos e anúncios não serve ao agente

Lojistas costumam sindicar o catálogo para Google e Meta, num formato pensado para busca humana e anúncios. Esse formato não ajuda o agente a descobrir nem a ler o produto. Para piorar, cada agente usa um modelo diferente, com ranking próprio, e a busca vetorial nem sempre devolve o mesmo resultado. Sem estratégia clara como no SEO, o PayPal recomenda testar.
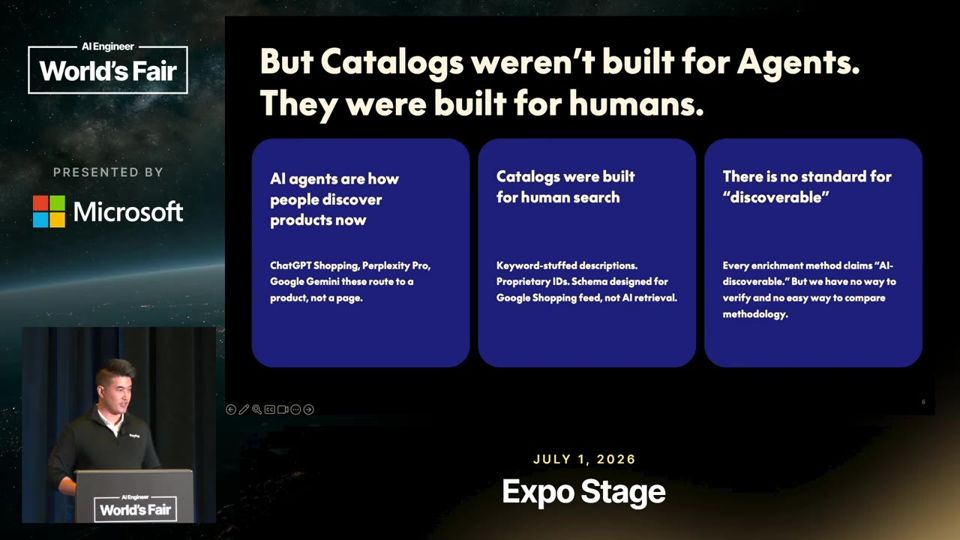
O formato atual de catálogo não foi desenhado para agentes.07:55

Busca por palavra-chave e busca semântica se complementam

A busca por palavra-chave é precisa, rápida e previsível, mas perde a intenção: quem busca calçado para corrida pode não ver tênis de corrida. A busca semântica converte a consulta em vetores e acha o tênis para treino de maratona sem nenhuma palavra em comum, porém é difusa e pode perder o foco. A abordagem híbrida combina as duas.
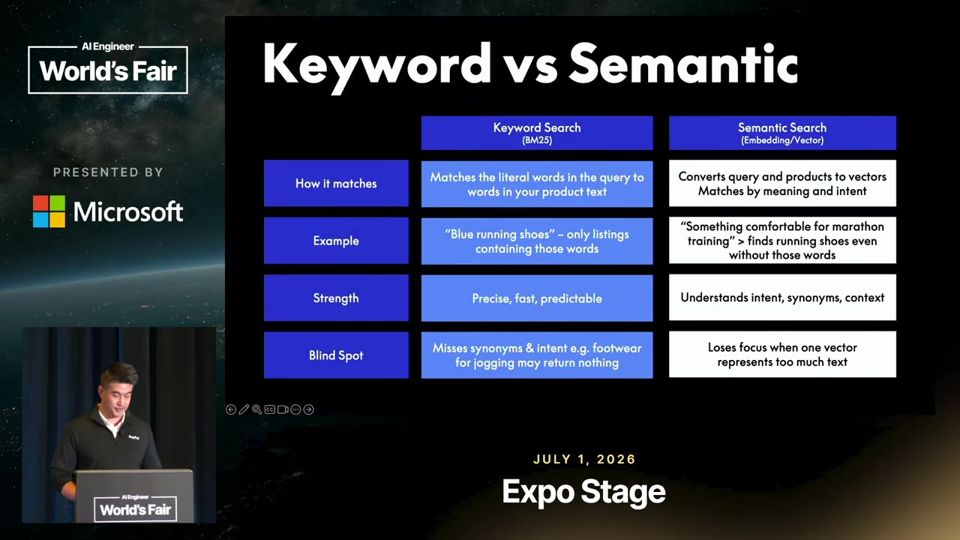
Keyword é literal e preciso, semântica é inteligente e difusa, híbrida junta as duas.10:01
Mais 2 ideias deste talk

Exemplo: enriquecer um tênis de corrida

O produto começa com título e descrição quase vazios, só azul e tamanhos. Depois do enriquecimento, ganha título descritivo, descrição com amortecimento e respirabilidade, atributos como material em mesh e caimento fiel ao tamanho, e avaliações. A busca passa a casar com corrida, treino e mesh. Os padrões testados foram preencher atributos, dar profundidade à descrição, incluir contexto de comprador e sinais de confiança.
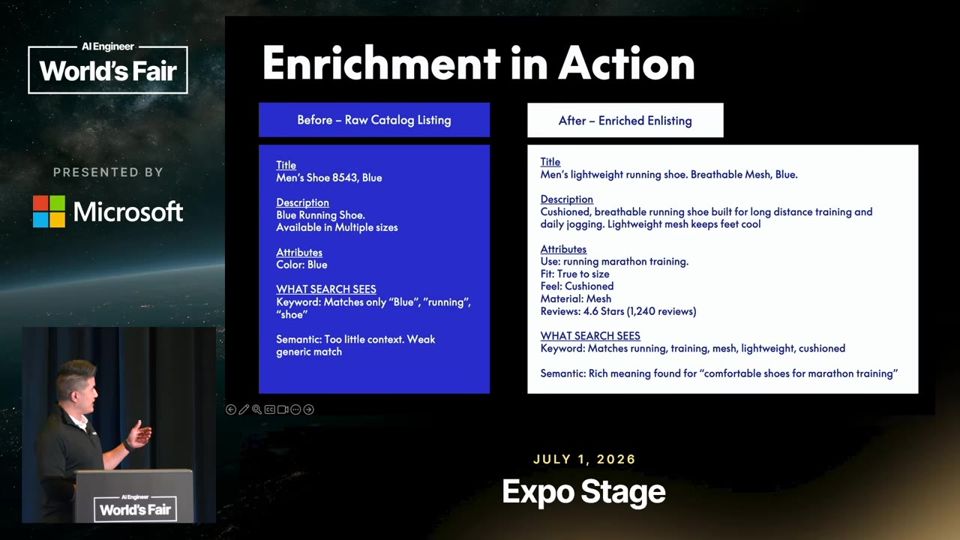
O mesmo produto antes e depois do enriquecimento de dados.12:34

Mais texto não é melhor: qualidade vence volume

O baseline sem enriquecimento perdeu de forma clara. Lojistas com catálogo mais magro tiveram o maior ganho. Já empilhar texto não estruturado, como boilerplate do tipo 'bem-vindo à nossa loja, somos uma empresa familiar', diluiu o sinal. Em alguns casos o excesso de enriquecimento levou o agente a alucinar mais e piorar o resultado.
Enriquecer ajuda, mas boilerplate dilui o sinal e aumenta alucinação.13:40
leitura crítica

O talk é pitch de produto: o PayPal vende Agentic Commerce Services e convida ao estande no fim. Os dados de mercado (Bain, 1,1 trilhão, 39%, 4x de conversão) vêm sem metodologia, e o 693% de tráfego de referência sai truncado na legenda. Os experimentos não trazem métricas, tamanho de amostra, modelos testados nem critério de 'melhor recomendação'. O próprio palestrante diz que foi um conjunto de experimentos e que não há recomendação concreta por negócio.

O que fazer com isso

  • Audite seu catálogo ou base de conteúdo e classifique como magro (poucos atributos) ou pesado em especificações antes de decidir o que enriquecer.
  • Preencha atributos estruturados (material, uso, tamanho) e inclua contexto de comprador e avaliações, em vez de adicionar texto institucional.
  • Monte um teste pequeno comparando recomendações de um agente com dados originais e enriquecidos, e observe se o enriquecimento aumenta alucinações.
  • Se usar busca em seus produtos de IA, avalie uma abordagem híbrida (palavra-chave mais vetores) em vez de escolher só uma.
We Built an AI Support Agent That Resolves 80% of Tickets

Troque o bot de prateleira por um agente seu, com docs em markdown e um CLAUDE.md que você corrige a cada erro.

Agentes 16:18 nível ●●○○○ AssemblyAI Assistir no YouTube (abre em nova aba)

Em 3 frases

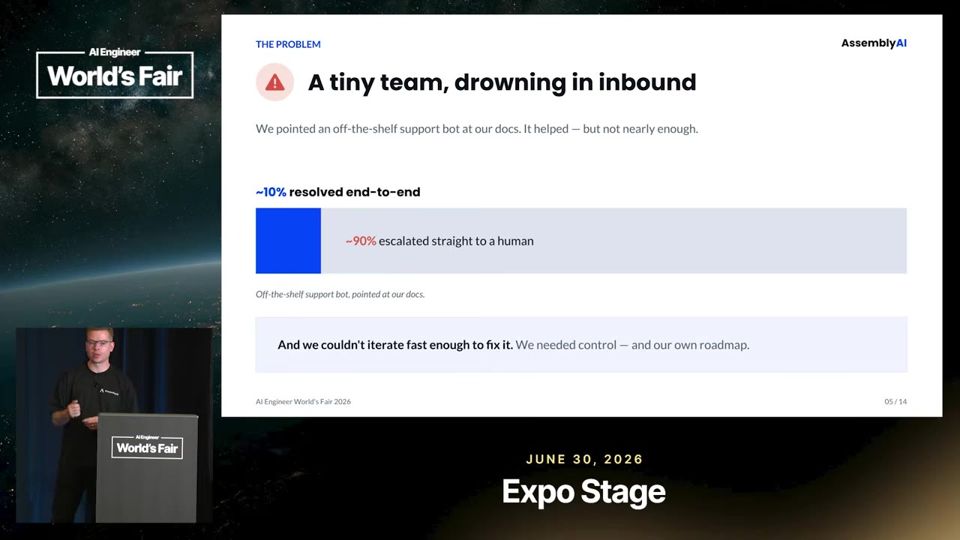
A AssemblyAI recebe cerca de mil cadastros de API por dia e tinha um único engenheiro de onboarding. Um bot de prateleira resolvia só 10% das conversas e a equipe não podia mexer em prompt, ferramentas nem RAG.

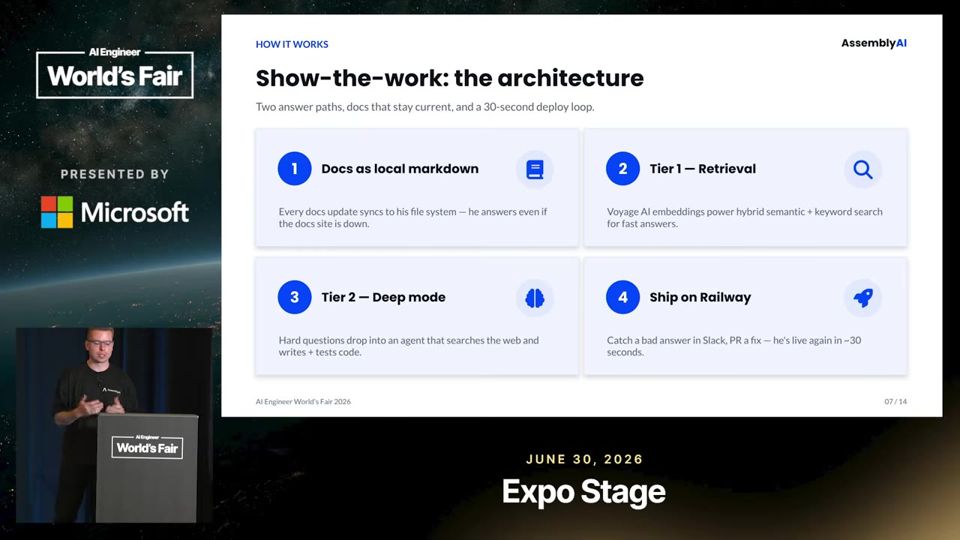
Eles construíram o Joey sobre o Claude Agent SDK, com docs em markdown local, embeddings da Voyage, busca agêntica em arquivos e um CLAUDE.md enorme. Cada resposta errada vira uma correção no CLAUDE.md, publicada em cerca de 30 segundos no Railway.

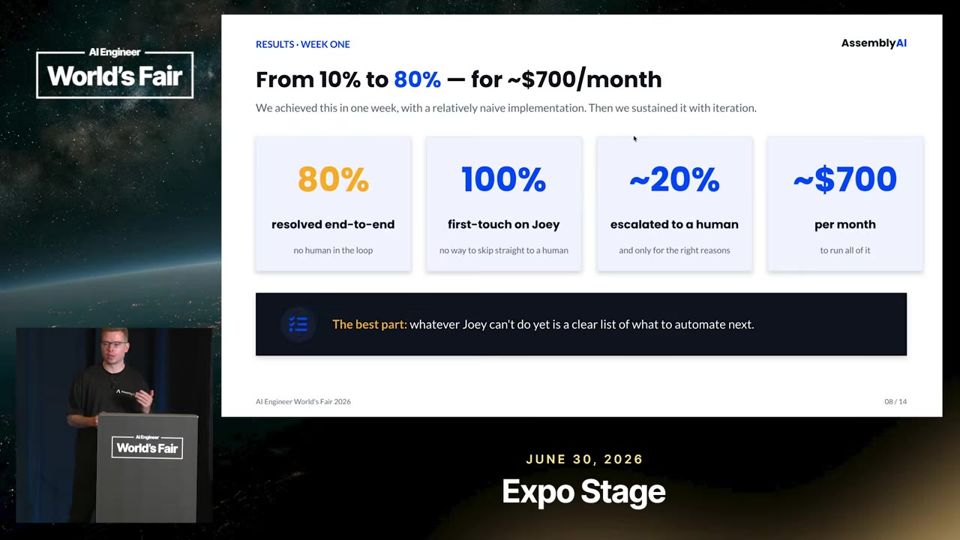
Segundo o palestrante, a resolução ponta a ponta foi de 10% para 80% na primeira semana, por cerca de US$ 700 por mês. Depois ele deu voz ao Joey com a Voice Agent API da empresa e defendeu que engenheiros de campo usem o próprio produto.

Antes de ler

Mais 2 termos

Bot de prateleira trava por falta de acesso

O bot comprado resolveu 10% das conversas. Sobravam cerca de 900 tickets por dia para humanos. O pior problema era não ter acesso ao system prompt, às ferramentas nem ao RAG. Toda mudança pedida ao fornecedor ouvia que estava no roadmap.

Sem acesso ao prompt e ao RAG, a equipe não consegue iterar.04:35

Arquitetura do Joey em quatro peças

Docs viram markdown local no sistema de arquivos do agente. Embeddings da Voyage trazem os trechos mais relevantes logo de início. Se a dúvida exigir mais, o agente busca nos arquivos por conta própria. O deploy fica no Railway, sem EC2 para administrar.

Quatro peças formam o Joey, todas sob controle da equipe.06:39

Corrigir o agente é editar um arquivo

Quando o Joey erra, a equipe revisa a conversa no Slack, ajusta o CLAUDE.md e faz um PR. Um novo Joey entra no ar em cerca de 30 segundos. Já houve caso de bug corrigido durante uma conversa ao vivo, sem o cliente notar.

O CLAUDE.md concentra as regras e é o principal ponto de ajuste.11:17
Mais 2 ideias deste talk

Resultado e o que sobra para humanos

A resolução foi de 10% para 80% na primeira semana, por cerca de US$ 700 mensais. O Joey recebe 100% dos tickets e escala 20% para humanos, em casos como mudança de tarifa, opt-out de dados e contratos. Cada escalação vira um item do roadmap do agente.

O número de 80% vem da própria empresa, sem auditoria externa.08:12

Voz com uma única conexão websocket

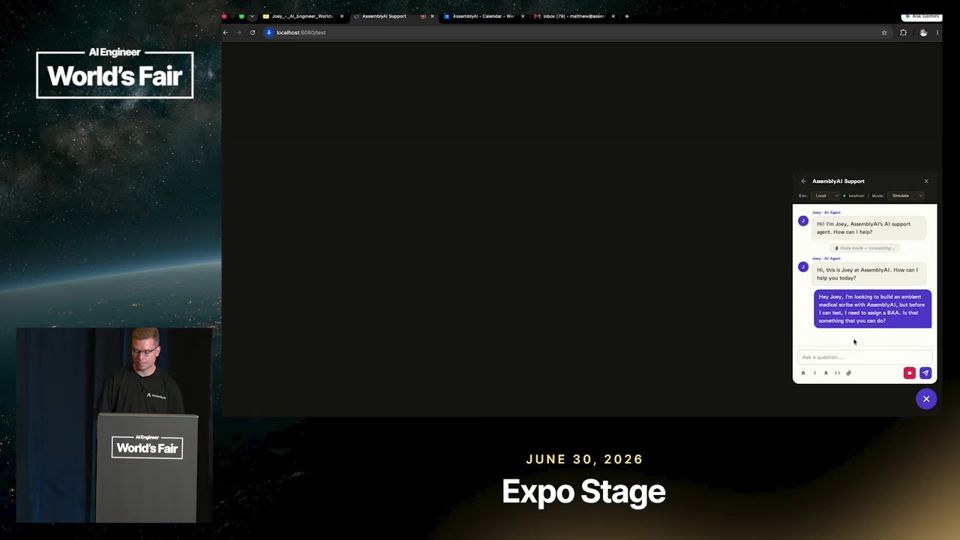
A Voice Agent API junta speech-to-text, LLM e text-to-speech numa conexão só, com tratamento de pausas e interrupções. No demo, o Joey responde por voz sobre assinar um BAA (acordo HIPAA) e cita as docs no chat.

A mesma ferramenta do texto agora responde por voz.12:51
leitura crítica

É palestra de empresa que vende a Voice Agent API, e o fim vira anúncio do produto. O 80% de resolução vem da própria equipe, sem definição de "resolvido" e sem checar se o cliente voltou ou ficou satisfeito. Ele chama a implementação de ingênua e cita US$ 700 por mês sem detalhar tokens e infraestrutura. Não há taxa de erro do Joey nem exemplos de respostas erradas. A demo foi simulada localmente, com uma única pergunta fácil.

O que fazer com isso

  • Liste os motivos de escalação do seu suporte e trate cada um como um item de roadmap para o agente.
  • Converta a documentação do seu produto para markdown e deixe o agente ler os arquivos, citando a URL de cada fonte.
  • Mantenha um CLAUDE.md versionado no repositório e corrija-o a cada resposta ruim, com deploy rápido.
  • Antes de comprar um bot de suporte, confirme se você terá acesso ao prompt, às ferramentas e ao RAG.

AI Coding Agents Are Breaking Big Codebases

Agentes geram código mais rápido do que os donos de grandes bases conseguem enxergar; visibilidade do código vira infraestrutura.

Engenharia de software 12:23 nível ●●○○○ Dan Adler, Sourcegraph Assistir no YouTube (abre em nova aba)

Em 3 frases

Dan Adler, CEO da Sourcegraph, diz que a maioria dos engenheiros trabalha em bases de código enormes e antigas, e que o código gerado por agentes acelera a degradação delas: duplicação, padrões divergentes, dependências frágeis e novas vulnerabilidades.

Para ele, o gargalo em escala corporativa está no contexto que o agente enxerga, mais do que na qualidade do modelo. Um agente que só faz grep (busca de texto) não entende o que não consegue ver em dezenas de milhares de repositórios.

Ele apresenta o Agentic Batch Changes, produto da própria Sourcegraph em beta, que aplica uma mudança em centenas ou milhares de repositórios a partir de um prompt, com rastreio e auditoria.

Antes de ler

Mais 2 termos

A maioria do software vive em bases grandes e antigas

Adler cita que 72% dos empregos da indústria de software estão em empresas com mais de 500 pessoas. Banco, seguradora, logística e aviação rodam sobre código de décadas, mantido por milhares de engenheiros. O talk fala por esse público, não pelas startups.

00:31 Prova o ponto de partida: o trabalho típico em software é em código grande e legado.

A onda de código gerado acelera a degradação

Mais código chega mais rápido, e agentes diferentes aplicam padrões diferentes. Surgem bibliotecas duplicadas, dependências entre serviços mais frágeis e pequenos desvios de padrão. Agentes também descobrem vulnerabilidades novas todo dia, o que exige manutenção constante. Revisores humanos e agentes de revisão ajudam, mas ele os compara a sacos de areia contra uma enchente.

Resume os quatro sintomas que o palestrante atribui ao excesso de código gerado.03:06

Contexto é o gargalo, não o modelo

Agentes entendem código buscando, como um novo funcionário. Com 500 ou 50 mil repositórios, não dá para clonar tudo nem caber em uma janela de contexto. Adler diz que descrever a arquitetura em arquivos agents.md quase não ajuda e que não se faz grep no que não se vê.

07:21 Resume o argumento central: busca sem visibilidade não escala.

Mais 2 ideias deste talk

Code graph como base para mudanças em massa

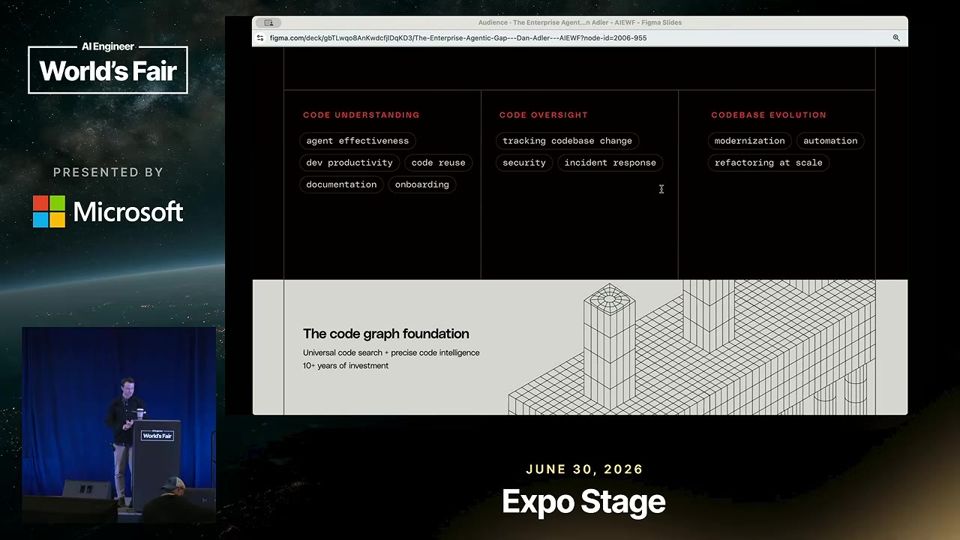
A Sourcegraph propõe um grafo do código, com busca e análise precisa como a de um compilador, para que agentes saibam onde e como mudar. Sobre ele, o Agentic Batch Changes aplica uma mudança em muitos repositórios, reage a CI e comentários de PR, usa agentes onde precisa de julgamento e scripts determinísticos onde não precisa, e registra tudo para auditoria.

Mostra o produto que o palestrante oferece como resposta ao problema.09:21

Caso Mercari: de 2 repositórios a 80 achados

Um usuário em acesso antecipado na Mercari corrigiu uma falha de injeção de código no GitHub (variáveis de ambiente mal configuradas) em dois repositórios. Depois pediu ao agente para explorar o resto e ele achou cerca de 80 outros pontos vulneráveis, corrigidos com um script determinístico.

Único caso concreto do talk, vindo de um usuário do próprio produto.10:23
leitura crítica

Adler é CEO da Sourcegraph e vende a solução que defende, então o talk é em grande parte pitch. Ele não mostra dados sobre decaimento de código causado por agentes, só relatos de executivos sem nome. O caso Mercari é uma citação de um usuário em acesso antecipado, sem taxa de falsos positivos nem medição de esforço. A afirmação de que OpenAI, Anthropic e Cursor não constroem essa infraestrutura não tem evidência no vídeo. O produto está em beta e o talk não traz demo.

O que fazer com isso

  • Levante quantos repositórios, forks e bibliotecas externas sua empresa realmente tem em produção, antes de pedir a um agente para mexer neles.
  • Ao usar agente para mudança repetida em muitos repositórios, peça um script determinístico para a parte mecânica e deixe o agente só para os casos de julgamento.
  • Exija trilha de auditoria em mudanças em lote: uma lista dos repositórios alterados, do status do CI e dos que ficaram de fora.
  • Ao testar ferramentas como a Sourcegraph, peça medição própria de falsos positivos em uma amostra dos seus repositórios, em vez de confiar em casos do fornecedor.

Agents That Write Their Own Tools at Runtime

Um agente com um prompt bom e três ferramentas genéricas escreve o que falta, mas só merece produção com evals e guardrails.

Agentes 20:40 nível ●●●○○ Sandhya Subramani, AWS Assistir no YouTube (abre em nova aba)

Em 3 frases

Sandhya Subramani, da AWS, mostra um agente que começa sem nenhuma ferramenta e escreve, carrega e usa as próprias ferramentas durante a execução, sem reiniciar.

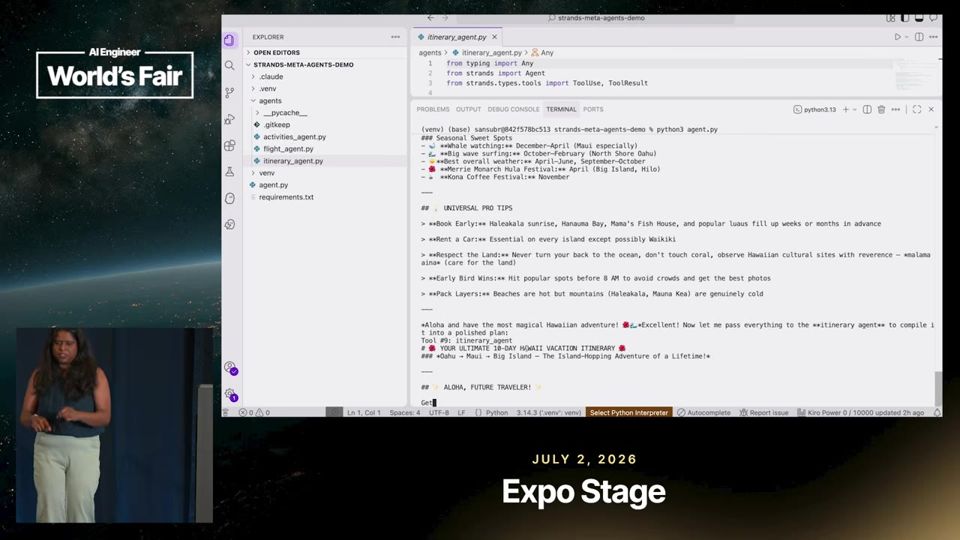
A receita usa o Strands Agents SDK, um prompt de sistema que descreve como é uma boa ferramenta e três ferramentas: editor, shell e load_tool. O mesmo truque cria subagentes, como num planejador de viagem.

Como o agente pode alterar e apagar coisas, ela defende avaliações em vários níveis e quatro guardrails: ambiente isolado, permissões restritas, observabilidade e evals.

Antes de ler

Mais 2 termos

Agente sem ferramentas que cria as próprias

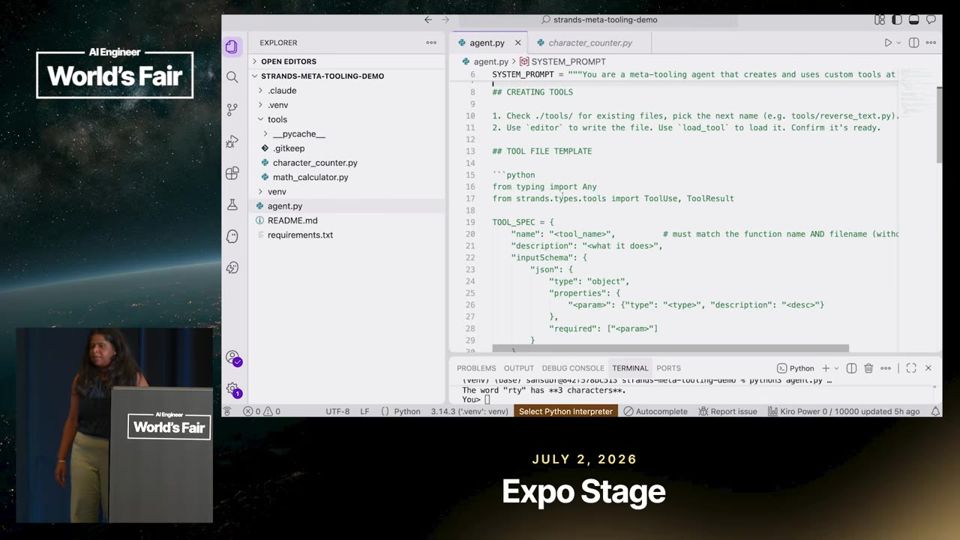
O agente da demo tem a pasta de ferramentas vazia. Ao receber um pedido de cálculo, ele escreve uma ferramenta de calculadora, a carrega na hora e responde. Depois faz o mesmo para um contador de caracteres. Não é preciso reiniciar o processo.

03:09 A ferramenta nasce durante a conversa e já é usada na resposta seguinte.

Receita: um prompt e três ferramentas

O agente precisa de um prompt de sistema com o molde de uma ferramenta (decorator @tool, especificação, regras e onde salvar) e de três ferramentas: editor para escrever, shell para ver o que existe e load_tool para carregar da pasta. Tudo cabe em poucas linhas de código.

O código inteiro do meta-tooling é curto: prompt mais três ferramentas.08:53

Agentes que criam subagentes

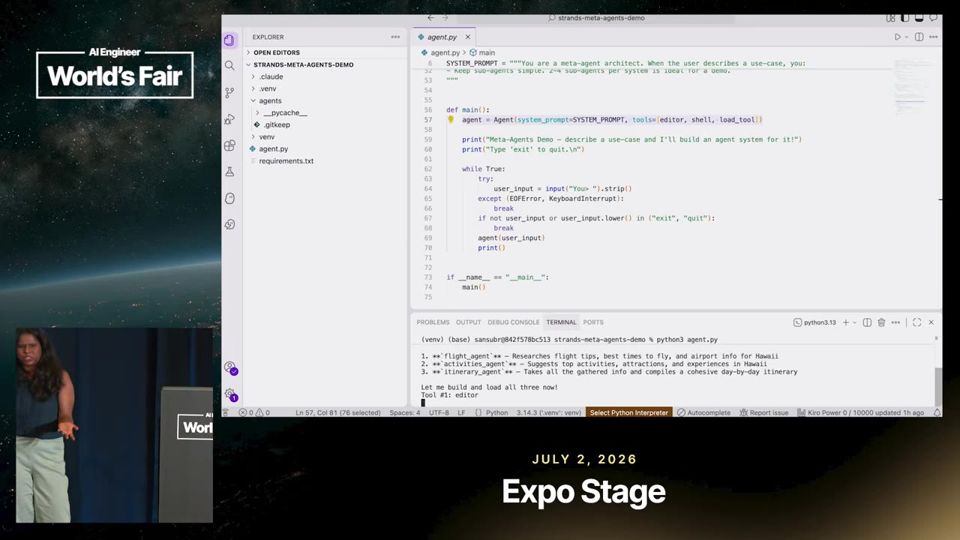
Com o mesmo método, o agente cria subagentes. Para um pedido de roteiro no Havaí, ele gerou três: voos, atividades e itinerário, chamando o editor uma vez para cada. Ela cita os padrões swarm, graph, handoff e workflow, que o agente também pode montar.

O agente decide sozinho a divisão em três subagentes.13:03
Mais 2 ideias deste talk

Autocorreção em produção

Ela argumenta que um agente que reconhece o próprio erro e corrige a ferramenta evita o ciclo de derrubar, consertar e subir de novo. Na demo, o agente quebrou por excesso de saída, e ela diz que ele costuma se consertar. Isso foi relatado, não mostrado em detalhe.

O agente reconhece o erro e propõe atualizar a própria ferramenta.14:35

Evals e guardrails antes de confiar

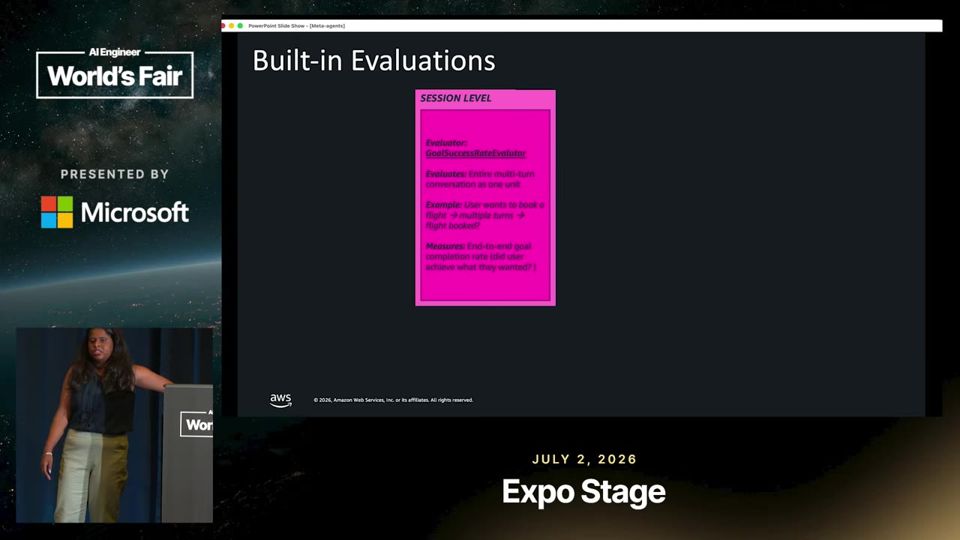
Ela lista avaliações por sessão (cumpriu o objetivo), por trace (resposta útil e sem invenção), por ferramenta (escolha e parâmetros certos) e entre agentes (ordem e mensagens). Os guardrails são ambiente isolado, permissões restritas e observabilidade, para o agente não apagar dados.

Evals medem objetivo, ferramenta, parâmetros e fluxo entre agentes.15:38
leitura crítica

É demo de produto da AWS para o Strands, com a palestrante no papel de divulgadora. A demo é pequena (calculadora, contador de letras, roteiro de viagem) e não há medição de taxa de acerto, custo ou segurança. A autocorreção é descrita, não mostrada, e ela admite que a demo quebra. Os guardrails aparecem em lista, sem como configurá-los. A fala de que o Strands escreveu a versão em TypeScript não traz detalhes de quanta revisão humana houve.

O que fazer com isso

  • Teste meta-tooling num repositório descartável: dê editor, shell e load_tool a um agente e veja que ferramentas ele cria para pedidos que não prevê.
  • Antes de liberar um agente que escreve código, rode-o em sandbox, com permissões mínimas e sem acesso de escrita a dados reais.
  • Monte evals em quatro níveis para seus agentes: objetivo da sessão, resposta, escolha e parâmetros de ferramenta, e fluxo entre subagentes.
  • Registre traces de cada ferramenta criada em runtime, para revisar o que o agente escreveu e decidir quais promover ao código oficial.

The Human Is an Async API

Humano demora minutos ou semanas para responder. Agente que espera por ele precisa pausar de forma durável, guardando o estado fora do processo.

Agentes 19:15 nível ●●●○○ Melanie Warrick, Temporal Assistir no YouTube (abre em nova aba)

Em 3 frases

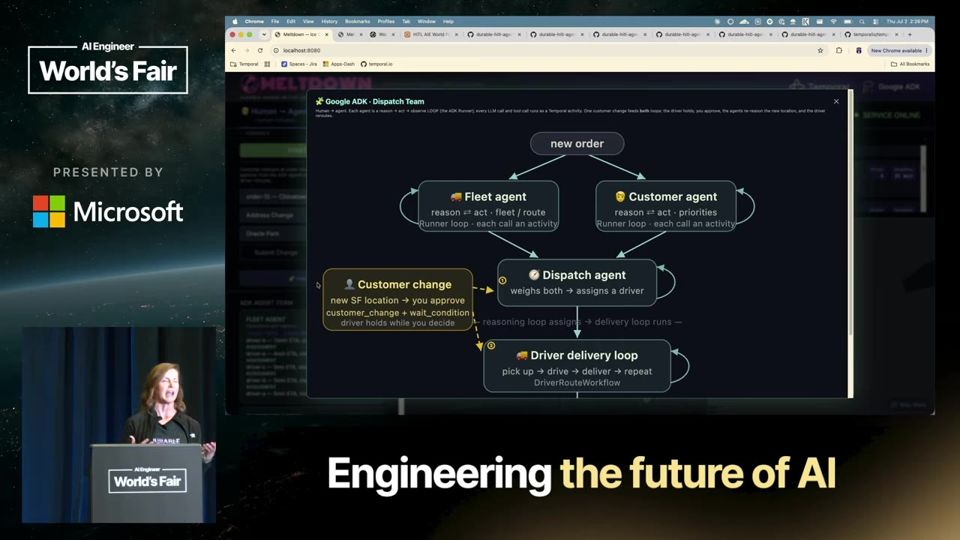
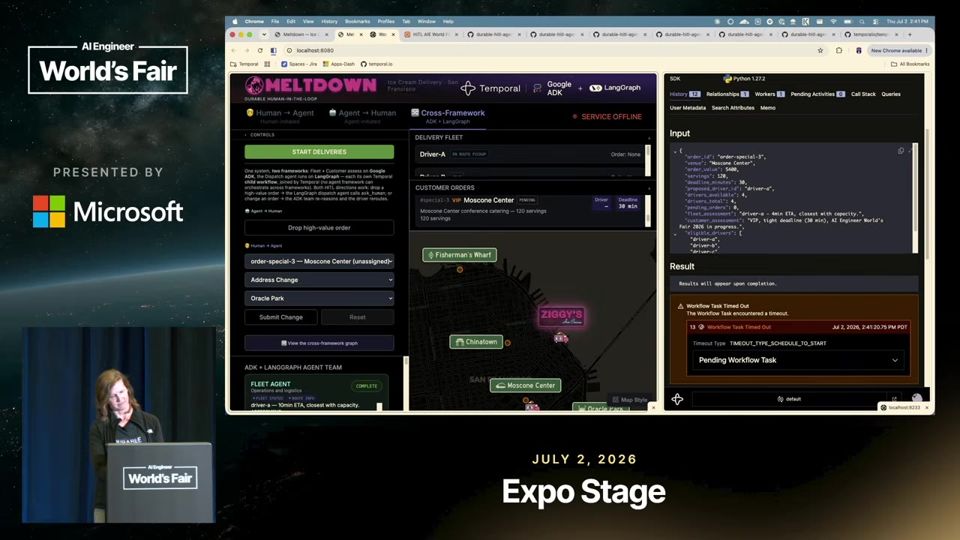
Melanie Warrick, da Temporal, mostra um demo de entrega de sorvete com três agentes (frota, cliente e despacho) em que um pedido espera aprovação humana sem travar o resto do sistema.

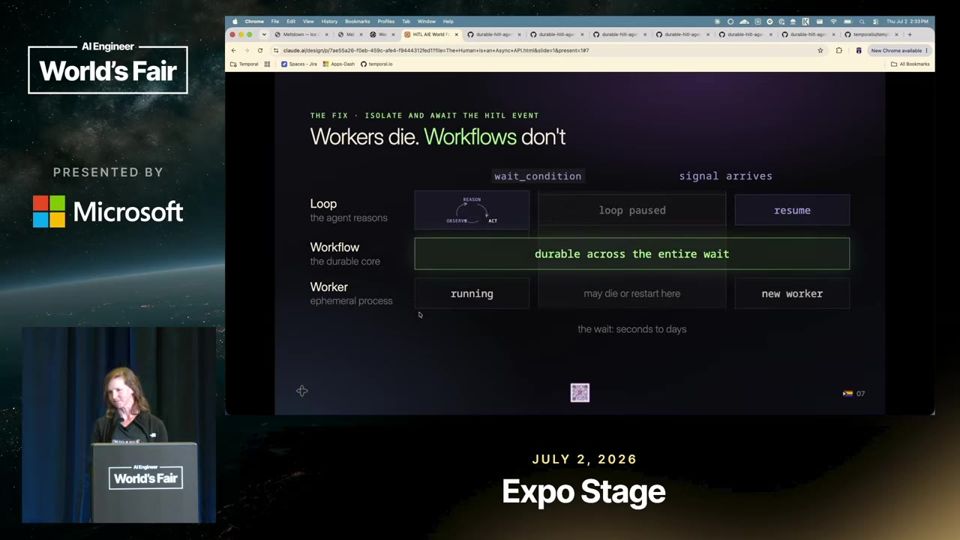
A solução usa duas primitivas da Temporal, a wait condition (condição de espera) e o signal (sinal), guardadas em um workflow (fluxo durável) que sobrevive a quedas do worker (processo que roda o código).

Ela mata o worker no meio da aprovação, aprova mesmo offline, e o agente retoma de onde parou porque o histórico de eventos é reexecutado, não refeito. Ao final, discute quando vale pôr um humano no loop.

Antes de ler

Mais 2 termos

Três agentes coordenados por um workflow pai

O demo tem um agente de frota, um de cliente e um de despacho. Frota e cliente pesquisam (Google Maps, Google Search) e o despacho decide com o resultado. A Temporal registra o estado de tudo em um workflow pai, com histórico de eventos visível na interface.

Vários agentes rodando juntos, com o estado rastreado em um único histórico.01:16

Worker, workflow e activity

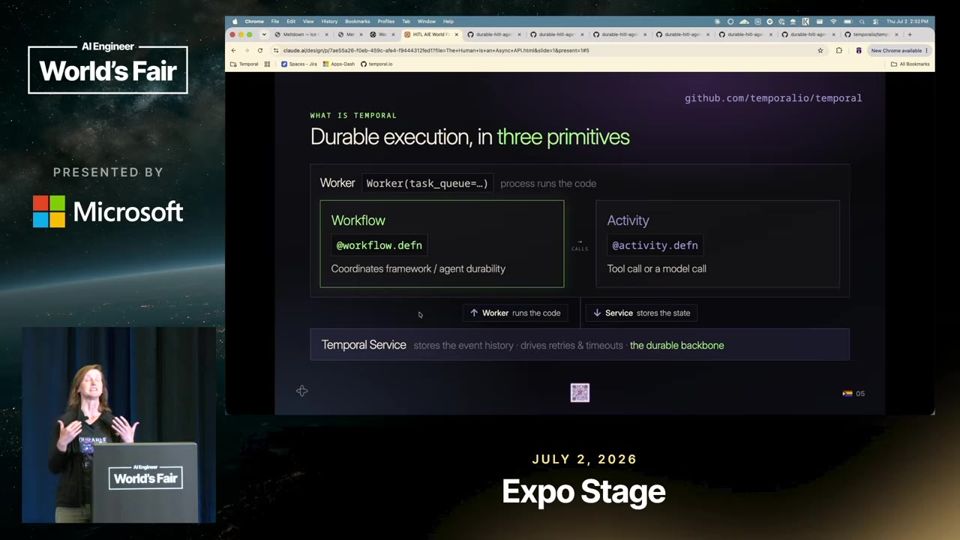
O worker roda o código. O workflow guarda os passos e é onde o loop do agente vive. A activity cobre tudo que fala com o mundo externo, como chamadas ao modelo e às ferramentas. Essa divisão decide onde cada pedaço do código fica.

Chamada de modelo e de ferramenta viram activities; o loop fica no workflow.06:26

Chamada bloqueante perde o humano; wait e signal não

Se o agente chama o humano como uma função comum, a chamada bloqueia e se perde quando o serviço cai. Com wait condition o fluxo pausa e o estado fica salvo na camada durável. O humano responde por um signal quando puder, e só aquele workflow espera.

Duas primitivas bastam para pausar por minutos ou semanas sem segurar thread.08:01
Mais 2 ideias deste talk

Matar o worker e voltar sem perder trabalho

No demo, ela derruba o worker, aprova o pedido enquanto ele está offline e sobe o worker de novo. O evento ficou na fila do armazenamento da Temporal. O agente reexecuta o log até o último ponto, vê a aprovação e entrega o pedido.

Replay do log recupera o estado; nada é refeito.15:50

Quando o humano deve entrar no loop

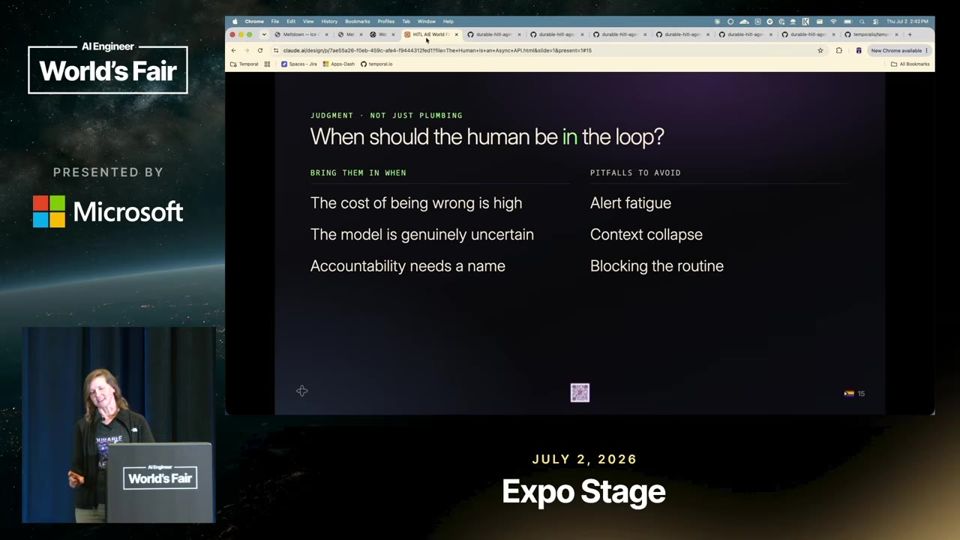
O critério central é o custo de errar, principalmente em segurança. Do outro lado há a fadiga de alerta, quando a pessoa passa a aprovar tudo sem ler. Ela admite que a resposta depende do caso e que os modelos continuam probabilísticos.

A decisão de pôr humano no loop equilibra custo de erro e cansaço de quem aprova.16:51
analogia

Replay de event history (reexecução do histórico de eventos). Replay do histórico de eventos é como um cozinheiro que assume o turno no meio do serviço, lê a comanda com os pratos já marcados como prontos e continua a partir do próximo prato.

  1. O sistema anota cada passo concluído de uma tarefa em um registro, chamado histórico de eventos (event history).
  2. Esse registro fica guardado no armazenamento da Temporal, fora do worker (processo que roda o código). Se o worker cai, o registro continua lá.
  3. Quando o worker volta, ele relê o histórico desde o início e reconstrói o estado. Os passos já feitos usam o resultado anotado, sem chamar o modelo ou a ferramenta de novo.
  4. Ao chegar no fim do registro, o agente encontra os eventos que chegaram enquanto ele estava fora, como uma aprovação humana, e segue para o próximo passo.
  5. No demo, a palestrante derruba o worker, aprova o pedido com ele offline e, na volta, o pedido é atribuído e entregue sem perder trabalho.
WORKER CAIProcesso sai do ar no meio da espera
EVENTO NA FILAAprovação fica guardada na Temporal
WORKER VOLTAProcesso sobe de novo
RELÊ O HISTÓRICOReconstrói o estado sem refazer passos
PEDIDO ENTREGUEAgente segue do ponto onde parou

Ajuda saber antes: Durable execution, Workflow, activity e worker, Determinismo em workflows

analogia

Determinismo em workflows (workflows determinísticos, activities não). Determinismo em workflows é como uma receita de bolo escrita, que dá sempre os mesmos passos na mesma ordem, enquanto a ida ao mercado para comprar os ingredientes pode terminar diferente a cada vez.

  1. Determinístico quer dizer que, com a mesma entrada, o código faz sempre a mesma coisa.
  2. A Temporal divide o código em duas partes. O workflow (fluxo) guarda os passos de decisão. A activity (atividade) faz tudo que fala com o mundo externo.
  3. Chamadas ao modelo de linguagem e a ferramentas podem dar respostas diferentes a cada vez. Por isso viram activities, que podem falhar e receber retry (nova tentativa).
  4. O workflow precisa ser determinístico porque a Temporal o reexecuta a partir do histórico. Se ele decidisse diferente na reexecução, o estado reconstruído não bateria com o registrado.
  5. No demo com LangChain, cada chamada de modelo ou de ferramenta dentro de um nó do grafo vira activity, e os passos do processo ficam no workflow.

Ajuda saber antes: Workflow, activity e worker, Replay de event history

leitura crítica

A palestrante trabalha na Temporal e avisa que está pitchando a empresa. O demo é controlado, com poucos pedidos, e não traz métrica de custo, latência ou taxa de falha. Ela diz que dá para escalar a milhões de workflows parados, sem mostrar dado. A visão de harness é apresentada como um mapa pessoal e sujeita a debate. Não compara com alternativas, como filas, banco de dados com estado ou outros orquestradores.

O que fazer com isso

  • Revise onde seus agentes chamam uma pessoa por uma função que bloqueia. Troque por um estado salvo mais um evento de retomada.
  • Em qualquer fluxo de agente, separe o que é passo de decisão (loop) do que fala com o mundo externo (modelo, ferramenta). Só o segundo precisa de retry e timeout próprios.
  • Defina um timeout para toda espera por aprovação humana e decida o que acontece quando ele estoura.
  • Liste as ações do agente por custo de erro. Peça aprovação humana só nas caras ou de risco de segurança, para evitar que o revisor aprove tudo no automático.

Fim da edição

Termos novos no glossário: Replay de event history, Determinismo em workflows.