Pular para o conteúdo
Aprendendo AI

Contexto, confiança e memória para agentes em produção

Edição de quinta, 8 out 2026 · 10 vídeos · 2 h 44 min de talks

Esta edição sai do protótipo e entra na rotina de uma empresa que usa agentes de verdade. Começa pelas pessoas e pela plataforma: como dar tempo para o time aprender e como deixar qualquer um publicar um app interno com segurança. Depois vem o contexto que o agente precisa enxergar, do mapa de APIs à telemetria de produção, e como validar o que ele entrega com PRs revisados por agentes, evals guiados pelo cliente e ferramentas MCP mais enxutas. Fecha com arquitetura e memória: separar quem planeja de quem executa e transformar experiência em lições e skills que o agente reaproveita.

How a Remote Company Builds AI Fluency

Dar ferramentas de IA não muda o jeito de trabalhar. Tempo protegido para aprender e praticar muda, e cada egresso vira professor.

Carreira e equipes 15:32 nível ●●○○○ Em Shreve, Automattic Assistir no YouTube (abre em nova aba)

Em 3 frases

A Automattic (WordPress.com e Tumblr, mais de 1.400 pessoas em 82 países) aposta que as pessoas precisam de tempo real para aprender IA, e não só de acesso às ferramentas.

Ela roda programas presenciais de duas semanas, metade oficinas e metade projeto real, para engenheiros, times mistos e áreas não técnicas como finanças e liderança.

Cada egresso vira multiplicador por meio de guias, encontros locais, ride-alongs e um canal de ajuda; os resultados vêm de pesquisas com os participantes e de projetos construídos no programa.

Antes de ler

Metade aula, metade trabalho real

O programa dura duas semanas e é presencial. Metade do tempo é aprendizado facilitado, com oficinas dadas por colegas da própria empresa. A outra metade é trabalho real: cada pessoa traz uma tarefa, um painel ou uma skill que quer construir. Todo dia termina com demos dos projetos.
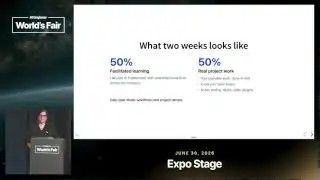
A estrutura do programa: oficina e projeto real em partes iguais01:34

Currículo que vai do básico a agentes autônomos

Os primeiros dias cobrem skills, MCPs, spec-driven development (desenvolvimento guiado por especificação) e uso responsável de IA. Depois vêm a criação de MCPs, os hooks para estender o harness (ambiente que roda o agente) e os agentes autônomos em segundo plano. O fim traz tópicos aplicados ao WordPress.
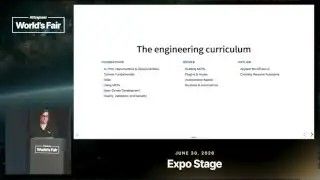
A progressão do currículo, dos fundamentos aos agentes03:38

Servidor MCP interno como base compartilhada

A empresa mantém um servidor MCP próprio, o Context A8C. Ele permite criar rápido conjuntos de ferramentas que não existem prontos e colocar camadas de governança e observabilidade. Os projetos dos participantes estendem esse servidor, e as capacidades se acumulam.
O MCP interno que concentra as ferramentas da empresa05:13
Mais 2 ideias deste talk

Cada egresso multiplica o alcance

Os formados viram guias (um programa de champions), organizam encontros locais de IA e dão ride-alongs, em que mostram como trabalham. Ver alguém com a mesma função usar a ferramenta é mais fácil de absorver do que ouvir conceitos. Um canal de Slack sempre aberto atende quem está começando.
Os quatro canais pelos quais os egressos ensinam outros07:17

Projetos de duas semanas, inclusive de quem não é engenheiro

Os participantes construíram um sistema agêntico de análise para lojas WooCommerce, um conector de Zendesk e um diretório de skills que funciona em várias ferramentas. A ferramenta de suporte guiado, que destaca partes da tela durante uma sessão de ajuda, saiu de uma pessoa de suporte.
Exemplos de projetos criados dentro do programa13:41
leitura crítica

O talk descreve um programa interno e não traz evidência de resultado de negócio. As métricas citadas (intencionalidade, fluxo, compartilhamento, ganho individual) vêm de pesquisas de autoavaliação, sem números, grupo de controle ou ligação com produtividade. Os projetos mostrados são escolhidos a dedo. A meta de 600 pessoas e os custos do programa não aparecem. No fim, a palestrante convida o público ao estande da empresa e fala dos conectores do WordPress, o que dá um tom de divulgação.

O que fazer com isso

  • Reserve tempo protegido para o seu time aprender IA, por exemplo meio dia por semana, em vez de só liberar licenças.
  • Peça que cada pessoa traga uma tarefa real para o treinamento. Aprender sobre trabalho de verdade fixa mais do que exemplos genéricos.
  • Organize uma sessão curta em que alguém da sua área mostre como usa IA no dia a dia, como os ride-alongs da Automattic.
  • Crie um lugar único para guardar e compartilhar skills e prompts úteis, para que o time construa sobre o trabalho dos outros.
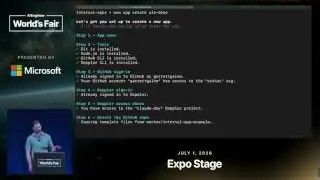
Let Anyone at Your Company Ship Internal Apps with AI

Com IA, construir um app interno ficou barato. O gargalo agora é publicar com segurança, e uma plataforma padrão resolve isso para quem não é engenheiro.

Carreira e equipes 17:13 nível ●●○○○ Garrett Galow, WorkOS Assistir no YouTube (abre em nova aba)

Em 3 frases

Uma executiva de vendas da WorkOS criou um chatbot com Lovable, mas o CEO não conseguiu abrir, e dois engenheiros tiveram que refazer o app para publicá-lo.

A empresa criou o WOW (um CLI instalado em todos os laptops) e o Atlas (a plataforma por baixo, em Cloudflare), que publicam apps com login corporativo, logs e segredos prontos.

Segundo o palestrante, há 278 apps registrados, 3,3 milhões de requisições na última semana e 37% dos cerca de 60 apps em uso regular sem nenhum engenheiro nos commits.

Antes de ler

Mais 1 termo

O gargalo mudou de construir para publicar

O app de vendas funcionava, mas morava numa conta de Lovable que o CEO não tinha. Duas pessoas do time de IA aplicada precisaram refazer, hospedar e manter o app. Com Claude Code e Codex, construir é fácil. Decidir onde rodar, como autenticar e como proteger continua pesado para quem não é engenheiro.

02:19 Construir ficou barato, publicar ainda exigia engenharia

Claude days: não engenheiros no teclado

A empresa faz hackathons de um dia em duplas. Quem não é engenheiro (marketing, vendas) constrói. O engenheiro só orienta e destrava. Isso gerou ideias reais e também o retorno que mostrou o que faltava na plataforma.

Quem tem o problema constrói, o engenheiro faz papel de coach04:52

Um comando cria repositório, template e deploy

O comando wow app create verifica se a máquina tem Git, Node, GitHub e Doppler (gestor de segredos). Depois cria o repositório na conta corporativa, usa um template e faz o deploy. O CLI chega a todos os funcionários por MDM, a ferramenta de gestão de dispositivos da empresa.

Demo ao vivo do app saindo do zero com um único comando06:54
Mais 2 ideias deste talk

Atlas: infra invisível, segura e descobrível

A plataforma segue três princípios. A infraestrutura fica invisível (hoje Cloudflare Workers, trocável). O acesso é seguro por padrão, com SSO da Okta, logs auditáveis e segredos no Doppler. Todo app aparece no catálogo e vive sob workos.tools, então um link no Slack basta.

Cada app já nasce com banco, domínio, login e log12:04

A métrica de sucesso é ausência de engenheiro

O objetivo era permitir que não engenheiros publicassem sozinhos. Entre os cerca de 60 apps mantidos ou usados com regularidade, 37% não têm engenheiro em nenhum commit. O próximo passo é permissão por grupo e papel, mais integrações com dados (Snowflake) e Slack.

O número que o palestrante chama de marcador de sucesso14:41
leitura crítica

O talk é um pitch: o palestrante encerra convidando quem tiver interesse a conversar com a WorkOS sobre a plataforma. Os números vêm da própria empresa, sem metodologia. O 37% vale para cerca de 60 apps, não para os 278, e não diz se commit sem engenheiro significa app sem revisão. Faltam dados sobre incidentes, custo e manutenção. O acesso padrão a todos os funcionários é uma limitação que o próprio talk admite, pois apps com dados de clientes precisam de permissão por grupo, ainda não pronta.

O que fazer com isso

  • Liste os apps internos que alguém da sua empresa criou com IA e identifique quais só funcionam na conta pessoal do autor.
  • Defina um caminho único de publicação (hospedagem, login corporativo e segredos) para que não engenheiros não precisem decidir isso sozinhos.
  • Teste um dia de construção em duplas, com a pessoa do negócio no teclado e um engenheiro como apoio.
  • Mantenha um catálogo central dos apps internos, com dono e data do último deploy.

Your AI Agent Has No Nervous System

Agente de código sem contexto do ambiente age rápido e às cegas; a Dynatrace vende o Bluebox como a camada que entrega esse contexto.

Agentes 15:34 nível ●●○○○ Matt Gibiec, Dynatrace Assistir no YouTube (abre em nova aba)

Em 3 frases

Matt Gibiec, da Dynatrace, diz que agentes de código giram em loop, causam problemas operacionais e de segurança e são difíceis de medir porque só enxergam os dados que recebem.

A solução proposta é dar contexto do ambiente real ao agente, como dependências entre serviços, uso em produção e histórico de mudanças, por meio do Bluebox, produto da própria empresa.

Os cenários mostrados são testar localmente com contexto de produção, detectar problemas cedo, sugerir correções que respeitem o resto do sistema e planejar antes de pedir código, sempre com um humano aprovando.

Antes de ler

Mais 2 termos

Agente rápido, mas sem enxergar

O palestrante cita o CTO da Dynatrace: agentes operam em velocidade, mas sem visão. Se faltam contexto, detalhes ou permissões nas ferramentas, o agente alucina e automatiza processos que não geram valor. A proposta é chamar esse contexto de sistema nervoso do agente.

A tese do talk: agentes são rápidos, mas só tão bons quanto os dados que veem.04:15

Funciona local, quebra em produção

Uma mudança testada no notebook pode derrubar três outros serviços depois do merge. O Bluebox mapeia serviços e dependências de cada agente e carga de trabalho de IA e leva o contexto de produção para o teste local.

O print mostra como o contexto de produção entra no teste local.07:52

Achar o problema antes do usuário

Com dados históricos de carga, a ferramenta aprende o que é normal e avisa o desenvolvedor na IDE quando um serviço fica lento ou passa a dar erros novos. Por estar ligada ao repositório, cruza o problema com a mudança que o causou.

Mostra o alerta no editor associado à mudança de código que causou o desvio.09:24
Mais 2 ideias deste talk

Corrigir sem quebrar o resto

Uma correção pode ser de uma linha, mas afetar outros serviços. Por isso o agente precisa conhecer as dependências ao sugerir os passos de remediação, em vez de resolver só o problema à vista.

A sugestão de correção leva em conta o impacto nos demais serviços.11:29

Planejar antes de pedir, humano decide no fim

Antes de construir, o agente recebe dados reais de uso para entender o que a feature precisa entregar. O ciclo observar, detectar, sugerir correção e decidir termina com uma pessoa aprovando o envio para produção.

O ciclo do Bluebox e o ponto em que o humano mantém o controle.13:33
leitura crítica

O talk é um pitch do Bluebox, produto da Dynatrace, e o palestrante trabalha para a empresa. Não há demonstração ao vivo, métrica, estudo de caso nem cliente citado. As afirmações sobre detectar problemas e sugerir correções seguras aparecem como promessas. O acesso é só por lista de espera. Os problemas descritos (loops, falhas após merge) são reais e conhecidos, mas o vídeo não compara o Bluebox com alternativas.

O que fazer com isso

  • Liste que contexto seu agente de código recebe hoje (dependências, logs, uso real) e o que falta antes de pedir mudanças em serviços ligados a outros.
  • Antes de fazer merge de uma mudança feita por agente, verifique quais outros serviços dependem do código alterado.
  • Defina uma métrica de valor para cada agente em uso na equipe, como o tempo economizado ou a taxa de erros após o merge.
  • Mantenha aprovação humana antes de qualquer correção automática ir para produção.

We Mapped 115 Microservices for Our Coding Agents

Em microsserviços, o agente de código só acerta se enxergar o mapa das APIs, e esse mapa precisa ficar atualizado.

Agentes 17:26 nível ●●●○○ Kamalakannan Nandagopal, Postman Assistir no YouTube (abre em nova aba)

Em 3 frases

A Postman montou um grafo de contexto de API que liga serviços, endpoints, linhas de código e chamadas em produção, e deu esse grafo ao seu agente de código.

Ela mediu o efeito com evals (avaliações) criados a partir de PRs reais, comparando o agente com grafo, o Claude Code com busca simples e o Claude Code com o grafo como skill.

O grafo ganhou em descoberta de API, redesenho e análise de impacto, mas falhou quando ficou desatualizado, e o palestrante trata a atualização como parte central do trabalho.

Antes de ler

Mais 2 termos

APIs formam a camada de contexto de um sistema distribuído

Cada microsserviço cuida de uma responsabilidade e a API define essa responsabilidade. As chamadas entre serviços revelam os fluxos de usuário que cruzam o sistema. Dentro de um único repositório o agente vai bem. Com centenas de repositórios, falta a ele essa visão de conjunto, e docs, skills e memória individual não a suprem.

04:01 A tese central: a API define a responsabilidade de cada serviço.

Todo dado do grafo precisa de lastro em código ou telemetria

O grafo cataloga serviços, endpoints, a linha de código de cada implementação, chamadas entre serviços e o caminho dos dados até bancos e caches. A regra do time é que cada ponto aponte para uma verdade concreta: uma linha de código ou um trace de telemetria de produção. O LLM indexa tudo, mas não inventa relações.

O que entra no grafo e a regra de só aceitar dado verificável.05:22

Evals saem de PRs reais e decisões de design já tomadas

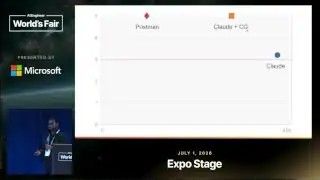
O time pegou PRs reais, registrou a intenção do desenvolvedor e o resultado final, e usou decisões de design documentadas como gabarito. Comparou três configurações: o agente da Postman com o grafo, o Claude Code com busca de código no GitHub e o Claude Code com o grafo como skill. Cada eval recebe nota de 0 a 5, e o gráfico cruza nota com tokens gastos.

Como ler o gráfico: canto superior esquerdo é bom e barato.07:35
Mais 2 ideias deste talk

O ganho maior apareceu em redesenho e análise de impacto

Em descoberta de API, a diferença para o Claude Code foi pequena, mas o grafo superou a busca simples. No redesenho, o agente com grafo identificou os formatos de entrada usados por cada consumidor de uma API, enquanto a busca simples foi mal e o Claude com skill desistiu cedo. Na análise de impacto, a qualidade subiu e o gasto de tokens caiu para cerca de metade ou um terço da busca de código.

Mais qualidade com bem menos tokens que a busca de código.12:08

Grafo desatualizado derruba a nota e a confiança

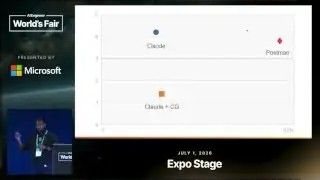
Em um eval de impacto de um PR, o resultado se inverteu: nota baixa e muito consumo de tokens. A causa foi que surgiram novos consumidores entre a escrita do eval e a execução. Para o palestrante, atraso na sincronização gera lacunas, as lacunas fazem o desenvolvedor perder a confiança e ele deixa de usar. Remoções de APIs e dependências também precisam ser detectadas.

A falha com dados defasados: nota baixa e consumo alto de tokens.12:39
leitura crítica

O talk é também uma apresentação de produto: o final cita acesso antecipado e o estande da Postman. Os evals são internos, sem número de casos, sem notas exatas e sem repetições, então não dá para medir a margem dos ganhos. Os gráficos mostram tendências, não valores. O Claude Code serve de comparação, mas a configuração dele não é detalhada. A falha por dados defasados mostra o custo de manutenção, que não aparece quantificado. A cifra de 75% dos PRs vem do top 10 de repositórios, não do total.

O que fazer com isso

  • Liste os serviços e APIs da sua empresa que o agente de código precisa conhecer e veja se existe um mapa atualizado disso, mesmo que seja uma planilha.
  • Monte um eval pequeno com PRs antigos: descreva a tarefa, guarde o resultado real como gabarito e rode seu agente com e sem contexto extra.
  • Meça nota e consumo de tokens juntos. Um contexto que melhora a nota mas dobra o custo muda a conta.
  • Se mantiver documentação ou grafo para agentes, defina como ele se atualiza a cada mudança e como remoções são detectadas.

AI Writes More PRs. Who Validates Them?

Se a IA gera mais PRs, a validação também precisa de agente, com confiança liberada em degraus até o merge automático.

Engenharia de software 11:34 nível ●●○○○ Ali-Reza Adl-Tabatabai, Sonar Assistir no YouTube (abre em nova aba)

Em 3 frases

O palestrante diz que a IA gera mais PRs e PRs maiores, e isso transforma CI e code review em gargalo: ou o time desacelera, ou aprova sem olhar.

A proposta é um agente de validação que revisa o PR, explica falhas de CI, corrige até ficar verde e aprova e faz merge conforme regras definidas pelo time.

O produto, Gitar (agora parte da Sonar), usa harness próprio, proxy de LLMs e análise de programa no SonarQube, mas o talk não apresenta dados medidos.

Antes de ler

Mais 2 termos

A IA move o custo para a validação

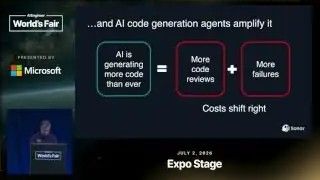
Com IA, o time gera mais PRs (pull requests, propostas de mudança no código) e PRs maiores, todos com chance de defeito. O custo se desloca para a revisão e para a produção. As duas saídas do palestrante são desacelerar, revisando tudo com cuidado, ou carimbar sem ler e arriscar incidentes.

Mostra o dilema entre desacelerar e aprovar sem ler.02:57

Agente de validação em quatro funções

O agente revisa o PR com poucos comentários de ruído, resume a causa de falhas de CI e identifica testes flaky (instáveis). Também corrige problemas em loop até o PR ficar verde e, por fim, aprova e faz merge segundo regras que o time configura.

Resume as funções do agente da criação do PR ao merge.03:51

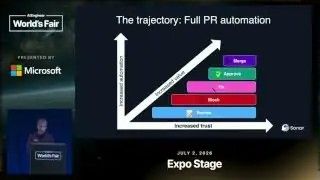
Confiança em degraus até a automação total

Segundo o palestrante, os usuários começam só lendo as revisões. Depois deixam o agente bloquear PRs, ligam o autofix e, por último, definem regras de aprovação e merge automáticos. Cada degrau libera mais automação conforme a confiança na precisão cresce.

Mostra a ordem em que times liberam autonomia ao agente.05:55
Mais 2 ideias deste talk

Insights para plataforma e liderança

Como o agente processa todo PR, ele categoriza as principais falhas de CI (testes instáveis ou problemas de infraestrutura) e o tipo de trabalho entregue (feature, correção, chore, refactor). O primeiro dado serve ao time de plataforma, o segundo à liderança.

Exemplifica os painéis para plataforma e liderança.06:57

Por baixo: control plane, harness e proxy de LLM

A arquitetura tem um control plane que orquestra os fluxos de PR, um harness próprio para execução multiagente, contexto, memória e tool calling, e um proxy de LLM que roteia entre modelos e faz failover. Na Sonar, o agente se combina com análise de programa como taint e data flow.

Mostra os três componentes internos do produto.07:59
analogia

Análise de programa (análise estática do código (taint, fluxo de controle e de dados)). Análise de programa é como um inspetor que confere a planta de um prédio e segue cada cano e cada fio no papel para achar vazamentos antes de alguém morar lá.

  1. Uma ferramenta lê o código sem rodar o programa e procura erros e falhas de segurança, como um revisor que lê um contrato antes da assinatura.
  2. Para isso, ela monta um mapa do programa. O mapa mostra quais partes chamam quais e por quais caminhos a execução pode seguir. Esse é o fluxo de controle (control flow).
  3. A análise de fluxo de dados (data flow) segue cada dado nesse mapa. A análise de contaminação (taint analysis) marca dados de fora, como o texto do usuário, e avisa se chegam ao banco de dados sem checagem.
  4. A análise de composição de software (software composition analysis) confere as bibliotecas de terceiros usadas no projeto e aponta versões com falhas conhecidas.
  5. No talk, a Sonar quer somar essas regras fixas do SonarQube ao agente de IA. A ideia é que as regras deem precisão e o agente dê cobertura e correção. O palestrante não mostra números que comprovem o ganho.
CÓDIGO DO PRLido sem executar o programa
MAPA DE CAMINHOSFluxo de controle entre as partes
RASTREIO DE DADOSTaint e fluxo de dados
AGENTE AVALIAFiltra alertas e propõe correção
ALERTA PRECISOFalha apontada com o caminho

Ajuda saber antes: Pull request, CI (integração contínua), Análise estática de código, Vulnerabilidade de segurança

leitura crítica

O talk é pitch de produto do Gitar/Sonar, feito por cofundador recém-adquirido. Não mostra números de precisão, taxa de falsos positivos, economia ou bugs que passaram. Os resultados no minuto 574 são qualitativos. A tendência de usuários rumo à automação total é uma observação sem amostra informada. A afirmação de resultado garantido a preço fixo por PR não tem detalhes. Aprovar e fazer merge sem humano exige evidência que o talk não traz.

O que fazer com isso

  • Meça em seu time quanto tempo PRs gerados por IA esperam por revisão e quantas falhas de CI vêm de testes flaky, antes de comprar qualquer ferramenta.
  • Adote a escada de confiança: comece com o agente só comentando PRs e compare os achados com a revisão humana por algumas semanas.
  • Só libere auto-merge para PRs de baixo risco, com regras escritas (tamanho, área do código, testes passando) e possibilidade de reverter.
  • Peça a qualquer fornecedor de revisão por IA dados de precisão e de falsos positivos em repositórios parecidos com o seu.

Why 80% Reliability Isn't Good Enough

Eval estático deixa você torcendo. Eval que nasce do sinal do cliente e muda toda semana é o que gera confiança.

Evals 17:44 nível ●●○○○ Felipe Blanes, Amazon AGI Lab Assistir no YouTube (abre em nova aba)

Em 3 frases

Felipe Blanes, do Amazon AGI Lab, conta que benchmarks públicos e dados sintéticos não previram o que os clientes do Nova Act (serviço da Amazon para criar agentes de navegador) fizeram em produção.

Ele propõe um ciclo de quatro passos: definir sucesso como o cliente define, capturar sinais (inclusive conversando com clientes), diagnosticar lacunas em modelo, engenharia e produto, e levar isso para decisões.

Das lições do trabalho com clientes, a confiança aparece só em torno de 90% de confiabilidade, falar dos limites do produto ajuda mais que nota alta, e casos de uso inesperados guiam as próximas funcionalidades.

Antes de ler

Mais 1 termo

A ilusão do benchmark

Times otimizam o produto para benchmarks públicos e dados sintéticos. Em produção, o cliente tenta tudo o que ninguém previu e quebra o produto. Com eval estático, depois do lançamento só resta torcer para que o teste refletisse o uso real.

Com eval estático, depois do envio só sobra esperança.03:36

O flywheel de evals em quatro passos

O ciclo repete sem parar: definir sucesso pela visão do cliente, capturar sinais (métricas e conversas), diagnosticar lacunas e alimentar decisões. As lacunas se separam em modelo (viram evals), engenharia (bugs no harness) e produto (posicionamento).

04:41 O flywheel: definir sucesso, capturar sinais, diagnosticar, decidir.

Quatro fases da jornada do cliente

O cliente evolui com o produto: descoberta de caso de uso, adotantes iniciais que mostram o que é possível, escala com o caso de uso principal e lacunas de produto para o futuro. Os evals precisam acompanhar a complexidade crescente de cada fase.

Cada fase da jornada pede sinais e evals diferentes.07:46
Mais 2 ideias deste talk

O penhasco da confiança

Com 80% de confiabilidade, o cliente ainda precisa monitorar o agente e refazer à mão o que falha, então dá mais trabalho. Perto de 90%, ele passa a entregar o fluxo inteiro ao agente. Na visão do palestrante, confiança funciona quase como tudo ou nada.

Abaixo de cerca de 90%, o cliente sente que ganhou trabalho extra.09:53

Transparência sobre limites vale mais que nota alta

Ele recomenda dizer ao cliente o que funciona, o que está em melhoria e o que está fora de escopo. A parte difícil é a última. Segundo ele, admitir limitações aumenta a confiança mais que um benchmark melhor.

Três coisas a declarar ao cliente, inclusive o que o produto não faz.11:29
leitura crítica

O talk também funciona como divulgação do Nova Act. Os números de confiabilidade (80% e cerca de 90%) aparecem sem método, sem amostra de clientes e sem dados. A descrição do vídeo cita 92%, mas na fala ele diz 'around 90%'. A afirmação de que transparência vale mais que benchmark vem da experiência dele, sem comparação. Os casos da Amazon Leo, Hertz e Sola são anedotas sem métricas de resultado. O ciclo é sensato, mas o talk não mostra como pesar sinais conflitantes entre clientes.

O que fazer com isso

  • Separe os casos de teste do seu agente em dois grupos: inventados por você e tirados de uso real. Passe a alimentar o segundo grupo toda semana.
  • Marque conversas curtas com 2 ou 3 usuários do seu fluxo com IA e registre o que eles tentaram fazer, antes de olhar as métricas.
  • Ao entregar uma automação a um colega ou cliente, escreva o que ela faz bem, o que está em melhoria e o que não deve ser usado nela.
  • Meça a taxa de acerto real do seu agente em tarefas do dia a dia e pergunte se o usuário ainda precisa vigiá-lo. Se precisa, a taxa ainda é baixa.

Why We Deleted Our MCP Server and Rebuilt It

Software para agentes depende de quem paga quando o agente erra. Poucas ferramentas com estrutura e incerteza visível deixam o humano julgar.

Agentes 16:39 nível ●●●○○ Abhi Arya, Reducto Assistir no YouTube (abre em nova aba)

Em 3 frases

A Reducto criou um servidor MCP com uma ferramenta por endpoint da API. Funcionou no demo, mas quebrou no dia em que o time inteiro usou, porque o agente montava fluxos completos com confiança e ninguém sabia explicá-los.

A correção foi apagar o arquivo e recriar com menos ferramentas, que embutem a estrutura do trabalho real, mais uma ferramenta de snapshot do estado e sinais de confiança que fazem o agente perguntar em vez de chutar.

Com logs de cada sessão alimentando a orientação do MCP, o sistema melhorou sozinho e o time de vendas passou a usá-lo sem ser pedido, inclusive em reuniões com clientes importantes.

Antes de ler

Mais 2 termos

Três jeitos de responder quem paga pelo erro

O palestrante separa três abordagens. No auto mode, o agente tem autonomia total e o usuário paga pelos erros que não vê. No user-first, o usuário tem todos os controles e o agente quase não faz nada, como um chatbot. A terceira, que ele defende, dá ao agente capacidades delimitadas e deixa o humano verificar o trabalho.

As três abordagens e quem arca com o erro em cada uma.02:38

Uma ferramenta por endpoint quebra em produção

O primeiro MCP deu uma ferramenta a cada endpoint da API, em um único arquivo grande. O demo curado funcionou. Quando o time todo usou, o agente recebia descrições vagas de uma call ou de uma página do Notion, montava o fluxo inteiro e afirmava que estava tudo certo. Nem usuário nem agente sabiam explicar o que o fluxo fazia.

O ponto em que o MCP v1 falhou ao sair do demo para o uso real.05:27

Menos ferramentas, com a estrutura do trabalho dentro

Ele apagou o arquivo em um commit. No lugar, criou ferramentas que entendem o produto, como uma única classify-to-extract que liga o classificador ao nó de extração. Após cada passo o agente recebe orientação sobre o próximo, e algumas ferramentas se encadeiam sozinhas. O agente deixa de improvisar o que a equipe já sabe ser verdade.

06:44 Uma ferramenta composta substitui várias chamadas soltas.

Mais 2 ideias deste talk

Snapshot do estado e incerteza visível

Como agentes não guardam estado, uma chamada de snapshot devolve o estado vivo do pipeline e os erros com códigos específicos. Em runtime, o extract entrega confidence scores e bounding boxes, e o agente pergunta ao usuário quando há duas leituras possíveis. Nos evals, a equipe passou a reprovar suposições frágeis.

A saída que torna a incerteza do agente legível para o humano.09:51

Instrumentação que vira ciclo de melhoria

Cada sessão do MCP foi registrada, e o time de vendas exportou suas sessões do Claude Code. Os logs mostram onde o humano corrigiu o agente, onde a confiança caiu e onde ele perguntou. Esses dados voltam para a orientação do MCP, e o sistema melhora a cada pipeline construído, sem reescrita manual.

O ciclo que transforma uso em melhoria da orientação do agente.13:07
leitura crítica

O talk também é divulgação da Reducto, com vaga aberta e estande no final. Não há medição de erros antes e depois, nem de satisfação com valores. A evidência é uma anedota: o time de vendas adotou a ferramenta, com reações no Slack como prova. A amostra é um único time interno, e o autor desenhou o sistema que avalia. A linha que atribui o erro a arquitetura e não a prompt é opinião sem comparação.

O que fazer com isso

  • Antes de expor uma API a um agente, liste os fluxos reais de trabalho e crie ferramentas por fluxo, em vez de uma por endpoint.
  • Faça o agente perguntar quando houver duas leituras possíveis, e inclua nos seus evals um caso que reprove suposição sem confirmação.
  • Exiba confiança e justificativa junto de cada resultado do agente, para que quem usa consiga revisar o que foi feito e por quê.
  • Registre as sessões de uso do agente e revise onde humanos corrigiram, para alimentar a orientação do sistema.

Brains vs Hands: How to Run AI Agents Safely in Production

Em produção, o LLM planeja o que fazer e um harness determinístico e durável executa. Cérebro e mãos ficam separados.

Agentes 16:49 nível ●●●○○ Viren Baraiya Assistir no YouTube (abre em nova aba)

Em 3 frases

Viren Baraiya (Orkes, criador do Netflix Conductor) diz que agentes em produção parecem aplicações completas, com tarefas agendadas, eventos, coordenadores e execuções de meses.

A regra central é que o LLM só planeja o próximo passo, enquanto o harness (a estrutura de código ao redor do agente) executa de forma determinística, com aprovação humana, passos idempotentes e efeitos colaterais registrados.

Na demo, um agente de SRE gera um plano que vira um workflow do Conductor, roda, é verificado e replanejado em dois ciclos, e o segundo ciclo pula o rollback já feito.

Antes de ler

Mais 2 termos

O agente vira aplicação

Agentes não são só chatbots. Há agentes em segundo plano, agendados, orientados a eventos, coordenadores de longa duração e sistemas multiagente. Como nos microservices, cada agente tem uma responsabilidade, e o conjunto precisa de um harness que os controle e os conecte a bancos, humanos e ferramentas (APIs ou MCP).

O harness é a aplicação, e o agente é só uma das peças.04:41

Partes determinísticas e não determinísticas

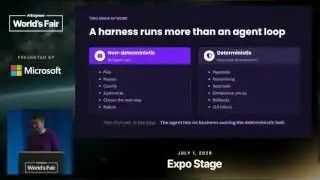
O LLM entrega o raciocínio, que é não determinístico. Pagamentos e reinício de cluster Kubernetes pedem uma sequência de passos fixa, que roda igual toda vez. O harness garante esse determinismo onde ele importa. Como roda por segundos ou meses, também precisa de durabilidade para se recuperar de falhas.

Raciocínio fica com o LLM, e passos críticos ficam com código fixo.05:11

Cérebro planeja, mãos executam

O palestrante pede que o público leve só um slide. O agente decide o que deve acontecer. O harness decide como fazer, pede aprovação humana (por exemplo, uma mensagem no Slack antes de reiniciar um cluster de produção) e registra efeitos colaterais quando o passo não é idempotente.

Divisão de responsabilidades entre o LLM (cérebro) e o harness (mãos).08:16
Mais 2 ideias deste talk

Sagas de ligação tardia

Um harness agêntico é uma saga (fluxo de passos com controle de falhas) cujo desenho nasce em tempo de execução. O conjunto de ferramentas é finito e determinístico, mas o agente monta a combinação. Com N ferramentas, ele cobre combinações que ninguém desenharia à mão, e mantém visibilidade e controle de um workflow tradicional.

O agente propõe o workflow, e o motor de workflow o executa.10:49

Demo: agente de SRE em dois ciclos

O LLM devolve uma sequência de passos: coletar evidências, analisar logs, reverter o deploy e verificar a recuperação. Uma ferramenta de plan and compile transforma o plano em workflow do Conductor, que é executado. No segundo ciclo, o agente vê que o rollback já foi feito e só checa os serviços dependentes.

O plano do LLM vira workflow determinístico e roda em dois ciclos.13:24
analogia

Saga de ligação tardia (late-bound saga: workflow montado em runtime). Uma saga de ligação tardia é como um cozinheiro com uma despensa fixa de ingredientes que decide a receita na hora, olhando o pedido do cliente, e anota cada etapa num caderno para poder parar e recomeçar sem errar.

  1. Uma saga (saga) é uma lista de passos que um sistema segue em ordem, com um plano para o caso de algum passo falhar no meio do caminho.
  2. Na saga tradicional, uma pessoa escreve todos os passos antes, no código. O fluxo roda sempre igual e é fácil de acompanhar, mas só cobre os caminhos que alguém previu.
  3. Na saga de ligação tardia (late-bound saga), o conjunto de ferramentas continua fixo e conhecido, mas a ordem e a combinação dos passos nascem em tempo de execução (runtime). Quem monta o plano é o agente de IA, olhando a situação do momento.
  4. O plano do agente vira um workflow de verdade, executado por um motor de orquestração como o Conductor. Assim você mantém visibilidade, controle e recuperação de falhas, e pode deixar o agente planejar um passo por vez ou vários de uma só vez.
  5. Com N ferramentas, o agente cobre combinações que ninguém conseguiria desenhar à mão como galhos de um fluxo. O agente decide o que fazer, e o motor de workflow garante como cada passo roda.
FERRAMENTAS FIXASConjunto finito e conhecido de ações
AGENTE PLANEJALLM escolhe e ordena os passos
PLANO VIRA WORKFLOWMotor compila o plano em fluxo
EXECUÇÃO CONTROLADAPassos rodam com registro e retomada
RESULTADO VISÍVELFluxo sob medida, rastreável

Ajuda saber antes: Agent harness, Orquestração, Sistema determinístico, Durable execution

leitura crítica

O talk é também divulgação do Conductor e da edição enterprise da Orkes, com QR code e convite ao estande no fim. A demo é uma execução gravada e pré-planejada, como o próprio palestrante admite (cerca de 773 s). Não há dado de falhas evitadas, custo, latência nem comparação com outras ferramentas de durable execution. A afirmação de que agentes em produção já são comuns se apoia só em mãos levantadas na plateia.

O que fazer com isso

  • Separe nos seus fluxos o que o LLM decide (diagnóstico, próximo passo) do que precisa rodar igual toda vez (pagamento, reinício, envio de e-mail) e passe a segunda parte para código fixo.
  • Coloque um portão de aprovação humana antes de qualquer ação destrutiva em produção, em um canal como o Slack, sem depender do modelo para decidir se pede.
  • Registre cada efeito colateral do agente (e-mail enviado, deploy revertido) para que o replanejamento não repita a ação.
  • Se o agente roda por horas ou dias, avalie um motor de workflow com execução durável, como Conductor ou Temporal, em vez de um loop em memória.

Giving AI Agents Memory That Learns

Log guardado não ensina nada ao agente. Só vira memória quando uma lição entra no contexto que ele lê na próxima execução.

Agentes 16:38 nível ●●●○○ Jake Broekhuizen, LangChain Assistir no YouTube (abre em nova aba)

Em 3 frases

Jake Broekhuizen, da LangChain, diz que times observam bem seus agentes, mas quase não transformam esses registros em lições para as próximas execuções.

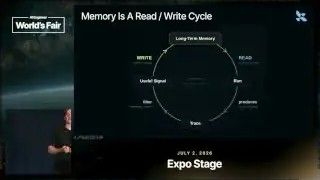
Ele propõe um ciclo de leitura e escrita: o agente lê a memória de longo prazo, roda e gera um trace (registro da execução), um filtro separa o sinal útil do resto, e o sinal é gravado de volta.

Três cuidados: a maior parte dos traces deve virar só histórico, atualizações de memória precisam chegar ao agente (cache), e regras de comportamento merecem revisão humana.

Antes de ler

Mais 2 termos

Observar não é aprender

O exemplo é um agente financeiro cujo tom escorregava de consultivo para diretivo, dizendo ao usuário que cancelasse assinaturas. A correção era manual: alguém lia os traces, editava o contexto e checava regressões. Isso escala mal. Se o contexto futuro não muda, o erro de hoje se repete amanhã.

01:34 O caso que guia o talk: tom fora da política e correção manual.

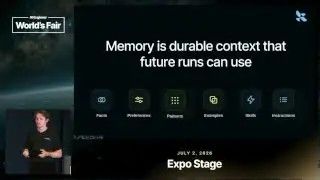
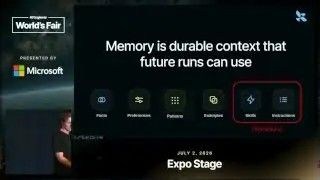
Três tipos de memória

O palestrante agrupa seis itens (fatos, preferências, padrões, exemplos, skills, instruções) em três tipos. Semântica é o que o agente sabe. Episódica é o que ele viveu. Procedural é como ele deve se comportar. No caso financeiro, a correção veio como regra procedural, não como fato novo.

A taxonomia de memória emprestada da ciência cognitiva.04:41

Memória de trabalho e de longo prazo

Memória de trabalho é o que o agente usa na execução atual: rascunhos, resultados de ferramentas, arquivos. Memória de longo prazo fica em um repositório e guia execuções futuras. Cada harness (estrutura que roda o agente) injeta essa memória de um jeito: no prompt, por ferramenta, por arquivos ou por um store.

A separação entre contexto temporário e contexto durável.06:15
Mais 2 ideias deste talk

O ciclo de leitura e escrita

O agente lê contexto do longo prazo, roda e produz um trace. Um filtro decide o que é sinal e o que fica como histórico. O sinal é gravado de volta. Sem o filtro, tudo viraria memória e o agente teria mais dificuldade de raciocinar nas tarefas seguintes.

O laço central: memória informa a execução, a execução gera evidência.08:18

Capturar, analisar, atualizar com LangSmith e Context Hub

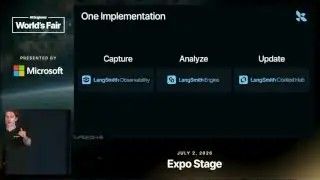
Como uma implementação possível, o observability do LangSmith captura a trajetória, uma etapa de análise extrai sinal dos traces e o Context Hub guarda instruções, skills e políticas que o agente baixa na próxima execução. No caso financeiro, o sistema detectou o desvio de tom e ajustou os arquivos markdown de skills.

A mesma ideia do ciclo, agora com produtos concretos da LangChain.10:52
analogia

Sleep-time compute (processamento de memória fora da execução ativa). Sleep-time compute é como o professor que corrige as provas e prepara a próxima aula à noite, para chegar à sala no dia seguinte já com tudo organizado.

  1. Um agente de IA trabalha em rodadas. Entre uma rodada e outra, ele fica parado esperando a próxima tarefa.
  2. Sleep-time compute (processamento em tempo de sono) aproveita esse intervalo para trabalhar na memória do agente. Alguns chamam isso de dreaming (sonhar).
  3. Nesse intervalo, um processo lê o trace (registro da execução) das rodadas anteriores e separa o que vale guardar do que fica só como histórico.
  4. As lições escolhidas entram na memória de longo prazo, como regras, skills (habilidades em arquivo) ou preferências do usuário.
  5. Na rodada seguinte, o agente carrega essa memória já organizada. Assim ele não gasta tempo da tarefa ativa para rever o passado e evita repetir erros.
AGENTE RODAExecuta a tarefa e gera um trace
AGENTE PARADOIntervalo sem tarefa ativa
REVISA OS TRACESSepara sinal útil de histórico
GRAVA NA MEMÓRIALições vão para o longo prazo
PRÓXIMA RODADA MELHORAgente já lê a memória atualizada

Ajuda saber antes: Memória de curto e longo prazo, Trace, Read-write cycle

leitura crítica

O talk é em parte pitch do LangSmith e do Context Hub, produtos da empresa do palestrante, e ele admite que é só uma implementação possível. Não há medição: sem taxa de erro de tom antes e depois, sem número de traces analisados, sem comparação com a revisão manual. O caso financeiro vem de um único cliente sem nome. O critério do filtro, que o próprio palestrante chama de ponto central, fica em aberto.

O que fazer com isso

  • Separe os traces do seu agente em três grupos: histórico, dados para eval (avaliação) e candidatos a memória. Só o último grupo muda o contexto.
  • Se corrigir o comportamento do agente à mão, grave a correção como regra ou skill em um arquivo que ele leia na próxima execução, em vez de repetir no prompt.
  • Exija revisão humana antes de aplicar mudanças automáticas em instruções, políticas e tom do agente.
  • Teste se uma atualização de memória realmente chega ao agente, principalmente em execuções longas com cache.

Turning Agent Memory Into Skills That Work

Recuperar texto parecido não basta. Memória de agente precisa virar grafo tipado e rastreável, e dele sair skills verificáveis.

Agentes 18:41 nível ●●●○○ Will Lyon, Neo4j Assistir no YouTube (abre em nova aba)

Em 3 frases

Will Lyon, da Neo4j, diz que memória de agente baseada só em embeddings e busca recupera trechos, mas não gera conhecimento acionável. Ele propõe um grafo de contexto com memória de curto prazo, de longo prazo e de raciocínio.

Desse grafo, a Neo4j destila skills (pacotes de instruções reutilizáveis) como grafos de execução tipados, com checagem de grounding (base nos dados), cobertura e coerência, e alerta quando a skill fica desatualizada.

Ele mostra o Neo4j Agent Memory Service (NAMS) gerando uma skill de admissão de paciente a partir de conversas de saúde. O talk é também uma apresentação do produto da empresa.

Antes de ler

Mais 2 termos

Recuperar não é saber agir

Sistemas de memória comuns guardam embeddings e injetam os trechos mais parecidos no contexto. Falta uma representação canônica das coisas: o mesmo médico aparece com três nomes e o agente não sabe que é a mesma pessoa. Lyon defende conhecimento conectado, tipado e rastreável.

O mesmo médico citado de três formas mostra a falta de uma representação canônica.01:20

Três memórias em um grafo de contexto

A Neo4j modela memória de curto prazo (mensagens), de longo prazo (entidades extraídas e ligadas por relações tipadas) e de raciocínio. Uma ontologia compartilhada e a resolução de entidades garantem que cada coisa tenha uma identidade única no grafo.

O desenho mostra mensagens virando entidades e relações em um grafo com tipos.02:20

Decision traces e memória compartilhada

Cada decisão do agente fica ligada à evidência, às políticas, ao plano, às chamadas de ferramenta, aos resultados, aos tokens gastos e ao tempo. Com isso, centenas ou milhares de agentes que usam as mesmas ferramentas aprendem com as execuções uns dos outros.
Cada decisão do agente aparece ligada ao que a justificou e ao que ela produziu.04:30
Mais 2 ideias deste talk

APE: skills como grafos de execução

Skills em prosa têm o mesmo problema da memória: ambiguidade e pouca depuração. A pesquisa da Neo4j propõe o APE, uma extensão do padrão de agent skills em que os passos são nós, descritos por um esquema rígido. Segundo o palestrante, o benchmark mostrou aumento relevante de tarefas concluídas, sem dar o valor.

A figura do paper mostra uma skill dividida em passos executáveis com esquema.08:40

Destilar skills com grounding, cobertura e coerência

O pipeline parte de um escopo (entidade, conversa ou classe da ontologia) e usa LLM só para sintetizar afirmações e textos. Grounding e cobertura checam se os passos vêm dos dados. Coerência, com detecção de comunidades no grafo, sugere dividir a skill quando ela mistura tópicos. Se os dados mudam, a skill é marcada como desatualizada.
Cada passo da skill aponta para as chamadas de ferramenta e entidades que o originaram.16:59
leitura crítica

O talk é pitch do NAMS e das ferramentas da Neo4j, empresa de banco de dados em grafo, então o grafo aparece como solução natural. O resultado do benchmark do APE vem de pesquisa da própria Neo4j e é citado sem número, só como aumento relevante. A demo mostra uma skill de saúde já pronta e não compara com skills escritas à mão ou com RAG simples. Não há dados de custo, latência nem taxa de erro da destilação.

O que fazer com isso

  • Liste as entidades que seu agente cita com nomes diferentes (clientes, produtos, pessoas) e defina um identificador único para cada uma antes de pensar em memória mais sofisticada.
  • Registre em log, para cada decisão do agente, a evidência, as ferramentas chamadas, os resultados e o custo em tokens. Esse histórico serve de base para depurar e para criar skills.
  • Ao pedir que um agente escreva uma skill, exija que cada passo cite a execução ou o dado de origem, e revise a skill quando esses dados mudarem.
  • Teste o NAMS gratuito com um fluxo pequeno do seu trabalho e compare a skill gerada com uma escrita por você.

Fim da edição

Termos novos no glossário: Análise de programa, Saga de ligação tardia, Sleep-time compute.