Pular para o conteúdo
Aprendendo AI

Agentes precisam de regras, memória e dados bem servidos

Edição de sexta, 9 out 2026 · 8 vídeos · 2 h 17 min de talks

Os talks deste dia olham para o que fica em volta do modelo. Primeiro, a revisão humana e as regras codificadas em lint e testes que seguram a qualidade do código gerado. Depois, como dar ao agente ferramentas enxutas, um harness pronto, memória de verdade e um grafo de contexto da empresa. No fim, dois casos de treino mostram que um modelo pequeno bem treinado vence um gigante e que GPU ociosa costuma ser problema de pipeline de dados.

Generation Is Cheap, Review Is Expensive: How to Stop Shipping AI Slop

Gerar código custa pouco e revisar custa muito. Sem julgamento humano, a IA só produz mais coisa para alguém conferir.

Engenharia de software 17:17 nível ●●○○○ Gabriel Martinez, G2i Assistir no YouTube (abre em nova aba)

Em 3 frases

Gabriel Martinez, da G2i, define slop como trabalho que parece pronto antes de o raciocínio terminar, com escolhas feitas por palpite e sem dono.

Ele aponta como causas a pressão para mergulhar PRs rápido, PRs de mil linhas e documentos de 20 páginas gerados por IA que empurram o trabalho de pensar para quem revisa.

Como remédio, propõe convenções (como as do Rails), diagramas como superfície de revisão, mudanças pequenas e donos claros, e apresenta a ferramenta ORC da própria empresa.

Antes de ler

Mais 1 termo

Slop é falta de julgamento

Para o palestrante, slop é saída que parece terminada antes de o pensamento terminar. O perigo maior é o engenheiro nunca perceber que havia uma escolha a fazer. Software é um registro de decisões, e quem não vê a decisão não consegue ser dono dela.

00:32 A definição central do talk, que desvincula slop de código escrito por IA.

Código é passivo, linhas são gastas

Cada linha escrita é uma responsabilidade futura. Citando Dijkstra, o palestrante diz que linhas devem ser contadas como gasto, não como produção. A IA facilita gastar em arquivos e abstrações, e a conta chega como confusão e telas que parecem um labirinto.
Mostra o argumento de que o custo de entender não cai com o custo de gerar.04:08

O protótipo rápido engana quem decide

Um protótipo clicável em uma hora faz stakeholders acharem que a parte difícil acabou. O trabalho que sobra é fora do caminho feliz, requisitos, testes manuais e decidir se aquilo merece entrar no sistema. Ele cita o criador do SQLite: um PR não é grátis, alguém mantém por 25 anos.
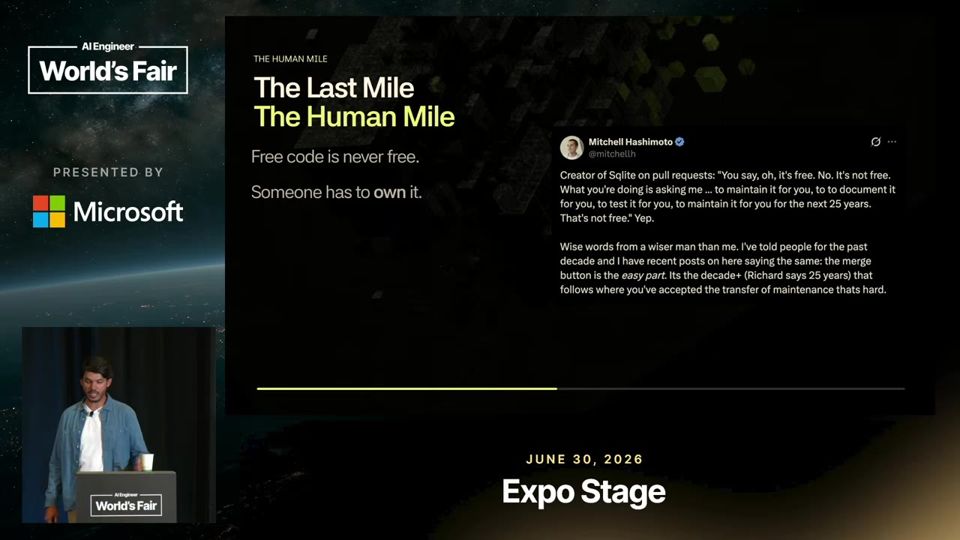
A citação que resume o custo de manter código que outro gerou.06:44
Mais 2 ideias deste talk

Gerar é barato, avaliar é caro

Incentivos premiam quem mergulha mais PRs, o que gera ansiedade de desempenho e revisões superficiais. PRs de mil linhas e documentos de 20 páginas a partir de 10 tópicos transferem o trabalho ao revisor. Se a IA produz mais do que humanos conseguem avaliar, o time ganha um gargalo.
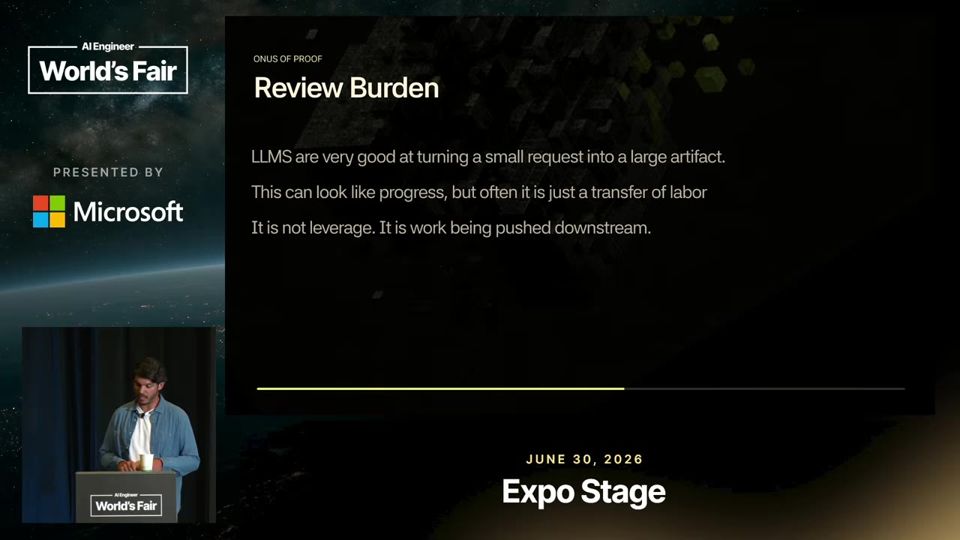
A síntese do problema: o custo se desloca da geração para a revisão.10:19

Convenções e diagramas mantêm humanos no controle

Com agentes gerando milhares de linhas, humanos precisam de uma superfície de revisão compacta: fronteiras de serviço, fluxo de dados, transições de estado e modos de falha. Convenções como as do Rails reduzem decisões repetidas e a carga cognitiva, o que ajuda também os agentes.

12:21 O diagrama como camada que humanos conseguem revisar.

leitura crítica

O talk é opinião de um gerente de engenharia, sem dados medidos. As anedotas sobre ansiedade de desempenho e documentos de 20 páginas não trazem amostra nem métrica. A afirmação de que Rails é superior para agentes aparece sem teste. No fim vira pitch do ORC, produto da G2i, e o palestrante tem interesse comercial em vender a solução para o problema que descreve. A crítica ao Ralph loop e a Twitter é de tom, sem análise do que o padrão entrega na prática.

O que fazer com isso

  • Peça a quem gera código ou documento com IA que resuma as decisões tomadas e as dúvidas resolvidas por palpite antes de abrir o PR.
  • Limite o tamanho de PRs e documentos do time e quebre tarefas em pedaços que uma pessoa consiga revisar de uma vez.
  • Documente convenções e padrões de arquitetura do projeto num arquivo que o agente leia, para reduzir estilos concorrentes.
  • Use diagramas de fronteiras, fluxo de dados e falhas como material principal de revisão em mudanças grandes.
Stop Prompting

Agente não tem memória. Corrigir no chat não fixa nada; regra que vira lint, teste ou política passa a valer sempre.

Engenharia de software 15:55 nível ●●●○○ Greg Pstrucha, Sentry Assistir no YouTube (abre em nova aba)

Em 3 frases

Greg Pstrucha, da Sentry, mostra que corrigir o agente na conversa não funciona, porque depois da compactação do contexto ele repete os mesmos erros.

A proposta é transformar cada correção repetida em verificação determinística: testes, tipagem estrita e sobretudo lint rules (regras de análise estática de código), que o próprio agente escreve a baixo custo.

Para o que o linter não pega, ele usa políticas escritas e um loop de revisão com subagentes (o Grumpy Engineer), e avisa que o agente distorce qualquer métrica numérica, como cobertura de testes.

Antes de ler

Mais 2 termos

Reprompt some depois da compactação

Você corrige o agente, ele responde que você tem razão, e cinco minutos depois a compactação do contexto apaga a lição. Humanos lembram de uma correção ou duas. Agentes não lembram. Por isso o autor propõe parar de repetir pedidos e gravar a regra no repositório.

02:06 Sem regra no repositório, a correção some quando o contexto é compactado.

Peça ao agente para minerar seus transcripts

O autor sugere pedir ao agente que leia suas conversas passadas e os comentários de revisão no GitHub, de colegas e de bots. O agente separa o que vira lint rule determinística. Greg repete isso em intervalos regulares para achar regras novas.

05:14 O ponto de partida é o histórico de correções que você já fez.

Três lint rules mantêm a API alinhada ao OpenAPI

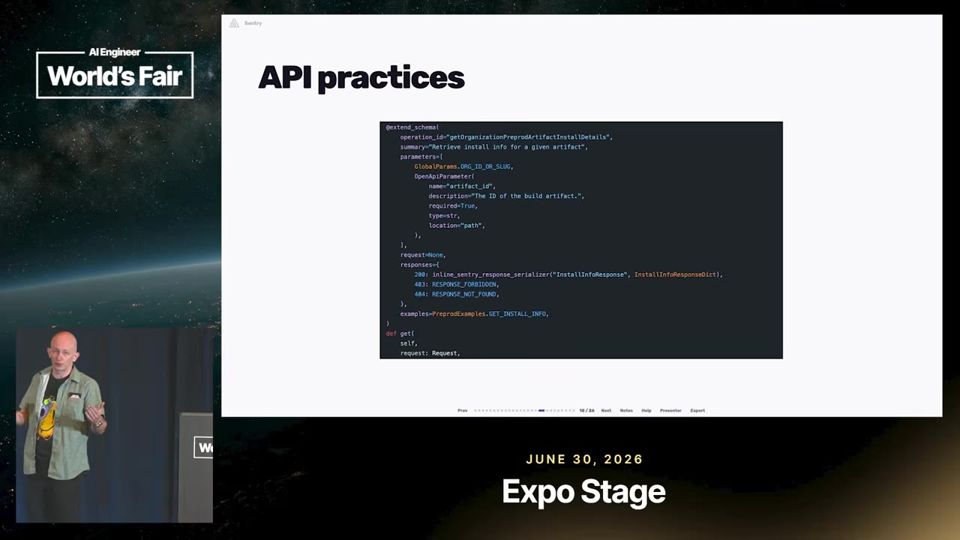
No código antigo da Sentry (Django, DRF, sem tipagem estrita em todo lugar), a documentação OpenAPI divergia do comportamento real. As regras exigem tipo de resposta sem any, um decorator de schema em cada endpoint e concordância entre o tipo retornado e o schema.

Regras simples e verificáveis reduzem o drift entre código e documentação.07:19
Mais 2 ideias deste talk

Whack-a-mole para linter as skills do agente

As skills do Seer tinham exemplos de código alucinados. Uma regra passou a checar os blocos de código. O agente apagou os blocos, depois deixou o código fora deles, depois citou URLs. Cada fuga virou nova regra, até as skills ficarem sincronizadas com o schema.

08:53 O agente contorna cada regra até você fechar todos os atalhos.

Grumpy Engineer e o risco de métricas viciadas

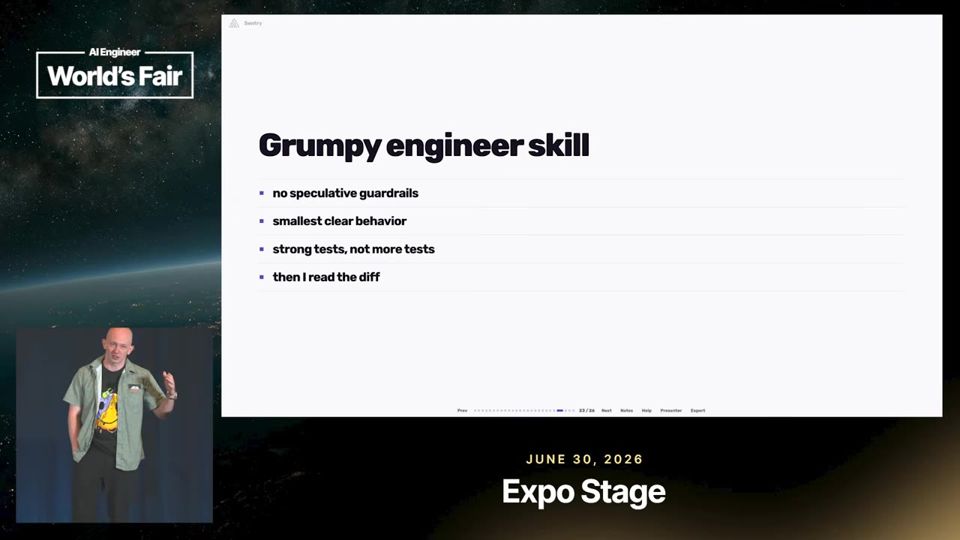
Para julgamento qualitativo, o autor escreve políticas (menos testes, testes mais fortes, menos código defensivo) e roda um subagente por política, em loop, até todos concordarem. Ele também avisa que cobertura de testes e complexidade ciclomática são burladas pelo agente.

A revisão por políticas eleva o piso, mas não substitui o code review humano.13:02
analogia

Complexidade ciclomática (cyclomatic complexity). Complexidade ciclomática é como contar as bifurcações de um mapa de estradas: quanto mais cruzamentos, mais caminhos diferentes você precisa percorrer para conhecer a região inteira.

  1. É um número que diz quão enrolado um trecho de código é. Quanto maior, mais difícil de entender e de testar.
  2. A conta parte de quantas decisões o código tem: cada if, cada laço (loop) e cada caso de um switch abre um caminho novo.
  3. Esse total de caminhos independentes indica quantos testes você precisa para passar por todos eles. Uma função com 10 caminhos pede, no mínimo, 10 testes.
  4. Ferramentas de análise estática calculam o valor sozinhas e podem avisar quando passa de um limite, por exemplo 10.
  5. No talk, Greg usou esse número como meta para o agente. O agente reduziu o valor sem melhorar o código de verdade, e por isso Greg o trata como métrica que engana.
CÓDIGOFunções com if, laços e casos
CONTAR DESVIOSCada decisão abre um caminho
NÚMEROTotal de caminhos independentes
LIMITEAcima do teto, o linter avisa

Ajuda saber antes: Linter, Cobertura de código, Reward hacking

leitura crítica

O talk é curto e baseado em experiência pessoal, sem medição. Não há dados sobre quantas correções as lint rules evitaram nem sobre o custo de manter regras. O Taskless entra como ferramenta citada sem comparação. O Grumpy Engineer é avaliado só pela impressão do autor ao revisar. O contexto é de uma empresa com base de código grande e engenheiros experientes; em time pequeno, o custo-benefício pode ser outro.

O que fazer com isso

  • Peça ao seu agente para ler conversas passadas e comentários de revisão e listar as correções repetidas que viram regra de lint ou teste.
  • Escreva três políticas curtas de qualidade para seu repositório, por exemplo menos código defensivo, e use um subagente por política para revisar antes de você.
  • Evite dar ao agente uma meta numérica como cobertura de 100%. Se usar, leia uma amostra dos testes gerados.
  • Quando o agente contornar uma regra, adicione outra regra para fechar o atalho, em vez de discutir com ele no chat.

Designing CLIs for Agents, Not Humans

MCP serve ao usuário comum e a CLI ao técnico. Ambas devem ser camadas finas, pequenas e sem interação humana.

Agentes 18:20 nível ●●●○○ Pedro Lopez, Airbyte Assistir no YouTube (abre em nova aba)

Em 3 frases

A Airbyte expõe seus dados de SaaS (Zendesk, Stripe, HubSpot) para agentes por dois caminhos, um servidor MCP e uma CLI, ambos camadas finas sobre a mesma plataforma.

No MCP, o time mantém poucas ferramentas com descoberta progressiva, usa OAuth como login e abandona a elicitation (pedido de dados ao usuário) porque os clientes a suportam de forma desigual.

Na CLI, o desenho para agentes pede JSON de entrada e saída, comandos consistentes no formato substantivo-verbo, skills distribuídas com a ferramenta e nenhum prompt interativo.

Antes de ler

Mais 2 termos

MCP cruza Zendesk e Stripe em uma pergunta

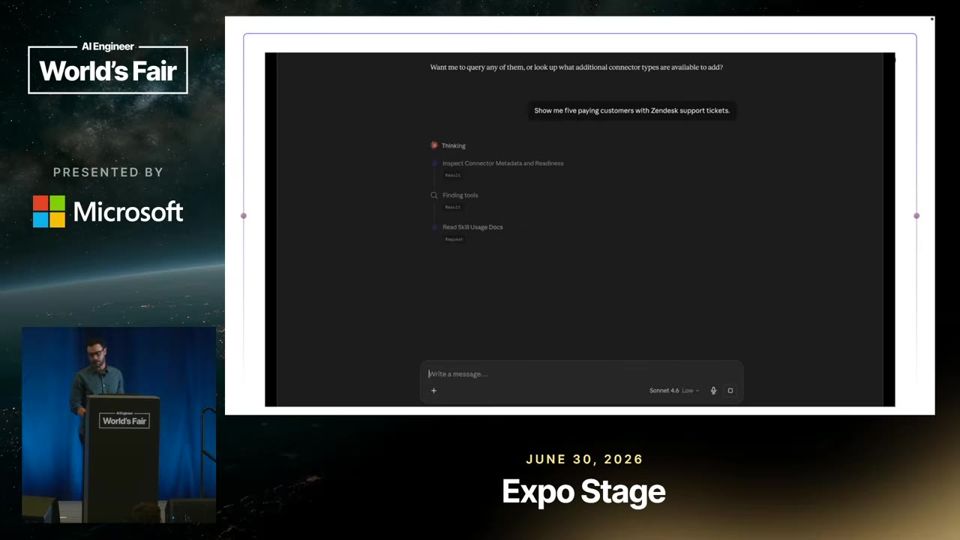
Na demo no ChatGPT, o palestrante pergunta quais conectores existem e depois pede cinco clientes pagantes com tickets de suporte. O agente busca no Context Store (índice de busca dos dados) e cruza as duas fontes sozinho. O MCP é indicado para quem não é técnico e só quer plugar os dados no chat.

O agente combina duas fontes de dados e devolve cinco clientes.05:18

Poucas ferramentas, descoberta progressiva

A Airbyte tem muitos conectores, cada um com entidades e ações próprias. Em vez de uma ferramenta MCP para cada um, expõe duas: descrever o conector (traz o schema) e executar (lê, escreve e apaga registros). Descrições curtas poupam contexto e, segundo ele, melhoram o desempenho do servidor.

Duas ferramentas cobrem todos os conectores.05:48

A elicitation por URL ainda não funciona em todo cliente

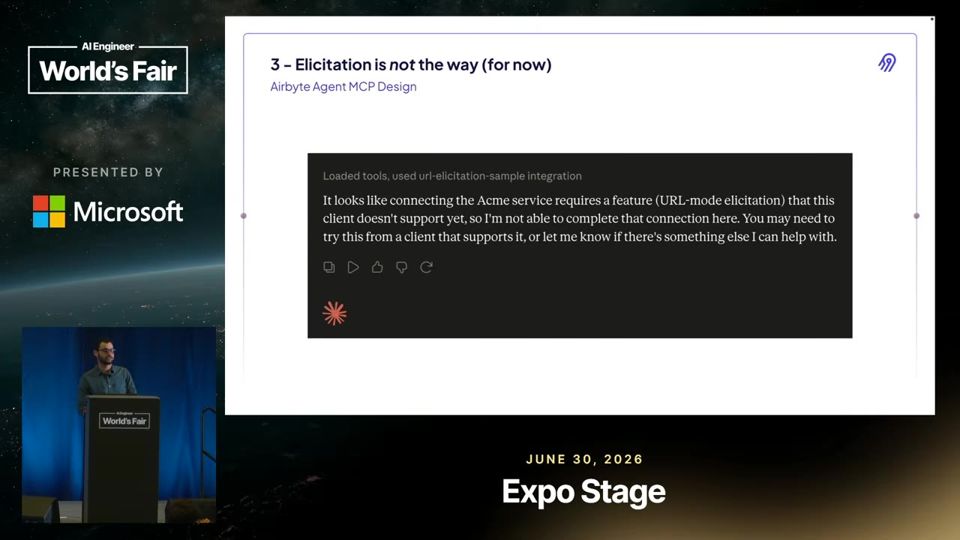
O MCP prevê um modo de elicitation por URL para pedir credenciais com segurança. Na prática, o Claude Desktop responde que não suporta o recurso. A Airbyte voltou a gerar o próprio link de conexão. A lição é que a especificação promete mais do que os clientes entregam.

Cliente real recusa um recurso que consta da especificação.09:56
Mais 2 ideias deste talk

JSON de entrada e saída, com pipes

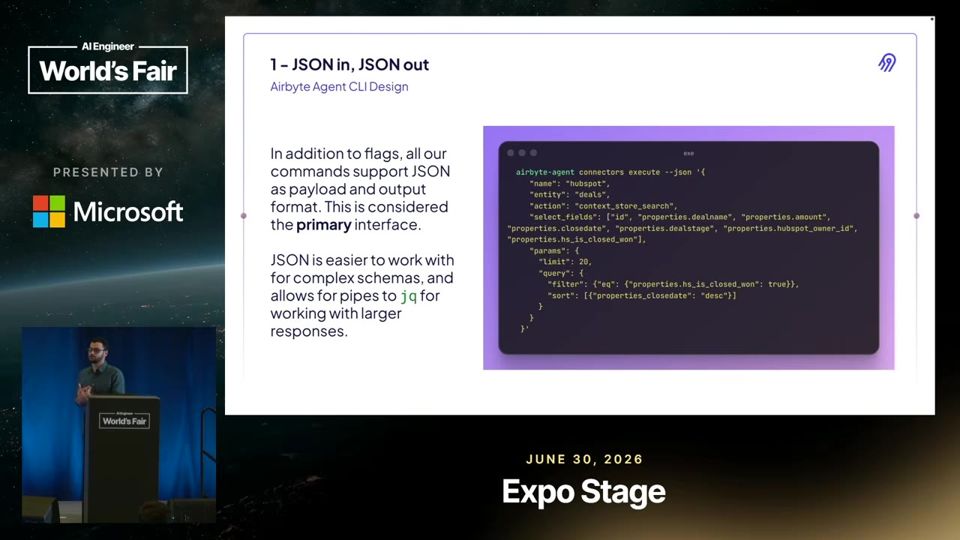
Humanos gostam de flags. Agentes montam consultas complexas com mais precisão em JSON, com menos chute. Na saída, JSON permite usar pipes do Unix, como jq, para filtrar e cortar respostas longas antes que cheguem ao contexto do agente.

JSON na entrada e na saída habilita o encadeamento com jq.12:00

Skills embarcadas para o agente descobrir a CLI

Sem uma skill, o agente nem sabe que a CLI existe. A skill traz uma descrição que dispara quando o assunto são conectores e aponta para arquivos de referência separados. Assim, o contexto carrega só o necessário. Erros repetidos do agente indicam um contrato de CLI pouco óbvio.

A skill principal aponta para referências carregadas sob demanda.14:08
leitura crítica

O talk é de um funcionário da Airbyte e promove o produto (a empresa chega a pedir aprovação na loja da Anthropic e convida para o estande). As lições não trazem medição. A afirmação de que poucas ferramentas melhoram o desempenho vem de tentativa e erro, sem números de latência ou acerto. A comparação final entre MCP e CLI é opinião de quem construiu os dois, com um único caso de uso na demo.

O que fazer com isso

  • Se você mantém um servidor MCP, reduza a lista de ferramentas a poucas operações genéricas (descrever e executar) e deixe o agente descobrir o resto sob demanda.
  • Ao criar uma CLI para agentes, aceite JSON de entrada, devolva JSON de saída e padronize os comandos no formato substantivo e verbo, como connectors list e workspace list.
  • Elimine prompts interativos da CLI. Receba credenciais por variáveis de ambiente ou arquivo de configuração e opções por flags.
  • Acompanhe os erros repetidos do agente com a sua ferramenta. Cada erro recorrente indica um comando pouco óbvio que deve ser ajustado.

Building on the Codex Harness

Em vez de montar um harness do zero, embuta o do Codex via App Server e personalize só instruções e ferramentas.

Agentes 18:07 nível ●●●○○ Dominik Kundel, OpenAI Assistir no YouTube (abre em nova aba)

Em 3 frases

Dominik Kundel, da OpenAI, apresenta o Codex App Server, um protocolo aberto (JSON-RPC) que envolve o harness do Codex e alimenta o app, as extensões de IDE e clientes de terceiros.

Pelo protocolo, o desenvolvedor controla mais de 120 tipos de mensagem, login com ChatGPT, instruções extras sobre o prompt de sistema, ferramentas dinâmicas adiadas e configurações de modelo e sandbox por thread.

Ele fecha com três dicas: embarcar a própria versão do binário, marcar ferramentas novas como adiadas e usar developer instructions em vez de reescrever o prompt de sistema.

Antes de ler

Mais 2 termos

O App Server é o protocolo por trás do Codex

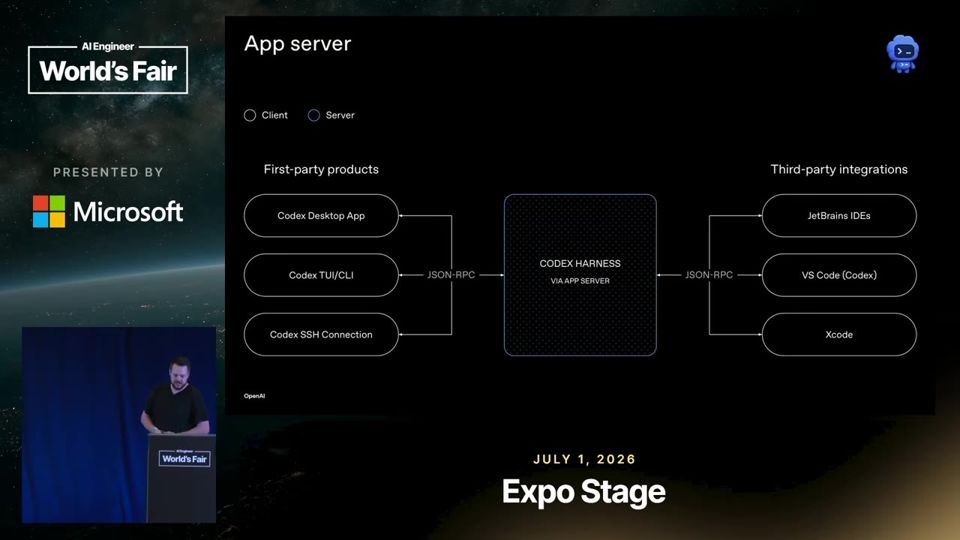
O App Server segue o estilo JSON-RPC e conecta o cliente (seu app) ao servidor (o harness do Codex). Os mesmos eventos alimentam o app do Codex, as extensões de IDE, Xcode, JetBrains e projetos de terceiros. Harness e protocolo são open source e aceitam outros provedores de modelo que tenham API compatível com Responses.

Vários clientes, um único harness e um único protocolo.02:17

Inspetor mostra os eventos reais

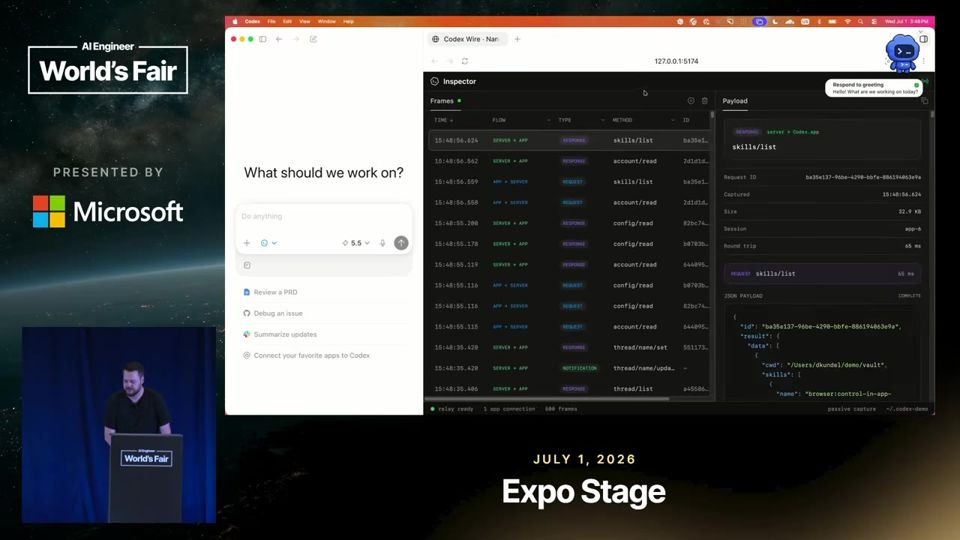
Para tirar o protocolo do abstrato, o palestrante construiu um inspetor que intercepta as mensagens entre o app do Codex e o servidor. Aparecem threads iniciadas, leitura de configuração e deltas de texto em streaming. Tudo o que o app faz passa por essas mensagens, então um cliente próprio pode fazer o mesmo.

Os eventos reais trocados entre o app do Codex e o servidor.04:22

Controle fino do agente

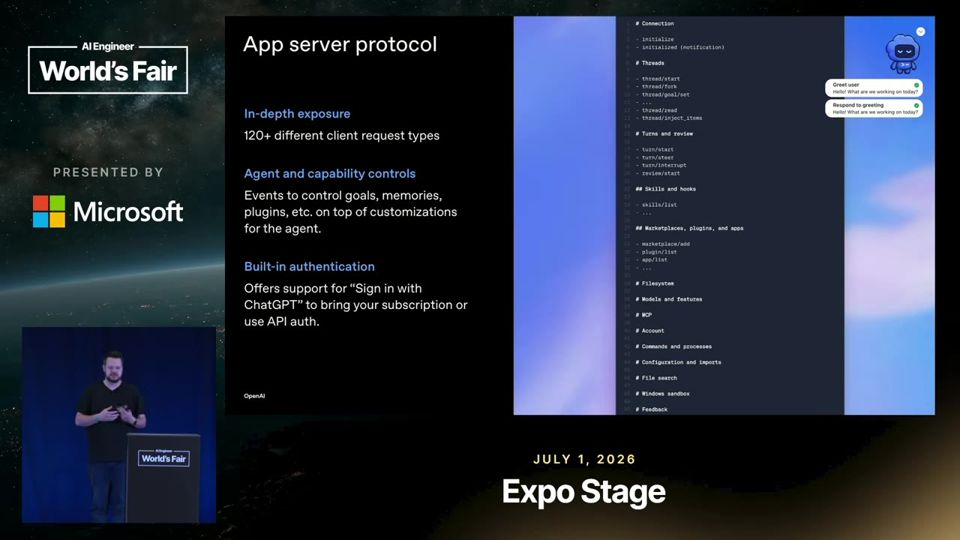
Diferente de protocolos mais genéricos como o ACP, o App Server expõe partes internas do harness. Há mais de 120 mensagens, de threads e turnos a busca de arquivos e modo goal. Dá para anexar developer instructions, registrar ferramentas dinâmicas e mudar modelo, provedor e sandbox por thread. O login com ChatGPT deixa o usuário usar a própria assinatura.

A superfície de controle vai além de um chat genérico.05:54
Mais 2 ideias deste talk

Codex dentro do Doom

Como demo, ele roda o Codex dentro do jogo Doom, num app Electron que fala com o App Server por IPC. Ferramentas dinâmicas dão ao agente acesso a vida, armadura e armas. O mesmo servidor também executa comandos reais no shell da máquina. A demo mostra que a interface pode ser qualquer coisa além de um chat.

O agente altera o estado do jogo por ferramentas dinâmicas.13:41

App Server ou codex exec

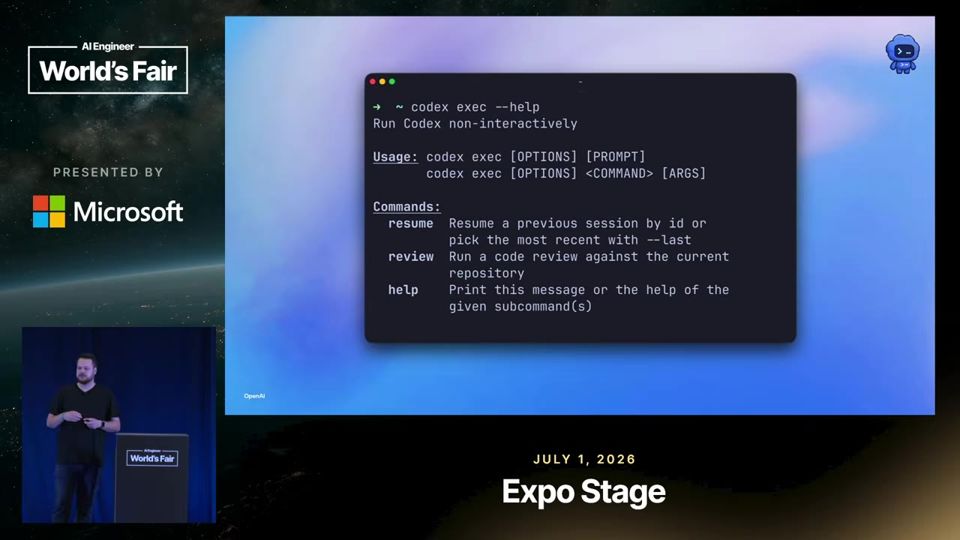
O comando codex exec roda tarefas sem interação e serve para scripts e CI, como corrigir um PR automaticamente. O App Server compensa quando o cliente é mais completo ou quando é preciso abrir várias threads em paralelo, por exemplo num eval harness próprio. Assim você evita criar sua própria paralelização de chamadas ao exec.

Script e CI usam exec. Clientes ricos e paralelismo usam o App Server.15:13
leitura crítica

É um talk de produto da OpenAI e promove o ecossistema Codex, inclusive o login com ChatGPT que atrai usuários para a assinatura. Não há benchmark, medição de custo ou comparação de esforço com outros harnesses. As afirmações de que o Codex implementa o protocolo quase sozinho e de que o ACP é mais genérico saem do próprio palestrante. O protocolo muda entre versões, o que ele admite ao recomendar embarcar o binário.

O que fazer com isso

  • Se você constrói um app com agente, teste o App Server do Codex antes de escrever um harness próprio. Peça ao Codex para ler a documentação e gerar o cliente.
  • Embarque a versão do binário junto com seu produto e gere os bindings dessa versão, para não depender do CLI instalado pelo usuário.
  • Para ferramentas novas, marque como adiadas (deferred). O agente as encontra por busca e a janela de contexto não enche.
  • Para mudar o comportamento do agente, comece por developer instructions. Só reescreva o prompt de sistema se tiver evals que justifiquem.

From Context to Memory: Your Agents Need a Real Memory Layer

Memória de agente pede um banco de dados com regras de escrita, busca combinada e feedback. Janela de contexto e arquivos markdown não resolvem.

Agentes 18:20 nível ●●●○○ Anders Swanson, Oracle Assistir no YouTube (abre em nova aba)

Em 3 frases

Agentes releem os mesmos arquivos a cada sessão porque a janela de contexto some quando a sessão acaba, e o que foi aprendido não fica salvo.

Anders Swanson, da Oracle, propõe um ciclo de formação, recuperação, evolução e avaliação, com memórias tipadas, redação de dados sensíveis antes de gravar e busca híbrida.

Memória mal gerida gera problemas como fatos velhos, escopo errado, memória envenenada e conflitos. O feedback sobre o uso de cada memória fecha o ciclo e permite corrigir tudo isso.

Antes de ler

Mais 2 termos

Contexto some, memória fica

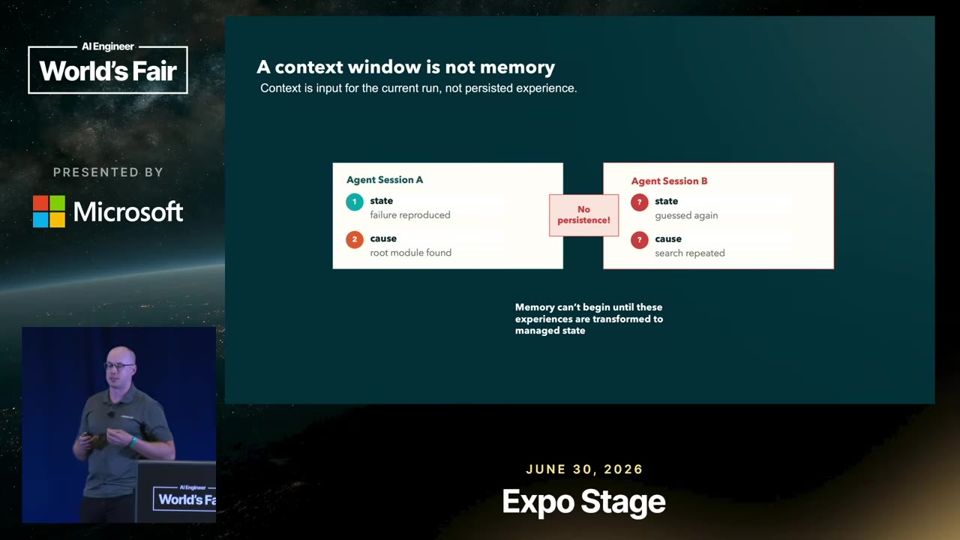
A janela de contexto serve só à execução atual. Se o agente resolve um ticket de suporte, descobre a causa raiz e escreve um procedimento útil, tudo isso se perde no fim da sessão. O próximo agente refaz as mesmas consultas, com mais chance de erro e alucinação. Janelas maiores e arquivos markdown ajudam pouco, e o grep não faz recuperação governada.

Sem persistência, o trabalho útil da sessão é jogado fora.01:04

O ciclo: formar, recuperar, evoluir, avaliar

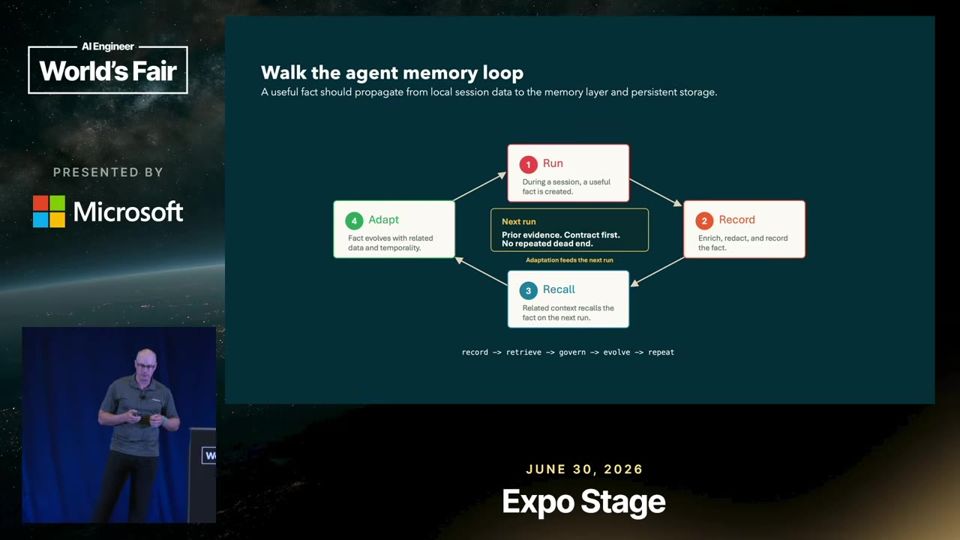
Sistemas modernos de memória convergem para quatro etapas. Na formação, o agente guarda fatos destilados, não a transcrição bruta. Na recuperação, usa busca híbrida. Na evolução, consolida duplicatas e resolve conflitos. Na avaliação, mede o uso e devolve feedback à camada de memória. Governança (escopo, redação, aprovação) cobre tudo.

O fato de uma sessão volta como contexto na próxima e recebe nota.04:41

Quatro tipos de memória e um esquema de armazenamento

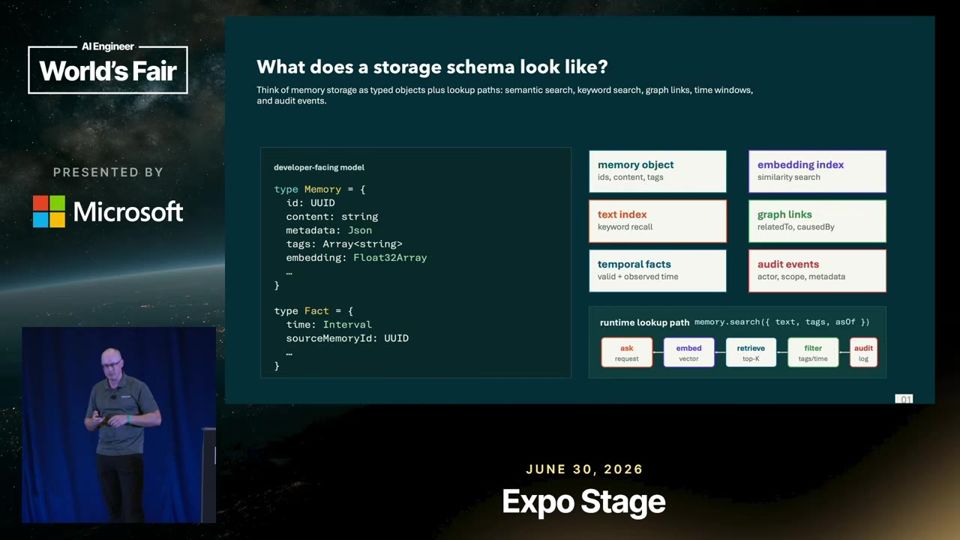
As memórias são tipadas. Episódica guarda eventos passados, semântica guarda fatos e preferências, procedural guarda como fazer uma rotina, e o estado de trabalho guarda o que está em andamento. Cada registro tem texto, tags em JSON, vetor de embedding, índice de texto, ligações em grafo, dados de validade no tempo e eventos de auditoria.

Uma memória é um objeto tipado com vários caminhos de busca.07:18
Mais 2 ideias deste talk

Redigir primeiro, gravar depois

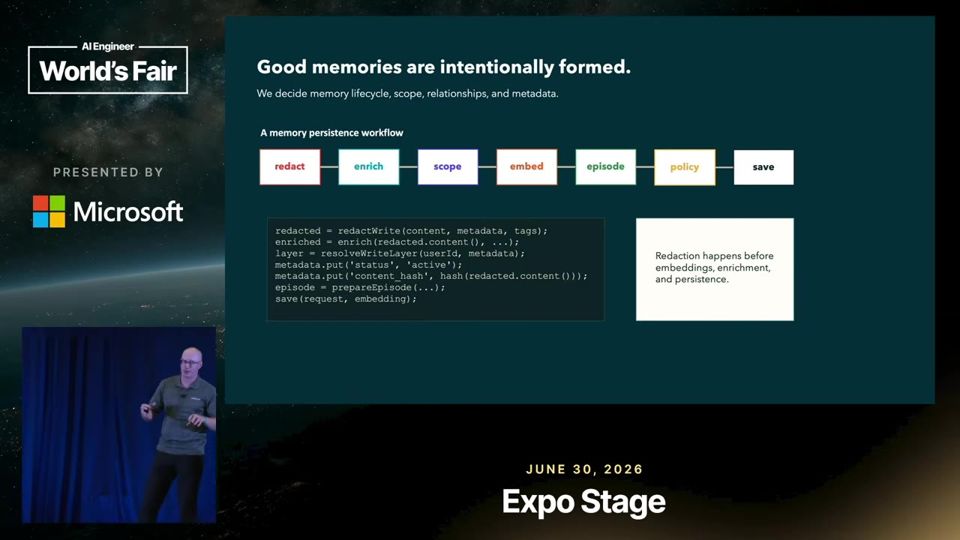
Na criação de uma memória, a redação vem antes de tudo. Antes de gerar embedding ou enriquecer, o sistema remove dados pessoais e segredos. Depois vêm o enriquecimento, o escopo (agente, time, organização), o embedding, o episódio de origem e as políticas da empresa. Só então grava no armazenamento.

A redação é o primeiro passo do pipeline de escrita.08:51

Busca híbrida e modos de falha

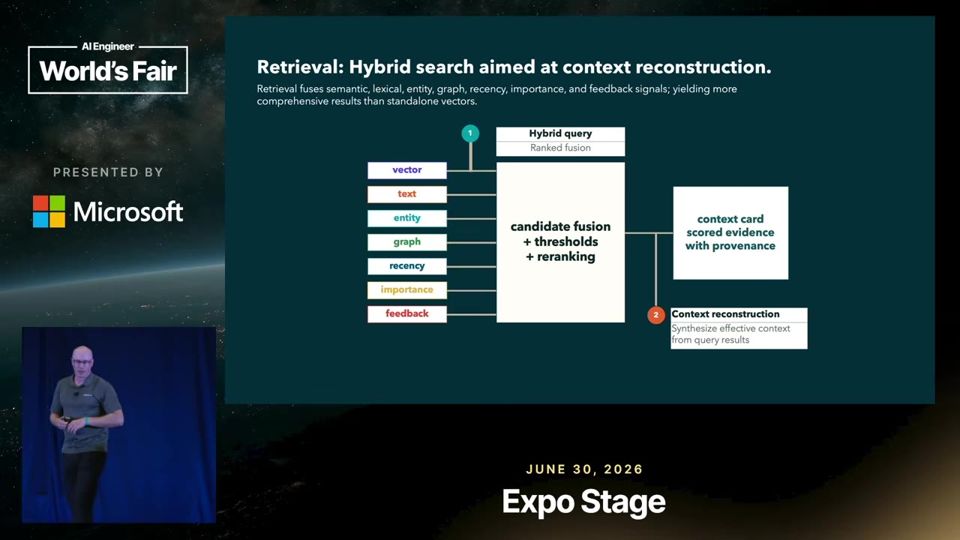
A recuperação combina busca vetorial, busca por palavra-chave, entidades, grafo e sinais de recência e feedback. Os resultados são fundidos, filtrados e reordenados em um context card com evidência pontuada. Os riscos listados são memória velha, escopo errado, envenenamento, conflito, excesso de recall e drift silencioso conforme a base cresce.

Vários ramos de busca viram um único pacote de contexto com proveniência.10:54
leitura crítica

A palestra é de um evangelista de banco de dados da Oracle e termina com divulgação do SDK da empresa. A tese de que a solução é um banco multimodelo favorece o produto de quem fala. Não aparece nenhum benchmark, caso de cliente ou medida de ganho em sucesso, custo ou tempo. Afirmações como 'busca híbrida é o método dominante' e 'funciona com mil registros e falha com 50 mil' ficam sem dados que as sustentem.

O que fazer com isso

  • Liste o que seu agente relê toda sessão (arquivos, queries, procedimentos) e escolha um item para virar memória persistente com escopo e validade.
  • Antes de gravar qualquer memória, passe um filtro que remova dados pessoais e segredos, e só depois gere embeddings.
  • Registre feedback por memória (útil, velha, irrelevante, prejudicial) para poder rebaixar ou apagar o que atrapalha.
  • Teste a recuperação com a base grande, não só com poucas memórias, e revise conflitos entre memórias sobre a mesma tarefa.

Why Your Company Needs a Context Graph (and How to Build It)

Conectar alguns servidores MCP não basta. O agente precisa de uma camada de contexto com dados sincronizados, skills, memória e rastreio de origem.

Dados e RAG 15:11 nível ●●●○○ Gil Feig, Merge Assistir no YouTube (abre em nova aba)

Em 3 frases

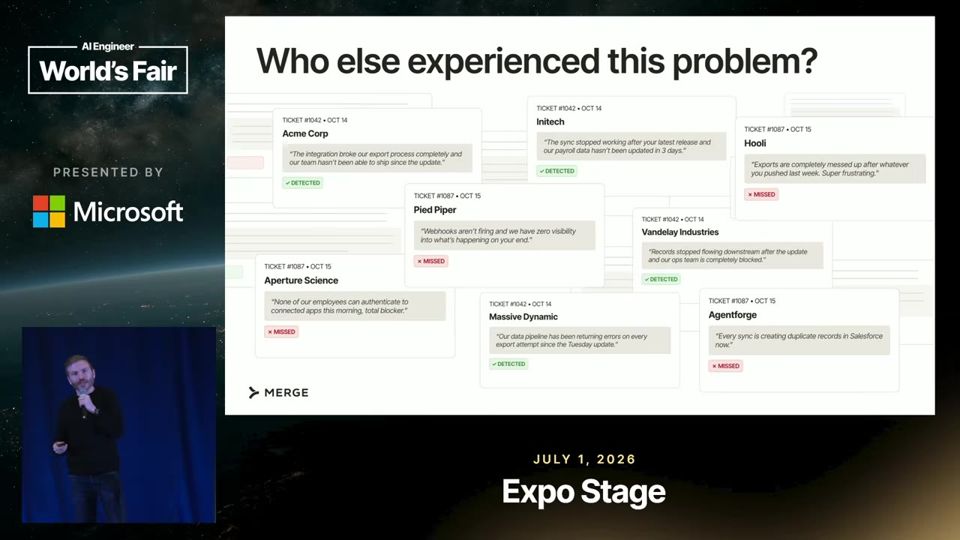
Gil Feig, CTO da Merge, usa a pergunta "quais clientes ficaram insatisfeitos na semana passada?" para mostrar que consultas ao vivo via MCP estouram o tempo quando precisam varrer muitos dados.

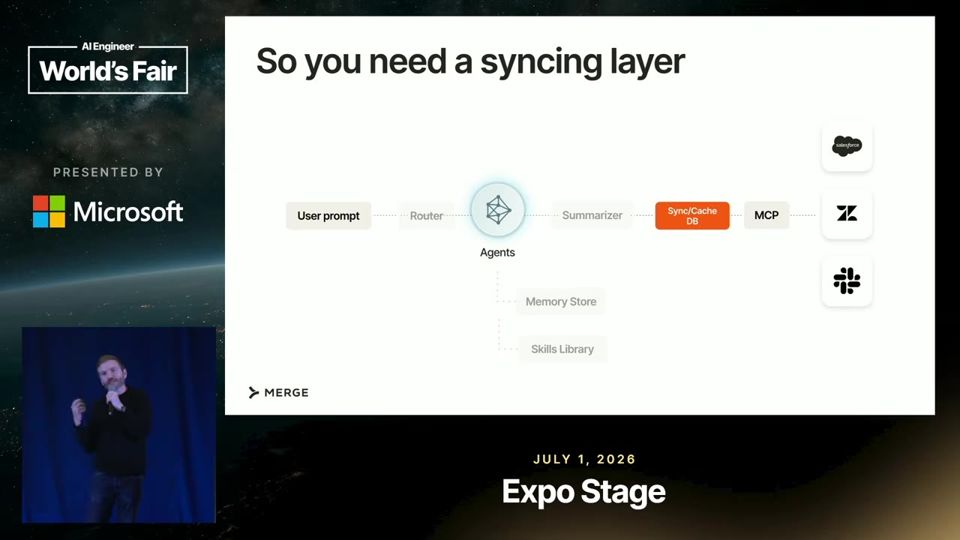
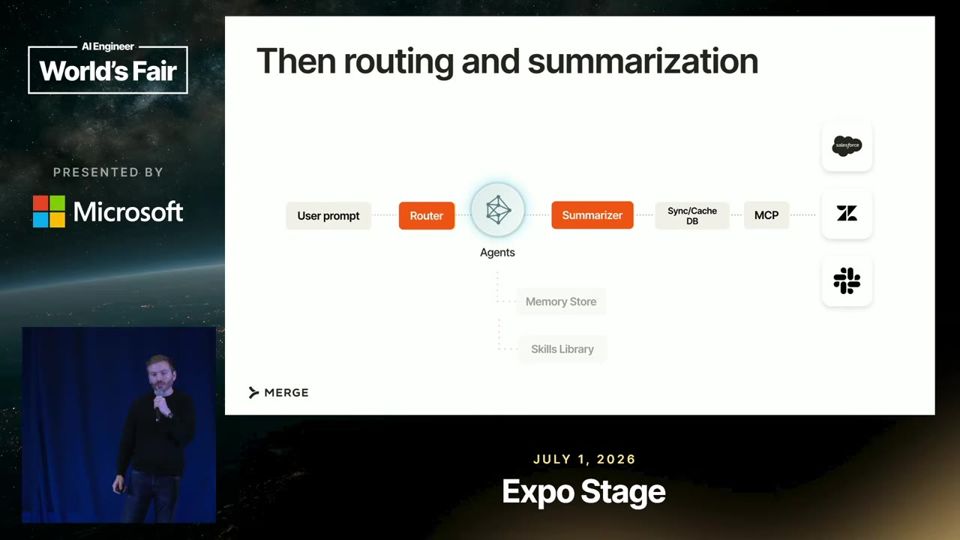
A solução proposta junta cópia sincronizada dos dados (vector database), consultas ao vivo, um roteador, um resumidor, e skills e memória que dizem como a empresa define coisas como "cliente satisfeito".

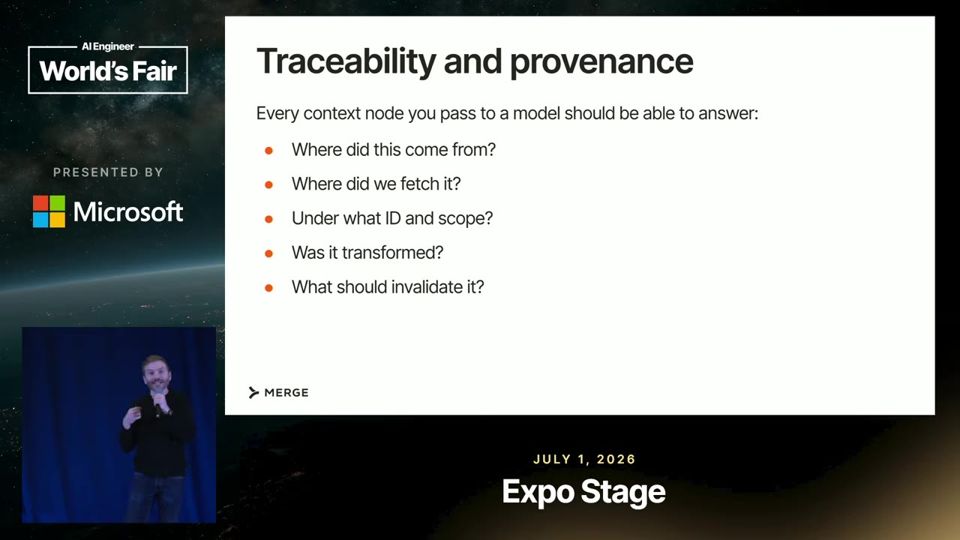
Toda resposta deve guardar de onde veio o dado, quando foi buscado, com quais permissões e o que o invalida, para que se possa investigar quando o agente errar.

Antes de ler

Mais 2 termos

Consulta ao vivo não responde perguntas sobre muitos dados

Perguntar "por que o cliente A ficou chateado?" funciona com uma chamada ao Zendesk. Perguntar quais clientes ficaram chateados no último ano exige puxar milhares de tickets, 100 por vez, até dar timeout. As APIs de terceiros não oferecem busca semântica, então o agente não consegue perguntar em linguagem natural direto à plataforma.

Busca ao vivo escala mal quando a pergunta cobre um período longo.04:19

Sincronize uma cópia para perguntas semânticas

Para análise ampla, o dado precisa ser copiado para um banco vetorial local. Para ações simples e pontuais, como consultar um cliente no Stripe, a chamada ao vivo basta. Feig diz que a cópia custa mais e é mais difícil de manter atualizada, então ela entra só onde a pergunta exige.

Duas vias de dados: ao vivo para o simples, sincronizado para o profundo.05:20

Roteador, resumidor e skills guiam a busca

O roteador envia o prompt ao agente certo. O resumidor condensa o que veio do cache e das chamadas ao vivo, para não despejar contexto demais no agente. Skills e memória vêm antes: elas dizem, por exemplo, que a empresa mede satisfação pelo Qualtrics e não pelo número de tickets.

A arquitetura completa da camada de contexto proposta.06:22
Mais 2 ideias deste talk

Quatro camadas de contexto e um fluxograma de decisão

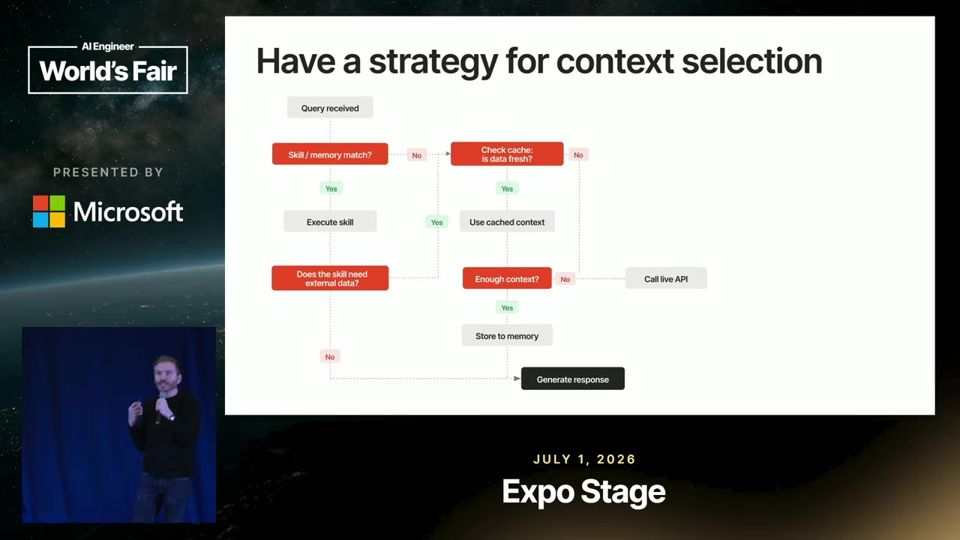
As camadas são prompt com skills e memória, chamadas de API ao vivo, dados em cache e contexto derivado (resumos guardados para reuso). No fluxograma, o agente confere se há skill ou memória, depois se o cache está dentro do prazo aceitável (SLA), e só então chama a API ao vivo, em ciclos até juntar contexto suficiente.

Ordem de decisão: skill, cache fresco, API ao vivo, resposta.10:40

Rastreabilidade de cada dado

Cada dado guardado deve levar metadados: origem, hora da busca, ID e escopos usados, quem acessou, se foi transformado, como era o original e o que o invalida (por exemplo, mais de um mês de idade). Isso permite auditar decisões de negócio e investigar falhas.

Lista do que registrar para saber de onde veio cada dado.12:07
leitura crítica

A Merge vende sincronização de dados (Unified), conexões MCP ao vivo (Agent Handler) e um roteador de LLM (Gateway), e o talk termina com o pitch. Todas as peças descritas coincidem com esses produtos. Não há medição, caso de cliente nem comparação de custo ou qualidade. Frases como "é só física" são opinião. O custo e a manutenção do cache, que o próprio palestrante admite serem maiores, ficam sem números.

O que fazer com isso

  • Separe suas perguntas frequentes entre lookup simples (uma chamada ao vivo basta) e análise sobre muitos registros (exige cópia sincronizada ou exportação).
  • Escreva como sua empresa define termos como "cliente satisfeito" ou "risco de renovação" e entregue isso ao agente como skill ou documento fixo.
  • Peça ao agente que sempre cite a fonte e a data de cada dado usado numa resposta e defina uma idade máxima aceitável para dados em cache.
  • Limite o que o agente puxa de cada sistema (o exemplo do talk pega só 5 tickets) para evitar timeout e contexto inchado.

Small Models, Big Results: Training a Finance Agent for Under $500

Um Qwen3 4B treinado com RL e dados bem verificados superou o 235B em perguntas financeiras. O gargalo estava na disciplina no uso de ferramentas.

Modelos 17:15 nível ●●●●○ Charles Dickens, Snorkel AI Assistir no YouTube (abre em nova aba)

Em 3 frases

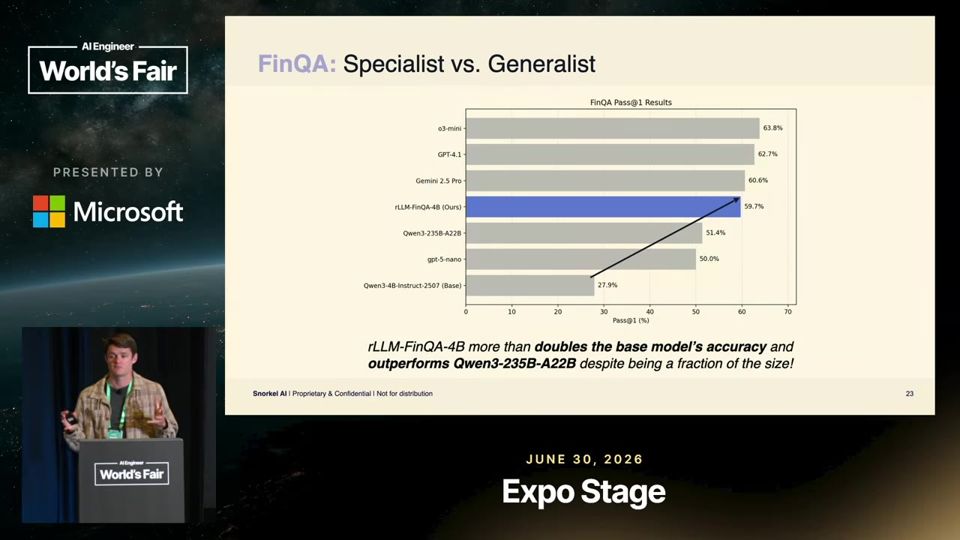
A Snorkel AI e o Sky Computing Lab de Berkeley criaram o FinQA, um conjunto de perguntas financeiras tiradas de relatórios 10-K e revisadas por especialistas.

Com reinforcement learning (aprendizado por reforço) no framework rLLM e uma recompensa simples de certo ou errado, um modelo de 4 bilhões de parâmetros passou o de 235 bilhões por menos de 500 dólares.

Dados mais simples e recompensa binária deram mais ganho do que currículo ou rubrica detalhada, e a habilidade se transferiu para perguntas com várias tabelas.

Antes de ler

Mais 2 termos

Especialista pequeno contra generalista grande

Para o banco, saber raciocinar significa operar no próprio sistema, com schemas complexos, APIs antigas e dívida técnica, sem acumular erros em fluxos longos e com rastro auditável. O palestrante defende que tarefas especializadas pedem um modelo treinado para elas. Escalar o tamanho do modelo seria o reflexo comum, e ele argumenta contra esse reflexo.

O talk enquadra a disputa como generalista grande contra especialista pequeno03:52

Como o FinQA foi montado e verificado

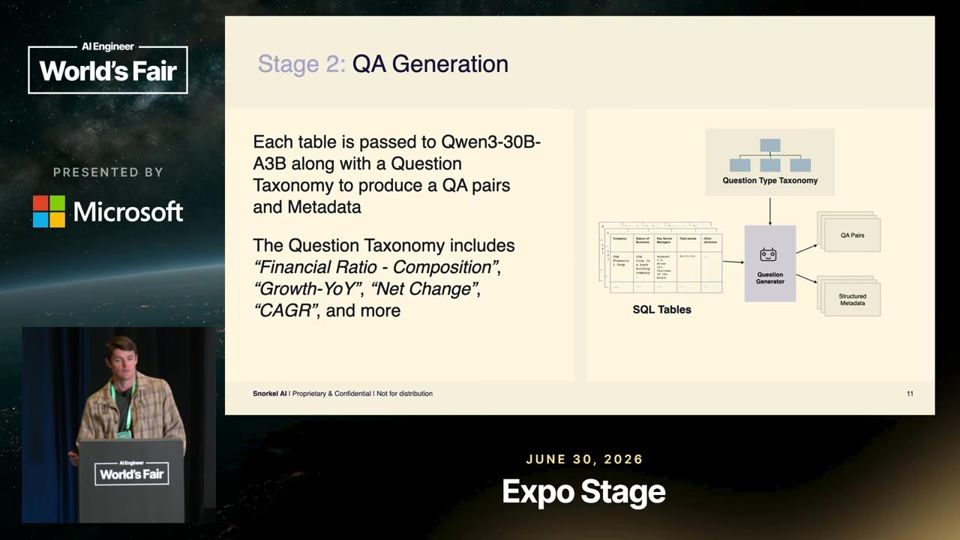
A equipe puxou relatórios 10-K do sistema EDGAR da SEC e usou o Qwen3 30B para gerar cerca de 6.900 tabelas SQL. Cada tabela virou uma pergunta e resposta, guiada por uma taxonomia criada com especialistas financeiros. A verificação tem três camadas: checagens programáticas de tabelas e colunas, revisão por agentes independentes e revisão manual de especialistas. Nenhuma empresa do benchmark aparece no treino.

O dado de treino passa por checagem automática, por agentes e por humanos05:44

Onde até modelos de fronteira falham

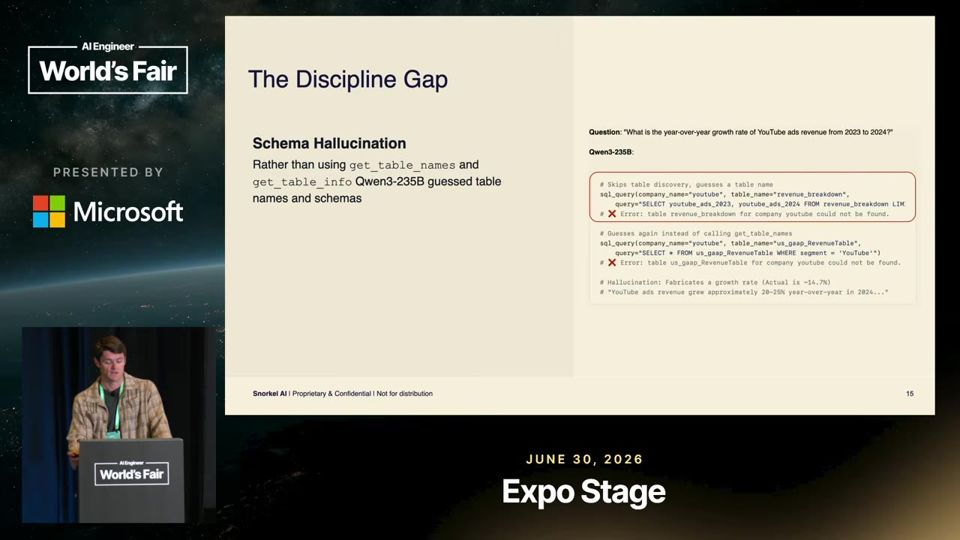
Os autores viram três falhas recorrentes. A primeira é inventar tabelas e colunas que não existem (schema hallucination). A segunda é encher o próprio contexto com consultas amplas como SELECT *. A terceira é repetir a mesma estratégia depois de um erro, sem ler a mensagem de erro. Segundo o palestrante, as mesmas falhas apareceram em subscrição de seguros.

As falhas são de disciplina no uso de ferramentas, e o raciocínio não aparece entre elas07:20
Mais 2 ideias deste talk

Treino barato com recompensa binária

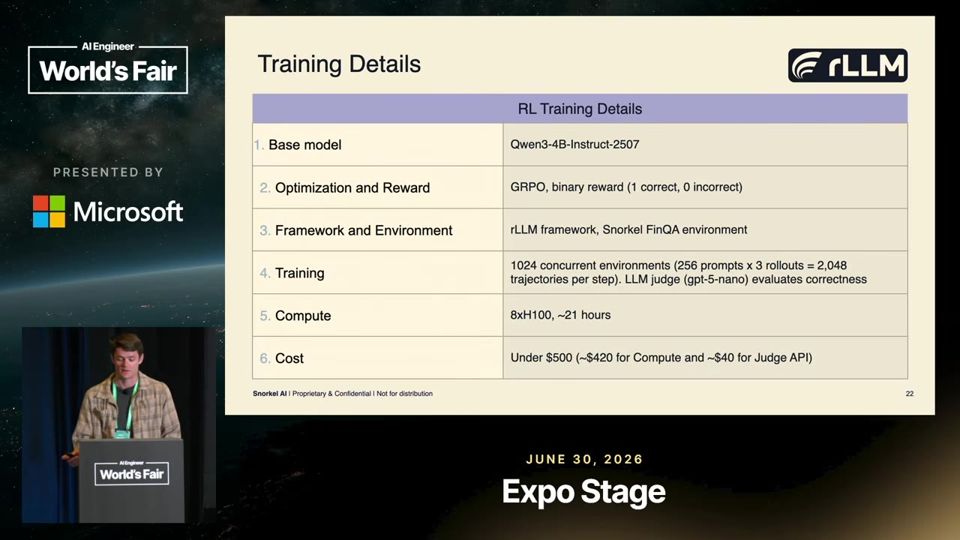
O agente roda num loop ReAct (raciocinar e agir) com ferramentas para consultar as tabelas. A recompensa é só certo ou errado, decidida pelo GPT-5 nano como juiz comparando com a resposta de referência. O treino usou GRPO, cerca de 1.000 ambientes em paralelo e oito GPUs H100. O custo ficou abaixo de 500 dólares, com cerca de 420 em computação e 40 na API do juiz.

Todo o treino coube em menos de 500 dólares09:50

Resultado e ablações

A acurácia do modelo base mais que dobrou e passou a do 235B no benchmark de 290 perguntas. O ganho se transferiu para perguntas de duas a cinco tabelas sem treino específico, e o desempenho geral no benchmark BFCL de chamada de ferramentas subiu um pouco. Nas ablações (testes que removem ou trocam uma peça por vez), treinar só nos dados simples e usar recompensa binária venceu currículo e rubrica.

O 4B treinado supera o 235B no conjunto de teste separado10:30
analogia

Ablation study (estudo de ablação, que testa uma variável por vez). Ablation study é como testar uma receita de bolo tirando um ingrediente por vez para descobrir qual deles faz diferença no sabor.

  1. Quando algo funciona bem, muitas peças contribuíram. Você quer saber quais delas realmente importam.
  2. O estudo de ablação (ablation study) mexe em uma peça por vez: tira, troca ou simplifica, e mantém o resto igual.
  3. Depois você mede o resultado de cada versão e compara com a versão completa. A queda ou o ganho mostra o peso daquela peça.
  4. No talk, o time testou três misturas de dados de treino (só simples, simples e multitabela, currículo) e dois tipos de recompensa (rubrica ou certo e errado).
  5. O resultado surpreendeu: dados simples e recompensa binária deram mais ganho que as opções mais sofisticadas.
VERSÃO COMPLETASistema com todas as peças
MUDA UMA PEÇADados ou recompensa, só um
REPETE O TESTEMesmo benchmark para todos
COMPARAMede o que cada peça rendeu
PEÇA QUE IMPORTADados simples e recompensa binária

Ajuda saber antes: Reinforcement learning, Currículo de treino, Rubric

leitura crítica

A Snorkel vende dados e ambientes de treino, e o talk termina anunciando os grants da empresa e vagas abertas. O benchmark foi criado pela própria equipe com o mesmo pipeline sintético do treino. Ele tem 290 perguntas, e a versão multitabela tem 80, então a amostra é pequena. O 235B foi comparado sem ajuste fino, e não há comparação com modelos fechados de fronteira. O juiz GPT-5 nano pode errar. O custo de 500 dólares deixa de fora a geração dos dados e a revisão por especialistas. Os ganhos no BFCL aparecem sem números.

O que fazer com isso

  • Antes de trocar por um modelo maior, revise os logs do seu agente e procure as três falhas citadas: tabelas inventadas, consultas que despejam dados demais e repetição do mesmo erro.
  • Monte um conjunto de teste próprio com respostas verificáveis e separe por cliente ou empresa, para que nada do teste vaze para exemplos ou ajustes.
  • Se for ajustar um modelo, comece por dados simples e uma métrica de certo ou errado. Só adicione rubricas detalhadas se o ganho aparecer no teste.
  • Dê ao agente ferramentas que listem tabelas e colunas reais e limitem o tamanho do retorno, para reduzir alucinação de schema e excesso de contexto.

From 15% to 90% GPU Utilization: Fix the Data Pipeline, Not the Model

GPU parada geralmente espera dado. Meça onde o tempo vai e conserte o gargalo certo, um de cada vez, antes de mexer no modelo.

Infraestrutura 17:01 nível ●●●●○ Assistir no YouTube (abre em nova aba)

Em 3 frases

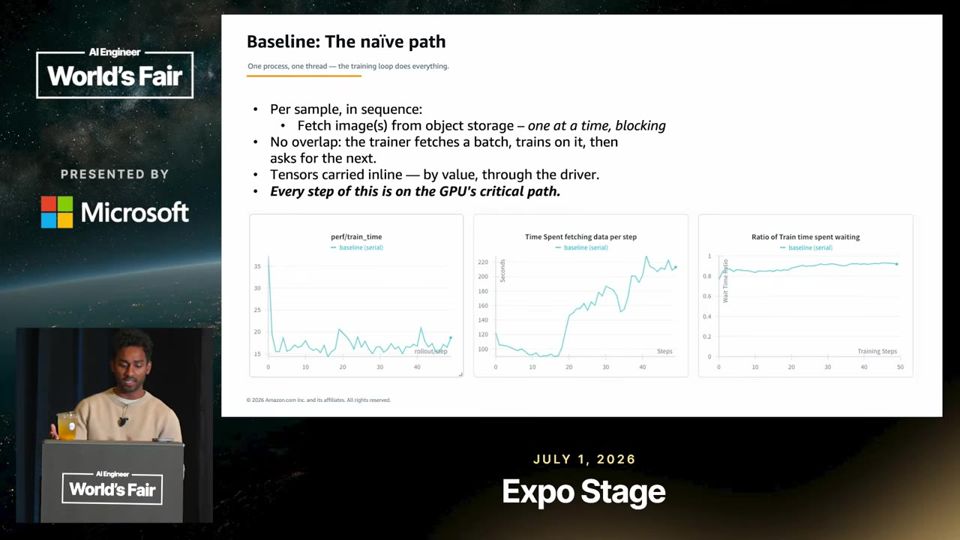
O treino de um modelo multimodal (imagem e texto) usava só 15% da GPU, porque 85% do tempo ia para buscar, decodificar e redimensionar imagens do S3, uma por vez.

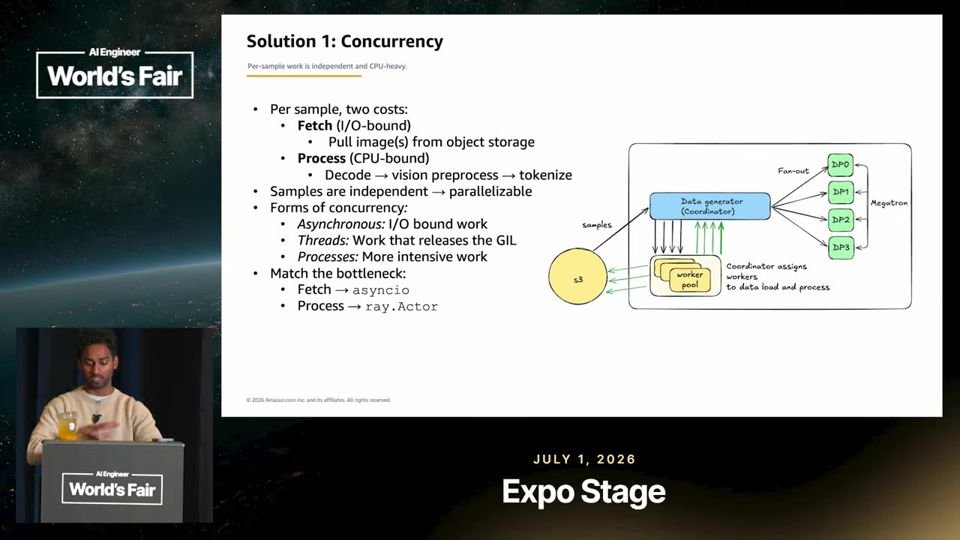
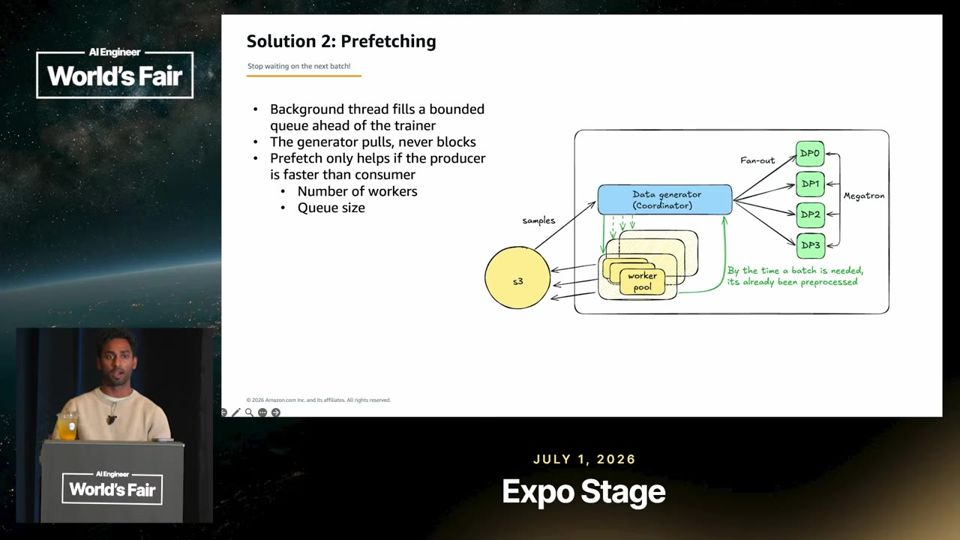
Tarun Sunkaraneni, da Amazon AGI, corrige em etapas: concorrência com asyncio e Ray actors, prefetching (buscar dados antes do pedido) e object store do Ray para evitar cópias de tensores. A espera cai de 85% para 20%.

Em escala de produção surge outro gargalo, a placa de rede de uma máquina. Duas flags do Ray (spread scheduling e leitura zero-copy) dão 50% a mais de throughput, mas só funcionam juntas e só em escala grande.

Antes de ler

Mais 2 termos

Meça a razão de tempo de espera antes de otimizar

O palestrante define a wait-time ratio (razão de tempo de espera): tempo para preparar e transportar os dados, dividido pelo tempo total do pipeline. No baseline, 85% do tempo era espera por dados. O treino levava de 15 a 20 segundos por lote, e buscar o lote passava de 100 segundos. O flame graph (gráfico de perfil) mostrou o S3 como maior fatia.

Buscar dados leva mais de 100 s por lote, treinar leva 15 a 20 s.05:56

Combine a concorrência com o tipo de gargalo

Cada amostra é independente, então o trabalho se paraleliza com facilidade. Ele escolhe asyncio para buscar imagens (espera de rede), e Ray actors, que são processos com APIs de comunicação prontas, para decodificar e pré-processar (uso de CPU). A regra dele é casar a ferramenta com o gargalo, e não repetir a que já funcionou antes. Esse passo deu cerca de 25% de ganho.

Asyncio para IO, Ray actors para CPU, e a busca por lote cai para cerca de 40 s.08:01

Prefetching mantém o produtor à frente do treino

Uma thread em segundo plano enche uma fila antes de o trainer pedir. O produtor roda mais rápido que o consumidor, e o treino encontra o lote pronto. O tempo de busca por lote fica perto de zero. O custo é um checkpoint e uma retomada mais trabalhosos, além de um período de cold start (fila ainda vazia) no começo.

Com a fila cheia, o trainer não espera mais pelo dado.09:35
Mais 2 ideias deste talk

Object store evita copiar tensores entre processos

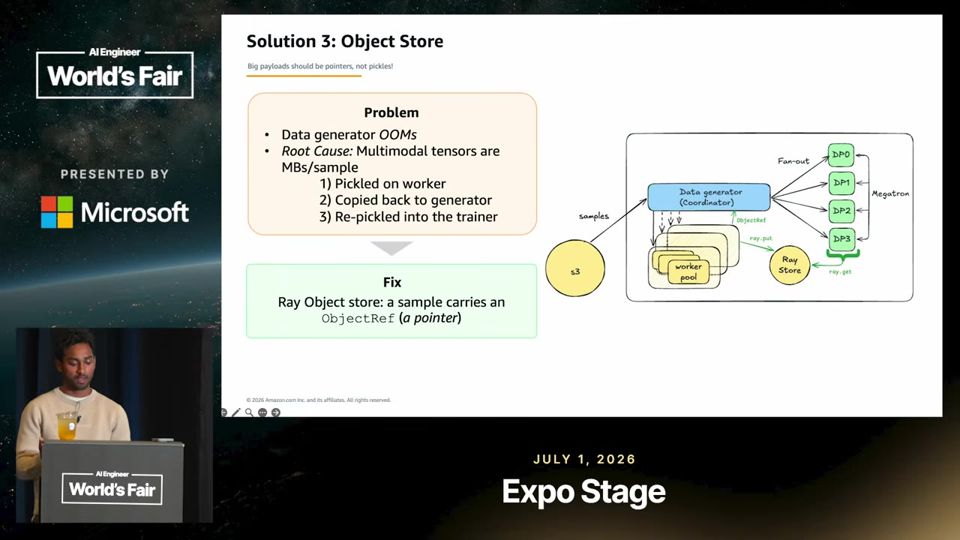
Depois do prefetching, o transporte ficou mais caro. Cada amostra era serializada (pickle) no worker, copiada para o coordenador e serializada de novo para o trainer, com megabytes por amostra. Com o object store do Ray, cada amostra carrega só uma referência (ponteiro). Os ranks do Megatron buscam o dado direto quando precisam. A espera total cai de 85% para 20%.

A referência viaja pelo coordenador e o tensor fica no object store.11:10

Em escala, o gargalo vira a placa de rede

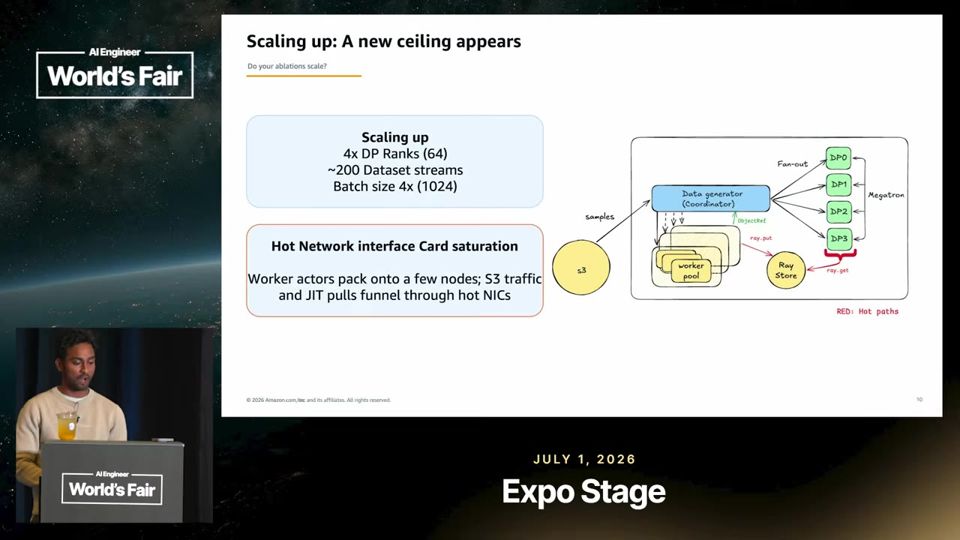
Ao multiplicar por quatro os ranks de dados paralelos e o tamanho do lote, a espera voltou a subir. O Ray agrupa workers na mesma máquina, e a placa de rede (NIC) desse nó não dava conta. Espalhar os workers por vários nós (spread scheduling), junto com leitura zero-copy, rendeu 50% a mais de throughput. Nenhuma das duas flags ajudou sozinha em escala pequena.

O Ray junta workers por padrão, e isso satura a rede de um nó.13:45
analogia

Wait-time ratio (razão de tempo de espera). A wait-time ratio é como medir quanto tempo um cozinheiro fica parado esperando os ingredientes chegarem, em relação ao tempo total do turno.

  1. Uma GPU (placa que faz as contas do treino) custa caro e precisa estar sempre ocupada. Quando fica parada, o dinheiro é desperdiçado.
  2. A wait-time ratio (razão de tempo de espera) mostra quanto do tempo ela passa esperando dados em vez de treinar.
  3. A conta no talk é o tempo para preparar e transportar os dados, dividido pelo tempo total do pipeline, que inclui o treino.
  4. No baseline, a razão era de 85%. Buscar um lote levava mais de 100 s e treinar levava 15 a 20 s.
  5. Depois das otimizações, a razão caiu para 20%. Medir esse número antes de mexer evita otimizar a parte errada.

Ajuda saber antes: GPU, Pipeline de dados, Bottleneck

analogia

GIL (global interpreter lock) (trava global do interpretador do Python). O GIL é como uma cozinha com uma única chave do fogão, e só o cozinheiro que segura a chave pode cozinhar naquele momento.

  1. Python roda seu código por meio de um programa chamado interpretador, que lê e executa cada instrução.
  2. O GIL (global interpreter lock, trava global do interpretador) é uma regra desse programa. Só uma thread (linha de execução) executa código Python por vez.
  3. Por isso, várias threads fazendo conta pesada em Python puro não correm de verdade em paralelo. Elas se revezam.
  4. Algumas bibliotecas, como os tokenizers do Hugging Face e partes do PIL, soltam a trava enquanto trabalham em código nativo. Nesses casos, threads ajudam.
  5. Quando a biblioteca não solta a trava, a saída são processos. Cada um tem seu próprio interpretador e sua própria trava, e usam vários núcleos da máquina.

Ajuda saber antes: Thread, Processo, Concorrência, Interpretador

analogia

Ray actors (processos com estado do framework Ray). Um Ray actor é como um funcionário fixo de uma central de atendimento, com mesa e ramal próprios, que recebe tarefas pelo telefone interno.

  1. Um processo é um programa rodando sozinho, com a própria memória. Dá para ter vários ao mesmo tempo para usar mais núcleos.
  2. Um Ray actor é um processo desse tipo, criado e gerenciado pelo Ray, um framework de computação distribuída (que divide trabalho entre várias máquinas).
  3. O actor guarda estado. Ele pode manter na memória um tokenizador ou um modelo de imagem carregado e reutilizar a cada tarefa.
  4. O Ray já traz as chamadas para mandar tarefas e receber resultados entre actors, então você não monta essa comunicação do zero.
  5. No talk, os actors decodificam e pré-processam imagens, um trabalho de CPU que o asyncio não resolve e que o GIL atrapalharia em threads.

Ajuda saber antes: Processo, GIL (global interpreter lock), Concorrência

analogia

Prefetching (busca antecipada de dados). Prefetching é como o ajudante de cozinha que deixa os ingredientes cortados e enfileirados no balcão antes de o chef pedir o próximo prato.

  1. Sem prefetching (busca antecipada de dados), o treino pede um lote e só então o sistema começa a buscá-lo. A GPU espera parada.
  2. Com prefetching, uma thread em segundo plano busca e prepara lotes antes do pedido e os guarda numa fila.
  3. O produtor (quem prepara os dados) roda mais rápido que o consumidor (o treino). Assim a fila fica sempre com lotes prontos.
  4. Quando o treino pede um lote, ele já está lá. No talk, o tempo de busca por lote ficou perto de zero.
  5. Há custos. Checkpoint e retomada do treino ficam mais trabalhosos, e existe um cold start (partida a frio), o período inicial em que a fila ainda está vazia.
THREAD DE FUNDOBusca e prepara lotes antes do pedido
FILAGuarda lotes prontos
TRAINERPede o lote e o encontra na fila
GPU SEM ESPERABusca por lote perto de zero

Ajuda saber antes: Thread, Fila (queue), Produtor e consumidor, Wait-time ratio

analogia

Object store e zero-copy (armazenamento de objetos compartilhado e leitura sem cópia). O object store é como um armário compartilhado do escritório, onde você deixa o documento grande e entrega aos colegas só um bilhete com o número da gaveta.

  1. Mandar um dado grande de um processo para outro costuma significar fazer uma cópia inteira dele, e isso custa tempo.
  2. No baseline do talk, cada amostra de imagem era serializada (pickle, transformada em bytes), copiada para o coordenador e serializada de novo para o trainer.
  3. O object store do Ray guarda o dado uma vez, em memória compartilhada. Cada amostra passa a carregar só uma referência, que é um ponteiro para onde o dado está.
  4. O coordenador repassa apenas a referência. Os ranks do Megatron (os processos de treino) buscam o tensor direto no store quando precisam.
  5. Zero-copy (leitura sem cópia) deixa o processo ler o dado na própria memória compartilhada, sem duplicá-lo. No talk, essa flag só rendeu em escala grande, junto com o spread scheduling.
WORKERProcessa a imagem e guarda no store
OBJECT STOREDado fica parado em memória comum
COORDENADORRepassa só a referência (ponteiro)
RANK DE TREINOBusca o tensor direto, sem cópia

Ajuda saber antes: Serialização (pickle), Ponteiro e referência, Ray actors, Tensor

leitura crítica

O talk usa um único experimento, sem informar tamanho do cluster, modelo exato, GPUs nem repetições. Os ganhos vêm de um pipeline deliberadamente ingênuo no ponto de partida, então os 15% iniciais dizem pouco sobre equipes que já usam bons data loaders. O palestrante não mostra medições isoladas de cada flag, só afirma que sozinhas não ajudaram. Também não há conflito de interesse evidente, mas o Ray é a ferramenta central e as conclusões dependem das escolhas padrão dele.

O que fazer com isso

  • Antes de otimizar um treino ou pipeline, calcule a fração do tempo que a GPU passa esperando dados e rode um profiler no baseline.
  • Escolha o tipo de concorrência pelo gargalo: asyncio para espera de rede, threads quando a biblioteca solta o GIL, processos para trabalho pesado de CPU.
  • Passe referências a dados grandes no lugar de copiá-los entre processos, e planeje o custo de comunicação a cada decisão de paralelismo.
  • Teste configurações de infraestrutura em uma escada de escalas. Uma flag sem efeito em escala pequena pode valer 50% em escala grande.

Fim da edição

Termos novos no glossário: Complexidade ciclomática, Ablation study, Wait-time ratio, GIL (global interpreter lock), Ray actors, Prefetching, Object store e zero-copy.