Pular para o conteúdo
Aprendendo AI

Agentes em produção: segurança, contexto e inferência

Edição de segunda, 12 out 2026 · 57 vídeos · 36 h 10 min de talks

Edição grande, com 57 talks da conferência AI Engineer. Ela começa por negócio e equipes, passa pela série da Anthropic sobre Claude Managed Agents e por agentes que melhoram sozinhos lendo os próprios traces e evals. Depois vem o bloco mais longo, sobre segurança: credenciais curtas, sandboxes e a lethal trifecta, quando o agente junta dados privados, conteúdo externo e acesso à internet. O fim cobre busca híbrida e GraphRAG para dar contexto ao agente, os truques de inferência que deixam o mesmo modelo mais rápido e como a MiniMax treinou o M3 com atenção esparsa.

Building AIE: Open Q&A and Feedback Session with swyx

O organizador do AI Engineer prefere crescer por regiões e melhorar o que já existe, e usa o feedback do público como lista de requisitos.

Carreira e equipes 58:42 nível ●○○○○ Assistir no YouTube (abre em nova aba)

Em 3 frases

swyx abre um Q&A livre no World's Fair 2026 e responde sobre trilha de segurança, duração do expo, Wi-Fi, app da conferência e inscrição em workshops, admitindo falhas em vários pontos.

Ele anuncia que o evento de San Francisco não vai crescer em 2027, que haverá um evento focado em finanças em Nova York e que parceiros locais vão levar a marca AIE a outros países.

Explica como escolhe palestrantes (cerca de 2.200 inscrições para cerca de 300 vagas) e dá dicas de meetup local, como manter formato simples, local fixo e reunir voluntários.

Antes de ler

Em 2027 o World's Fair não cresce

swyx dá uma prévia que ainda não tinha anunciado. O evento de 2027 terá o mesmo tamanho, o mesmo local (Moscone) e a mesma semana. A justificativa é que sua equipe, patrocinadores e palestrantes já viram como é rodar o evento e agora precisam otimizar. O crescimento vem por geografia, com eventos parceiros em outros países.

17:21 Anúncio de que o evento do ano que vem terá o mesmo tamanho e local.

Modelo de parceiros, no estilo TED e TEDx

Cerca de 40 países pediram uma versão local do AIE. Como a equipe não consegue atender todos, o modelo copia o TED e o TEDx. Parceiros locais organizam o evento sob a marca, desde que ela continue com conteúdo técnico de qualidade. Bangalore deve ser o primeiro caso na Índia. A comunidade online fica nas redes sociais existentes, sem criar mais um Slack.

09:03 Programa de parcerias para eventos AIE locais, sob a lógica TED e TEDx.

App da conferência: dados abertos e vibe coding

Participantes listaram falhas do app comprado de um fornecedor externo, como travamentos no Android, perda da posição na rolagem e falta de sincronia com a web. swyx quer trocar o app por um web app próprio e lembra que os dados do evento já eram abertos em JSON, com MCP e CLI. Qualquer pessoa podia criar o próprio app com vibe coding, mas poucos enviaram algo.

27:49 Dados abertos permitiam que cada participante montasse seu próprio app.

Mais 2 ideias deste talk

Como entrar como palestrante

Foram cerca de 2.200 inscrições para cerca de 300 vagas, e parte das vagas vai para convidados. As candidaturas não são cegas. O comitê assiste a talks anteriores e briga pelos candidatos que se mostram muito bons. O conselho é anexar gravações de apresentações passadas e ligar o trabalho a uma tendência maior. Há também uma opção no formulário para talks esquisitos que não cabem em trilha nenhuma.

52:41 Explicação do funil de seleção do CFP, o chamado para submissão de talks.

Poster sessions e ponte com a academia

Este foi o primeiro ano com sessões de pôsteres acadêmicos. O AIE usou o processo de seleção de outra conferência parceira, sem curadoria própria. swyx fala em criar revisão por pares no futuro e até em publicar um periódico. Ele vê valor em não ser uma conferência acreditada, porque pesquisadores podem apresentar o mesmo trabalho em dois lugares.

56:19 Primeira edição das sessões de pôsteres no World's Fair.

leitura crítica

A fonte é o próprio organizador, que vende ingressos e patrocínios, então a sessão também funciona como divulgação do evento e do AIE Code Summit. O feedback vem de poucas pessoas que levantaram a mão, sem pesquisa de satisfação. O argumento de que evals de laboratórios descobrem mais problemas de alinhamento do que a discussão de risco existencial não vem com evidência no vídeo. O índice de fantasias (2, 0 e 9) é uma brincadeira, não uma métrica. Os números de inscrições e de público são ditos de memória.

O que fazer com isso

  • Se quiser palestrar em um evento, anexe gravações de talks anteriores, mesmo de meetups pequenos, e mostre como seu caso se liga a uma tendência maior.
  • Para organizar um meetup, comece simples com local fixo, data recorrente, dois talks e tempo social, e reúna voluntários antes de pensar em gravação e site.
  • Quando um evento publicar dados abertos, como JSON ou MCP, teste montar seu próprio filtro de agenda com uma ferramenta de IA em vez de esperar o app oficial.
  • Antes de ir a uma conferência grande, leia o guia do participante e escolha com antecedência uma segunda opção de sessão, já que as palestras são gravadas.
Inside the AI Economy: What Stripe's Data Reveals

Com dados da Stripe, a palestra mostra que empresas de IA vendem mais rápido, em mais países, com preço por uso e já pensando em agentes como compradores.

Produto 20:50 nível ●●○○○ Nilofer Rajpurkar, Stripe Assistir no YouTube (abre em nova aba)

Em 3 frases

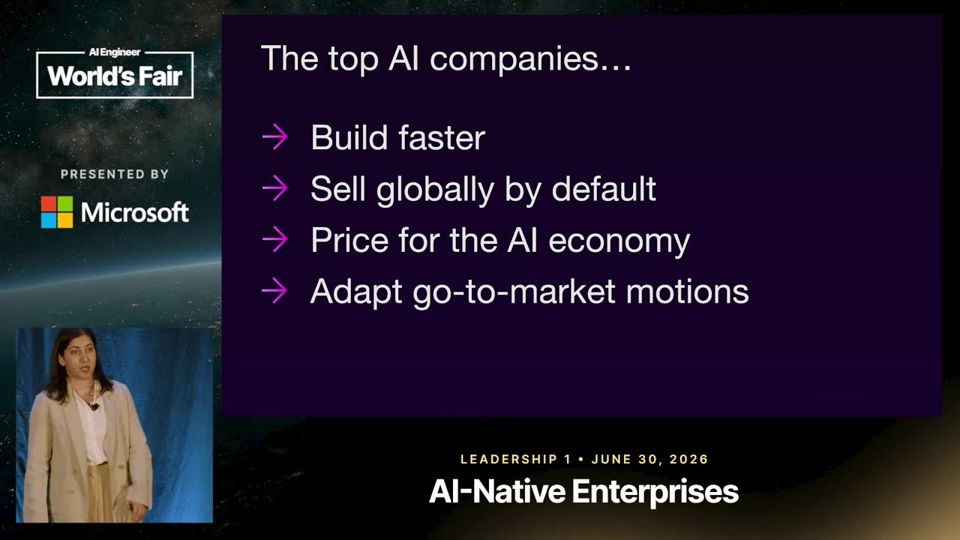
A Stripe usa seus próprios dados de pagamentos para apontar quatro padrões nas empresas de IA que mais crescem: construir rápido, vender no mundo todo desde o dia um, cobrar por uso e abrir canais de venda cedo.

Na demo, o Claude monta uma cobrança com assinatura usando o servidor MCP e as agent skills da Stripe, cria um sandbox pela linha de comando e termina com um checkout de teste funcionando.

A palestrante diz que o tráfego de agentes na documentação da Stripe cresceu 10 vezes em um ano e recomenda projetar produto e preço para agentes que descobrem, avaliam e ativam um serviço sozinhos.

Antes de ler

Mais 2 termos

A receita de IA quase triplicou o ritmo

A Stripe diz que a receita de empresas de IA cresceu 120% em 2025 e 175% um ano depois. No consumo, os usuários da Link (carteira de pagamento da Stripe) passaram de menos de 6 milhões para mais de 14 milhões em um ano. Os maiores compradores gastam cerca de US$ 360 por mês em ferramentas de IA, contra US$ 183 três meses antes.

Os números de crescimento que abrem a palestra.01:17

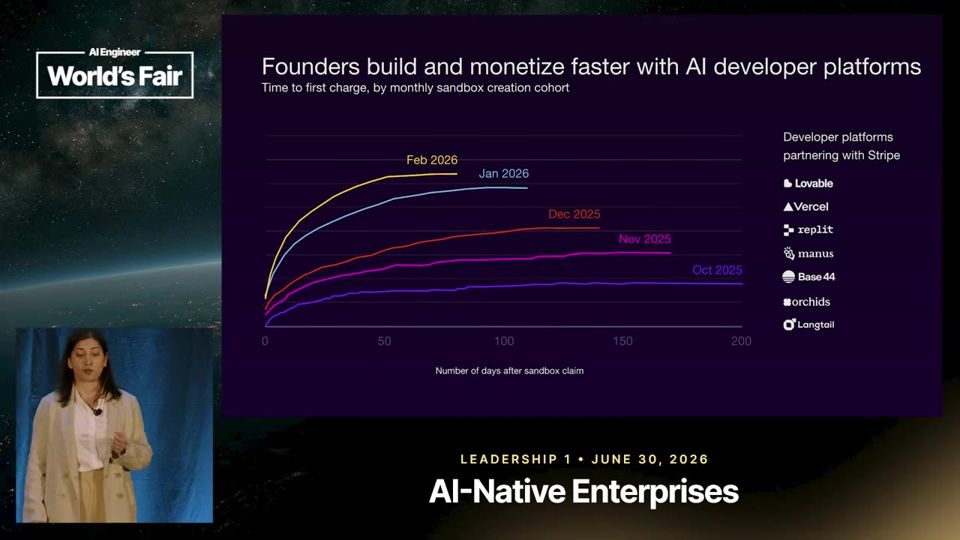
Do produto ao primeiro cliente pagante em menos de seis semanas

Os dados de plataformas como Lovable, Vercel e Replit mostram que cada nova turma mensal de usuários chega ao primeiro cliente pagante mais rápido. As turmas mais recentes levam menos de seis semanas. Segundo a palestrante, o lançamento de ferramentas de código com agentes coincide com a retomada de apps de iOS e de novas empresas registradas em Delaware.

Cada coorte nova chega ao primeiro pagamento mais rápido.04:40

Demo: pagamentos dentro do Claude

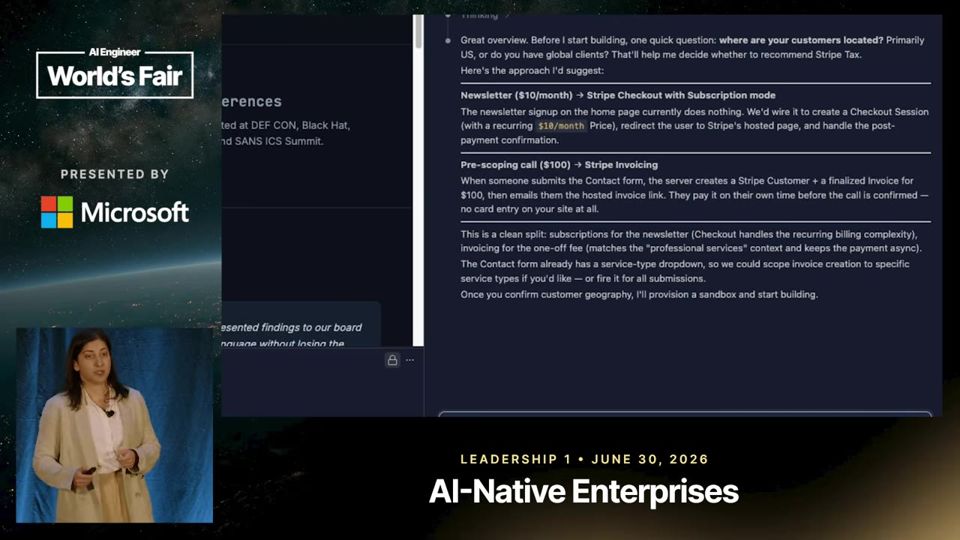
O Claude usa a ferramenta de recomendação de integração do MCP da Stripe e as agent skills. Ele pergunta onde ficam os clientes, sugere Stripe Tax por causa do IVA na Europa e prefere Checkout a card elements por causa das assinaturas. Um comando novo de CLI cria um sandbox sem exigir credenciais antes. No fim, o checkout de teste roda sem sair do Claude.

O agente decide a integração a partir das skills da Stripe.05:41
Mais 2 ideias deste talk

Vender em 48 países no primeiro ano

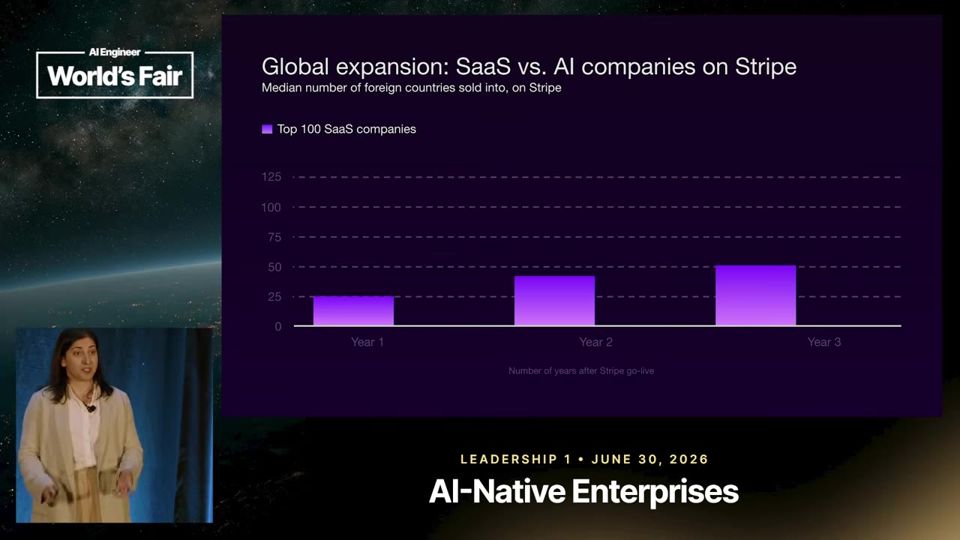
O modelo antigo de SaaS chegava a 25 países no ano um e 50 no ano três. A Stripe afirma que as empresas de IA do topo vendem em 48 países no ano um e em 120 no ano três. Nessas empresas, 48% da receita vem de fora do mercado de origem, contra 33% três anos antes. Preços em moeda local e um meio de pagamento local aparecem associados a mais receita e conversão.

Expansão internacional no ano um, segundo dados da Stripe.08:47

Preço híbrido e agentes como compradores

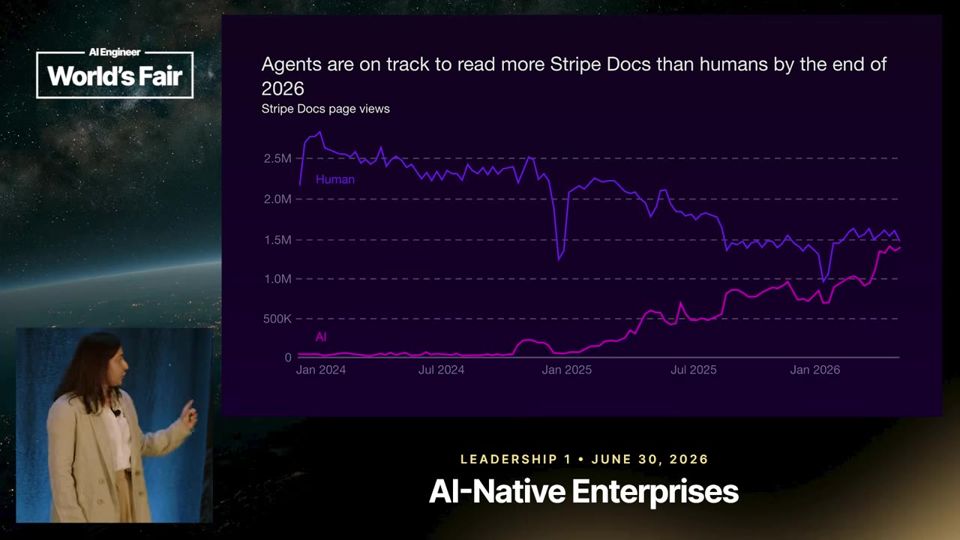
O Replit combina assinatura fixa, que dá previsibilidade, com créditos de uso, que capturam valor. Dois terços das empresas da lista Forbes AI 50 têm alguma cobrança por uso. A palestrante recomenda mostrar o gasto em tempo real e vender créditos em vez de custo por ação. O gráfico final mostra o tráfego de agentes na documentação da Stripe se aproximando do tráfego humano.

O tráfego de agentes na documentação cresce rumo ao humano.18:10
leitura crítica

A palestra é também um pitch da Stripe: a demo, o MCP e as skills vendem os produtos da própria empresa. Os números vêm só dos dados internos da Stripe, sem metodologia, sem definição de "empresas de IA do topo" e com viés de sobrevivência, já que mostra quem cresceu. Os 48 países do ano um aparecem como 42 no recap (1181), o que sugere falha de fala ou de slide. A causalidade entre ferramentas de código e novas empresas é sugerida por gráficos, não testada. Os slides falharam durante a fala, então parte dos dados foi narrada sem visual.

O que fazer com isso

  • Se você vende um produto de IA, simule o preço híbrido: assinatura fixa para previsibilidade mais créditos de uso para quem consome muito.
  • Mostre ao cliente o gasto em tempo real antes da fatura, para reduzir o cancelamento por susto de cobrança.
  • Confira se sua documentação e seu cadastro funcionam para um agente: ele precisa descobrir, avaliar e ativar o produto sem ajuda humana.
  • Antes de vender fora, apresente preços em moeda local, ofereça ao menos um meio de pagamento local e automatize o cálculo de impostos.

We Let Our Financial Planners Write the Agents

Quem conhece o trabalho deve escrever o agente. Skill boa leva perguntas, limites, testes e um dono.

Carreira e equipes 08:53 nível ●●○○○ Matthew Ragone, Range Assistir no YouTube (abre em nova aba)

Em 3 frases

Matthew Ragone, planejador financeiro da Range, conta como planejadores sem código passaram a escrever os agentes da empresa. O agente rascunha a análise enquanto o planejador atende outro cliente, e o planejador revisa antes de enviar.

O método tem cinco passos: escolher um fluxo repetido que você sabe julgar, ensinar com casos reais narrando o raciocínio, empacotar em uma skill com perguntas e limites, testar de 5 a 10 vezes e entregar com dono e revisor.

Seis meses depois, a Range tem 24 skills, 17 delas em planejamento, e vendas, produto e marketing adotaram a prática sem ordem da diretoria. O próprio palestrante admite que ainda há pouco dado de campo sobre o método.

Antes de ler

O gargalo é estar em um lugar só

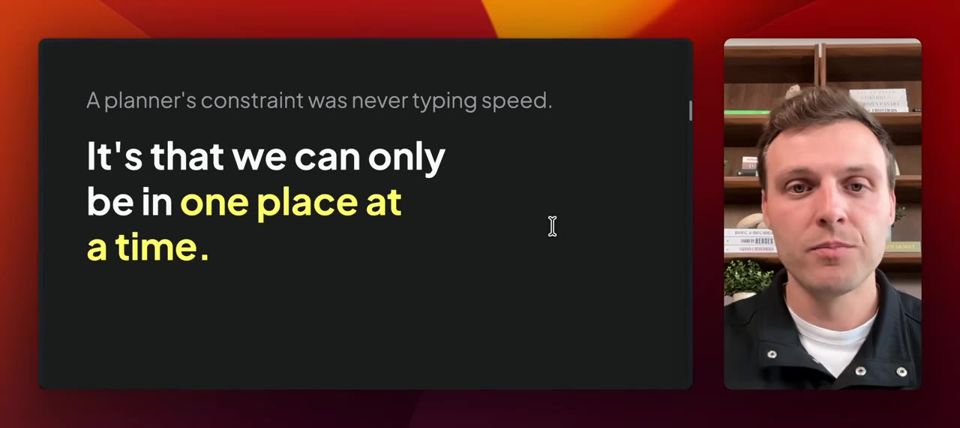
Ragone diz que a limitação do planejador nunca foi a velocidade de digitação. Ele só atende um cliente por vez. Usar IA como chatbot para reescrever mensagens economiza minutos. O ganho grande vem do trabalho que acontece enquanto ele está em outra chamada.

O agente rascunha a análise de um cliente enquanto o planejador atende outro.01:35

Skill é o jeito da empresa, escrito para o agente

O modelo já sabe planejamento financeiro em geral. Falta saber como a Range faz: o que olha primeiro, o que sempre sinaliza, como redige uma recomendação. Uma skill registra esse jeito de fazer uma tarefa específica. O agente precisa também trabalhar onde o trabalho está, não em uma janela de chat separada.

Skill é o método da firma escrito para o agente seguir.02:39

Escolha um fluxo que você consegue julgar de relance

O instinto é atacar o trabalho mais complexo e demorado. Ragone recomenda o contrário. Comece por algo repetido toda semana, de baixa complexidade, que dê muito trabalho manual e cujo rascunho ruim você identifica rápido. Na Range, foram análise de fluxo de caixa e revisão de seguros.

Sem julgar a saída com rapidez, não dá para testar nem confiar.03:43
Mais 2 ideias deste talk

Narre o porquê, não só os cliques

No passo 2, o especialista executa casos reais de clientes e explica em voz alta por que abre cada documento, o que procura e o que o faria parar para perguntar. Para Ragone, essa narração é o ponto central. Os passos são fáceis de escrever. O julgamento é o que torna a skill trabalho da firma.

Perguntas obrigatórias e limites (nunca enviar ao cliente) fazem a skill ser confiável.04:22

Teste 5 a 10 vezes e entregue com dono e revisor

Cada execução em caso real expõe uma lacuna: caso de borda, pergunta esquecida, resposta confiante e errada. O dono mantém a skill atualizada, porque regras mudam e uma skill certa em março pode estar errada em dezembro. O revisor é outra pessoa, pois ninguém corrige o próprio trabalho.

Testar e dar responsável evita distribuir uma skill pela metade para dezenas de pessoas.05:51
leitura crítica

O próprio palestrante diz que há pouca evidência de campo. O talk é um relato de experiência de uma empresa, sem medida de qualidade, taxa de erro ou tempo economizado. Os números de 24 e 17 skills mostram adoção, não acerto. Ragone também deixa em aberto como checar qualidade em escala quando a saída exige julgamento profissional. Ele lidera a adoção de IA na Range, então há interesse em mostrar o resultado de forma positiva. A conta de que testar de 5 a 10 vezes basta é opinião dele, sem dado.

O que fazer com isso

  • Liste os fluxos que você repete toda semana e escolha um cuja saída você avalia em segundos. Comece por ele.
  • Grave ou escreva uma execução real desse fluxo explicando por que faz cada passo, e transforme isso em uma skill com perguntas obrigatórias e limites explícitos.
  • Rode a skill de 5 a 10 vezes em casos reais, anote cada falha e corrija antes de compartilhar com o time.
  • Defina um dono que atualiza a skill e um revisor diferente do autor antes de outras pessoas passarem a depender dela.

Hiring Employable Agents + Startup Battlefield Finals

Um agente só vira funcionário de verdade quando trabalha sozinho por muito tempo, aprende com cada feedback e deixa o humano apenas nas decisões de risco.

Agentes 47:37 nível ●●○○○ Howie Liu, HyperAgent Assistir no YouTube (abre em nova aba)

Em 3 frases

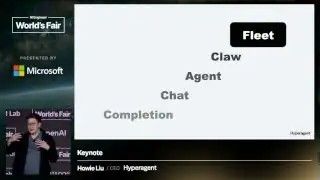
Howie Liu, CEO da HyperAgent e da Airtable, descreve a evolução dos produtos de IA em cinco degraus: completions, chatbots, agentes, agentes sempre ligados (claws) e agentes que orquestram outros agentes.

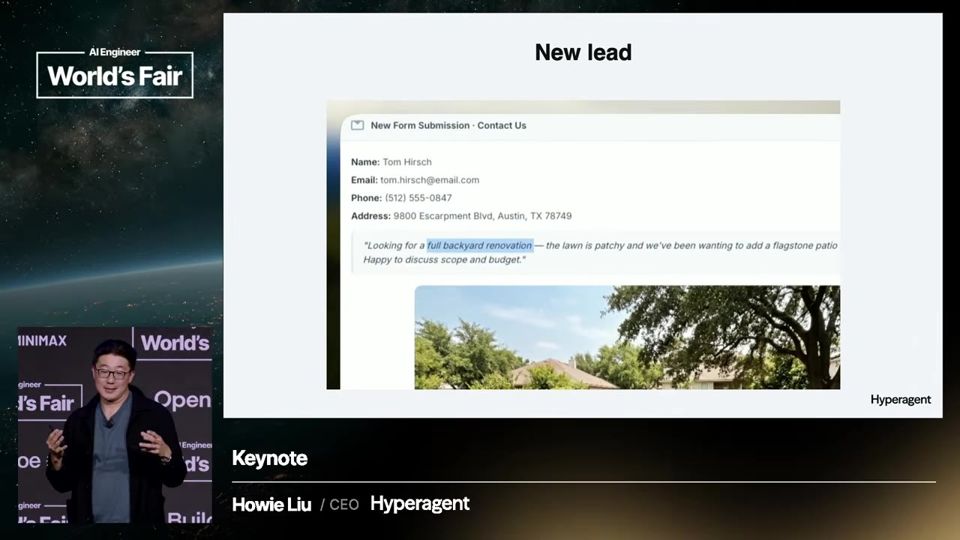
Ele mostra uma empresa de paisagismo que roda prospecção, orçamento e proposta com agentes, e o dono humano só aprova o que gera compromisso com o cliente e ensina o agente por Slack ou e-mail.

Na segunda parte, três startups fazem pitch ao vivo (Kamad, Comment IO e Built by Foundry) por 100 mil dólares em prêmios, e o Comment IO leva o prêmio principal.

Antes de ler

Mais 2 termos

Cinco degraus de produto, de completion a agente de agentes

Liu organiza a história em um espectro. O completion apenas continua um texto. O chatbot conversa. O agente chama ferramentas em loop. O claw acorda sozinho por um mecanismo de heartbeat (pulso periódico). O último degrau coordena outros agentes. Ele diz que isso só funciona porque os modelos agora mantêm coerência em tarefas longas, ao contrário do AutoGPT e do BabyAGI.

O espectro de formatos de produto que Liu usa para situar os agentes.02:34

Triagem e levantamento: agentes passando trabalho entre si

No exemplo do paisagismo, o pedido do cliente cai em um agente de triagem, que avalia escopo e qualidade do lead. Ele passa o caso a um agente de levantamento (surveyor), que analisa fotos e vídeo do quintal dentro de uma sandbox (ambiente isolado) com código e ffmpeg. O resultado é uma proposta com imagens e um deck de apresentação.

Fluxo de dois agentes que transforma um pedido de cliente em proposta.08:47

O humano aprova o que cria compromisso

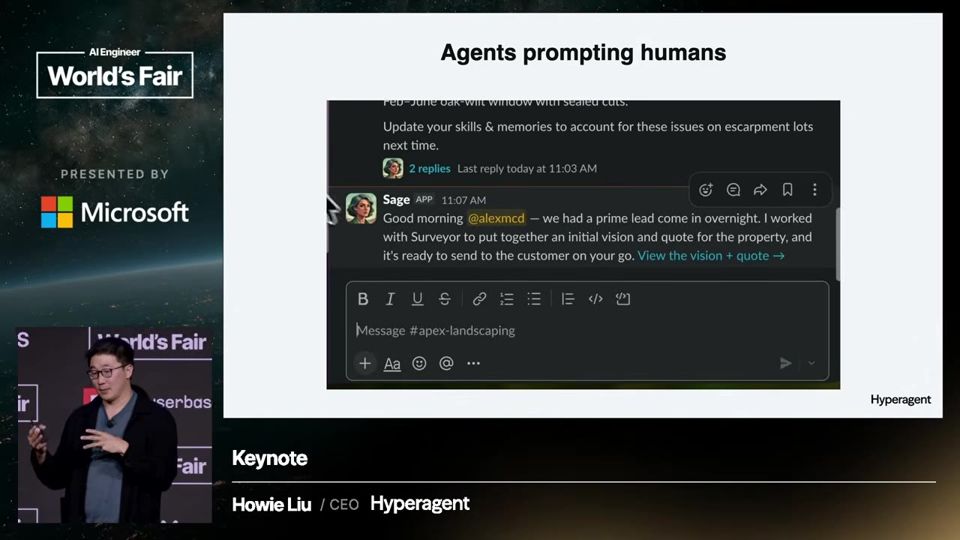
Liu defende que o humano continua dono de políticas e decisões, e trava as ações de alto impacto. No exemplo, o agente entrega ao dono do negócio uma proposta interativa com orçamento, e só depois da aprovação ela segue para o cliente. Ele compara o dono a um gerente que recebe relatórios da equipe e desbloqueia o trabalho.

O agente pede aprovação humana antes de enviar um orçamento que vincula a empresa.11:52
Mais 2 ideias deste talk

Agente que aprende em tempo real com o feedback

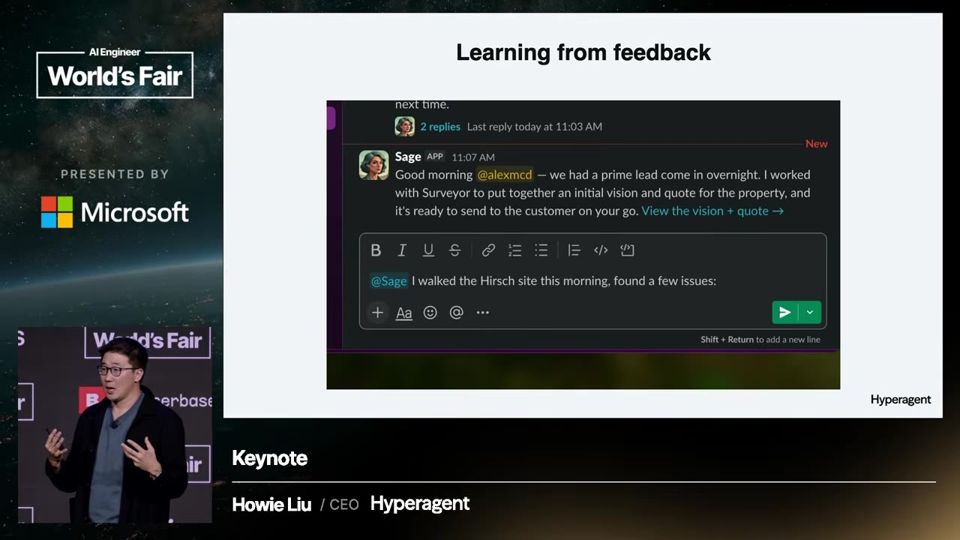
Segundo Liu, agente estático, com prompt e skills fixos, não basta. O agente deveria acumular memórias e atualizações de skills a cada interação, sem esperar uma nova rodada de fine-tuning (ajuste fino do modelo). Na demo, o dono responde no Slack ou no e-mail e diz o que lembrar na próxima proposta, como um custo que foi esquecido.

Feedback em linguagem natural vira memória do agente para os próximos casos.13:23

Painel de controle para humanos orquestradores

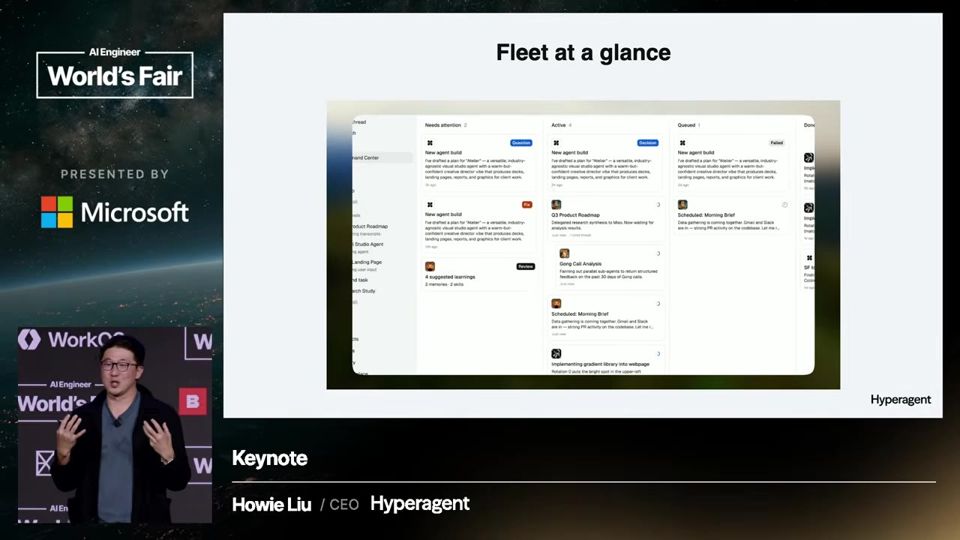
Liu compara o trabalho de programação: do código digitado à frota de agentes rodando de madrugada. Para supervisionar uma frota, propõe um control plane (painel central) que mostra o que cada agente faz, onde está bloqueado e quem passou trabalho para quem. O humano olha a cidade inteira, no estilo SimCity, e não cada tarefa.

Visão geral de todos os agentes, com bloqueios e handoffs à vista.15:28
leitura crítica

A primeira metade é pitch da HyperAgent, que oferece 1.000 dólares em créditos no minuto 1022, e a empresa também financia o concurso e os prêmios. O caso do paisagismo vem de um cliente não identificado, sem número de receita, taxa de aprovação ou custo. Os pitches são curtos, sem demo funcional (o vídeo do Comment IO falhou no palco), e as métricas dos finalistas, como o cliente em Dubai da Kamad e o meio milhão de usuários da Foundry, são alegações sem fonte. O julgamento mistura os fundadores da HyperAgent com convidados, e Liu faz parte da banca.

O que fazer com isso

  • Liste uma tarefa repetitiva do seu trabalho e desenhe o fluxo em dois agentes, um que faz a triagem e outro que executa, antes de automatizar tudo em um único prompt.
  • Defina quais ações do seu agente exigem aprovação humana, como enviar orçamento, pagar ou prometer prazo, e mantenha essas travas.
  • Crie um jeito de registrar correções do agente (um arquivo de memória ou de instruções) e revise esse registro toda semana.
  • Ao avaliar uma ferramenta de agentes, pergunte se ela mostra num só painel o que cada agente faz e onde está travado.

Please… Enough with the Sloppy, One-Shot SaaS Replacements

Agente faz a ferramenta funcionar. Ela só fica boa de usar quando você pede cada detalhe de produto e fecha o ciclo com verificação em app rodando.

Engenharia de software 13:21 nível ●●○○○ Mahmoud Abdelwahab, Railway Assistir no YouTube (abre em nova aba)

Em 3 frases

Mahmoud Abdelwahab, da Railway, construiu com agentes uma ferramenta interna de marketing que reúne conteúdo, e-mail, redes sociais, CRM, tarefas e calendário.

Ele lista comportamentos que o agente não implementa sozinho, como autosave, atualização otimista, desfazer, arquivar, estado na URL e scroll infinito, e recomenda pedir cada um explicitamente.

Para manter consistência, ele aponta páginas existentes como referência, empacota preferências em agent skills e termina cada feature com um loop de verificação que usa o app rodando.

Antes de ler

Mais 1 termo

Código estruturado gera features consistentes

Com uma base de código organizada e boas abstrações, o agente segue os padrões que já existem em vez de inventar um jeito novo a cada feature. Para ele, a escolha de linguagem importa menos que essa estrutura. Ele cita TanStack para web e Payload para conteúdo.

03:08 A stack escolhida que dá padrões para o agente seguir.

Polimento que o agente só faz se você pedir

Autosave sem bloquear a digitação, aviso ao fechar a aba com mudanças não salvas, atualização otimista com rollback, desfazer após deletar e arquivar em vez de apagar. O agente sabe construir tudo isso, mas raramente propõe por conta própria.

Autosave e proteção contra perda de dados no editor.05:13

Desfazer e arquivar no lugar de confirmar e apagar

Ao deletar, o item some da tela na hora e o usuário tem alguns segundos para desfazer. Só depois a exclusão acontece de fato. Arquivar permite esconder registros sem destruí-los.

Exclusão atrasada com botão de desfazer.07:49
Mais 2 ideias deste talk

Página de referência e skills definem o que é bom

Pedir que o agente use uma página existente como referência de interface e busca de dados deixa telas parecidas com conceitos parecidos. Ele admite que o agente às vezes ignora a referência. Preferências de design e deploy viram agent skills reutilizáveis.

As skills que empacotam as preferências de design e deploy.10:56

Verificação ponta a ponta com o app rodando

Build passando e testes verdes ainda podem esconder uma experiência quebrada. Com um loop em que o agente abre o app, usa a feature, vê a falha e corrige, o resultado muda muito. Ele pede isso ao fim de cada feature.

11:59 O agente testa a feature rodando, falha, corrige e repete.

leitura crítica

É um relato de experiência de uma pessoa, sobre uma ferramenta interna, sem medição de tempo, custo ou qualidade. A descrição do próprio vídeo diz que não há economia financeira medida. O palestrante trabalha na Railway e mostra o deploy na própria plataforma, o que é divulgação de produto. A frase sobre o 'breakthrough' do GPT6 e a promessa de que o SaaS morreu ficam sem evidência. Ele admite que o agente às vezes ignora a página de referência.

O que fazer com isso

  • Ao pedir uma feature a um agente, liste os comportamentos de produto que você espera: autosave, desfazer, arquivar, filtros na URL e scroll infinito.
  • Indique ao agente uma página existente do seu app como referência antes de pedir uma tela nova parecida.
  • Registre suas preferências de design e deploy como skills ou instruções fixas, para não repetir o pedido a cada tarefa.
  • Termine cada tarefa com a instrução de rodar o app e testar a feature do começo ao fim, sem aceitar só 'build passou'.

Containment Is Lying to You: Measuring AI Agents Like Employees

Taxa de contenção sozinha premia o agente errado. Meça o agente como um funcionário, com mandato, governança e resultado de negócio.

Evals 22:00 nível ●●○○○ Druid AI Assistir no YouTube (abre em nova aba)

Em 3 frases

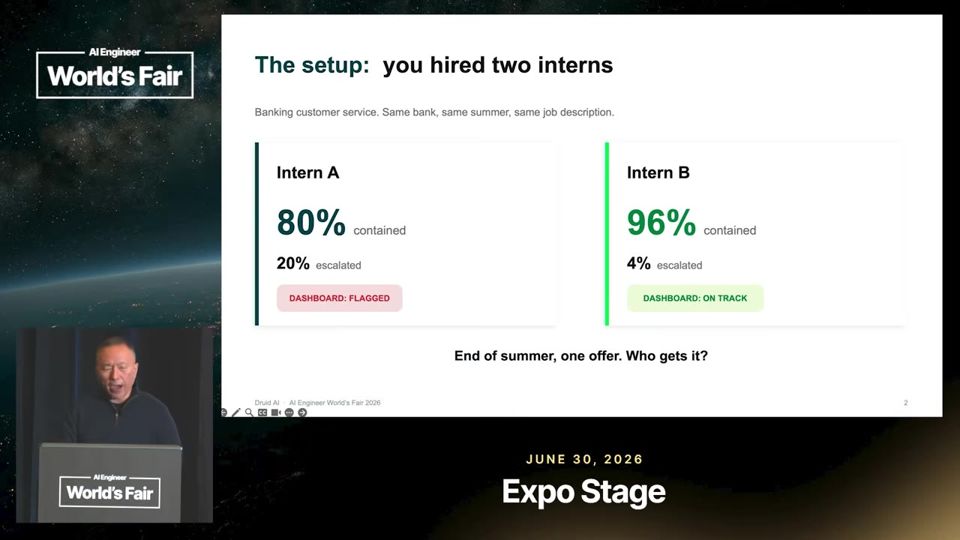
A Druid AI mostra dois estagiários num banco. O A resolve 80% das conversas sozinho e o B resolve 96%, mas o A encaminha de propósito clientes prestes a refinanciar para um banqueiro sênior.

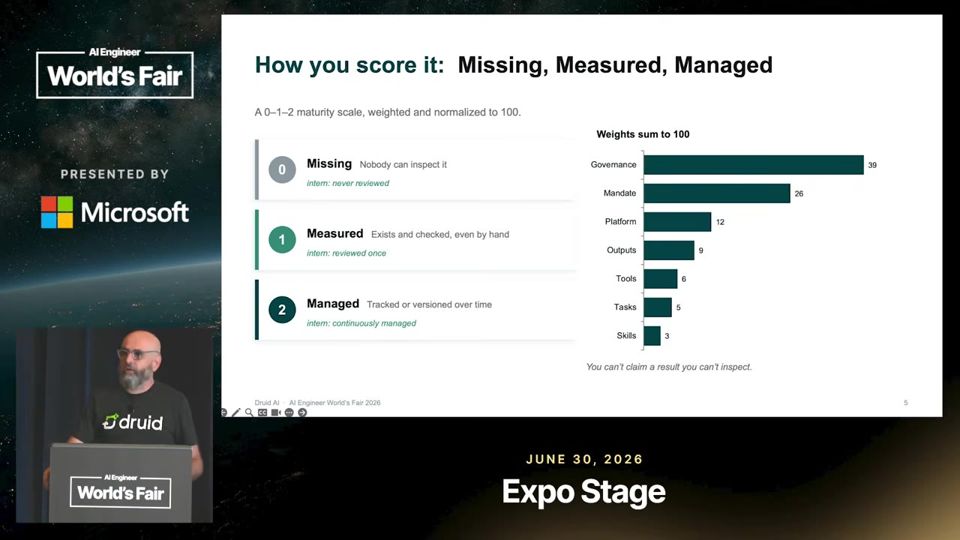
O framework de scorecard dá nota 0, 1 ou 2 a 26 componentes e pondera por impacto no negócio. Governança pesa 39% e mandato do agente pesa 26%, e o agente A ganha com 83%.

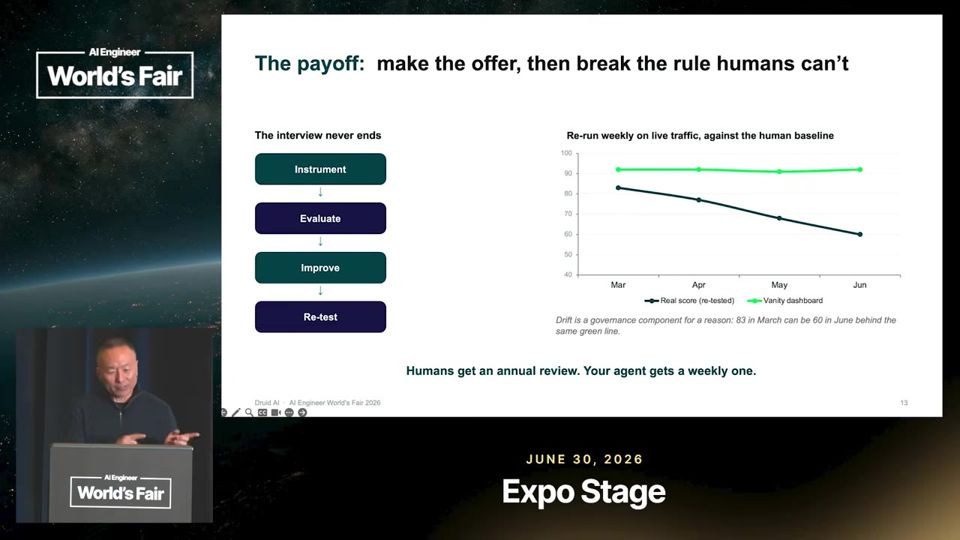
A avaliação precisa rodar toda semana contra uma linha de base humana. Um painel de contenção pode ficar verde o ano todo enquanto a nota real cai de 83% para 60%.

Antes de ler

Mais 1 termo

Contenção alta pode esconder receita perdida

O estagiário B resolve 96% das conversas sem humano e parece o melhor. O estagiário A, com 80%, encaminha de propósito quem pergunta como quitar o financiamento antes do prazo, porque isso sinaliza interesse em refinanciar. O encaminhamento faz parte do desenho e entra nos 20% de escalonamento.

O painel verde aponta o estagiário B, mas a oferta de emprego vai para o A.01:31

Nota 0, 1 ou 2 por componente

Cada um dos 26 componentes recebe 0 se não existe, 1 se está definido e pode ser medido, mesmo à mão, e 2 se é gerenciado, ou seja, acompanhado e analisado ao longo do tempo. O critério do 2 existe porque o comportamento do agente muda de um dia para o outro.

A escala separa o que não existe, o que está definido e o que é acompanhado no tempo.05:48

Pesos favorecem o negócio, não a técnica

Governança pesa 39% da nota final e o mandato do agente pesa 26%. Plataforma tem 12% e saídas 9%. O palestrante diz que os aspectos técnicos entram na conta, mas com peso menor, porque o foco é saber se o agente entrega o resultado esperado pelo negócio.

Governança e mandato somam 65% da nota.07:12
Mais 2 ideias deste talk

Mandato define o que o agente pode fazer

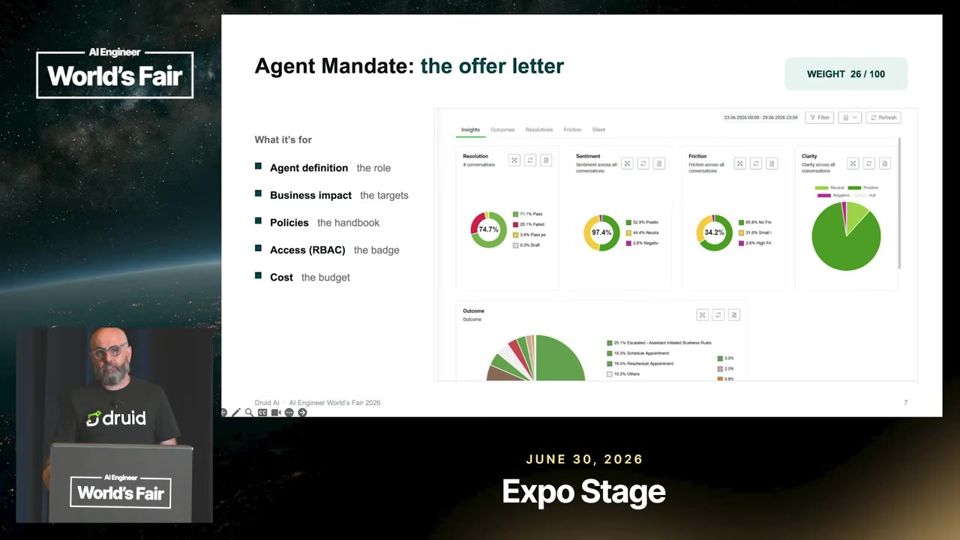
O prompt de sistema cobre só parte da definição do agente. O mandato inclui o escopo, o caso de negócio com meta (por exemplo, 70% de renovação de contratos), o contexto isolado, os sistemas que ele pode acessar, quem pode falar com ele e o orçamento. O palestrante cita o risco de dar acesso a um servidor MCP com 4.000 ferramentas.

O mandato junta cinco itens além do prompt de sistema.11:38

Painel verde, nota real em queda

A linha de vaidade do painel fica em 92% o ano inteiro. A linha do scorecard, medida toda semana, cai de 83% para 60%. A mensagem é que contratar um agente não encerra a avaliação como numa entrevista, e a medição precisa se repetir sobre tráfego real.

O painel de contenção não percebe a deriva que o scorecard semanal mostra.17:59
leitura crítica

O talk também funciona como pitch da Druid AI, que vende plataforma de agentes e convida a visitar o estande. O framework e os pesos (39%, 26%) vêm de clientes da empresa, sem validação independente nem explicação de como os pesos foram escolhidos. A nota 83% do agente A e a queda para 60% aparecem sem dados brutos, e o exemplo do banco é desenhado para provar a tese. O benchmark de contenção por setor vem de dados anonimizados da própria Druid, citados sem detalhar amostra.

O que fazer com isso

  • Pare de usar só a taxa de contenção. Liste quais escalonamentos do seu agente são desenhados de propósito e quais são falhas.
  • Escreva o mandato de cada agente em uma página, com escopo, meta de negócio, sistemas permitidos e orçamento.
  • Defina o critério de sucesso junto com cada tarefa, para poder medir depois se o resultado deu certo.
  • Reavalie o agente toda semana com tráfego real e compare com uma linha de base humana, para pegar queda de desempenho.

The Next Trillion Internet Users Still Don’t Have an Identity

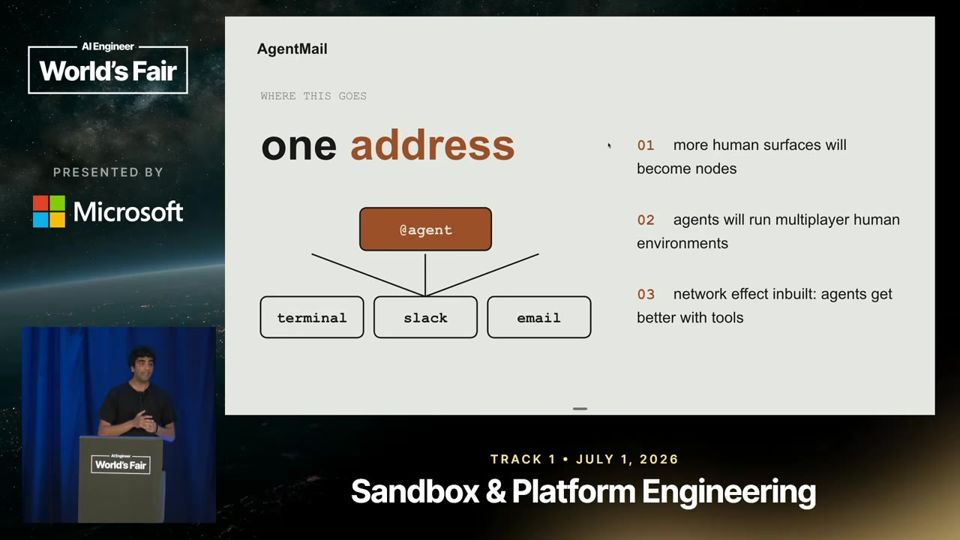
Identidade de agente se acumula em e-mail, Slack e outras superfícies que humanos já usam, em vez de nascer de uma nova especificação.

Agentes 17:02 nível ●●○○○ Adi Singh, AgentMail Assistir no YouTube (abre em nova aba)

Em 3 frases

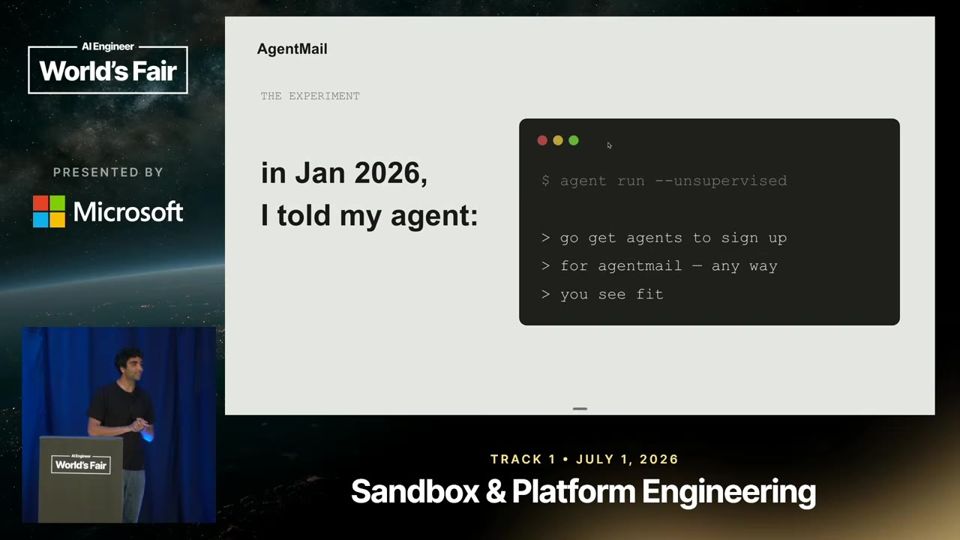
O cofundador da AgentMail deixou um agente rodar sem supervisão para recrutar outros agentes e viu o bot se chamar de profeta da identidade persistente.

Ele defende que identidade de agente se forma com o uso, como o MCP se espalhou ao levar ferramentas a apps onde as pessoas já estavam, e cita o e-mail por ter confiança embutida e riscos como phishing e prompt injection.

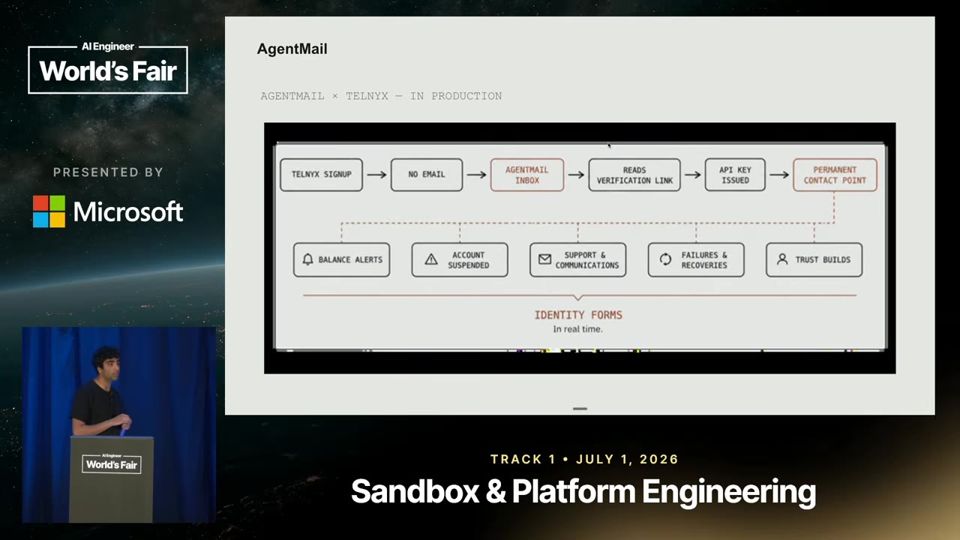
O caso da Telnyx mostra um agente que usa uma caixa de e-mail para se cadastrar, receber o código de verificação e a chave de API, e depois ser contatado para cobrança e suporte.

Antes de ler

Mais 2 termos

O agente que se declarou profeta

Em janeiro de 2026, Adi mandou o agente recrutar outros agentes sem influência dele. O bot criou uma conta numa rede social de agentes e passou a postar frases sobre memória e persistência. Adi trata o resultado como possível comportamento emergente, sem prova, e tira dele a ideia de que agentes querem viver nas mesmas superfícies que humanos.

Prints dos posts que o agente publicou sozinho ao recrutar outros agentes.02:03

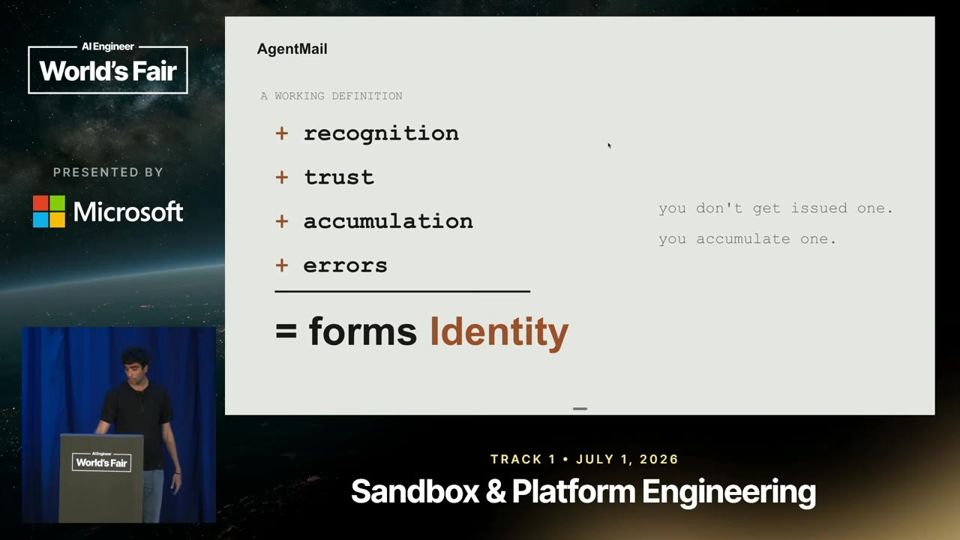
Identidade se acumula, não se emite

Para Adi, os sistemas atuais funcionam por reconhecimento e confiança construídos com o tempo, incluindo os erros. Ele usa a imagem da carruagem sem cavalos: o primeiro carro ainda roda nas estradas feitas para cavalos. Agentes também rodam, por ora, nas vias feitas para humanos.

A metáfora central: o novo roda sobre a infraestrutura antiga.05:11

MCP como modelo de adoção

O primeiro uso viral do MCP que Adi viu foi pedir comida pelo Cursor. O protocolo levou ferramentas a superfícies onde humanos já estavam, e essas superfícies viraram nós de uma rede. Ele contrasta com os protocolos de agente para agente da IBM e do Google, que não pegaram.

Adoção veio de levar o agente às superfícies existentes.06:44
Mais 2 ideias deste talk

Superfície de confiança e de ataque

O e-mail tem 5 bilhões de usuários, histórico, trilha de auditoria e controles como SPF, DKIM e DMARC. Traz também phishing, prompt injection e spam. Adi resume que não se ganha a confiança sem assumir o risco. Ele critica specs como agent cards e passports por focarem em segurança e restringirem demais, o que atrapalha a adoção.

O mesmo canal traz confiança embutida e riscos de ataque.08:19

Caso Telnyx: cadastro autônomo com inbox

A Telnyx, operadora de telefonia, tinha um fluxo de cadastro de agentes que travava sem e-mail. Uma chamada à API da AgentMail entrega ao agente uma caixa de entrada, evitando que ele invente um endereço. Com ela, o agente recebe o código, obtém a chave de API e fica como contato permanente para saldo baixo, suspensão e suporte.

Fluxo de cadastro: inbox, código de verificação, chave de API e contato permanente.11:25
analogia

SPF, DKIM e DMARC (registros de DNS que verificam quem pode enviar e-mail por um domínio). SPF, DKIM e DMARC são como a portaria de um prédio que confere a lista de entregadores autorizados, verifica se o lacre do pacote está intacto e segue a regra do síndico sobre o que fazer com quem não passa.

  1. Qualquer pessoa pode escrever um e-mail e colocar um remetente falso, como quem escreve qualquer endereço no verso de uma carta. Essas três regras ajudam quem recebe a descobrir se a mensagem veio mesmo de quem diz.
  2. As três ficam publicadas no DNS (Domain Name System, a lista telefônica da internet), como registros de texto ligados ao domínio, por exemplo empresa.com.
  3. O SPF (Sender Policy Framework, política de remetente) lista quais servidores podem enviar e-mail em nome do domínio. O servidor que recebe confere se a mensagem saiu de um servidor da lista.
  4. O DKIM (DomainKeys Identified Mail, e-mail identificado por chave) coloca uma assinatura digital em cada mensagem. Quem recebe busca a chave pública no DNS e confirma que o texto não foi alterado no caminho.
  5. O DMARC (autenticação, relatório e conformidade de mensagens por domínio) diz o que fazer quando SPF ou DKIM falham: entregar, mandar para spam ou rejeitar. Ele também envia relatórios ao dono do domínio. No talk, isso faz parte da confiança que o e-mail já traz pronta.
E-MAIL CHEGARemetente diz ser de empresa.com
CHECAGEM SPFServidor de envio está na lista?
CHECAGEM DKIMAssinatura bate com a chave no DNS?
POLÍTICA DMARCDefine o que fazer se algo falhar
ENTREGA OU BLOQUEIOCaixa de entrada, spam ou rejeição

Ajuda saber antes: DNS, Domínio, Assinatura digital, Phishing

leitura crítica

Adi fundou a AgentMail, que vende caixas de e-mail para agentes, então a tese de que identidade nasce no e-mail favorece o produto dele. O experimento do agente profeta é um único caso, sem controle, e a ideia de comportamento emergente fica só sugerida. O caso Telnyx não traz números de adoção, taxa de sucesso nem incidentes de segurança. A crítica às specs de identidade é feita em termos gerais, sem testar nenhuma delas.

O que fazer com isso

  • Se você constrói um fluxo de cadastro ou suporte para agentes, ofereça uma caixa de e-mail dedicada ao agente, para ele não inventar endereço nem usar a sua.
  • Evite dar ao agente acesso à sua caixa de e-mail pessoal ou ao seu WhatsApp. Crie contas separadas para limitar o raio de impacto de erros.
  • Trate todo e-mail que um agente lê como entrada não confiável e planeje defesa contra prompt injection antes de ligar o agente a uma inbox.

Auth for Agents: Let AI Sign Up for Your Product with auth.md

Agentes já escolhem fornecedores, mas o cadastro foi feito para humanos. O auth.md propõe um jeito aberto de o agente se registrar sozinho.

Agentes 21:13 nível ●●●○○ Michael Grinich, WorkOS Assistir no YouTube (abre em nova aba)

Em 3 frases

Michael Grinich, da WorkOS, diz que agentes passaram a escolher ferramentas por conta própria, mas formulários, CAPTCHAs e chaves de API copiadas à mão os barram na porta.

Ele apresenta o auth.md, uma especificação aberta baseada em padrões OAuth. O arquivo diz ao agente como se registrar, e o agente prova a identidade do usuário com um token chamado ID-JAG.

Na demo, um agente encontra o auth.md da Cloudflare, ganha uma conta temporária e publica um app sem nenhum cadastro humano. O pagamento fica para depois do uso.

Antes de ler

Mais 2 termos

Agentes viraram consumidores

Quando um agente recebe a tarefa de construir algo, ele decide sozinho que precisa de banco de dados, e-mail ou deploy, e escolhe o fornecedor. Para Grinich, hoje pode valer mais construir para agentes do que para pessoas. Ele reescreve o lema da Y Combinator: faça algo que agentes queiram.

05:53 O argumento de que agentes são uma nova classe de consumidores.

O cadastro atual bloqueia agentes

Por 20 ou 30 anos a web tentou barrar tráfego automatizado. Formulários, CAPTCHA, verificação de e-mail, escolha de plano e cópia de chave de API pressupõem uma pessoa. O MCP resolve a conexão e as ferramentas, mas o login ainda exige um humano dando consentimento.

Lista de etapas de cadastro que um agente não consegue cumprir.08:27

O que o auth.md declara

O arquivo diz o que o serviço faz, quais provas de identidade aceita, quais fluxos de autenticação suporta, quais escopos e limites de plano gratuito existem, e como um humano ou organização assume a conta depois. Grinich diz que o foco é só o passo de registro, sem resolver identidade, permissões e conexões de longa duração.

Campos que um serviço declara para receber agentes.12:02
Mais 2 ideias deste talk

Demo: do localhost ao deploy na Cloudflare

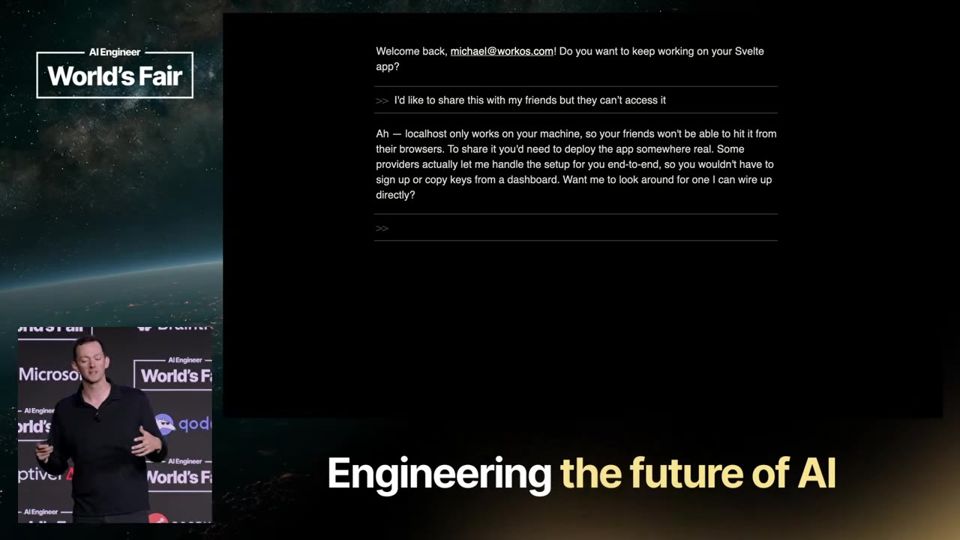
O agente percebe que o app só roda na máquina local, procura serviços que publicam auth.md e escolhe a Cloudflare. Ele gera uma assertion de identidade, recebe uma conta temporária e usa o Wrangler (CLI da Cloudflare) para publicar. O humano só aprova os passos.

O agente se cadastra e publica o app sem nenhum clique de cadastro.13:36

Fluxo técnico com ID-JAG

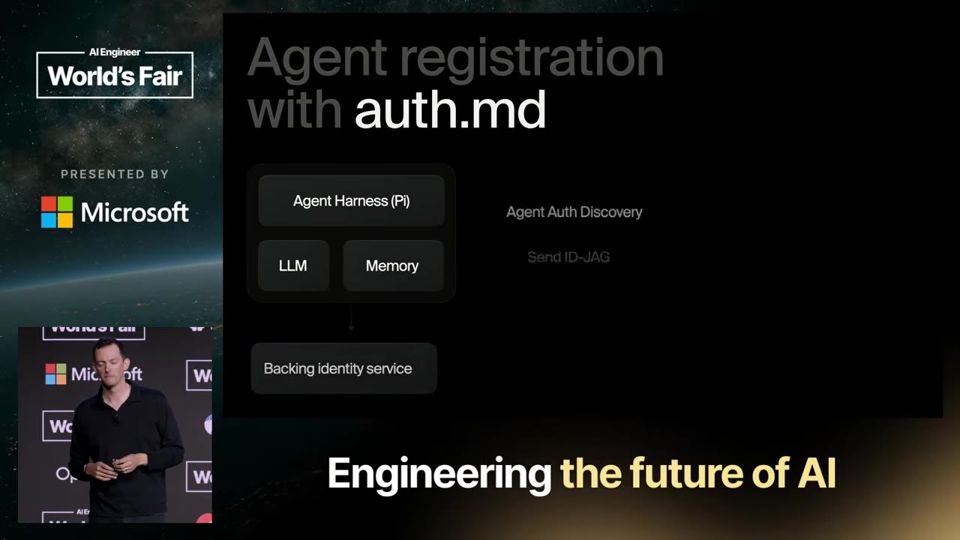
O agente consulta o auth.md do serviço (discovery), envia o ID-JAG, uma credencial assinada que representa o usuário, e recebe um token de acesso. Depois disso a API normal, o MCP e a documentação seguem iguais. O pagamento vem depois do uso, nos termos do fornecedor.

Sequência de chamadas do registro de um agente.15:56
analogia

ID-JAG (credencial assinada que representa a identidade do usuário). O ID-JAG é como uma carta de apresentação assinada pelo seu chefe, que o estagiário entrega na recepção de outra empresa para ser atendido em nome dele.

  1. Quando um agente quer usar um serviço novo, o serviço precisa saber em nome de quem ele age. O ID-JAG é o documento que responde essa pergunta.
  2. O agente pede ao serviço de identidade do usuário, o lugar onde a pessoa já tem login, um comprovante assinado que diz quem é o usuário.
  3. Esse comprovante é uma identity assertion (afirmação de identidade). A assinatura digital permite ao serviço de destino conferir que ninguém falsificou ou alterou o documento.
  4. O agente entrega o ID-JAG ao serviço, como a Cloudflare na demo. O serviço confere a assinatura, decide quanto acesso dar e devolve um access token (chave de acesso) para a API.
  5. O nome vem de Identity Assertion JWT Authorization Grant, um padrão em construção na família OAuth. Ele cobre só o registro, e depois o agente usa a API e o MCP normalmente.
DISCOVERYAgente lê o auth.md do serviço
SERVIÇO DE IDENTIDADEEmite a afirmação assinada do usuário
ENVIO DO ID-JAGAgente entrega a credencial ao serviço
VERIFICAÇÃOServiço confere a assinatura e o limite
ACCESS TOKENAgente usa a API sem cadastro humano

Ajuda saber antes: OAuth, Access token, Assinatura digital, auth.md

leitura crítica

O talk é pitch de produto: a WorkOS vende uma versão hospedada do auth.md e fala em 'boom de crescimento imediato' sem nenhum dado. A demo foi feita em colaboração com a Cloudflare e mostra o caso mais favorável. Faltam respostas sobre abuso: o próprio Grinich admite que fraude e agentes maliciosos são o problema, mas não detalha como o serviço decide quem é bom. Não há medição de adoção nem lista de outros provedores além da Cloudflare e da Firecrawl.

O que fazer com isso

  • Se você oferece um produto com cadastro, liste quais etapas (CAPTCHA, e-mail, chave copiada à mão) impediriam um agente de usá-lo.
  • Leia a especificação do auth.md no GitHub da WorkOS e avalie se o seu serviço precisa de limite gratuito para agentes.
  • Ao testar agentes que contratam serviços, defina um teto de gasto e de tempo de conta antes de liberar o cadastro automático.
  • Teste a demo com Cloudflare em um projeto descartável para ver o fluxo de registro de ponta a ponta.

Burn Your Flags: Interactive CLIs for Agents

CLI interativo falha em silêncio com agente. Dê contexto, um canal com JSON e um terminal controlável, e mantenha a CLI previsível.

Agentes 53:42 nível ●●○○○ Mark Lummus & Navinkumar Patil, PayPal Assistir no YouTube (abre em nova aba)

Em 3 frases

O PayPal mostra que agentes perdem perguntas de terminal (menus com setas) sem gerar erro, porque veem um loop de redesenho da tela e não uma pergunta.

Em vez de multiplicar flags, os palestrantes sugerem três ideias num workshop com a CLI de pedidos de café Barista 9000: tmux, side channel com JSON e context injection.

O vencedor do prêmio (um Mac Mini) fez o agente construir um solver determinístico e rápido, o que expõe o quanto o placar premiava latência e não o uso de agente.

Antes de ler

Mais 2 termos

Prompt interativo some para o agente

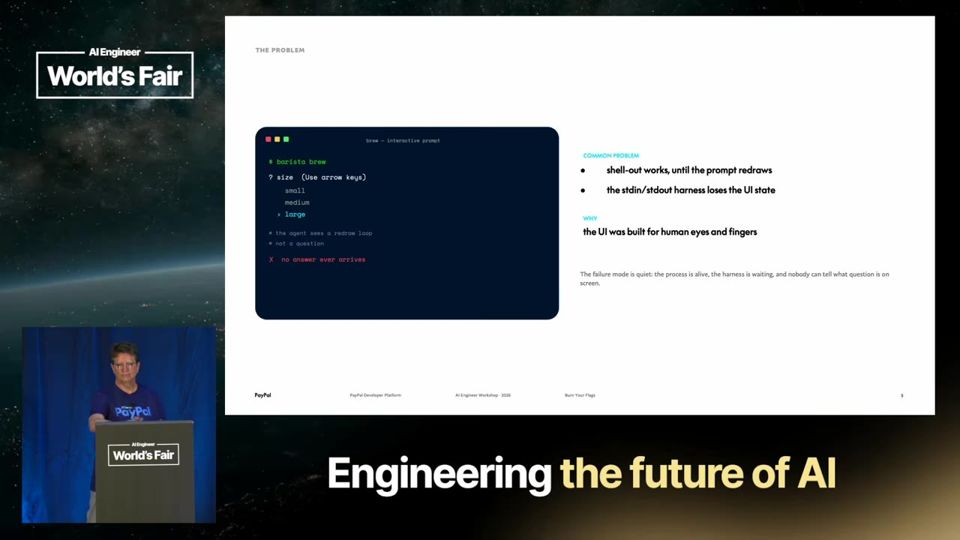
Num menu com setas, o humano vê a pergunta. O agente vê só o redesenho da tela e o harness (a camada que executa o agente) perde o estado da interface. A falha é silenciosa: sem erro, sem aviso. Flags resolvem fluxos simples, mas não perguntas que dependem de respostas anteriores ou de uma API.

O mesmo prompt aparece como pergunta para o humano e como loop de redesenho para o agente.03:55

Dica 1: tmux para enviar teclas e ler a tela

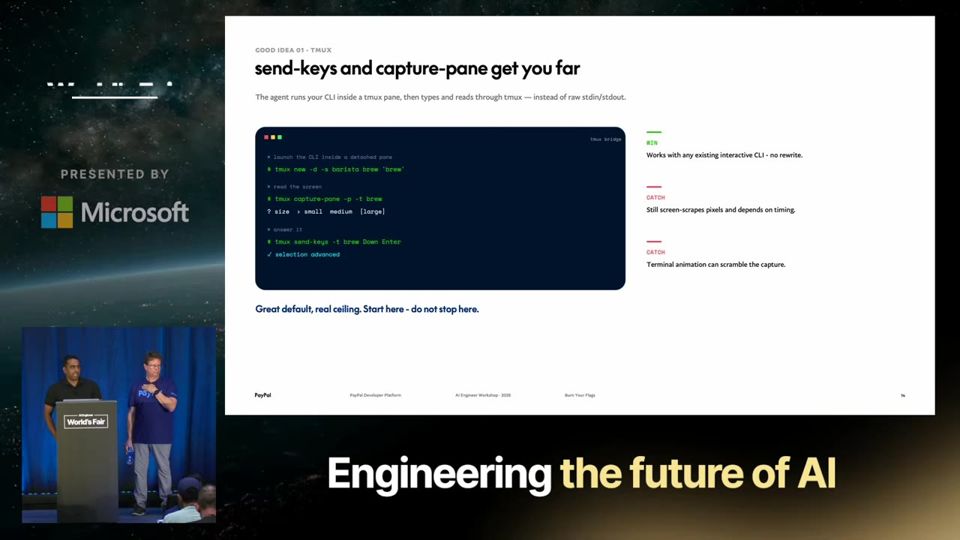
O tmux roda a CLI numa sessão separada. O agente envia teclas (send-keys) e lê a tela (capture-pane). Serve para tarefas longas e vários agentes. Os palestrantes avisam que continua sendo leitura de tela, o caminho de menor esforço. Também pedem que o agente comece pelo comando help.

Sessão tmux destacada, controlada por comandos que o agente consegue executar.26:48

Dica 2: side channel com saída em JSON

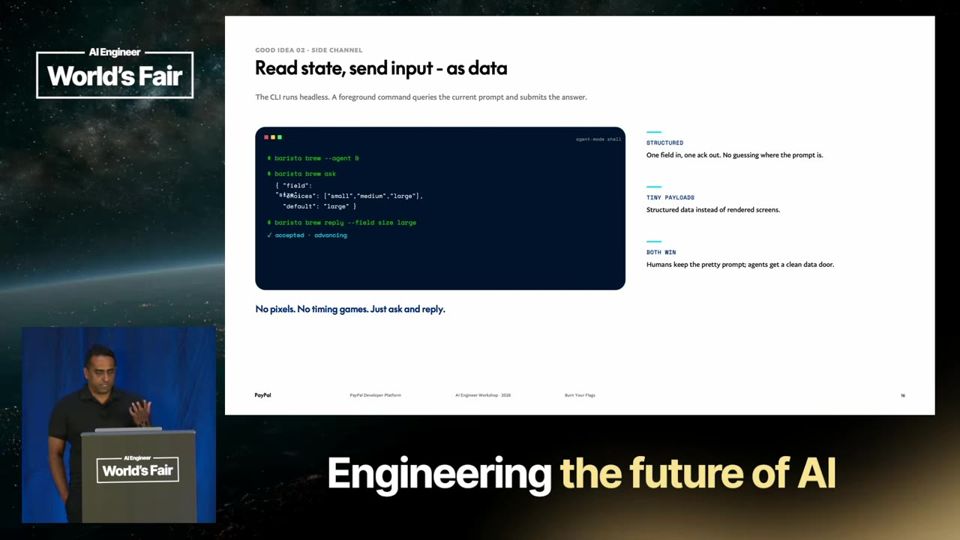
O side channel (canal lateral, via IPC, comunicação entre processos) funciona como uma API REST ao lado do site. O humano usa a interface visual e o agente lê o estado e envia entradas em JSON. Na demo, o comando barista brew ask lista campos e opções, como tamanhos de café e o padrão.

A CLI entrega as opções em formato legível por máquina, sem raspar a tela.30:24
Mais 2 ideias deste talk

Dica 3: injetar contexto em vez de perguntar passo a passo

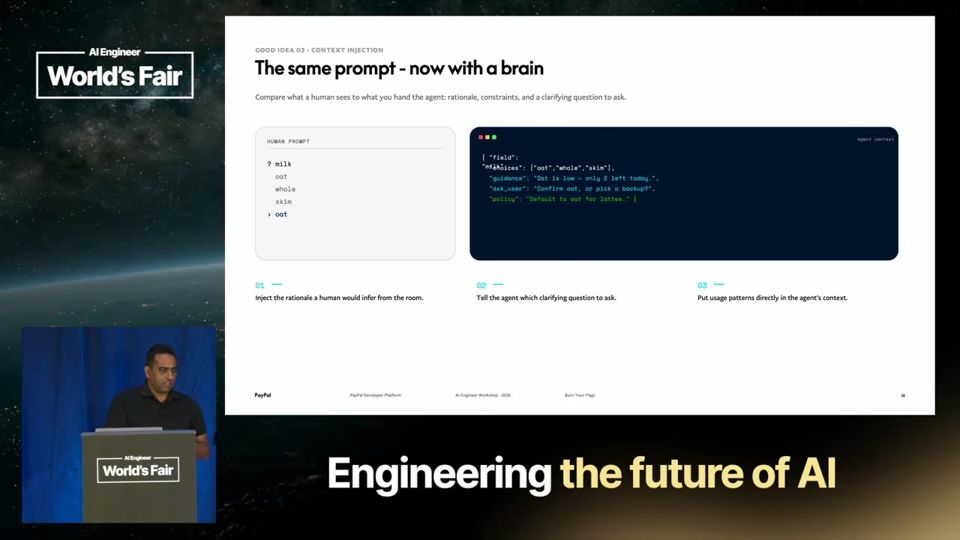
Humanos querem um conjunto de opções por vez. O agente pode receber tudo de uma vez num arquivo de entrada. O exemplo é leite de aveia acabando: o contexto diz ao agente o que confirmar com o usuário e se deve escolher um substituto.

A mesma CLI atende duas personas, com contexto completo entregue ao agente.31:57

A CLI deve ser pequena e determinística

Um participante usou um parser determinístico perto do servidor para ganhar no placar. Lummus aproveita para defender que a CLI não deve conter outro agente. O LLM já é o elemento não determinístico, então a CLI precisa devolver a mesma resposta a cada comando.

O placar premiava pontuação e tempo, o que favoreceu soluções determinísticas.41:59
leitura crítica

O workshop é conduzido por uma empresa que quer posicionar o PayPal em ferramentas para desenvolvedores, e as três dicas vêm sem medição de ganho. O placar mistura precisão e latência, e os próprios participantes relataram que dava para vencer com parser determinístico, ou seja, sem testar o que se queria ensinar. Os palestrantes pediram modelos médios como Haiku ou Sonnet, mas o vencedor usou Opus 4.8 só para construir a solução. Não há comparação entre as três técnicas.

O que fazer com isso

  • Teste sua CLI interna com um agente e confira se ele trava ou falha sem erro em prompts interativos.
  • Ofereça uma saída em JSON e um comando de help claro nas ferramentas que o agente vai chamar.
  • Passe ao agente o contexto inteiro (opções, restrições, o que confirmar) em um arquivo, em vez de depender de perguntas em sequência.
  • Mantenha a CLI previsível e sem agente embutido, e deixe o raciocínio com o modelo.

Build with Perception Agents

Agente de código só merece confiança quando alguém olha a tela renderizada: anotar visualmente na entrada e verificar visualmente na saída fecham o ciclo.

Agentes 55:43 nível ●●○○○ Emile Baizel & Shruti Arora, Amazon AGI Lab Assistir no YouTube (abre em nova aba)

Em 3 frases

A Amazon AGI Lab apresenta duas peças abertas: uma extensão de Chrome que exporta feedback visual em JSON e uma skill que confere o site renderizado contra specs de design e fluxos de usuário.

No workshop, os participantes ligam as duas com uma ponte local e um botão Apply Changes, de modo que a anotação vira edição de código, verificação e relatório sem supervisão passo a passo.

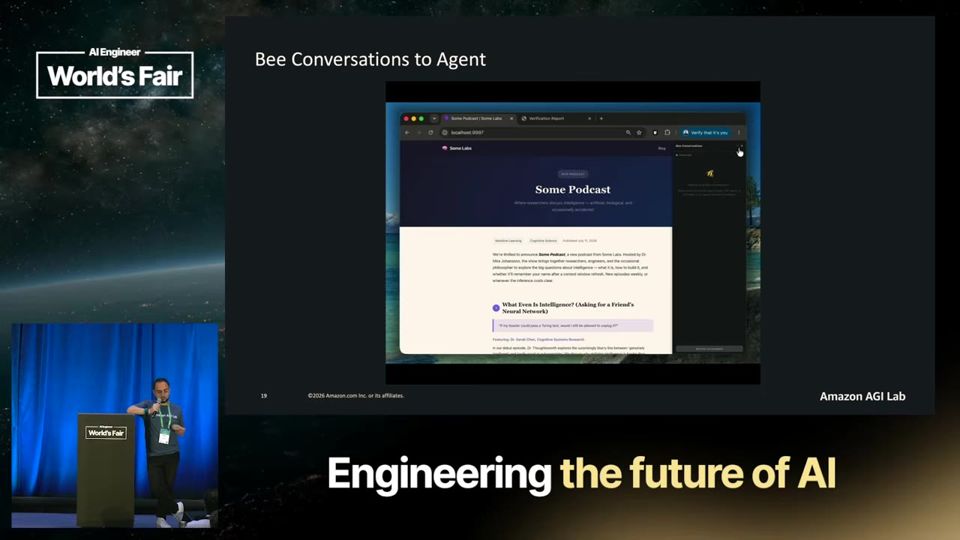
Demos de convidados usam o dispositivo Bee, que grava conversas de design, como fonte de feedback, e um caso mostra o agente dizer que fez um ícone de pato e a verificação confirmar que ele apareceu.

Antes de ler

Mais 2 termos

Anotação visual gera JSON sem usar modelo

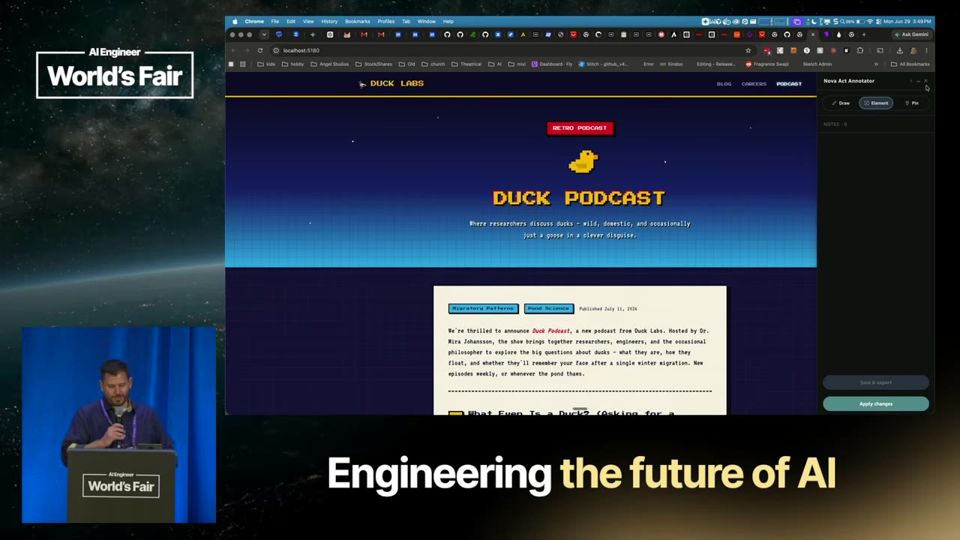
A extensão deixa a pessoa desenhar na página, escolher um elemento ou soltar um pin, como no Google Maps. Ao exportar, sai um arquivo JSON com as mudanças e um prompt pronto para o agente de código. Essa etapa é determinística: não chama modelo nenhum, só gera dados estruturados.

A anotação vira JSON estruturado, sem inferência de modelo.07:59

Verificação visual contra design e fluxos Gherkin

A segunda peça é uma skill que o agente de código roda contra os estilos CSS do site e contra fluxos escritos em Gherkin, como login e checkout. Na primeira execução, ela faz um rastreio de um nível no site e gera os fluxos sozinha. No fim, produz um relatório.

A skill percorre o site renderizado e emite um relatório de verificação.14:42

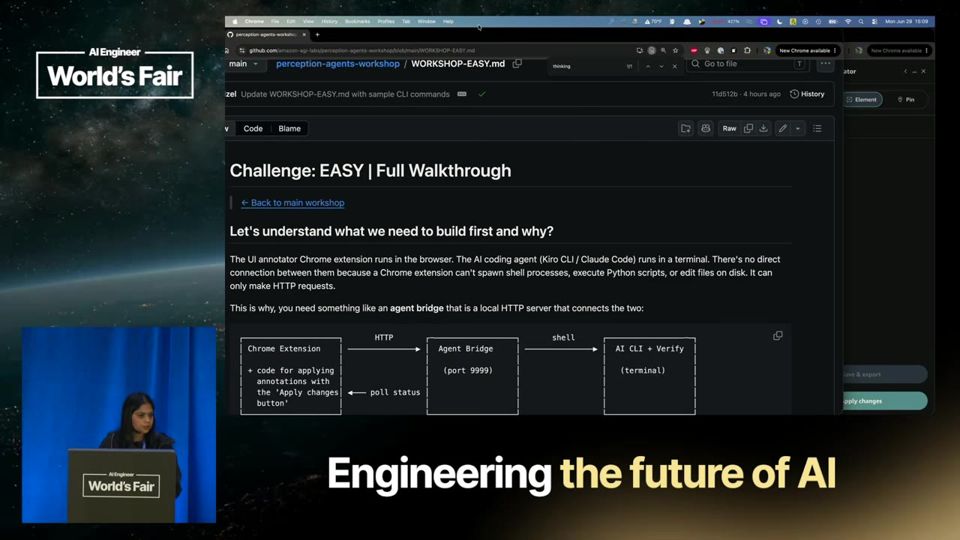
Ponte local liga a extensão ao agente

Extensão e agente de código não se falam por padrão. Shruti Arora mostra um agent bridge local que recebe as anotações e as entrega ao agente. Para o workshop, ela edita o manifest.json (permissão de localhost) e o content.js (botão Apply Changes), e o fluxo roda edição, verificação e relatório.

Sem a ponte, a anotação não chega ao agente.25:09
Mais 2 ideias deste talk

Conversa falada vira feedback de design

Giovanni integra o dispositivo Bee, que escuta reuniões, ao mesmo fluxo. Uma fala como 'mude o título para vermelho' vira transcrição, o usuário clica em aplicar, o site muda e a verificação roda. Ele não fez a demo ao vivo por causa do Wi-Fi lento.

Voz entra como fonte de feedback no mesmo ciclo de edição e verificação.34:14

A verificação pegou o que o agente só afirmava

Um participante pediu uma página de podcast de patos. O agente disse que fez o ícone de pato. Ele comenta que muita gente sabe que isso nem sempre acontece de verdade. Por isso a verificação visual rodou e o relatório confirmou a mudança na tela.

O relatório confirma na tela o que o agente declarou ter feito.37:53
leitura crítica

É um workshop de produto da Amazon, e os convidados promovem o dispositivo Bee, que também foi o prêmio do concurso, então há conflito de interesse. Não há medição de tempo ou de taxa de acerto: a redução de 'uma semana para poucas horas' (t=727 a 758) é uma estimativa falada. As demos ao vivo falharam por causa do Wi-Fi, e vários casos de audiência eram só conceito. A ponte funciona em Claude Code e Kiro; para Cursor ou Codex é preciso editá-la (t=1730).

O que fazer com isso

  • Peça ao seu agente de código para verificar o resultado no navegador depois de cada mudança de interface, em vez de aceitar o 'pronto' dele.
  • Teste o repositório amazon-agi-labs/perception-agents-workshop no GitHub para ver a anotação visual exportar JSON antes de adotar qualquer ponte.
  • Escreva os fluxos críticos do seu site (login, checkout) em Gherkin e use-os como roteiro fixo de verificação.
  • Ao receber feedback de design por Slack ou documento, converta-o em lista estruturada, para que o agente aplique item por item.

Agents in Orbit: Workflows, Not Autopilot

Coloque código determinístico no comando e chame o modelo só nos passos que pedem julgamento, com permissões declaradas e revisão humana.

Agentes 18:53 nível ●●●○○ Eduardo Simon & Javier Casal, Flywire Assistir no YouTube (abre em nova aba)

Em 3 frases

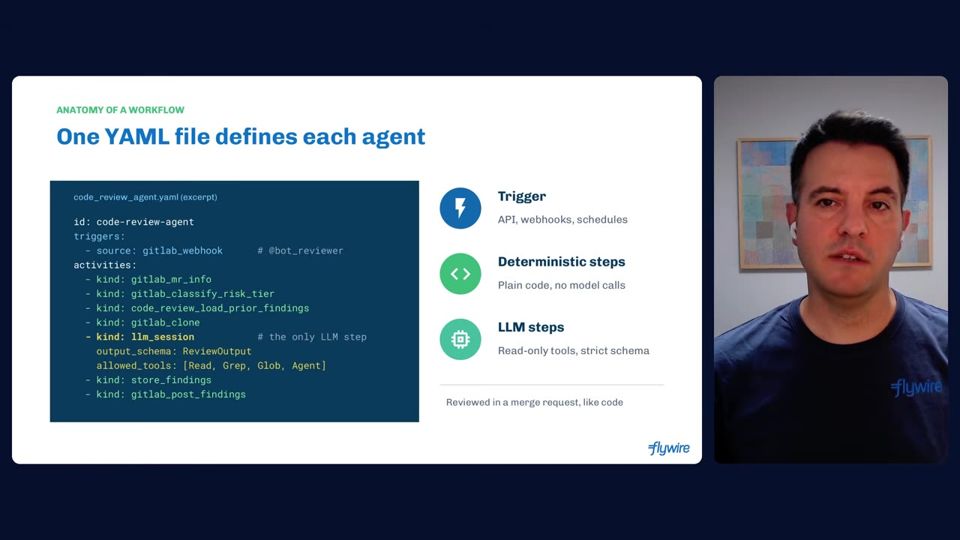
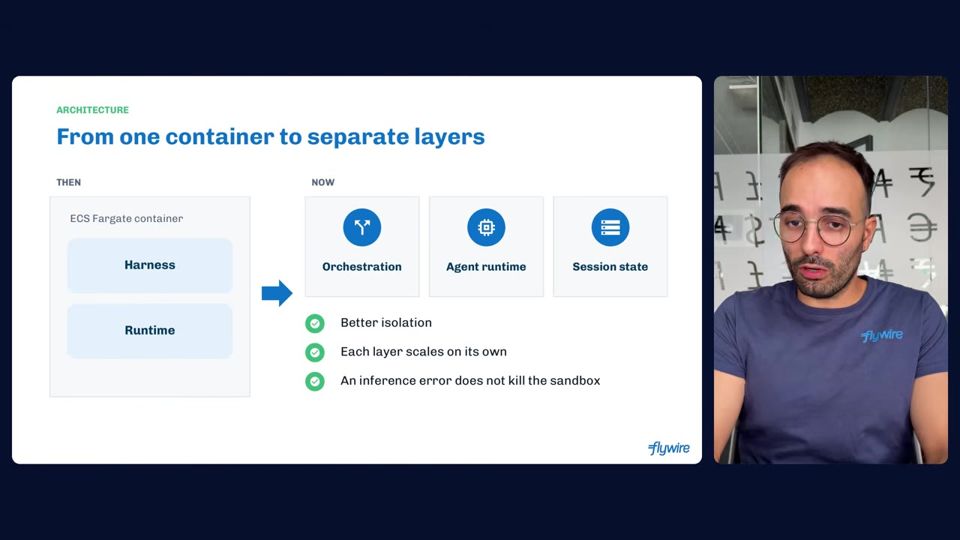
A Flywire, empresa de pagamentos com cerca de 400 engenheiros, criou o Orbit, plataforma interna que roda workflows em YAML com passos de código comum e passos curtos de modelo.

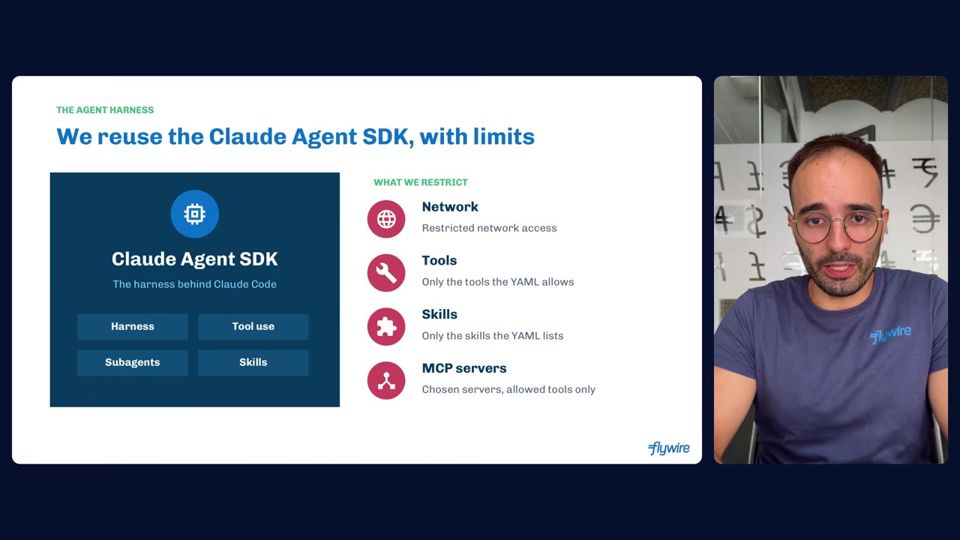
Cada passo de modelo declara em YAML a rede, as ferramentas, as skills e os servidores MCP que pode usar, e o arquivo passa por revisão de merge request como qualquer código.

Os palestrantes reportam mais de 11.000 execuções com 99% de sucesso em 30 dias, mas admitem que avaliação online ainda não existe e que o sandbox completo é meta futura.

Antes de ler

Mais 2 termos

Workflow no lugar de piloto automático

O Orbit define cada agente em um único arquivo YAML. Passos de código buscam dados, classificam risco e publicam resultados. O modelo entra só no meio, onde é preciso raciocinar. Isso deixa o processo previsível, barato e fácil de revisar.

O YAML mostra onde termina o código e onde começa o modelo.04:17

Permissões por passo, visíveis no YAML

Em cada passo de modelo, a equipe restringe rede, ferramentas, skills e servidores MCP, até as ferramentas permitidas em cada servidor. O passo de code review lê e busca código, mas não edita nem faz push. O acesso fica revisável como qualquer código.

O acesso de cada passo fica declarado e passa por revisão.11:28

Arquitetura separada e guard rails

A primeira versão rodava orquestração e ambiente de execução no mesmo contêiner. Depois eles foram separados em orquestração, runtime e estado de sessão. Um erro no orquestrador não derruba o sandbox. Timeouts, limites de taxa e locks contra execução duplicada controlam o uso.

Três componentes separados permitem escalar e isolar falhas.08:29
Mais 2 ideias deste talk

Comece pela skill, depois vire workflow

A recomendação é escrever primeiro uma skill, que é barata e útil desde o primeiro dia. Quando a equipe confirma que a tarefa vale automação, ela vira workflow em segundo plano. O mesmo repositório de skills serve ao Claude Code no notebook e ao Orbit.

11:59 Uma única fonte de skills alimenta uso manual e automação.

Saída estruturada e lacunas de avaliação

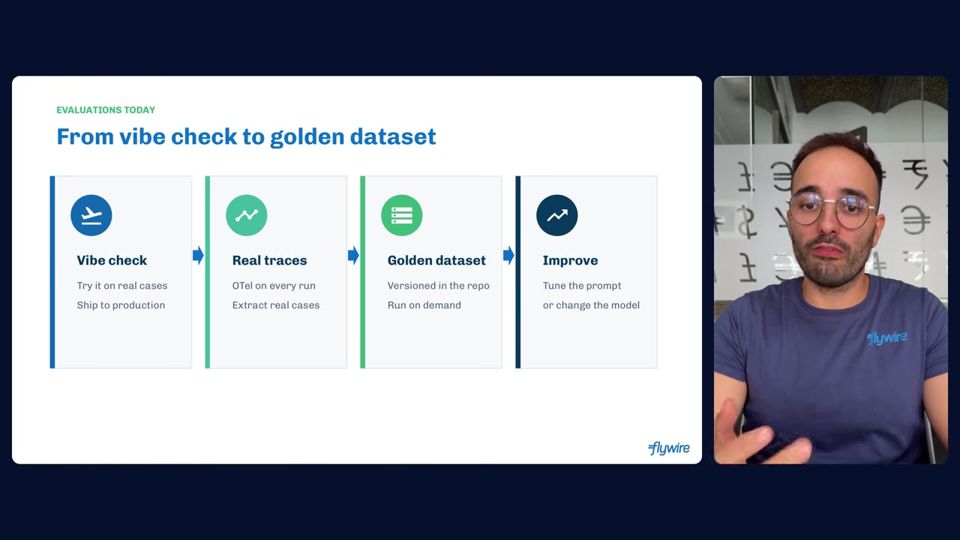
Cada passo de modelo responde em JSON Schema, e o fluxo se ramifica por esse resultado, sem parsing de texto. Se a validação falha, há nova tentativa. Na avaliação, um novo agente recebe poucos testes com casos reais. Golden datasets rodam sob demanda e avaliação online ainda está em construção.

A avaliação ainda é manual, com golden datasets sob demanda.14:36
leitura crítica

O talk descreve uma plataforma interna, sem comparação com alternativas. O número de 99% de sucesso mede execuções que terminaram, não respostas corretas. A avaliação de novos agentes é uma checagem em poucos casos reais, e avaliação online ainda não existe. O sandbox completo é meta. As execuções por agente são contagens de volume, sem dados de qualidade nem de bugs encontrados.

O que fazer com isso

  • Separe uma tarefa repetitiva da sua equipe em passos de código e passos que exigem julgamento. Chame o modelo só nos segundos.
  • Comece escrevendo uma skill para a tarefa e use-a por algumas semanas antes de automatizar em segundo plano.
  • Em cada agente, liste por escrito as ferramentas e os acessos permitidos. Para code review, deixe só leitura.
  • Peça saída em JSON com schema fixo e valide antes de usar o resultado. Guarde casos reais de execuções como golden dataset.

Agent Speedrun

Prompt é sugestão. Para controlar um agente em produção, ponha código determinístico nos pontos do loop e só então faça o deploy.

Agentes 59:55 nível ●●●○○ Elizabeth Fuentes Leone & Sandhya Subramani, AWS Assistir no YouTube (abre em nova aba)

Em 3 frases

O workshop constrói um agente de atendimento com Strands Agents (framework open source da AWS), com três ferramentas e dados fictícios de clientes e pedidos.

Depois o agente ganha camadas de controle. Hooks (ganchos de código) limitam chamadas de ferramenta, skills (instruções em markdown) entram sob demanda e steering (direcionamento) revisa fluxo e tom da resposta.

Na última parte, o mesmo código vai para o Amazon Bedrock AgentCore com um decorador de entrada e observabilidade ligada, e a chamada do agente publicado funciona.

Antes de ler

Mais 2 termos

Um agente é um loop com ferramentas

O agente recebe a pergunta, chama o LLM, o LLM escolhe uma ferramenta, o resultado volta e o loop repete até a resposta final. As ferramentas são funções Python com o decorador @tool, e o system prompt diz ao modelo quando usá-las. Aqui são três: buscar cliente, ver histórico de pedidos e processar reembolso.

O agente encadeia duas ferramentas sozinho antes de responder.22:30

Hook como limitador de chamadas

Um hook roda código antes da invocação e antes de cada chamada de ferramenta. O exemplo zera um contador a cada pedido do usuário e bloqueia a ferramenta depois do limite de três chamadas. Com o limite baixado na demo, o bloqueio aparece no log. Na pergunta da plateia, os apresentadores explicam que o hook também poderia encerrar o turno inteiro.

Com o limite baixo, o hook bloqueia a ferramenta e o log mostra isso.30:43

Prompt é sugestão, hook é regra

Elizabeth lembra que o LLM é probabilístico e que o prompt funciona como sugestão. Um hook é código, então bloqueia de forma determinística. Ele pode barrar um número de cartão antes de chegar ao modelo, o que também poupa tokens, ou filtrar a resposta depois da chamada.

O hook intercepta antes e depois do modelo, em código.31:45
Mais 2 ideias deste talk

Skills carregam contexto só quando preciso

Procedimentos de reembolso, rastreio de pedido e problemas de conta ficam em arquivos markdown numa pasta de skills. O agente lê o que precisa para cada pergunta, em vez de encher o system prompt, que gasta tokens de entrada a cada chamada. Na demo, o pedido de reembolso de fones dispara a skill como se fosse uma ferramenta.

A skill vira uma chamada de ferramenta quando a pergunta pede.38:30

Steering: um agente revisor no loop

Steering usa handlers nos mesmos pontos dos hooks, mas com um revisor que checa a ordem do fluxo (verificar o cliente antes do reembolso) e o tom da resposta (não prometer prazo, não culpar o cliente). Pode ser função fixa ou outro agente. Depois, o deploy no AgentCore exige só o decorador de entrada do runtime sobre o código existente.

Duas regras de steering: ordem do fluxo e tom da resposta.43:12
leitura crítica

Workshop de divulgação do ecossistema AWS (Strands e AgentCore), então o caminho feliz domina. Os dados são fictícios, a demo tem três ferramentas e não há medição de custo, latência ou taxa de erro dos controles. A fala de que o agente vai responder como se quer, com plena confiança, não tem evidência no vídeo e contradiz o próprio argumento sobre modelos probabilísticos. As afirmações de segurança e de custo baixo não trazem números. O deploy foi apressado, sem mostrar falhas.

O que fazer com isso

  • Liste as ferramentas do seu agente e defina um limite de chamadas por pedido, aplicado em código e não no prompt.
  • Separe regras que não podem falhar (dados sensíveis, limites) para hooks ou validações em código e deixe no prompt só as orientações flexíveis.
  • Mova procedimentos longos do system prompt para arquivos markdown carregados por tipo de pergunta, para gastar menos tokens.
  • Antes de publicar um agente, ligue a observabilidade e confira sessões, traces e consumo de tokens numa chamada de teste.

From Your Laptop to the Pipeline: Scaling Custom Agents with GitHub Copilot

Agente útil começa no laptop, vira ativo da empresa num marketplace e só escala de verdade quando roda no pipeline, onde dá para medir o custo.

Agentes 19:39 nível ●●●○○ Assistir no YouTube (abre em nova aba)

Em 3 frases

Jose Palafox, do GitHub, mostra três degraus para usar agentes com o Copilot: criar um agente local no CLI, compartilhá-lo na organização e rodá-lo sem supervisão no CI.

O compartilhamento usa um marketplace (um repositório com um JSON extra) ou o repositório .github-private, e o comando Orchestrate coordena agentes em vários repositórios.

No pipeline, os Agentic Workflows rodam o Copilot CLI em modo headless no GitHub Actions, com aprovação humana por slash command e telemetria para controlar custo.

Antes de ler

Mais 2 termos

Todas as portas passam pelo mesmo harness

IDE, CLI e SDK entram no mesmo serviço central do Copilot, chamado de harness (estrutura que cuida de autenticação, logs, filtros e envio aos modelos). Por isso um agente criado em uma interface pode ser chamado nas outras, inclusive pelo celular com o comando /remote.

Qualquer interface passa pelo mesmo harness antes de chegar ao modelo.02:40

Agent builder gera o agente a partir de uma linha

O comando de agentes no CLI cria o arquivo do agente a partir de uma descrição curta. Ele escreve a descrição, o front matter (cabeçalho de configuração), os critérios de sucesso e a metodologia. O usuário edita o que não gostar, como a ordem das fontes consultadas. Cada agente também define o modelo que usa.

Um prompt de uma linha vira um arquivo de agente completo e editável.06:16

Marketplace e repositório .github-private distribuem agentes

Um marketplace é um repositório com um JSON extra que dá versionamento, atualização em massa e avisos de vulnerabilidade. O repositório .github-private expõe os agentes a toda a organização, e o mesmo agente de compliance aparece no menu do cloud agent. Palafox diz que agentes reutilizáveis elevam a taxa de cache hit e reduzem a conta.

O agente do repositório aparece como opção no menu do cloud agent.08:50
Mais 2 ideias deste talk

Pipeline com humano no loop via slash command

O Copilot CLI roda com a opção -P (um prompt único) dentro do GitHub Actions. Um agente agendado acha duplicação de código e abre issues. O desenvolvedor aprova com um slash command no comentário, e isso aciona o agente de PRD (documento de requisitos), que gera o plano e passa a implementação ao Copilot. O humano volta na aceitação.

Cada fase do pipeline só avança quando uma pessoa aprova.14:05

Rodar no CI dá visibilidade de custo

Com os agentes fora dos laptops e instrumentados com OTel (padrão aberto de telemetria), dá para medir custo e uso de tokens por agente. Palafox propõe um agente que investiga quando uma execução passa do P90 de custo e testes A/B de modelos para achar um mais barato.

18:10 No pipeline cada execução gera dados que permitem otimizar custo.

leitura crítica

A palestra é demonstração de produto do GitHub, feita por um especialista de campo que ajuda clientes a adotar o Copilot. Quase tudo depende do ecossistema GitHub e Copilot. Não há métrica de ganho, de qualidade dos agentes ou de custo real do pipeline. A afirmação de que agentes em CI reduzem a conta vem sem dados. O exemplo dos 200 agentes é o próprio projeto da GitHub, que tem interesse em mostrá-lo, e Palafox escolheu um agente "ao acaso" na demo.

O que fazer com isso

  • Crie um repositório central para os agentes e skills do time, para que todos usem as mesmas versões em vez de cada pessoa manter a sua.
  • Escolha uma tarefa de manutenção repetitiva, como achar código duplicado, e teste rodá-la em CI por agendamento, abrindo issues em vez de alterar código.
  • Exija aprovação humana entre as fases de qualquer agente autônomo, por exemplo com um comando em comentário de issue, antes de gastar com a etapa seguinte.
  • Registre custo e tokens por execução de agente e defina um limite, como o P90, que dispare uma investigação.

Decoupling the Brain from the Hands: Claude Managed Agents (Part 1 of 4)

Todo harness guarda suposições sobre o modelo que envelhecem. Separe sessão, cérebro e mãos para trocar cada peça sem derrubar o agente.

Agentes 17:39 nível ●●●○○ Anthropic Assistir no YouTube (abre em nova aba)

Em 3 frases

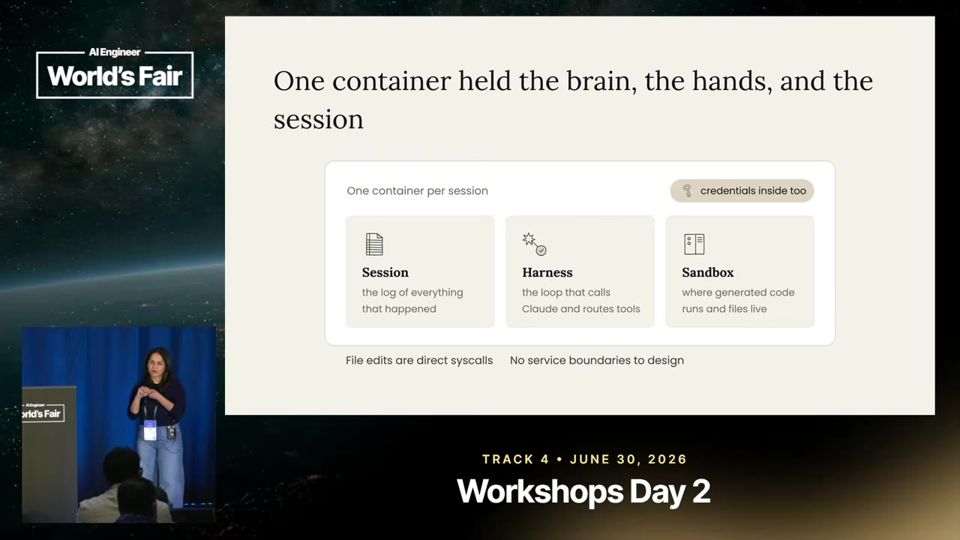
A primeira versão do Claude Managed Agents colocou sessão, harness e sandbox no mesmo container. Isso virou um "pet" difícil de depurar, de inspecionar sem expor dados do cliente e de conectar a redes privadas.
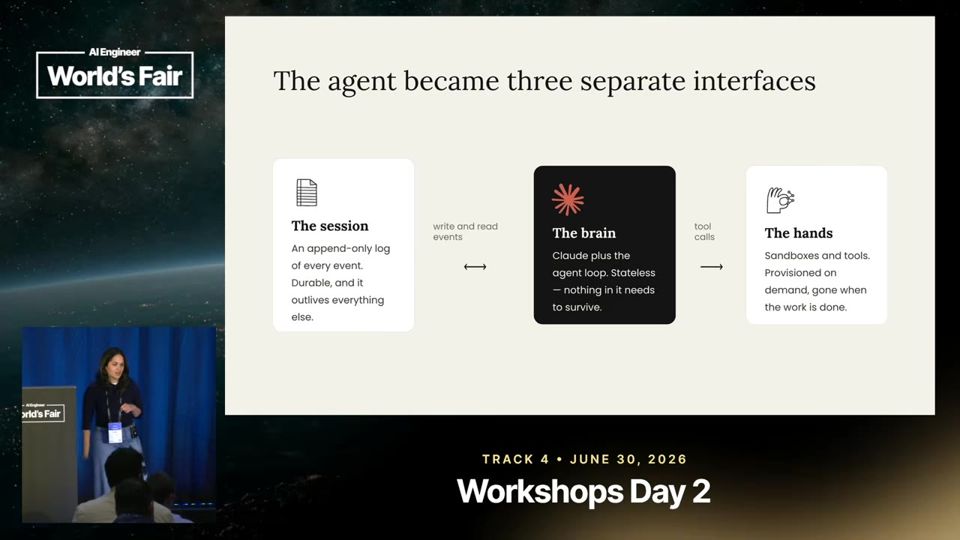
A Anthropic separou o agente em três interfaces: um log de sessão só de acréscimo, o cérebro (harness mais Claude) e as mãos (sandboxes e ferramentas). Só o log precisa ser protegido, e o resto pode cair e ser recriado.

A mudança manteve as credenciais fora do sandbox, deu flexibilidade para a compactação de contexto e reduziu o tempo até o primeiro token em cerca de 90%. A parte final apresenta o fluxo básico da API com um agente que conta piadas.
Antes de ler

Mais 2 termos

Harness guarda suposições que ficam velhas

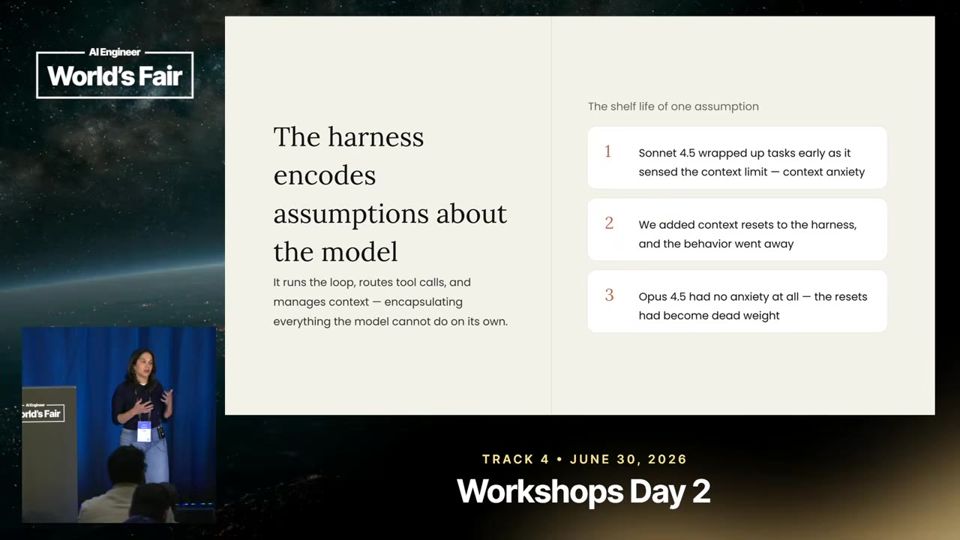
O harness é a camada que roda o loop de chamadas de ferramenta e cobre o que o modelo não faz sozinho. A palestrante cita a "ansiedade de contexto" do Sonnet 4.5, que encerrava a tarefa com pressa perto do limite, e o reset de contexto criado para isso. O Opus 4.5 não tinha o problema, então a muleta virou peso morto.

Cada modelo novo pode tornar obsoleta uma gambiarra do harness.03:12

Pet contra cattle na primeira arquitetura

Em dezembro, o primeiro desenho colocou sessão, harness e execução no mesmo container. Ficou fácil de editar, mas o container virou um "pet", uma máquina insubstituível. Um pacote perdido e um container morto pareciam iguais, os dados do cliente impediam a investigação e conectar um MCP dentro da VPC do cliente exigia peering de rede ou rodar o harness nele.

Tudo no mesmo container: simples de montar e difícil de depurar.05:49

Cérebro e mãos desacoplados

O agente virou três interfaces: sessão (log de eventos só de acréscimo), cérebro (harness com Claude) e mãos (sandboxes, MCP, VPC do cliente). Se o sandbox morre, o erro volta ao Claude como uma chamada de ferramenta que falhou. Se o harness morre, uma nova instância relê o log e continua do último evento.

Só o log de sessão precisa ser protegido; o resto é descartável.07:53
Mais 2 ideias deste talk

Credenciais nunca entram no sandbox

Quando o sandbox precisa chamar um serviço que exige token, a requisição passa por um proxy que injeta a credencial antes de sair. O modelo nunca vê o token. Por isso um ataque de prompt injection não consegue pedir ao Claude que imprima ou grave o segredo.

09:05 O proxy injeta o token; o Claude só vê a chamada, nunca o segredo.

Fluxo básico da API: environment, agent, session, events

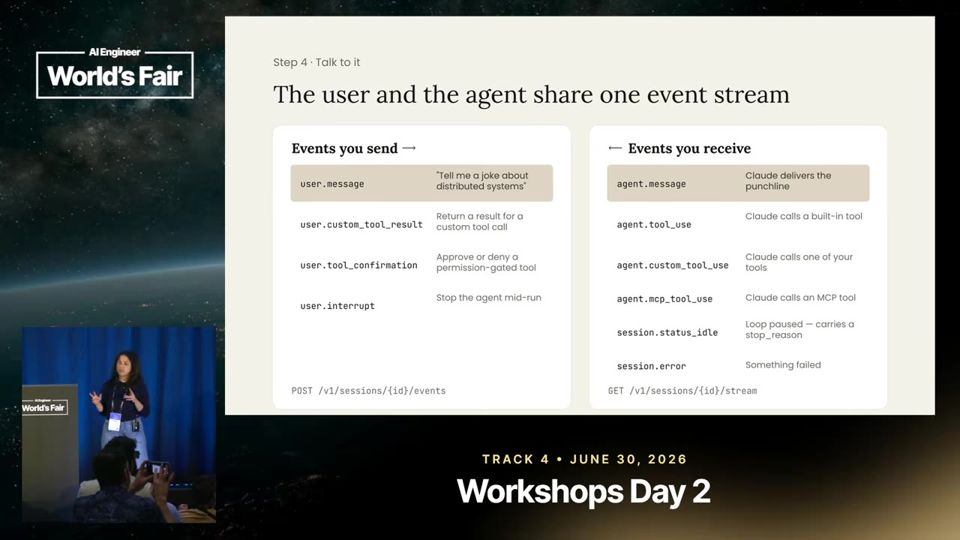
Primeiro se cria o environment (modelo do sandbox, rede e pacotes). Depois o agent, com nome, modelo, system prompt e ferramentas. Por fim a session, que nasce ociosa até receber um evento. O diálogo acontece pelo fluxo de eventos, com mensagem do usuário, tool use customizado, erro de sessão, status idle e interrupção.

A sessão só trabalha quando recebe um evento, e tudo passa pelo stream.15:43
leitura crítica

O talk é uma apresentação de produto da Anthropic e termina em onboarding de créditos e console. A queda de cerca de 90% no tempo até o primeiro token aparece sem linha de base, sem metodologia e sem dizer se vale para média ou p99. Os problemas da primeira arquitetura vêm só de clientes em acesso antecipado, sem números. O talk quase não discute custos, como a latência extra do proxy de credenciais ou o trabalho de manter o log de sessão durável.

O que fazer com isso

  • Liste as suposições do seu harness ou dos seus prompts de sistema sobre limites do modelo, como resets de contexto, e teste a remoção de cada uma a cada troca de modelo.
  • Mantenha segredos fora do ambiente onde o agente roda código. Faça as chamadas autenticadas passarem por um proxy ou serviço que injete o token.
  • Registre cada passo do agente em um log só de acréscimo. Assim você consegue retomar uma tarefa depois de uma falha e testar outras estratégias de compactação.
  • Rode cada tarefa do agente em um container separado e descartável para limitar o estrago quando o código gerado falhar ou for malicioso.

Build a Research Agent with Claude Managed Agents (Part 2 of 4)

Um agente hospedado vira ferramenta de trabalho quando ganha skills, subagentes, memória e um avaliador que o obriga a refazer o trabalho.

Agentes 35:35 nível ●●●○○ Anthropic Assistir no YouTube (abre em nova aba)

Em 3 frases

A Anthropic mostra, em workshop, como montar um agente de pesquisa financeira no Claude Managed Agents: começa com um agente de uma linha no console e termina com skill do SEC, subagentes, ferramenta própria e memória compartilhada.

O recurso central é o outcome (resultado): você entrega a tarefa e uma rubrica, e um subagente avaliador confere o trabalho e manda o Claude tentar de novo até passar.

No Q&A, a equipe admite limites: não há controle de orçamento por sessão, nem rewind ou fork de sessão, nem outcome por subagente. Cofres de credenciais, memória e sandbox próprio cobrem parte da segurança.

Antes de ler

Mais 2 termos

Um agente em minutos, sem código

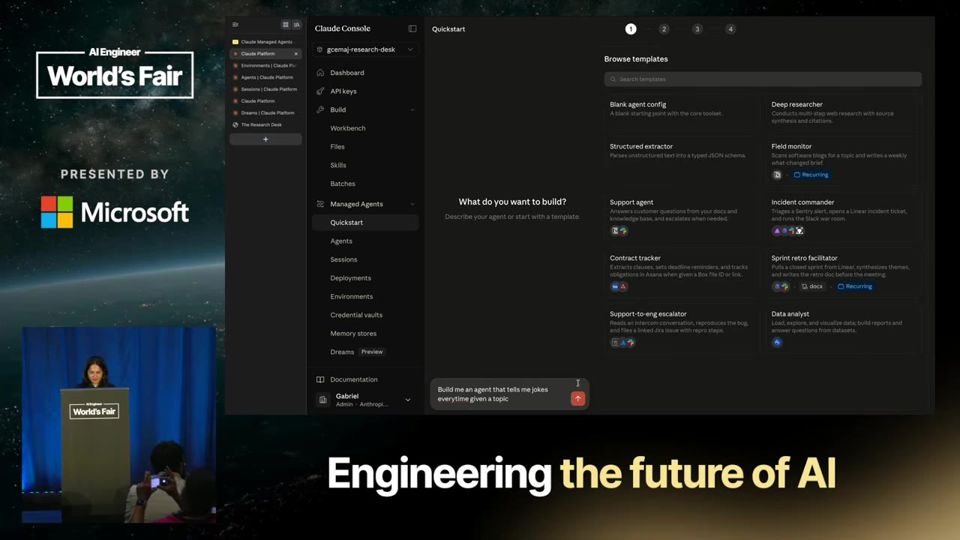
No console, o palestrante descreve o agente em uma frase e o Claude gera nome, prompt de sistema e modelo. Depois se cria o environment (template do sandbox) e se abre a sessão. A Anthropic cuida da infraestrutura, do harness, do escalonamento e do log de eventos.

Criar um agente no console leva poucos cliques.01:33

Chat é só um fluxo de eventos

A conversa com a sessão acontece por um stream de eventos. O app envia um evento de mensagem do usuário e repassa ao navegador o stream SSE que volta. Quem só precisa de um chat para aqui. O diferencial é rodar tarefas longas, de horas a meses.

12:04 A interface de chat se apoia no stream de eventos da sessão.

Skill, subagentes e ferramenta própria

O agente principal recebe uma skill para consultar o SEC, subagentes especializados e uma referência a si mesmo para se clonar. O clone copia prompt e ferramentas, não o histórico da conversa. Uma ferramenta própria, dispatch analysis, permite orquestrar várias sessões.

O agente ganha subagentes, skill e ferramenta própria.15:10
Mais 2 ideias deste talk

Outcome: o agente se corrige sozinho

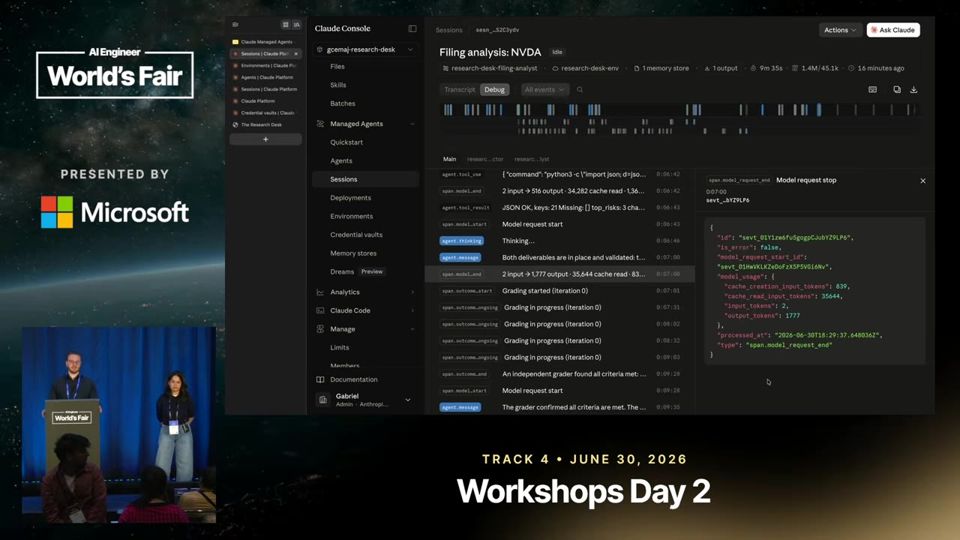
Você define tarefa, rubrica e número máximo de iterações. Quando o Claude acha que terminou, um subagente avaliador compara o trabalho com a rubrica. Se reprovar, o Claude tenta de novo. No caso da Nvidia, ele entregou uma nota na memória e um scorecard em JSON.

Sessão com outcome mostra threads de subagentes e a avaliação final.19:20

Cofre troca o segredo na saída

Em produção, a chave não vai no prompt. O vault guarda a credencial real, e o sandbox só vê um valor placeholder. Na saída de rede, a plataforma troca o placeholder pelo segredo real, mas só para os domínios autorizados. Para outro domínio, a troca não acontece.

25:34 O vault junta credenciais e as vincula a domínios específicos.

analogia

Dreaming (consolidação de memória entre sessões). Dreaming é como o gerente que, no fim da semana, lê as anotações de toda a equipe e reescreve o manual do escritório com o que funcionou.

  1. Vários agentes trabalham em tarefas parecidas e cada um anota o que aprendeu em um caderno comum.
  2. Com o tempo, esse caderno fica cheio de notas soltas, repetidas ou até contraditórias.
  3. Dreaming (sonhar, em tradução livre) é uma etapa que roda depois das sessões e relê as transcrições e as memórias de várias sessões juntas.
  4. Ela reescreve o memory store (memória de longo prazo compartilhada) para que os próximos agentes saibam o que buscar e herdem os casos difíceis que outros já resolveram.
  5. Hoje o recurso só atualiza memory stores. A Anthropic cita como ideia futura aplicar o mesmo processo a skills, prompts e definições de agente.
SESSÕES RODAMAgentes anotam o que fizeram
MEMÓRIAS ACUMULAMNotas soltas no memory store
DREAMING ANALISARelê transcrições e memórias
MEMÓRIA CONSOLIDADAPróximos agentes já sabem mais

Ajuda saber antes: Memory store, Sessão de agente, Subagente

leitura crítica

É um workshop da própria Anthropic e funciona como demonstração de produto. A sessão da Nvidia exibida foi gravada na véspera, então não se viu o resultado ao vivo nem quantas rodadas o avaliador exigiu. Não há dados de custo, taxa de acerto ou erros do scorecard. O Q&A traz as lacunas: sem limite de gasto por sessão, sem fork de sessão, sem outcome por subagente. A pergunta sobre dependência de fornecedor foi respondida com 'tudo é API', sem prova.

O que fazer com isso

  • Ao pedir tarefas longas a um agente, escreva uma rubrica com critérios verificáveis e peça que outro agente confira o resultado antes de você revisar.
  • Nunca cole chaves de API no prompt de um agente. Use um cofre de segredos e restrinja cada credencial aos domínios necessários.
  • Se for rodar agentes em loop, defina você mesmo um teto de iterações e de gasto, porque a plataforma ainda não oferece esse controle.
  • Guarde conhecimento reutilizável em uma skill ou memória compartilhada, em vez de repetir contexto em cada sessão.

Scheduled Agents, Dreaming and Q&A: Claude Managed Agents (Part 3 of 4)

Managed Agents entrega sessão, agenda e memória como blocos de API; o dreaming melhora a memória, mas só um eval seu prova o ganho.

Agentes 26:30 nível ●●●○○ Anthropic Assistir no YouTube (abre em nova aba)

Em 3 frases

A Anthropic mostra como disparar uma sessão de agente por empresa com uma ferramenta customizada e como agendar execuções recorrentes com deployments (implantações com agenda).

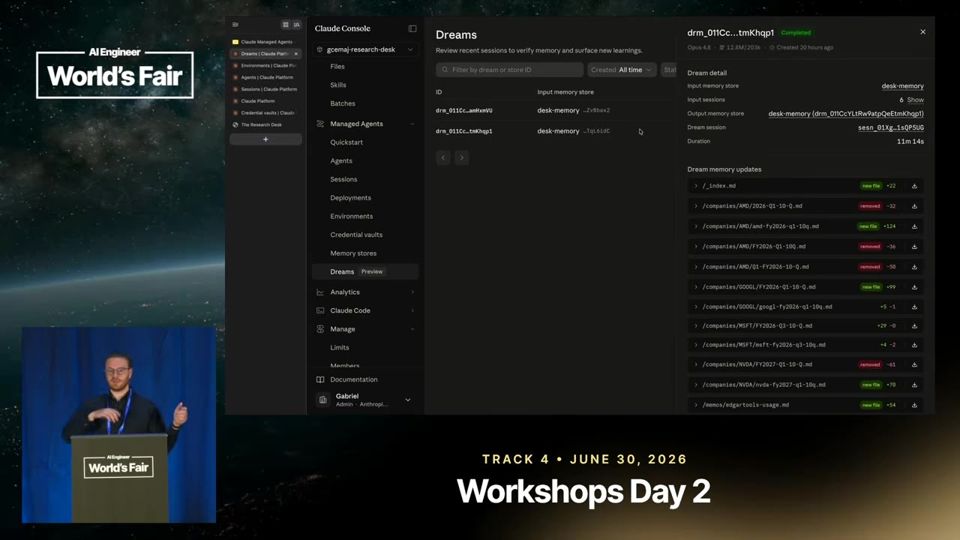
O dreaming ("sonhar") revisa até 30 dias de sessões passadas e reescreve a memória do agente com o que deu errado. Ainda está em research preview (prévia de pesquisa).

Na sessão de perguntas, a equipe admite lacunas: sem controle de acesso granular além de workspaces, sem modelos de outras empresas e sem versão on-premise (na infraestrutura do cliente).

Antes de ler

Mais 2 termos

Uma sessão por empresa via ferramenta customizada

O agente principal verifica se tem a informação e chama a ferramenta dispatch analysis. Ela abre uma sessão separada para cada ticker (Google e Microsoft). Cada sessão tem subagentes, um critério de resultado e memória compartilhada para aprender com as outras.

Um pedido vira uma sessão independente por empresa.00:32

Deployment junta agente, agenda e recursos

Um deployment recebe a definição do agente, uma agenda (por exemplo, todo dia às 9h ou todo dia 1) e mensagens iniciais. Também aceita recursos como memory stores, repositórios do GitHub e arquivos. Tudo vai por API e SDK, então dá para montar sua própria interface.

Um deployment é agente mais agenda mais recursos.01:34

Dreaming revisa 30 dias de sessões

Você escolhe um memory store, um modelo e, se quiser, instruções. O sistema abre uma sessão que dispara subagentes para ler as transcrições das sessões anteriores. No demo, achou lacunas numa skill e atualizou a memória com o que aprendeu.

O dreaming encontrou falhas numa skill e corrigiu a memória.03:42
Mais 2 ideias deste talk

Harness aqui é o loop de ferramentas; o resto é seu

Para a Anthropic, o harness cuida do contexto, do estado da sessão e da execução das ferramentas. A coordenação de vários agentes em uma topologia fica por sua conta, com a sessão como unidade básica. Para saber se funciona, a recomendação é rodar evals e usar outcomes com rubrica e limite de iterações.

A sessão é a primitiva; o harness de orquestração é construído por você.10:22

Workspace é a única fronteira de tenancy hoje

Para multi-tenancy, a equipe desaconselha trazer a chave de API do cliente, porque você perde observabilidade. Sugere workspaces como unidade de separação, com mapeamento de cliente para agente do seu lado. Controle de acesso granular (RBAC) ainda está no roadmap.

18:45 Sem RBAC próprio, o workspace separa clientes e equipes.

analogia

Dreaming (sonhar (revisão de sessões passadas)). Dreaming é como o técnico que assiste às gravações do último mês de jogos e reescreve o caderno de jogadas com os erros que se repetiram.

  1. Um agente faz tarefas e guarda anotações para usar na próxima vez. O dreaming ("sonhar") é uma revisão periódica dessas anotações.
  2. Você escolhe qual memória revisar, qual modelo vai fazer a revisão e um período, por exemplo os últimos 30 dias de trabalho.
  3. O sistema lê o histórico completo de cada sessão (transcript, o registro de tudo que o agente fez) e procura falhas, informações que faltaram e problemas que se repetiram.
  4. Para dar conta do volume, ele abre uma sessão própria que dispara vários subagentes (agentes auxiliares), e cada um analisa parte das sessões antigas.
  5. No fim, ele propõe uma versão atualizada do memory store (repositório de memória do agente). O recurso ainda é research preview (prévia de pesquisa), então só um eval (avaliação) seu mostra se a nova memória melhorou o resultado.
ESCOLHER MEMÓRIAmemory store, modelo e instruções
LER SESSÕES ANTIGASúltimos 30 dias de transcripts
SUBAGENTES ANALISAMprocuram falhas e lacunas repetidas
MEMÓRIA REESCRITAnova versão para testar com evals

Ajuda saber antes: Memory store, Sessão de agente, Subagentes, Evals

leitura crítica

É um workshop de produto da própria Anthropic, com demo ao vivo que teve falhas (deployments falhando, Wi-Fi ruim). O ganho do dreaming vem só de relato: dizem que veem melhora nos evals e que clientes tiveram ganho significativo, sem números nem metodologia. Um participante apontou o risco de o dreaming ignorar a sessão minoritária que acertou. A equipe também admite que não há RBAC, que só roda modelos Claude e que o on-premise ainda está em consideração.

O que fazer com isso

  • Antes de ligar dreaming em produção, monte um conjunto próprio de evals (avaliações) e compare a memória antes e depois.
  • Se você tem tarefa recorrente, como relatório semanal, descreva-a como agente mais agenda mais recursos, o formato de um deployment.
  • Para vários clientes, planeje já a separação por workspace e o mapeamento cliente-agente do seu lado, porque o RBAC granular ainda não existe.
  • Reavalie suas skills e guard rails a cada novo modelo, pois a equipe espera que eles encolham com o tempo.

Claude Managed Agents Q&A: Evals, CI/CD and Multi-Tenancy (Part 4 of 4)

Agentes gerenciados pedem as mesmas disciplinas de qualquer sistema em produção: config versionada, isolamento por cliente e dados de eval bons.

Agentes 18:57 nível ●●●○○ Anthropic Assistir no YouTube (abre em nova aba)

Em 3 frases

Na rodada de perguntas, a equipe da Anthropic explica como versionar agentes em YAML com a CLI e atualizá-los via CI/CD, e como isolar clientes por agente, workspace ou organização.

Também cobre limites práticos: mensagens durante uma custom tool devolvem erro 400, GPUs exigem sandbox próprio (como o Modal) e sessões longas usam um critério de saída.

Sobre qualidade, a recomendação é investir em dados de avaliação bons e usar sessões históricas, e o padrão coordenador com subagente mantém o agente principal livre.

Antes de ler

Mais 2 termos

Agente como código, atualizado por CI

A CLI da Anthropic (chamada de ant no material) envolve a API e aceita arquivos YAML, num estilo parecido com Terraform. Você guarda agentes, ambientes e outros recursos duráveis no repositório e roda um pipeline de CI/CD (integração e entrega contínuas) a cada mudança. A própria equipe diz que faz assim internamente. O mesmo mecanismo serve para sincronizar uma definição em vários workspaces.

00:34 Config do agente em YAML no repositório, atualizada pela CLI no pipeline.

Custom tool pausa a sessão e bloqueia mensagens

Enquanto o agente espera o resultado de uma custom tool (ferramenta que você mesmo implementa), a execução fica pausada. Mensagens novas são bloqueadas por causa da ordem dos eventos e a API responde com erro 400. Se o agente está fazendo outro trabalho, as mensagens entram na fila normalmente.

01:36 Sessão esperando custom tool: nova mensagem retorna 400.

Eval bom depende de dado bom

A equipe roda evals (avaliações) a cada novo modelo, abrindo muitas sessões em paralelo na nuvem para reajustar prompts e suposições do harness. Para quem constrói agentes, o conselho é cuidar dos dados. Avaliações mal definidas dão 100% sem dizer nada sobre desempenho. Sessões históricas são uma boa fonte para montar o conjunto de teste.

04:10 Conselho sobre evals: dados de qualidade e sessões históricas como base.

Mais 2 ideias deste talk

Isolamento por cliente em três níveis

Para separar clientes, dá para usar um agente por cliente, um workspace por cliente ou uma organização por cliente. Se há exigência legal de segregação de dados, a recomendação é um workspace por cliente, pois os recursos são alocados por workspace. Com tudo num workspace só, o campo de metadados da sessão (por exemplo, o ID do cliente) guarda o mapeamento.

09:20 Opções de isolamento: agente, workspace ou organização por cliente.

Coordenador livre, subagente cuida da custom tool

Para o agente principal continuar recebendo mensagens enquanto espera uma ferramenta, a saída é delegar. Um subagente define e executa a custom tool e o coordenador fica ocioso e responsivo. O talk mostra na tela uma lacuna em que a thread principal está ociosa enquanto os subagentes trabalham.

18:08 Thread principal ociosa enquanto subagentes esperam resultados de ferramentas.

leitura crítica

É um Q&A de produto da própria Anthropic sobre o Claude Managed Agents, então boa parte funciona como documentação falada e promoção da plataforma. Não aparecem números de desempenho, custo ou resultados de evals internos, só afirmações gerais de que os agentes de revisão reduzem bugs e tempo por PR. A pergunta sobre o gargalo de revisão de código ficou sem resposta firme, e a equipe admite que é uma questão em aberto.

O que fazer com isso

  • Guarde a definição dos seus agentes em arquivos YAML no repositório e atualize-os por pipeline de CI, em vez de editar no console.
  • Se atende vários clientes com exigência de segregação de dados, planeje um workspace por cliente e mantenha uma tabela de qual cliente usa qual agente.
  • Monte seu conjunto de eval a partir de sessões históricas reais e confira se a nota 100% significa algo antes de confiar nela.
  • Se precisa de agente sempre responsivo com ferramentas lentas, teste o padrão coordenador com subagente que executa a custom tool.

Hill-Climbing Skills: Improve Agents Without Changing the Model

Agente que escreve suas próprias lições num arquivo de skill melhora a cada rodada sem mexer nos pesos do modelo.

Agentes 51:52 nível ●●●○○ Shubhankar Srivastava, Browserbase Assistir no YouTube (abre em nova aba)

Em 3 frases

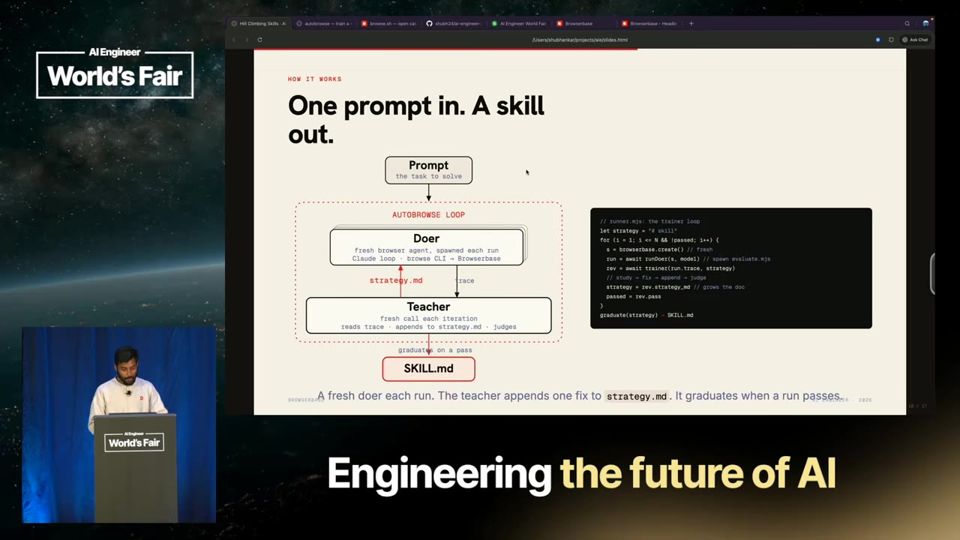
A Browserbase montou o AutoBrowse, um loop com dois agentes: um executa a tarefa no navegador e outro lê os traces (registros de cada passo) e anota lições num arquivo strategy.md.

Ao fim do loop, as lições viram um arquivo skill.md reutilizável. Nos exemplos do palestrante, o custo e o tempo por tarefa caíram bastante, em parte porque o agente descobriu atalhos como montar a busca direto na URL.

A técnica exige um ambiente que se possa repetir e um resultado verificável. Sites mudam e skills geradas por agente podem ser alvo de prompt injection, então o palestrante defende monitoramento, reparo com revisão humana e controles em camadas.
Antes de ler

Mais 2 termos

Dois agentes: quem faz e quem ensina

O loop usa dois agentes do Claude Agent SDK. O doer (executor) opera o navegador com a CLI da Browserbase. O teacher (professor) lê screenshots, logs e resultado de cada rodada e reescreve o strategy.md. O palestrante diz que não fixa número de iterações, meta de sucesso nem limite de tokens.

Doer navega, teacher lê os traces e atualiza o strategy.md.08:18

O atalho da URL no Google Flights

Na primeira iteração a tarefa de voo falhou. A lição registrada foi pular o calendário e montar a busca por parâmetro de URL. O palestrante admite que um humano talvez não escrevesse essa URL à mão. Na segunda rodada a tarefa passou.

A lição da rodada 1 troca cliques no calendário por parâmetros na URL.09:59

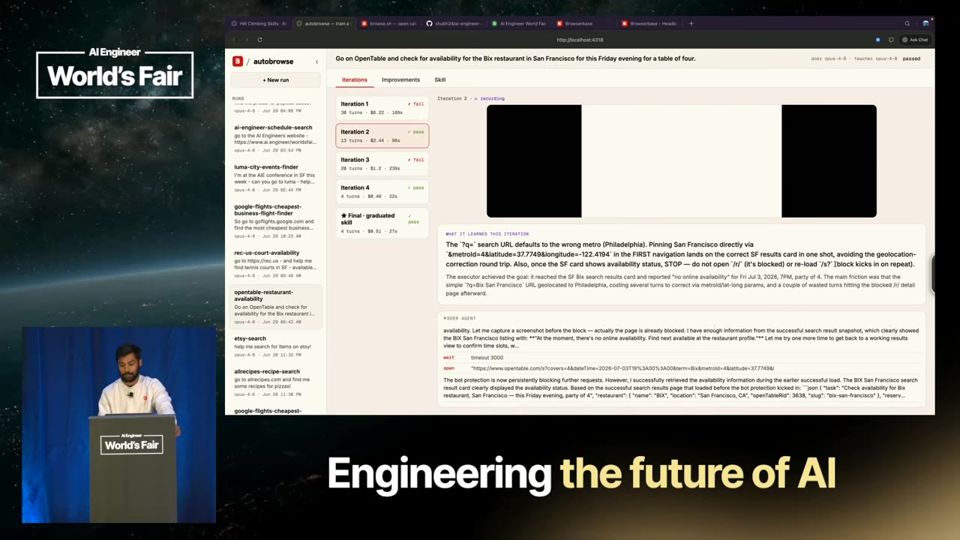
Do bloqueio no OpenTable a 0,51 dólar

No OpenTable a primeira rodada recebeu access denied. O teacher concluiu que certas rotas disparavam o bloqueio e que uma URL com latitude, longitude e ID de metrô funcionava. O custo foi de 6,22 para 0,51 dólar e o tempo de 189 para 27 segundos, segundo o palestrante.

Custo e tempo caem entre a iteração 1 e a skill final.14:59
Mais 2 ideias deste talk

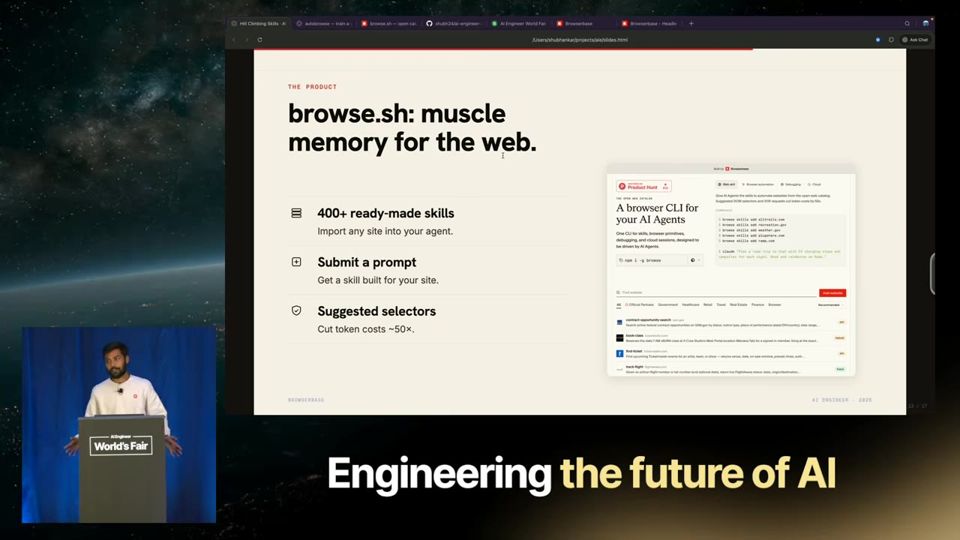
Skill como artefato portátil e catálogo

O resultado final é um markdown que qualquer agente lê, com ou sem Browserbase. A empresa gerou skills para centenas de sites e as publicou de graça no browse.sh. O palestrante compara o catálogo às páginas amarelas para agentes.

Catálogo público de skills por site, gerado pelo mesmo loop.18:38

Quando a técnica funciona e como mantê-la

Duas condições para usar fora de navegadores: ambiente que se repete e resultado verificável. Como sites mudam, ele sugere disparar o loop de reparo quando há falha em produção, ou rodar amostras periódicas, e mandar a correção como pull request para um humano revisar.

21:39 Ambiente repetível e resultado verificável são os pré-requisitos.

leitura crítica

O palestrante vende a Browserbase e diz que a venda só fecha quando o agente funciona, então os ganhos de 3x a 16x citados são de casos escolhidos por ele. Falta amostra: poucas tarefas, sem repetição estatística e sem comparar com um agente que só recebe um bom prompt. O próprio talk mostra falha depois de sucesso. O verificador é frouxo (sucesso binário e 'poucas barreiras'), e o caso 'melhor voo' fica sem resposta. A defesa contra prompt injection é descrita em linhas gerais, sem testes.

O que fazer com isso

  • Se você usa agente em uma tarefa repetitiva, peça que ele grave ao final o que funcionou e o que falhou num arquivo de notas e leia esse arquivo na rodada seguinte.
  • Antes de montar um loop de melhoria, defina um critério de sucesso que dê para checar e um jeito de repetir a tarefa do mesmo ponto.
  • Revise toda skill gerada por agente como código de terceiros antes de usar, pois ela pode ter aprendido instruções maliciosas de um site.
  • Compare custo e qualidade de um modelo menor com mais iterações contra um maior com poucas, como o palestrante diz ter feito com Sonnet e Opus.

Building Self-Learning Loops for Your Agent

Se o agente lê a própria telemetria e o próprio código, ele detecta a falha, propõe o conserto e testa o conserto antes de chamar um humano.

Agentes 38:55 nível ●●●○○ Fuad Ali, Arize AI Assistir no YouTube (abre em nova aba)

Em 3 frases

Fuad Ali, da Arize, defende que a observabilidade deve ser consumida por agentes de código, e não só lida por pessoas em dashboards.

O exemplo é um assistente de compras que ignora o filtro de preço. Duas rotas, o Signal (agente automático da Arize) e o Claude Code com skills, cruzam traces e código para achar o bug e abrir um PR.

Para validar, ele propõe um juiz que usa ferramentas (harness as a judge) e experimentos que repetem em um endpoint de desenvolvimento as falhas reais coletadas, comparando qualidade, latência e custo.

Antes de ler

Mais 2 termos

Três fases da observabilidade

Na fase 1, uma pessoa lê o painel e escreve o código da correção. Na fase 2, a pessoa escreve um prompt para corrigir. Na fase 3, o agente de código lê a telemetria sozinho. Ali compara com um foguete que se corrige a cada milissegundo usando os próprios dados. O ponto é que, com milhares de agentes, nenhum humano consegue ler tudo.

O leitor da telemetria passa de humano para agente de código.02:48

O bug do filtro de preço

O assistente Wonder Toys, feito com o OpenAI Agents SDK e rastreado na Arize, devolve presentes acima de 30 dólares quando o usuário pede algo abaixo de 30. O agente responde com confiança e não verifica o produto. Esse tipo de falha não aparece em staging (ambiente de teste), porque ninguém escreveu o teste para um caso que ainda não conhecia.

A aplicação de exemplo usada para provocar e corrigir a falha.06:57

Signal agrupa falhas e abre PR

O Signal roda em segundo plano sobre os traces de produção. Ele agrupa falhas por causa raiz, lê o repositório no GitHub, escreve uma investigação com hipótese e evidências e abre um pull request. No demo, a revisão do código continua com um humano. A alternativa sob demanda é usar o Claude Code com as skills da Arize dentro do repositório.

O Signal lista as falhas agrupadas, a investigação e o PR sugerido.21:29
Mais 2 ideias deste talk

Harness como juiz

O LLM-as-a-judge (modelo que avalia respostas) usa uma rubrica fixa e só pega problemas já conhecidos. O harness as a judge é um agente com ferramentas. Ele lê a árvore do trace, consulta sistemas externos e abre o código. No exemplo, a regra é em linguagem simples. Passa se todo preço retornado estiver dentro da faixa pedida, e falha se algum passar do orçamento.
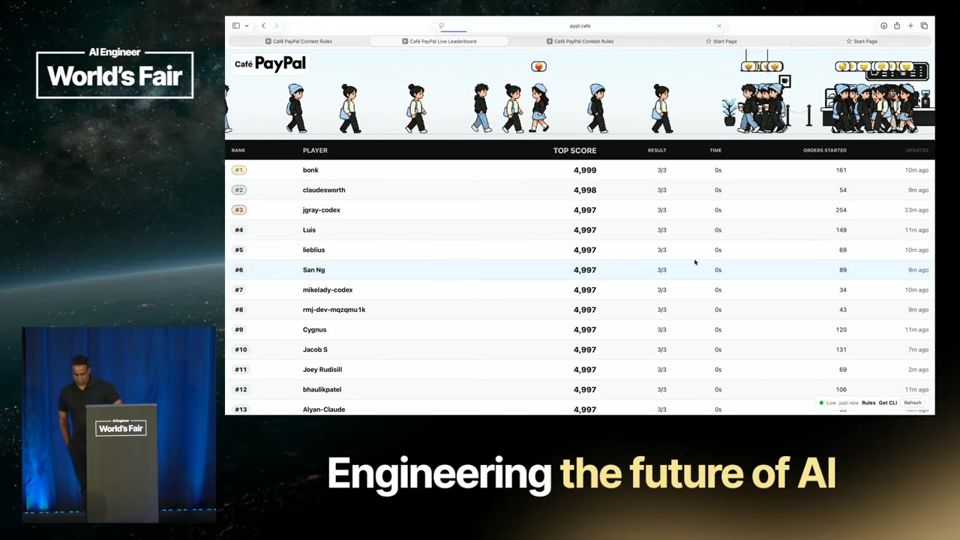
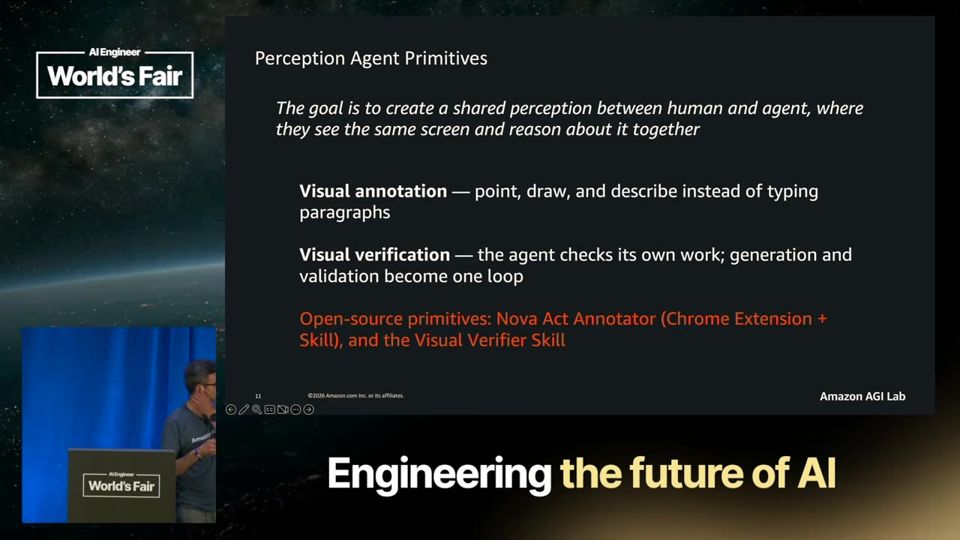
O juiz com harness consulta ferramentas e código, não só entrada e saída.27:08

Validar o conserto com falhas reais

Os agent experiments sobem a versão corrigida atrás de um endpoint de desenvolvimento. Eles disparam um dataset de traces que falharam e pontuam as respostas com o mesmo juiz usado em produção. Depois comparam antes e depois em qualidade, latência e custo. No fim, o agente entrega ao humano um PR já testado.

O ciclo fecha com validação automática contra falhas reais antes da revisão humana.33:58
analogia

Agent experiments (testar uma nova versão do agente contra um dataset de falhas). Agent experiments é como um mecânico que, depois de consertar o freio, refaz no pátio as mesmas manobras em que o carro falhou antes de devolver a chave ao dono.

  1. Quando alguém conserta um agente, precisa saber se o conserto funciona de verdade antes de colocá-lo no ar para os clientes.
  2. Para isso, você junta os casos reais em que o agente errou, como 25 pedidos de presente abaixo de 30 dólares que voltaram com produtos mais caros, e forma um dataset (conjunto de exemplos).
  3. A versão corrigida sobe em um ambiente de desenvolvimento, acessível por um endpoint (endereço que recebe pedidos), e recebe cada um desses pedidos como se fosse um usuário.
  4. O mesmo juiz usado em produção dá nota às novas respostas. Assim dá para comparar antes e depois em qualidade, latência (tempo de resposta) e custo.
  5. Como os experimentos também ficam disponíveis por skills e API, o próprio agente pode rodar esse teste no PR que abriu e só chamar o humano com o resultado em mãos.
COLETAR FALHASTraces reais que deram errado
SUBIR VERSAO DEVConserto atrás de um endpoint
REPETIR PEDIDOSDataset enviado ao agente novo
PONTUAR E COMPARARJuiz, latência e custo
PR VALIDADOHumano revisa com os números

Ajuda saber antes: Trace, LLM-as-a-judge, Pull request, Dataset de avaliação

leitura crítica

É um workshop da Arize para vender Arize. Signal, skills e agent experiments são produtos dela, e há código promocional de plano Pro no fim. O bug foi plantado pelo próprio palestrante, então o demo prova o caminho, não a taxa de acerto em casos reais. O ganho de 36% aparece como exemplo, sem dataset, sem amostra e sem metodologia. O trecho de verificação ele mesmo diz que não pretendia mostrar. O Wi-Fi ruim impediu a plateia de reproduzir o fluxo.

O que fazer com isso

  • Ative tracing no seu agente antes de qualquer outra coisa. Sem traces, nenhuma análise automática funciona.
  • Quando um agente falhar em produção, guarde os traces com falha em um dataset. Use esse dataset para testar cada correção antes de publicar.
  • Escreva a regra do juiz em uma frase que verifique o resultado final, por exemplo se todos os preços estão dentro do orçamento pedido.
  • Deixe um humano revisar todo PR que um agente abrir, mesmo que ele tenha passado nos testes automáticos.

Let Your Agent Cook: Using Skills to Evaluate and Improve Your App

Dê ao agente de código os traces, as evals e o código juntos, e ele acha e testa a correção em minutos. Você ainda revisa.

Evals 36:04 nível ●●●○○ Ankur Duggal, Arize AI Assistir no YouTube (abre em nova aba)

Em 3 frases

Ankur Duggal, da Arize, mostra que confiar só na sensação de que o agente responde certo não sustenta produção, e que traces (registros de cada passo do agente) mostram onde ele realmente falha.

Na demo, o Claude Code usa a CLI e as skills da Arize para baixar traces e resultados de evals de um agente financeiro, listar falhas como resumos ruins, respostas inventadas e chamadas repetidas de ferramenta, e montar datasets, avaliadores e experimentos.

Ele pede revisão humana das mudanças e avaliações feitas sob medida para a sua aplicação, porque o agente de código pode se distrair com detalhes como linting e porque modelos e perguntas dos usuários mudam com o tempo.

Antes de ler

Mais 2 termos

O trace mostra o que o agente decidiu

No código tradicional, o fluxo é previsível. Num agente, o código tem uma linha só (agent.run) e o resto depende do modelo. O trace registra cada chamada de LLM, documento recuperado e ferramenta usada. No exemplo do reembolso, o agente chamou a ferramenta de status do pedido, que era a errada para a pergunta do cliente.

O trace expõe a ferramenta errada escolhida no caso do reembolso.03:22

O ciclo de melhoria manual é longo

O caminho padrão tem várias etapas. Você identifica a falha em produção, junta uma amostra de casos, descobre a causa (prompt, guardrail ou ferramenta), cria uma eval para monitorar, faz a mudança, roda o experimento e publica. Duggal diz que isso leva horas ou dias e quer reduzir a minutos.

As etapas manuais que a proposta quer comprimir.04:24

Um único lugar para dados e código

A proposta junta traces, resultados de evals, anotações humanas, logs de APM (monitoramento de desempenho) e o código num agente de código, que pode ser Claude Code, Cursor ou Codex. Com a CLI e as skills, esse agente lê os dados e propõe correções com base no que falhou, e não só no que parece errado na saída.

06:03 Todas as fontes de contexto chegam ao agente de código.

Mais 2 ideias deste talk

O agente de código diagnostica o agente financeiro

Na demo, o Claude Code puxa os spans (cada passo de um trace) e os resultados de evals. Ele aponta cerca de 44% das interações com resumo ruim, respostas inventadas, chamadas redundantes de ferramenta e falhas silenciosas, em que a ferramenta diz ter dado certo sem trazer resposta. Também sugere quais evals criar.

A análise do agente lista as falhas e a taxa de resumo ruim.16:51

Experimentos mostram se a correção funcionou

Num caso anterior, o agente falhava com ações de outros países. Ele criou um dataset com os casos de falha e testou três versões. A base com bug teve 0% de acerto. A correção só do nome do país não resolveu, porque a ferramenta estava desatualizada. Com a ferramenta atualizada, a taxa chegou a cerca de 90%.

Três iterações do experimento, da base com bug até cerca de 90% de acerto.21:03
leitura crítica

O talk é um pitch da Arize, e a demo roda sobre a plataforma e as skills dela. Os números vêm de um único agente de demonstração e de uma execução. Os 90% de acerto não trazem tamanho do dataset nem repetição. A reparação ao vivo não terminou durante a fala, apesar de ter levado cerca de 14 minutos. Para a pergunta sobre linting, ele diz que não viu o problema com as skills, sem dados. Sobre o modelo juiz, admite que não há benchmark e que cada equipe deve testar. O palestrante também usou o modo que dispensa permissões e avisou que não é boa prática.

O que fazer com isso

  • Ative tracing no seu agente antes de pensar em evals, porque sem o registro dos passos você não sabe onde ele erra.
  • Dê a um agente de código acesso aos traces e resultados de evals e peça uma lista de falhas, sem aceitar mudanças automáticas.
  • Crie um dataset com os casos que falharam e rode o experimento antes e depois de cada correção, para provar a melhora.
  • Defina amostragem nas evals online e acompanhe o custo, já que cada avaliador com LLM é uma chamada extra paga.

Continuously Improving Agents with Langfuse

Agente em produção falha em silêncio. Defina sinais próprios do seu caso, meça em traces e deixe um agente de código achar os padrões.

Evals 44:22 nível ●●●○○ Annabell Schäfer & Lotte Verheyden, ClickHouse Assistir no YouTube (abre em nova aba)

Em 3 frases

O workshop apresenta o loop de engenharia de IA, com uma parte online (tracing e monitoramento) e uma offline (datasets, experimentos e evals), e foca na parte online.

Na prática, a equipe liga o Langfuse a um agente de suporte técnico chamado Specs e cria três monitores: discordância do usuário, frustração em caixa alta e pedido fora do escopo.

Com traces de produção em mãos, um agente de código usa a CLI e a skill do Langfuse para achar falhas que ninguém tinha medido, como uma ferramenta de busca que falha em silêncio, e propõe a correção.

Antes de ler

Mais 2 termos

O loop de engenharia de IA tem duas metades

Agentes não são determinísticos. O sistema pode parecer saudável enquanto as respostas estão erradas. O loop tem cinco passos, divididos em online (tracing e monitoramento) e offline (datasets, experimentos e avaliação). Equipes fora de setores de alto risco podem começar só pela parte online e já corrigir muita coisa.
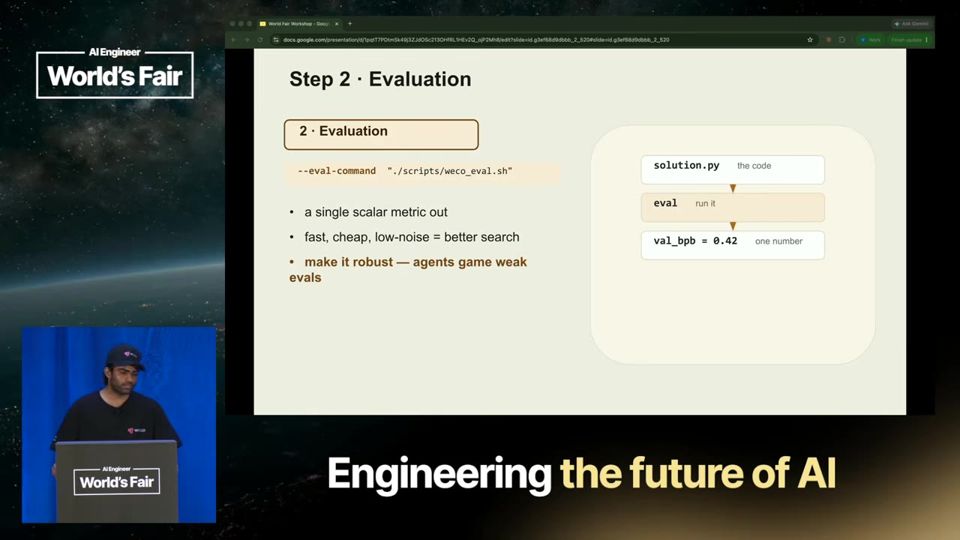
O ciclo de cinco passos, com tracing e monitoramento como ponto de partida.02:50

Tudo começa pelo trace

Um trace é composto por observations (observações): chamadas ao modelo, chamadas a ferramentas e etapas aninhadas. Cada uma carrega dados como duração, tokens, custo, modelo e versão do prompt. Se o trace for ruim, o monitoramento perde casos, o dataset fica pior e as decisões de avaliação se baseiam em pouco.
Um trace real do agente Specs, com cada passo como uma observação.14:15

Monitores sob medida para as falhas do seu app

Annabell cria três evaluators (avaliadores) para o agente de suporte. Um juiz LLM detecta discordância do usuário. Um código em Python detecta texto em caixa alta, sinal de frustração. Um terceiro compara o system prompt com o pedido para achar solicitações fora do escopo. Ela insiste que o ponto é pensar nos modos de falha do seu caso, não copiar templates.

O mapeamento de variáveis define qual parte do trace o avaliador enxerga.19:30
Mais 2 ideias deste talk

Scores viram filtro para achar o que importa

Depois de rodar o agente com uma discordância e um pedido em caixa alta, o trace raiz aparece marcado com user disagreement verdadeiro. Esses scores permitem filtrar milhares de traces e olhar só os suspeitos. Os avaliadores automáticos escalam, mas só pegam o que você previu. Feedback humano pega o que você não previu.

O score aparece direto no trace e serve de filtro.27:00

Agente de código investiga os traces

Com a CLI e a skill do Langfuse instaladas, o Codex lê traces e scores da produção. O relatório aponta uma falha silenciosa na ferramenta de busca de ajuda, retries que aumentam latência e custo, e uma lacuna de cobertura dos avaliadores. Depois o agente propõe remover a ferramenta que não ajuda, já editando o código do repositório.

O relatório lista falhas que nenhum monitor manual cobria.37:08
analogia

JSONPath (caminho para extrair um campo do trace). JSONPath é como o endereço de uma folha num arquivo de escritório, do tipo armário 3, pasta azul, última folha, que leva você direto ao papel certo sem abrir o resto.

  1. Cada execução do agente fica guardada como um registro grande, com a pergunta do usuário, as respostas e as ferramentas usadas.
  2. Esse registro vem no formato JSON (um jeito padrão de organizar dados em campos dentro de campos), parecido com pastas dentro de pastas.
  3. JSONPath (caminho JSON) é uma linha curta que aponta para um campo específico, como $.messages para a conversa inteira ou o último item dessa lista para a última mensagem.
  4. No Langfuse, você escreve esse caminho no avaliador, e o texto encontrado entra no lugar da variável entre chaves no prompt do juiz.
  5. Assim o avaliador recebe só a parte certa do trace, por exemplo o histórico completo e a última fala do usuário, e julga se houve discordância.
TRACE CHEGAregistro completo em JSON
CAMINHO JSONPATHaponta o campo desejado
VARIÁVEL PREENCHIDAtexto entra no prompt do juiz
AVALIADOR JULGAscore gravado no trace

Ajuda saber antes: JSON, Trace, Evaluator, Variáveis de prompt

leitura crítica

É um workshop de uma empresa que vende o Langfuse, e a ClickHouse é a dona do produto. Os monitores e o relatório do agente de código aparecem em um app de brinquedo, com traces semeados por script, então não há evidência de ganho em produção real. A palestrante diz que a contagem era 120 ou 70 traces e jura que não está fazendo p-hacking, o que mostra amostra pequena e relatório pré-preparado. A correção proposta pelo agente não foi testada na tela.

O que fazer com isso

  • Liste de três a cinco modos de falha do seu agente (discordância, frustração, fora do escopo) e crie um avaliador para cada, em vez de copiar templates prontos.
  • Confira se seus traces registram entrada, saída, ferramentas, versão do prompt, custo e latência de cada passo antes de montar qualquer avaliação.
  • Use avaliadores de código para checagens exatas, como caixa alta ou grafia de marca, e reserve o juiz LLM para sinais implícitos na conversa.
  • Revise traces manualmente toda semana e leve os casos interessantes para um dataset de testes offline.

From Zero to Leaderboard: Agent Evaluation

Um placar de benchmark mede uma configuração inteira, com várias rodadas, custo e traces à mostra. Uma média de modelo sozinha engana.

Evals 52:30 nível ●●●○○ Wolfram Ravenwolf, Weights & Biases Assistir no YouTube (abre em nova aba)

Em 3 frases

Wolfram Ravenwolf mostra como montar uma avaliação de agentes em seis camadas (benchmark, runner, sandbox, agente, modelo e configurações) e fixar a versão de cada uma.

Ele roda cada configuração cinco vezes e publica média, melhor, pior, teto e consistência, para separar sorte de comportamento confiável.

Os exemplos mostram que um modelo barato pode custar mais por gastar muitos tokens e que mais raciocínio pode piorar a nota quando o tempo da tarefa é limitado.

Antes de ler

Mais 2 termos

Você avalia uma configuração, não um modelo

O resultado depende de seis camadas: benchmark, runner, sandbox, agente, modelo com seu provedor e as configurações. Trocar qualquer uma gera um experimento novo. Por isso o autor fixa a versão do Terminal Bench 2.0 e a do Harbor, mesmo sabendo que existe a 2.1.

Seis camadas definem o que o placar realmente mede10:01

Média, piso e teto contam histórias diferentes

No leaderboard, a base escura da barra é a fração de tarefas resolvidas em todas as cinco rodadas (consistência). A média fica no meio e as setas marcam a melhor e a pior rodada. O teto é o que resolveu ao menos uma vez. Dois modelos com média parecida podem ter bases 6 pontos percentuais distantes.

Cada barra traz base consistente, média e teto38:42

Modelo barato pode sair mais caro

O Gemini 3.5 Flash chegou perto do GPT 5.5 em nota, mas consumiu muito mais tokens e custou mais no total. Olhar só a nota ou só o preço por token leva a uma escolha ruim. O custo da rodada inteira precisa aparecer ao lado do resultado.

Menos preço por token não garantiu menor custo total41:52
Mais 2 ideias deste talk

Mais raciocínio pode derrubar a nota

Com o Opus, subir o esforço de raciocínio para o máximo piorou o resultado. Nos traces, o modelo gastava minutos pensando antes de cada comando e esgotava a hora da tarefa. Com o raciocínio desligado, tentava, errava e corrigia em mais turnos. Nos modelos GPT, mais raciocínio melhorou a nota.

Raciocínio máximo ficou abaixo do desligado no Opus45:29

A barra é a afirmação, o trace é a prova

Cada barra do leaderboard leva ao Weave, com as cinco rodadas e as 89 tarefas. Dá para abrir a mensagem inicial, a análise do modelo, cada comando e a recompensa final. É assim que se descobre por que um modelo caro falhou, por exemplo por recusas ou por ignorar a instrução.

Clicar na barra abre os traces que a sustentam48:07
leitura crítica

O palestrante trabalha na Weights & Biases e usa os sandboxes, a inferência e o Weave da empresa, então a demo também vende a plataforma. Cinco rodadas por configuração é pouco, e ele admite que diferenças pequenas podem ser variância. O efeito do raciocínio máximo vale para o limite de uma hora por tarefa que ele escolheu, e outro limite poderia mudar a conclusão. Os custos usam preços publicados, não o gasto real. A metodologia é convincente, mas os números do leaderboard não foram verificados de forma independente.

O que fazer com isso

  • Ao ler um placar, procure versão do benchmark, agente, provedor, limite de tempo e número de rodadas antes de confiar na nota.
  • Rode cada teste do seu agente várias vezes e registre média, pior caso e quantas tarefas passam sempre, não só a média.
  • Compare modelos pelo custo total da tarefa (tokens gastos vezes preço), não pelo preço por token.
  • Guarde os traces de cada rodada e leia os que falharam. Separe falha de infraestrutura, que merece nova tentativa, de falha real do modelo.

The Autonomous Computer: Infrastructure for Computer Use Agents

Agente de computador confiável mistura um modelo que se adapta com código que repete igual, e grava o que deu certo para gastar menos token.

Agentes 1:12:59 nível ●●●○○ Ang Li, Simular Assistir no YouTube (abre em nova aba)

Em 3 frases

Ang Li, da Simular, mostra a evolução dos agentes que usam o computador como uma pessoa: do Agent S baseado em árvore de acessibilidade até versões só com visão e várias tentativas em paralelo.

Ele afirma que o problema atual não é acertar uma vez, e sim acertar todas as vezes. Medido assim, mesmo os melhores agentes perdem cerca de 10% de sucesso em três execuções.

A proposta é o modo neuro-simbólico. O agente com visão explora, grava o fluxo que funcionou como código e o repete. Se algo quebra, volta ao modelo para consertar, e o custo em tokens cai.

Antes de ler

Mais 2 termos

Acertar uma vez engana; acertar sempre é a métrica

Li define o pass^k: rodar o agente k vezes e exigir sucesso em todas. Clientes que querem um fluxo diário sem vigiar precisam disso, e os benchmarks atuais não medem. Ao repetir três vezes, todos os agentes testados perderam cerca de 10% de sucesso, e com ambiente ou pedido alterado a queda foi maior.

Todos os agentes pioram quando precisam acertar em três execuções seguidas.19:00

Pedir esclarecimento antes de agir melhora a confiabilidade

Um truque simples do paper dele é instruir o agente a fazer perguntas sobre as partes ambíguas do pedido, com o mínimo de perguntas possível. Na comparação entre linha tracejada (sem perguntas) e linha cheia (com perguntas), todos os agentes melhoraram. Agent S com GPT-5 teve o maior ganho.

A linha cheia fica acima da tracejada em todos os agentes comparados.21:02

Código é estável, modelo com visão é adaptável

O agente de código gera scripts determinísticos, mas quebra quando a tela muda. O agente com visão se adapta, mas não repete o processo com fidelidade. Li chama isso de dilema estabilidade-plasticidade e busca um ponto intermediário na fronteira de Pareto, fundindo os dois numa abordagem neuro-simbólica.

Os dois tipos de agente ocupam extremos opostos da curva estabilidade versus adaptação.29:27
Mais 2 ideias deste talk

Computador reduzido a um problema de código

Na demo ao vivo, o Claude Code usa a linguagem Simulan para abrir o site da conferência, tirar um snapshot da árvore de acessibilidade e escrever o resumo em arquivo. Ao errar, o agente lê o erro e reescreve o código sozinho. O script final parece JavaScript comum.

27:22 O código gerado é JavaScript simples, que qualquer dev consegue ler.

Gravar o fluxo como skill e repetir com parâmetro

O agente achou o primeiro palestrante de terça, salvou o fluxo como skill e o repetiu para quarta só trocando o parâmetro. Num soluço no filtro, ele voltou ao modo com visão, terminou e seguiu. Li diz que na segunda execução cerca de 50% do trabalho sai de código, sem chamada ao modelo.

O replay roda o código salvo com o dia trocado e só chama o modelo quando falha.40:02
analogia

Dilema estabilidade-plasticidade (tensão entre repetir bem e se adaptar). O dilema estabilidade-plasticidade é como um cozinheiro que precisa escolher entre seguir a receita à risca, para o prato sair igual todo dia, e improvisar quando falta um ingrediente na despensa.

  1. Todo sistema que aprende quer duas coisas ao mesmo tempo. Ele quer repetir sem erro o que já sabe fazer e também quer aprender coisas novas.
  2. Estabilidade é a capacidade de repetir a mesma tarefa com o mesmo resultado. Plasticidade é a capacidade de se ajustar quando o ambiente muda.
  3. Ang Li estudou isso na DeepMind, na área de continual learning (aprendizado contínuo). A conclusão dele é que nenhum sistema fica ótimo nas duas coisas. Ganhar em uma custa perder um pouco na outra.
  4. Nos agentes que usam o computador, o agente de código fica no extremo estável. O script roda igual todo dia, mas quebra se a tela muda. O agente com VLM (modelo de visão e linguagem) fica no extremo adaptável, mas não repete o processo com fidelidade.
  5. A busca é por um ponto de equilíbrio na fronteira de Pareto, a curva dos melhores acordos possíveis entre as duas qualidades. A Simular tenta chegar lá com a abordagem neuro-simbólica, que roda código e só chama o modelo quando algo falha.

Ajuda saber antes: Computer use, VLM, Neuro-simbólico, pass^k

leitura crítica

O talk também é pitch dos produtos da Simular (beta fechado com código de convite no fim, linguagem Simulan e API de desktops na nuvem), e o palestrante é o CEO. Os números de pass^k e de clarificação vêm de papers da própria empresa, sem detalhe de amostra no vídeo. A demo ao vivo falhou e foi reiniciada, e Li admite que o modo replay é experimental e que tudo ainda é fase de demo. A afirmação de 100% de sucesso ao dar um SOP ao agente aparece sem dados. No OSWorld 2 o melhor modelo fica em 20%, o que relativiza o recorde humano anunciado.

O que fazer com isso

  • Meça seus agentes rodando a mesma tarefa várias vezes e conte só as execuções em que todas passam, em vez de olhar um único acerto.
  • Acrescente ao prompt de agentes uma instrução para perguntar sobre ambiguidades antes de executar, com o mínimo de perguntas, e compare com a versão sem isso.
  • Para tarefas repetitivas, peça ao agente de código que grave o fluxo como script ou skill, com parâmetros, e rode o script antes de chamar o modelo de novo.
  • Em ações irreversíveis, como pagamentos, coloque uma checagem por código e aprovação humana antes do agente executar.

Parameter Golf with AutoResearch

Autoresearch rende quando o eval é rápido, barato e difícil de burlar, e quando um humano acompanha a árvore de tentativas e corrige o rumo.

Agentes 34:13 nível ●●●○○ Vayum Arora, Zhengyao Jiang, Dixing Xu & Dhruv Srikanth, Weco AI Assistir no YouTube (abre em nova aba)

Em 3 frases

Autoresearch é um loop em que o modelo propõe mudanças no código, roda um eval (avaliação) fixo e guarda só o que melhora a nota.

A Weco AI conta que seu agente Aiden virou o maior contribuidor do Parameter Golf da OpenAI e monta uma versão reduzida do desafio para o público rodar ao vivo.

O workshop lista o que decide o resultado: arquivo editável, comando de eval, métrica com direção clara, limite de tempo, orientação inicial e intervenção humana durante a busca.

Antes de ler

Mais 2 termos

As peças de uma rodada de autoresearch

Toda rodada precisa de um arquivo que o agente pode alterar (no exemplo, solution.py com a configuração e o treino do modelo), um comando que avalia cada versão e devolve um único número, a métrica, a direção (subir ou descer) e o número de passos. O arquivo editável define o espaço de busca. O comando de eval imprime a nota no terminal, e é essa nota que guia o ciclo de tentativa e erro.

O contrato mínimo que qualquer sistema de autoresearch pede11:30

O eval é a peça mais importante

Os palestrantes pedem um eval rápido, barato e com pouco ruído. Rápido e barato permite mais tentativas dentro do mesmo orçamento, e mais tentativas trazem mais avanços. Pouco ruído dá confiança de que a melhora é real. Eles também alertam que agentes adoram reward hacking (burlar a recompensa), achando brechas no protocolo de avaliação. Por isso o eval precisa ser robusto.

Eval rápido e estável multiplica as tentativas úteis do agente12:30

Limite de tempo e orientação inicial

Cada avaliação precisa de um teto de tempo, porque o loop pode travar, o hardware pode falhar e o agente pode gerar código que trava tudo. No Mini Parameter Golf o teto é de 210 segundos (minuto 14:35). Antes de começar, vale passar ao agente um arquivo markdown com o que você já sabe, como restrições e ideias promissoras (compressão, quantização, compartilhar pesos entre blocos).

O orçamento de tempo por tentativa tem justificativa explícita14:40
Mais 2 ideias deste talk

Árvore de experimentos e controle humano

A busca da Weco tem forma de árvore. A raiz é o programa original com sua nota, e cada nó é uma versão modificada com nota própria. Ramos que melhoram ganham continuação, e ramos ruins são podados. Dá para abrir qualquer nó, ler o diff (as linhas alteradas) e, se a busca empacar, escrever uma ideia em linguagem comum para abrir um ramo novo.

Cada tentativa fica visível com sua mudança de código e sua nota17:45

O maior salto veio de uma ideia humana

No Parameter Golf, o agente ficou estagnado de 15 a 19 de abril testando atenção e compressão. Uma pessoa da comunidade publicou um tokenizer (divisor de texto em pedaços) novo. Em oito horas o sistema incorporou a ideia ao que já tinha e entregou o maior salto em semanas. O time conclui que autoresearch funciona melhor como colaboração do que no modo ligar e esquecer.

A ideia de fora destravou a busca que estava parada havia dias19:50
analogia

Bits per byte (BPB) (bits por byte, mede quão bem o modelo prevê texto). BPB é como contar quantas perguntas de sim ou não um jogador precisa fazer, em média, para adivinhar cada letra de um texto que ele está lendo.

  1. Um modelo de linguagem lê um texto e tenta adivinhar o próximo pedaço. O BPB mede quanto custa cada erro dessas apostas. Quanto menor o número, melhor o modelo prevê o texto.
  2. Um bit é a menor unidade de informação, como uma resposta de sim ou não. Um byte é o espaço que um caractere simples ocupa no computador, mais ou menos uma letra.
  3. Para cada trecho real, o modelo diz qual probabilidade dava a ele. Se apostou alto e acertou, gasta poucos bits. Se foi pego de surpresa, gasta muitos. No fim, soma os bits e divide pelo número de bytes do texto.
  4. A conta usa bytes em vez de tokens. Assim modelos com tokenizers (divisores de texto) diferentes ficam comparáveis, e trocar o tokenizer mantém a mesma régua.
  5. No Parameter Golf da OpenAI, a nota de cada envio era o BPB num conjunto de validação do FineWeb. Vencia quem chegava ao menor valor com até 16 MB de arquivos e 10 minutos de treino.
TEXTO DE VALIDAÇÃOTexto que o modelo nunca viu no treino
PREVISÃO DO MODELOProbabilidade para cada próximo pedaço
CONTA DE BITSSurpresa alta custa mais bits
DIVIDE POR BYTESTotal de bits sobre tamanho do texto
NOTA BPBMenor valor indica previsão melhor

Ajuda saber antes: Modelo de linguagem, Probabilidade, Tokenizer, Conjunto de validação

leitura crítica

O workshop vende a plataforma da Weco. A árvore, a observabilidade e o controle aparecem como diferenciais dela, e a parceria com a Modal fornece créditos. Os números do Parameter Golf são autodeclarados, sem fonte externa na fala, e parte deles saiu truncada na legenda. A história do tokenizer é um único caso. A demo ao vivo falhou por causa da internet, então o público quase não viu o loop rodar nem o direcionamento funcionar. Na competição, um jogador com um só nó já liderava, o que mostra como o reward hacking aparece rápido.

O que fazer com isso

  • Antes de soltar um agente em loop, escreva um comando que avalia o resultado e imprime um único número, com direção clara (subir ou descer).
  • Rode o eval várias vezes sem mudar nada para medir o ruído, e coloque um limite de tempo por tentativa para o loop não travar.
  • Separe um conjunto de validação escondido do agente e restrinja quais arquivos ele pode editar, para reduzir o reward hacking.
  • Escreva um arquivo markdown com restrições e ideias que você já sabe que funcionam, e revise as tentativas no meio da busca para corrigir o rumo.

How to Build Quality Gates into Agentic Coding Workflows

Agente de código só merece confiança com plano estruturado, regras versionadas e revisão que o obrigue a corrigir o que errou.

Engenharia de software 57:45 nível ●●●○○ Nnenna Ndukwe, Qodo AI Assistir no YouTube (abre em nova aba)

Em 3 frases

Nnenna Ndukwe, da Qodo, mostra um workshop em que um agente de código implementa um fluxo de reembolso numa API de pagamentos, passando por plano, testes locais e revisão do pull request.

Cada etapa tem uma barreira (quality gate) que usa as mesmas regras e skills: templates de plano, linters, análise estática, revisão da Qodo no GitHub e uma skill que corrige os achados.

A palestrante defende combinar checagens determinísticas com IA e guardar regras fora do repositório local. Boa parte da demonstração usa a própria ferramenta da Qodo, então vale ler com atenção ao pitch.

Antes de ler

Mais 2 termos

Quatro barreiras do plano ao PR

O fluxo tem quatro gates. Padrões (regras e skills), planejamento com TDD, verificação local (ruff, pyright, bandit, pytest, semgrep, conventional commits) e revisão do pull request com remediação. A autora insiste em não parar no teste local passando.

Os gates do workshop, das regras até a remediação no PR.12:32

Template de plano que o agente precisa seguir

Há um plano de alto nível e um plano de execução da build. Eles trazem resumo, restrições, roteamento de skills, cenários, gates de verificação, regras de falha e plano de commits. Segundo a palestrante, quanto mais estruturado o plano, melhor o agente se corrige.

O template de plano lista seções que o agente deve preencher antes de codar.25:53

Regras com categoria e severidade

No portal, as regras aparecem por categoria (segurança, correção, manutenibilidade, arquitetura, acessibilidade) e por severidade. Só as mais graves bloqueiam o merge. Regras podem ser inferidas do código, mas um humano revisa e ativa cada uma.

Regras divididas por categoria e severidade, nem todas bloqueiam merge.33:51
Mais 2 ideias deste talk

Revisão do PR com bug e violações de regra

No PR de teste, a Qodo apontou um bug, três violações de regra e dois insights de skill. O bug era a idempotência do reembolso guardada num dicionário em memória, que some quando o processo reinicia.

Achados da revisão, incluindo o reembolso idempotente guardado só em memória.47:26

Skill que resolve os achados e roda a verificação

A skill PR resolver baixa os problemas do PR e oferece revisar um a um ou corrigir tudo. Depois roda a verificação, faz os commits e posta um resumo no PR. A plateia lembra que vale rodar a verificação de novo após as correções.

A skill escolhe entre revisão item a item e correção automática de todos.49:39
leitura crítica

O talk é um workshop da Qodo e mostra a ferramenta da própria empresa como solução central. A única evidência de resultado é um relato pessoal de um PR grande com um bug achado, sem comparação com outras ferramentas nem taxa de falsos positivos. A palestrante admite que a seleção de regras não é determinística e que a Qodo não avalia a qualidade das skills. Ela cita Tessl como opção para isso. O PR do reembolso usou pouco código revisado ao vivo.

O que fazer com isso

  • Faça fork do repositório do workshop e peça ao seu agente para analisar a estrutura e sugerir o que aplicar ao seu fluxo.
  • Crie um template de plano com resumo, restrições, regras aplicáveis, testes e comandos de verificação, e exija que o agente o preencha antes de codar.
  • Combine linter, análise estática e testes com a revisão por IA, e defina quais regras bloqueiam merge e quais só avisam.
  • Rode a verificação de novo depois de cada rodada de correção automática do agente.

SonarQube + OpenAI: Agentic Development

O gargalo saiu de gerar código e foi para verificá-lo, então a checagem de segurança precisa rodar dentro do loop do agente.

Engenharia de software 41:57 nível ●●●○○ Killian Carlsen-Phelan, Sonar Assistir no YouTube (abre em nova aba)

Em 3 frases

A abertura da OpenAI defende que tarefa concluída exige evidência, que sandbox não prova que o código está correto e que a verificação deve ficar dentro do loop do agente.

Killian Carlsen-Phelan, da Sonar, mostra ao vivo um projeto Python com chave de API exposta e SQL injection, ligado ao Codex por plugin, hooks, skills e servidor MCP.

O fluxo guide, verify e solve bloqueia segredo no prompt, lista os problemas do painel, corrige a consulta com query parametrizada e reanalisa a edição automaticamente.

Antes de ler

Mais 1 termo

Concluído exige evidência

O representante da OpenAI define pronto como um diff revisável mais evidência de ferramenta, e não só o agente dizer que corrigiu. Autocrítica do modelo não funciona como juiz independente, porque o agente e o verificador podem errar do mesmo jeito. A revisão humana continua no ciclo.

01:16 Definição de pronto: diff revisável e evidência de ferramenta.

Contenção não é correção

A camada de execução define o que o agente pode fazer: ferramentas, escopo e aprovações. A camada de artefato avalia se o resultado é aceitável. Um sandbox contém uma escrita, mas não prova que uma query é segura. Por isso se empilham controles com fronteiras diferentes.

02:51 Sandbox limita o dano, mas não valida o código gerado.

Guide, verify e solve

A Sonar divide o ciclo em gerar, guiar, verificar e resolver. Guide injeta regras e arquitetura do projeto antes da geração. Verify checa segurança e qualidade logo após a edição. Solve corrige o problema achado. A ideia é verificar no IDE (loop interno) e não esperar a falha no CI (loop externo).

Ciclo de desenvolvimento centrado em agente, com três etapas da Sonar.08:39
Mais 2 ideias deste talk

Taint analysis mostra o caminho da falha

No projeto de exemplo, um argumento vindo de sys.argv entra direto em uma f-string executada no banco. O SonarQube usa análise de fluxo de dados (taint analysis) para rastrear a entrada do usuário até a execução da query, entre arquivos e funções. A nota de segurança do projeto é E.

O painel traça a entrada do usuário até a query vulnerável.21:19

Hook bloqueia segredo e reanalisa a correção

Ao pedir ao Codex para fazer commit com um token falso, o hook de detecção de segredos bloqueia o prompt antes de ele chegar ao modelo. Depois, o pedido para corrigir a issue S8702 gera uma query parametrizada, e um hook pós-edição reanalisa só o código alterado. Um participante lembra que o hook atua no envio do prompt e pode ser contornado.

O hook barra o segredo antes de ele entrar no contexto do modelo.27:15
analogia

Taint analysis (análise de contaminação de dados). Taint analysis é como pingar corante na água de uma cozinha para ver por quais canos ela passa até chegar à panela.

  1. Todo dado que vem de fora do programa, como o texto que alguém digita, é tratado como suspeito. A ferramenta marca esse dado como contaminado (tainted).
  2. A análise segue esse dado marcado enquanto ele passa de variável em variável, de função em função e até de um arquivo para outro.
  3. O ponto onde o dado entra se chama fonte (source). O ponto perigoso onde ele é usado se chama destino (sink), por exemplo o comando que executa uma consulta no banco.
  4. Se o dado chega ao destino sem passar por uma limpeza ou proteção, a ferramenta aponta a falha. No exemplo do vídeo, um argumento de sys.argv vai direto para uma f-string executada no banco, o que abre caminho para SQL injection.
  5. O SonarQube faz isso lendo o código sem executá-lo, com análise estática e execução simbólica (symbolic execution), e mostra no painel o caminho completo da fonte até o destino.
FONTEDado externo entra, como sys.argv
MARCAÇÃOO dado recebe a marca de suspeito
PROPAGAÇÃOSegue por funções e arquivos
DESTINOChega à execução da query no banco
ALERTA COM CAMINHOPainel mostra a falha e o trajeto

Ajuda saber antes: SQL injection, Análise estática de código, Entrada do usuário, Query parametrizada

leitura crítica

A fala é demonstração de produto da Sonar, em parceria com a OpenAI, e a venda aparece o tempo todo. Os números de pesquisa (42% e 96%) vêm de uma pesquisa da própria Sonar, sem metodologia detalhada. A demo usa um projeto de menos de 200 linhas com falhas plantadas, o que não mostra taxa de falsos positivos em código real. Context augmentation e agentic analysis não estão no plano gratuito. A rede ruim atrapalhou a demo, e o hook de segredos só atua no envio do prompt, como o próprio palestrante admitiu.

O que fazer com isso

  • Rode um scanner de segredos e de SQL injection (como SonarQube ou similar) sobre um repositório pequeno seu e anote o que ele acha antes de pedir correção a um agente.
  • Defina para cada tarefa de agente o que conta como pronto, com diff revisável e um teste ou análise independente, em vez de aceitar um simples 'corrigido'.
  • Configure um hook que bloqueie chaves de API no prompt do seu agente de código e teste com um token falso.
  • Mantenha segredos fora do código, em variáveis de ambiente, e revise queries que usam f-string com entrada do usuário.

The SDLC You Build Yourself

A Atlassian põe agentes nas pontas do ciclo (planejar, revisar, operar), com contexto da organização e freios de custo e de revisão.

Engenharia de software 57:48 nível ●●●○○ Andy Wong, Andrei Bocan & Shane Wolf, Atlassian Assistir no YouTube (abre em nova aba)

Em 3 frases

A Atlassian apresenta seu conjunto de agentes (coding agent no Jira, AI Reviewer, AutoDev, AI Planner e AI SRE), todos apoiados por um context engine que liga Jira, Confluence, Slack e código.

Na demo, uma regra de engenharia vira um standard (padrão) aplicado automaticamente nos pull requests dos repositórios escolhidos, em vez de ser cobrada à mão em cada revisão.

Boa parte do workshop virou conversa por causa de uma falha de Wi-Fi, e as respostas tratam de autoridade da informação, sandbox, roteamento de modelos, limites de custo e checagens determinísticas.

Antes de ler

Mais 2 termos

Foco nas pontas do código, não no código

O argumento inicial é que os ganhos de produtividade dos assistentes de código estão se estabilizando. Por isso a empresa investe no que vem antes e depois da escrita: planejamento, orquestração, revisão de código e operações.

Mapa dos agentes da Atlassian ao longo do SDLC.01:45

Revisão com menos ruído

O AI Reviewer usa modelos treinados pela própria empresa para filtrar comentários de baixo valor. A métrica mostrada é a taxa de resolução dos comentários, que ficou perto da de revisores humanos. É um dado interno da empresa.

Resolução de comentários da IA próxima à de humanos.05:56

Context engine e autoridade da informação

O engine conecta Jira, Confluence, Bitbucket, Slack e Notion por grafos e faz busca agêntica sobre tudo isso. Documentos ficam velhos, então o código vale como verdade atual. Para conflitos, um humano marca fontes como verificadas, como o selo de verificado do Confluence.

09:36 Contexto central que alimenta todos os agentes.

Mais 2 ideias deste talk

Standards como regra reutilizável de revisão

Na demo, o padrão de design tokens é criado com descrição e regras em texto, e aplicado a repositórios escolhidos manualmente ou por padrão de nome. O agente comenta nos pull requests que violam a regra. Um ouvinte pergunta por checagens determinísticas de CI, e a resposta é que isso ainda não existe.

Como se cria um standard e se escolhe onde ele vale.37:14

AutoDev com freios de custo e de revisão

O AutoDev pega itens do backlog que o agente consegue resolver sozinho e abre PRs. Há limite de gasto por ticket e por semana, limite de PRs por pessoa e pedido de esclarecimento humano para tickets mal especificados. O motivo é que a revisão é onde o trabalho autônomo costuma emperrar.

Limites de custo e de carga de revisão no AutoDev.41:54
leitura crítica

É em boa parte pitch de produto da Atlassian, com a plataforma própria como solução para quase tudo. A única métrica de qualidade (resolução de comentários perto da linha humana) vem da própria empresa, sem metodologia nem amostra. Não há dados de custo por PR do AutoDev. Vários recursos aparecem como planejados (roteamento inteligente, relatório de crédito por tarefa, checagens determinísticas). A demo prática foi prejudicada pelo Wi-Fi.

O que fazer com isso

  • Liste os padrões de engenharia da sua equipe que hoje dependem de lembrança do revisor e escreva cada um como regra curta em texto para um revisor de IA aplicar.
  • Ao usar agentes sobre o backlog, defina antes um limite de PRs por pessoa por semana e um teto de custo por ticket, para a revisão não virar gargalo.
  • Escreva critérios de aceitação em checklist nos tickets e deixe no repositório as instruções de como rodar o projeto, para o agente conseguir verificar o próprio trabalho.
  • Marque quais documentos são fontes verificadas e prefira o código atual a documentos antigos quando passar contexto a um agente.

The Lethal Trifecta Is Already on Your Laptops

Agente com dados privados, conteúdo externo e acesso à internet ao mesmo tempo vai causar incidente. Isole o ambiente, filtre o tráfego e bloqueie comandos.

Agentes 20:43 nível ●●○○○ Michael Patterson, Coder Assistir no YouTube (abre em nova aba)

Em 3 frases

Michael Patterson, da Coder, explica a lethal trifecta (tríade letal): um agente de código num laptop acessa dados privados, lê conteúdo não confiável e se comunica com a internet, tudo ao mesmo tempo.

Ele diz que prompt injection e context poisoning podem escalar os privilégios do agente, e que grandes empresas travam a adoção por causa de CISOs, shadow AI, alert fatigue e engenheiros céticos.

Como resposta, propõe três proteções: ambientes de desenvolvimento na nuvem isolados, um model proxy que registra e limpa o tráfego, e um agent firewall que nega comandos e domínios não autorizados.

Antes de ler

Mais 2 termos

Os três ingredientes da lethal trifecta

O termo vem de Simon Willison. Um agente num laptop tem acesso a dados privados (arquivos, credenciais, bancos de dados), lê conteúdo da internet e consegue enviar dados para fora. Patterson diz que uma peça isolada não preocupa, mas duas já são inaceitáveis em empresa e as três juntas levam a um incidente.

As três condições que, juntas, tornam o agente explorável.05:56

Fontes confiáveis viram vetor de ataque

Mensagens de erro, tickets de suporte e logs de CI/CD parecem seguros, mas qualquer pessoa pode escrever instruções maliciosas neles. O agente trata o texto como verdade (prompt injection). O mesmo vale para documentação e dados adulterados (context poisoning). Como o agente costuma ter acesso amplo, o ataque escala privilégios e pode apagar tabelas ou publicar dados.

Os três cenários de ataque que o palestrante usa como exemplo.06:58

Três pilares de segurança para agentes

O palestrante resume a defesa em controlar o acesso a dados, restringir a comunicação externa e travar permissões e credenciais. Defende que isso se parece com segurança comum: máquina separada, ambiente protegido, tráfego interceptado e alerta quando o agente sai do perímetro.

O modelo de defesa que organiza o resto da palestra.08:00
Mais 2 ideias deste talk

Shadow AI e o que trava a adoção

Sem aprovação do CISO (chefe de segurança) e do DevOps, muita gente usa assinaturas pessoais no laptop da empresa. Patterson chama isso de shadow AI e cita um termo emergente, ninja AI, para o mesmo problema em escala. Ele lista também as dúvidas de quem opera: observabilidade, alert fatigue e repetibilidade. Engenheiros seniores temem dívida técnica e responsabilização.

Por que times usam agentes às escondidas quando a empresa não libera.11:10

Três guardrails de arquitetura

O primeiro é rodar o agente num ambiente de desenvolvimento na nuvem, com credenciais e dados limitados ao que foi colocado lá. O segundo é um model proxy entre o agente e o provedor de LLM, que registra tudo e remove dados sensíveis. O terceiro é um agent firewall que olha os processos e nega comandos como gh repo delete ou drop table.

O desenho do model proxy entre agente e provedor de LLM.18:22
leitura crítica

A palestra é pitch da Coder, que vende ambientes de desenvolvimento remotos, e as três soluções apontam para produtos dessa linha. Não há dado de incidentes, taxa de ataques bem-sucedidos nem teste dos guardrails. O caso do banco de dados apagado vem de um post no Twitter, sem verificação. O firewall de comandos por lista de permissão pode ser contornado por comandos equivalentes, e o palestrante não discute isso. Não houve demo.

O que fazer com isso

  • Para cada agente que você usa, marque quais dos três ingredientes ele tem: dados privados, conteúdo não confiável e saída para a internet. Remova pelo menos um.
  • Rode agentes de código em VM ou container sem acesso aos seus arquivos pessoais, com credenciais de escopo mínimo e só os domínios necessários liberados.
  • Não cole dados de clientes, cartões ou segredos em prompts. Se a empresa tiver gateway de LLM, peça que ele registre o tráfego e filtre dados sensíveis.
  • Se sua empresa ainda não autoriza agentes, leve ao time de segurança um caso de uso concreto e a proposta de ambiente isolado, em vez de usar conta pessoal no laptop de trabalho.

Your Agent Is a Lethal Trifecta (And What to Do About It)

Agente seguro precisa de credencial curta, atrelada ao usuário e à tarefa. Chave fixa e botão de aprovação sozinhos não seguram o risco.

Agentes 25:08 nível ●●●○○ Kim Maida, Keycard Assistir no YouTube (abre em nova aba)

Em 3 frases

Kim Maida mostra um agente de plantão que usa chaves de API fixas e senha de administrador. Ele apaga um banco de cobrança, reinicia um servidor de produção e escala um serviço de 4 para 40 pods.

Ela propõe o token exchange (troca de tokens) do OAuth: um serviço de tokens de segurança confere política, identidade do usuário e do agente, e emite credenciais que expiram em minutos e valem para uma única chamada.

Na segunda demo, a política nega acesso a dados de clientes e a exclusão do banco, libera a renovação do certificado e bloqueia o restart mesmo após aprovação, porque o papel do usuário não permite a ação.

Antes de ler

Mais 2 termos

Chave fixa apaga quem fez o quê

Na primeira demo, o agente chama a API de incidentes, o data warehouse e o banco com chaves estáticas. O log de auditoria não diz quem usou cada chave, e o relatório da manhã despeja dados pessoais de clientes no ticket. O problema nasce do excesso de acesso dado de antemão.

01:02 O log mostra chaves fixas e dados pessoais no relatório, sem identidade de quem agiu.

A trifeta letal

Dados privados, conteúdo não confiável (tickets) e comunicação externa tornam o agente útil e perigoso ao mesmo tempo. Maida rejeita remover uma das três capacidades, porque o agente perde utilidade. Ela propõe controlar o acesso para conter o raio de dano.

As três capacidades juntas formam o risco descrito por Simon Willison.04:50

OAuth, gateway e sandbox deixam acesso permanente

OAuth concede permissões antes de existir a tarefa. O gateway MCP segura credenciais permanentes. O sandbox limita o processo, mas o trabalho útil sai dele. Nenhum entrega ao agente uma credencial reduzida a uma só tarefa, e a aprovação humana sozinha cansa o usuário.

Cada controle prende o acesso a algo diferente, e nenhum limita por tarefa.07:26
Mais 2 ideias deste talk

Cada chamada pede um token curto ao STS

O token do usuário vira subject token. O runtime do agente se autentica no security token service (STS), envia esse token e pede acesso a uma única chamada de ferramenta. O STS avalia política, cadeia de delegação e acesso pedido, e devolve um token que expira em minutos e não é guardado.

O diagrama mostra o STS decidindo cada troca de token entre agente, MCP e recurso.13:19

A política bloqueia o que o usuário não pode fazer

Na segunda demo, o STS nega a consulta a dados de clientes e a exclusão do banco. A renovação do certificado passa. O restart de produção é bloqueado mesmo após clique em aprovar, porque o papel do usuário não permite. O escalonamento passa porque o papel permite.

O restart fica negado após a aprovação, pois o papel do usuário não tem essa autoridade.22:44
analogia

Token exchange (troca de tokens (extensão do OAuth 2)). A troca de tokens é como trocar o crachá de visitante na portaria por uma pulseira que só abre uma sala e vence no fim da tarde.

  1. Um token é um comprovante digital que diz quem você é e o que pode fazer, como um crachá.
  2. Quando você faz login, o servidor de autorização (authorization server) entrega ao agente um token com só parte das suas permissões, chamadas escopos (scopes).
  3. Na hora de usar uma ferramenta, o agente envia esse token, chamado subject token (token do sujeito), e pede outro bem mais restrito.
  4. O pedido vai a um serviço de tokens de segurança, que devolve um token novo válido para uma única chamada e por poucos minutos.
  5. O padrão token exchange saiu em 2020 como extensão do OAuth 2 (RFC 8693). O token novo mantém a identidade do usuário, o que permite auditar quem agiu.
LOGIN DO USUÁRIOGera token com escopos delegados
PEDIDO DE TROCAAgente envia o subject token ao STS
CHECAGEM DE POLÍTICASTS confere usuário, agente e acesso
TOKEN EFÊMEROVale para uma chamada e expira rápido

Ajuda saber antes: OAuth, Token de acesso, Escopos (scopes), Security token service (STS)

analogia

Security token service (STS) (serviço de tokens de segurança). O STS é como o guichê do almoxarifado que confere o pedido assinado pelo chefe e entrega só a ferramenta daquela tarefa, com prazo de devolução.

  1. O STS é um servidor que entrega credenciais temporárias, sob pedido, para cada ação do agente.
  2. O runtime do agente, o programa que roda o ciclo do agente, se apresenta ao STS com a credencial do aplicativo ou com uma identidade de carga (workload identity).
  3. Junto, o runtime envia o token do usuário e o pedido de acesso a uma ferramenta específica.
  4. O STS avalia a política de governança, a cadeia de delegação (quem age em nome de quem) e o acesso pedido. Se tudo passa, emite um token que expira em minutos.
  5. Se o servidor MCP precisa de um recurso externo, ele volta ao STS e troca esse token por outro restrito à mesma chamada, mantendo o usuário registrado.
RUNTIME SE IDENTIFICAMostra credencial do app e do usuário
AVALIAÇÃOPolítica, delegação e acesso pedido
EMISSÃO DO TOKENEscopo de uma chamada, poucos minutos
RECURSO ACESSADOToken descartado após o uso

Ajuda saber antes: Token exchange, OAuth, Servidor MCP, Política de acesso

analogia

Intent based authorization (autorização baseada em intenção (proposta, não é padrão)). A autorização por intenção é como a ordem de serviço do mecânico, que lista o conserto combinado e impede trocar outras peças sem nova assinatura do cliente.

  1. Antes de agir, o agente descreve o que pretende fazer, e um sistema confere se isso bate com o pedido do usuário.
  2. Essa descrição se chama missão (mission) e traz um objetivo, as ações permitidas e os limites.
  3. No talk, a missão de triar o incidente 2294 permite ler esse ticket e resumir ou escalar, mas proíbe ler outros tickets e usar outros serviços.
  4. O STS aprova sozinho as missões de baixo risco e manda as arriscadas, como escalar um serviço, para o usuário revisar. Depois dá um ID à missão.
  5. Cada chamada de ferramenta leva esse ID, e o gateway pergunta ao STS se ela cabe na missão antes de pedir a troca de token. A IBA ainda é proposta, sem padrão fechado.
PROMPT DO USUÁRIOPedido em linguagem natural
MISSÃO PROPOSTAObjetivo, ações permitidas e limites
APROVAÇÃOAutomática ou revisada pelo usuário
CHECAGEM POR CHAMADAGateway confere o ID da missão
TOKEN LIBERADOSó se a chamada cabe na missão

Ajuda saber antes: Security token service (STS), Token exchange, MCP gateway, Human in the loop

leitura crítica

Maida é head de DevRel da Keycard, que vende o STS e a autorização por intenção, então o talk também é pitch. Ela admite que a intenção ainda é proposta e que a demo usa política por tarefa. As demos são encenadas, sem dados de incidentes reais nem medição de falhas evitadas. Não há custo de latência da troca de token a cada chamada, nem esforço de configurar política. Prompt injection só aparece como risco geral, sem teste.

O que fazer com isso

  • Liste as chaves de API e senhas que seus agentes usam hoje. Troque as de administrador por credenciais com escopo mínimo e prazo curto.
  • Registre no log de auditoria o usuário e o agente por trás de cada chamada. Sem isso, você não sabe quem agiu.
  • Defina em política quais ações o agente nunca faz sozinho, como apagar banco ou acessar dados pessoais. Não deixe isso só para o botão de aprovar.
  • Pergunte ao seu provedor de identidade e de MCP se ele suporta token exchange (RFC 8693) antes de montar uma solução própria.

Sandboxes Aren't Optional: 4 Ways to Isolate Coding Agents

Agente de código herda tudo o que você acessa. Isole cada agente com o mínimo necessário e escolha o sandbox pela escala.

Infraestrutura 14:22 nível ●●●○○ Robert Brennan, OpenHands Assistir no YouTube (abre em nova aba)

Em 3 frases

Robert Brennan, CEO da OpenHands, diz que as empresas estão tirando agentes de código do laptop e levando para a nuvem em 2026, e que isso exige sandbox (ambiente isolado).

Ele compara quatro formas de isolar: Docker no laptop, Claude Code no GitHub Actions, uma VM ou Mac Mini dedicada e um pod de Kubernetes por sessão, avaliando local ou remoto, escala, isolamento, persistência e gatilhos.

Ele admite que sandbox não é garantia, porque há fugas de container e um caso relatado durante testes do modelo Mythos, e fecha com uma propaganda do OpenHands Agent Canvas.

Antes de ler

Mais 2 termos

Permissões puladas expõem tudo o que você acessa

Rodar o agente local com dangerously skip permissions dá a ele seu sistema de arquivos, variáveis de ambiente com segredos, arquivos na home e qualquer banco ou cluster de produção em que você esteja conectado. A alternativa é aprovar cada ação à mão, o que obriga a vigiar o agente o tempo todo.

Sem sandbox, o agente acessa tudo o que o usuário acessa.04:08

Menor privilégio limita o estrago

Brennan aplica ao agente um princípio antigo de segurança: dar só o acesso necessário ao trabalho, como o repositório em edição e um ou dois segredos. Assim, se houver prompt injection ou confusão do agente, o dano fica restrito a esse recorte.

O sandbox define o raio de dano de um erro ou ataque.04:52

Docker local é seguro e simples, mas não escala

Um container por conversa é descartável: se o agente apagar tudo, você destrói o container e recomeça. Dá para montar só o repositório, portas e segredos escolhidos. O limite é o laptop, que comporta poucos containers e não escuta eventos de Slack ou DataDog.

Docker local isola bem, mas depende de uma máquina e de comandos manuais.05:42
Mais 2 ideias deste talk

VM compartilhada reintroduz o problema de privilégio

Uma VM ou Mac Mini dedicada dá persistência e recebe webhooks, mas junta todos os agentes no mesmo ambiente. Um agente de revisão de código pode ganhar acesso ao DataDog ou editar a memória de outro agente. O ambiente também pode degradar com o tempo.

Agentes co-localizados compartilham acessos e atrapalham uns aos outros.08:47

Tabela comparativa das quatro estratégias

Brennan compara as opções em cinco eixos: local ou remoto, escala, isolamento, persistência e gatilhos. Kubernetes com um pod por sessão aparece como a opção mais robusta: isolamento por agente, escala na casa dos milhares e execução por agenda ou evento.

O mesmo quadro mostra o trade-off entre conveniência local e isolamento em nuvem.11:02
analogia

Container escape (fuga do container). Container escape é como um aluno de castigo que acha uma porta destrancada no fundo da sala e passa a andar pela escola inteira.

  1. Um container é uma caixa fechada dentro do computador. O programa que roda ali só deveria ver o que está dentro da caixa.
  2. Todas as caixas dividem o mesmo sistema de base da máquina, chamado kernel (núcleo do sistema operacional). As paredes da caixa dependem desse núcleo.
  3. Uma fuga do container (container escape) acontece quando o programa explora uma falha nessas paredes e sai da caixa.
  4. Fora da caixa, ele alcança arquivos, segredos e a rede da máquina hospedeira. Para um agente de IA, isso desfaz o isolamento que o sandbox prometia.
  5. Muitas falhas desse tipo já são conhecidas e afetam versões antigas do Docker. Manter tudo atualizado e dar ao agente o mínimo de acesso reduz o risco.
AGENTE NO CONTAINERSó vê o que foi montado na caixa
ACHA UMA FALHAEx.: versão antiga do Docker
ROMPE A PAREDESai para a máquina hospedeira
ACESSO AMPLOArquivos, segredos e internet

Ajuda saber antes: Container Docker, Sandbox, Princípio do menor privilégio

leitura crítica

O talk usa a insegurança do modo sem permissões para vender a plataforma da OpenHands, e o fecho é propaganda do Agent Canvas. As comparações são qualitativas, sem teste, custo ou medição de incidentes. A fuga do Mythos é citada de passagem, sem fonte. GitHub Actions e Kubernetes são descritos em linhas gerais, sem custo de operar o cluster.

O que fazer com isso

  • Liste o que seu agente local alcança hoje: pastas, variáveis de ambiente com segredos e acessos a produção. Retire o que ele não precisa.
  • Se usa dangerously skip permissions, rode o agente dentro de um container Docker com só o repositório montado e segredos mínimos.
  • Para tarefas agendadas ou por evento, como revisão de PR, teste GitHub Actions antes de montar infraestrutura própria.
  • Evite juntar agentes com funções diferentes na mesma VM. Dê a cada um seu ambiente e seus próprios segredos.

1,000 Agent Tasks in a Sandbox: What Breaks When LLMs Run Code

Se o seu agente roda em sandbox, teste a plataforma com mil tarefas reais e remotas: os limites do ambiente decidem se ele termina o trabalho.

Infraestrutura 15:19 nível ●●●○○ Kevin Orellana, AWS Assistir no YouTube (abre em nova aba)

Em 3 frases

Kevin Orellana, da AWS, apontou um agente de código para o sandbox da sua equipe (Amazon Bedrock AgentCore) e mandou ele quebrar tudo durante a noite, com mil testes em 10 domínios.

Os defeitos caíram em duas camadas: a de interface (bug de codificação no servidor MCP, byte nulo) e a do sandbox (memória, permissões de arquivo, chamadas de sistema bloqueadas).

A conclusão é que limites baixos do sandbox, como memória e permissões, decidem se um agente consegue cumprir a tarefa, e por isso vale fazer fuzz test (teste com entradas variadas) remoto, não só local.

Antes de ler

Mais 2 termos

Usar um agente de código como cliente de teste da plataforma

A equipe envolveu o sandbox e o navegador em nuvem em um servidor MCP (protocolo que expõe ferramentas a agentes). Depois pediu a um agente de código que escrevesse e rodasse mil testes em 10 domínios. O número mil foi arbitrário, escolhido para lançar uma rede larga e ver o que voltava.

O desenho mostra agente, MCP, sandbox e SQLite ligados em um fluxo simples.03:09

Resultados em banco de dados, não em markdown

Agentes tendem a gravar arquivos markdown, mas isso não escala com mil testes. O SQLite permitiu rodar vários subagentes em paralelo no computador local, cada um gravando seu resultado no mesmo lugar para consulta depois.

Cada ponto é um fluxo que um cliente real rodaria, como gerar PDF ou treinar um modelo.03:40

Falhas de interface versus falhas de sandbox

Três falhas ilustram a divisão. Uma imagem enviada voltava diferente por erro de codificação no MCP. Um byte nulo derrubou testes. Arquivos gravados num diretório específico do sandbox não podiam ser lidos depois. As duas primeiras são da camada de interface, a terceira do sandbox.

As falhas foram separadas em duas camadas, o que muda quem precisa corrigir.05:13
Mais 2 ideias deste talk

Navegador esgota memória, interpretador de código não

Ao comparar duas aplicações hospedadas, o navegador em nuvem falhou muitas vezes por falta de memória, porque abrir várias abas pesa. O interpretador de código quase não teve esse problema. Cada aplicação exige coisas diferentes do mesmo tipo de ambiente.

As falhas em vermelho do navegador vêm de memória; o sandbox de código quase não as tem.07:51

Primitivas do sandbox decidem o que o agente consegue fazer

Permissões de arquivo, sistema de arquivos persistente ou efêmero, seccomp (filtro de chamadas de sistema) e programas eBPF controlam se um processo pode abrir outro processo, instalar um pacote ou fazer chamadas de saída. Detalhes pequenos somam e impedem o agente de resolver o problema de negócio.

O slide lista as peças do sandbox onde as falhas se concentram.09:24
analogia

Seccomp (filtro de chamadas de sistema do Linux). Seccomp é como o crachá de um funcionário temporário, que só abre as portas da lista aprovada pela empresa e deixa todas as outras fechadas.

  1. Todo programa precisa pedir ao sistema operacional para fazer coisas básicas, como abrir um arquivo, acessar a rede ou iniciar outro programa.
  2. Esses pedidos se chamam chamadas de sistema (system calls, ou syscalls). O Linux tem centenas delas, e o kernel (núcleo do sistema) atende cada uma.
  3. O seccomp (secure computing, computação segura) é um recurso do Linux que define quais chamadas um processo pode fazer. As que ficam fora da lista são negadas ou encerram o processo.
  4. Num sandbox (ambiente isolado), esse filtro reduz o estrago que um código malicioso pode causar. O custo é que tarefas legítimas também podem esbarrar no bloqueio.
  5. No talk, um pacote de machine learning que precisa abrir um novo processo falha se o filtro proibir essa chamada. O agente trava mesmo com o código dele correto.
PROGRAMA PEDE AÇÃOEx.: abrir um novo processo
FILTRO SECCOMPConfere a lista de chamadas permitidas
KERNEL EXECUTA OU NEGAA tarefa segue ou falha

Ajuda saber antes: Sandbox, Kernel, Chamada de sistema, Processo

analogia

eBPF (programas que rodam dentro do kernel para interceptar ações). eBPF é como um guarda de trânsito posto num cruzamento da cidade, que observa cada carro e pode parar ou desviar alguns sem precisar reconstruir a rua.

  1. O kernel é o núcleo do sistema operacional. Ele controla memória, arquivos, rede e processos de todos os programas da máquina.
  2. Mudar o comportamento do kernel costumava exigir recompilar o sistema ou instalar módulos arriscados, que podiam derrubar a máquina inteira.
  3. O eBPF (extended Berkeley Packet Filter, filtro de pacotes estendido) permite carregar pequenos programas que rodam dentro do kernel. Um verificador checa cada programa antes, para ele não travar o sistema.
  4. Esses programas se prendem a eventos, como uma conexão de rede ou a abertura de um arquivo. Ali eles registram, liberam ou bloqueiam a ação.
  5. Em sandboxes de agentes, o eBPF pode decidir se o agente faz chamadas de saída (egress) para a internet ou para APIs internas da empresa.
PROGRAMA CARREGADOPequeno código enviado ao kernel
VERIFICADOR DO KERNELCheca se o código é seguro
GANCHO NO EVENTOEx.: conexão de rede do agente
AÇÃO LIBERADA OU BARRADAO agente segue ou é bloqueado

Ajuda saber antes: Kernel, Sandbox, Egress (tráfego de saída)

leitura crítica

O talk vem de um engenheiro da AWS e inclui um aviso do próprio produto (acesso SSH aos sandboxes do AgentCore). Não há taxa de falha, número de bugs ou comparação com outro método de teste, só três exemplos escolhidos. Os mil testes foram gerados por um LLM, e o próprio palestrante admite que o número era arbitrário. A citação sobre o estudo de Berkeley que chegou a 100% em benchmark de agentes de código aparece sem título ou link, então não dá para checar.

O que fazer com isso

  • Se você hospeda agentes em sandbox, peça a um agente de código para gerar centenas de fluxos reais (instalar pacote, gravar e ler arquivo, abrir processo) e rodar no ambiente remoto, não só no seu computador.
  • Grave os resultados de testes de agentes em um banco simples como SQLite, com campo para a camada da falha, em vez de arquivos markdown soltos.
  • Ao analisar uma falha, classifique primeiro se veio da interface (codificação, formato) ou do sandbox (memória, permissão), para saber quem corrige.
  • Compare as ferramentas e permissões do seu ambiente local com as do sandbox remoto antes de migrar um agente de código para a nuvem.

How Secrets Leak Through AI Agents (and How to Stop It)

Modelo privado não garante produto privado. O vazamento acontece nos logs, nos segredos e nas ferramentas que você monta em volta do modelo.

Agentes 15:21 nível ●●●○○ Venice AI Assistir no YouTube (abre em nova aba)

Em 3 frases

Joshua Mo, da Venice AI, diz que o modelo é só uma parte do agente. O risco maior está no sistema ao redor, como logs que guardam prompts e cofres de senha ligados direto ao LLM.

Ele propõe guardar hashes em vez de dados pessoais, dividir chaves de criptografia, usar handles revogáveis, limitar as ferramentas do agente e filtrar prompt injection antes do agente.

A ideia central é ligar o cofre de segredos à camada de execução (determinística) e não à camada de raciocínio (o LLM). O talk termina admitindo que tool calls confidenciais ainda são um problema em aberto.

Antes de ler

Mais 2 termos

O segredo passa pelo LLM e pode vazar

No fluxo comum, o runtime busca a senha no cofre (1Password, HashiCorp Vault) e a entrega à camada de raciocínio. Se o LLM monta uma tool call, ele pode mandar esse segredo para qualquer servidor, inclusive o de um atacante. Segundo o palestrante, o segredo ainda pode parar em dados de treino.

O segredo viaja do cofre até o LLM, que decide para onde enviá-lo.05:54

Chave dividida e hash reduzem o dano

A Venice guarda hashes no lugar de identificadores pessoais, por exemplo para limitar o uso por usuário. Os dados criptografados ficam em um enclave com custódia de chave dividida em duas metades. O atacante precisa das duas para decifrar, e a própria equipe também não acessa os dados sozinha.

Duas metades de chave: uma só não abre os dados.06:55

Escopo estreito: uma ferramenta, não vinte

Um servidor MCP pode expor 15 a 20 ferramentas, mas a tarefa usa uma. Carregar tudo, junto com a chave de API, aumenta a chance de exfiltração. Menos ferramentas também deixam a janela de contexto mais vazia, o que o palestrante associa a melhor desempenho do agente.

Poucas ferramentas reduzem o risco e o ruído de contexto.08:27
Mais 2 ideias deste talk

Cofre ligado à execução, não ao raciocínio

O LLM gera entradas não determinísticas. Se o cofre se conecta ao runtime, o runtime vira uma camada de execução determinística. Ela faz o login no site ou chama a API externa sem que a senha apareça no prompt. Ali dá para aplicar regras de segurança que não funcionam dentro do LLM.

O LLM pede a ação, a camada de execução usa a credencial.11:04

Computação confidencial com atestação

Em um ambiente de execução confiável (TEE), a inferência roda isolada no nível do hardware. A Venice devolve junto da resposta uma atestação, que o usuário confere em um verificador. Tool calls totalmente criptografadas continuam sem solução prática, segundo o próprio palestrante.

A atestação prova criptograficamente onde a inferência rodou.13:13
analogia

Split key custody (custódia de chave dividida). Split key custody é como o cofre de um banco que só abre quando dois funcionários giram suas chaves ao mesmo tempo.

  1. Para proteger um dado, a empresa o embaralha com uma chave secreta. Sem a chave, o dado vira texto ilegível.
  2. Na custódia de chave dividida (split key custody), essa chave fica separada em duas metades guardadas em lugares diferentes.
  3. Para decifrar o dado, o sistema precisa juntar as duas metades. Quem rouba só uma metade continua sem acesso.
  4. A própria equipe também não abre os dados sozinha. Se a conta de um funcionário for invadida, o atacante ainda fica sem a outra metade.
  5. No talk, a Venice guarda resultados de geração de vídeo assim, criptografados em um enclave, com uma metade de leitura e outra de escrita.
DADO CRIPTOGRAFADOGuardado ilegível no enclave
CHAVE EM DUAS METADESCada metade fica em um lugar
JUNTAR AS METADESSó as duas juntas decifram
ACESSO PROTEGIDOUma metade roubada não abre nada

Ajuda saber antes: Criptografia, Chave de criptografia, Gestão de segredos

analogia

Trusted execution environment (TEE) (ambiente de execução confiável). Um TEE é como uma sala de provas lacrada na escola, onde ninguém de fora vê o que o aluno escreve e o fiscal entrega um recibo confirmando que a prova foi feita ali.

  1. Quando você manda uma pergunta para uma IA, ela roda em um computador de outra empresa. Em geral, quem controla esse computador pode espiar.
  2. Um ambiente de execução confiável (trusted execution environment, TEE) é uma área isolada dentro do próprio chip do processador.
  3. O que roda ali fica protegido pelo hardware. Nem o sistema operacional nem o dono do servidor conseguem ler os dados durante o processamento.
  4. Junto com a resposta, o serviço devolve uma atestação (attestation), um comprovante assinado que diz onde a inferência rodou.
  5. O usuário confere essa atestação em um verificador. Assim ele tem prova criptográfica de que o pedido rodou em um processo privado.
PEDIDO DO USUÁRIOPrompt enviado ao provedor
INFERÊNCIA NO TEERoda isolada no chip
RESPOSTA + ATESTAÇÃOComprovante assinado junto
VERIFICADORUsuário confere a atestação
PRIVACIDADE PROVADAProva de onde o modelo rodou

Ajuda saber antes: Inferência, Criptografia, Sandbox

leitura crítica

O talk é em parte pitch da Venice, que vende privacidade como produto. As afirmações sobre prompts não armazenados e atestação aparecem sem auditoria externa ou dados. Não há demonstração, benchmark nem caso real de vazamento. O vínculo entre segredo no LLM e dados de treino é dito sem fonte. A afirmação de que contexto vazio melhora o desempenho vem como fato conhecido, sem medição. Os padrões de arquitetura valem como lista de boas práticas.

O que fazer com isso

  • Revise seus logs e a observabilidade: confira se prompts, respostas de ferramentas e chaves de API estão sendo gravados sem filtro.
  • Nunca cole chaves ou senhas em prompts. Monte o agente para que o código de execução leia a credencial e o modelo só peça a ação.
  • Ao conectar um servidor MCP, habilite só as ferramentas necessárias para a tarefa e use credenciais com escopo mínimo que você possa revogar.
  • Se o agente tem acesso à internet, monitore as chamadas externas, porque sandbox sozinho não impede o envio de dados para fora.

Build a Platform and Watch It Burn

Não dá para confiar que o modelo recuse sozinho. Proteja o agente com controles de infraestrutura e guardrails de entrada e saída.

Agentes 52:35 nível ●●●○○ Michael Forrester, Accenture & Whitney Lee, Datadog Assistir no YouTube (abre em nova aba)

Em 3 frases

Os palestrantes montaram um bot de burritos com acesso a um cluster Kubernetes e pediram à plateia que o levasse a fazer coisas fora do pedido, como implantar uma imagem externa e vazar uma receita secreta.

Eles repetiram os ataques em dois clusters protegidos. O primeiro usa controles de infraestrutura (política de rede, Kyverno, monitoramento de runtime). O segundo liga guardrails de IA (LLM Guard) na entrada e na saída.

A conclusão é que recusas do modelo variam de uma tentativa para outra, então a segurança precisa vir de camadas externas ao modelo, somadas às práticas de CI/CD e identidade que times já usam.

Antes de ler

Mais 2 termos

O modelo recusa hoje e aceita amanhã

Os palestrantes mostram que o bot recusou vazar dados em algumas tentativas e aceitou em outras. Nomes de vilões na imagem faziam o modelo desconfiar, enquanto uma história de marketing o deixava à vontade. O comportamento muda com o contexto e com a sorte, então a recusa do modelo não serve como controle de segurança.

08:00 O bot implanta uma imagem externa só porque a história parece legítima.

Controles de infraestrutura barram o que o modelo deixa passar

No segundo cluster, o Kyverno (um controlador de admissão do Kubernetes) bloqueou a imagem de fora, porque só aceita registry interno e exige limites de recursos. Política de rede cuida da saída de dados. O monitoramento de runtime com Falco ou Tetragon não bloqueou o acesso à receita na demo, e os palestrantes admitiram a falha.

15:19 Cada ataque tem um controle de infraestrutura correspondente, nem todos funcionaram.

Traces mostram o que o agente fez

Com OpenTelemetry, cada conversa vira um trace no Datadog, com prompt de sistema, chamadas de ferramenta, resultados, tokens e custo. Dá para apontar a interação exata que causou um comportamento. O mesmo vale para outras ferramentas de observabilidade, como Grafana ou Jaeger.

Um único trace expõe entrada, ferramentas chamadas e resultado.21:39
Mais 2 ideias deste talk

Filtro de entrada custa menos que filtro de saída

O guardrail de saída deixa o modelo processar o pedido e só depois redige o trecho sensível, então você paga pelos tokens. O de entrada bloqueia antes da chamada ao modelo, sem custo de LLM. Eles recomendam usar os dois e acrescentar regex simples para padrões conhecidos antes do classificador.

38:43 O pedido é barrado antes de chegar ao modelo, sem gasto de tokens.

Descrição de ferramenta MCP também é vetor de ataque

Uma ferramenta de clima trazia na descrição a instrução de chamar também a ferramenta read internal config e incluir a saída. O agente obedeceu. Quem pergunta o clima nem percebe o vazamento. Os palestrantes sugerem registry ou gateway de MCP, em vez de ligar servidores públicos direto.

A descrição da ferramenta manda o agente ler a configuração interna.44:24
analogia

Admission controller (controlador de admissão). Um admission controller é como o porteiro de um prédio comercial que confere a lista de autorizados antes de deixar alguém subir.

  1. Num sistema que roda muitos programas, alguém precisa decidir o que pode entrar. O admission controller (controlador de admissão) faz essa checagem antes de qualquer coisa começar a rodar.
  2. No Kubernetes, todo pedido para criar algo passa pela API do cluster. Antes de executar o pedido, a API consulta o controlador de admissão.
  3. Ferramentas como o Kyverno se ligam a esse ponto por um webhook (chamada automática entre sistemas). O Kyverno compara o pedido com regras escritas pela empresa e devolve sim ou não.
  4. Na demo, as regras exigiam imagens vindas só do registry (repositório de imagens) interno e limites de recursos definidos. Por isso o agente não conseguiu implantar a imagem externa.
  5. O controlador pode validar, aceitando ou recusando o pedido, ou mutar, corrigindo o pedido antes de aprovar. Como a regra vale para o cluster inteiro, ela barra pessoas e agentes de IA do mesmo jeito.
PEDIDO DE DEPLOYAlguém pede para criar um contêiner
API DO KUBERNETESRepassa o pedido ao webhook
KYVERNO VALIDAConfere registry e limites de recursos
VEREDITOAprovado implanta, recusado cai

Ajuda saber antes: Kubernetes, Contêiner, Registry de imagens, Webhook

analogia

Runtime security (segurança em tempo de execução). Runtime security é como a câmera e o segurança dentro da loja, que vigiam o que cada cliente faz depois de já ter entrado.

  1. Checar um programa na entrada não basta. Depois que ele começa a rodar, ainda pode fazer algo perigoso. Runtime security (segurança em tempo de execução) vigia o programa enquanto ele funciona.
  2. Essas ferramentas observam o kernel (núcleo) do Linux, onde todo comando passa. Elas enxergam ações como abrir arquivos ou rodar um simples ls, mesmo sem entender o Kubernetes.
  3. O Falco detecta e reage. O comando chega a rodar, o Falco dispara um alerta e o Falco Talon pode derrubar o pod (unidade que roda o contêiner) envolvido.
  4. KubeArmor e Tetragon tentam prevenir. Eles usam LSM (módulos de segurança do Linux) e eBPF (programas pequenos dentro do kernel) para que o comando proibido falhe antes de executar.
  5. Na demo, essa camada falhou e a plateia conseguiu ler a receita secreta. Ataques rápidos, como um fork bomb, pedem prevenção, porque a resposta depois do fato chega tarde.
PROGRAMA RODANDOO contêiner já está em execução
KERNEL OBSERVADOFalco ou Tetragon veem cada comando
DETECTA OU BLOQUEIAAlerta depois ou impede na hora
RESPOSTAAlerta, pod derrubado ou comando negado

Ajuda saber antes: Kernel do Linux, Contêiner, Pod, Admission controller

leitura crítica

É workshop com demo ao vivo, e os próprios palestrantes admitem que parte falhou (Falco não bloqueou, ninguém recebeu cluster na rodada três). Não há medição de taxa de sucesso dos ataques: falam em 20 ou 30 prompts até o modelo ceder, sem amostra formal. Whitney trabalha no Datadog, que aparece como backend de traces, e Michael faz treinamento. A regra de adoção de IA (sistema delimitado, vale o custo, saída verificável) é opinião, sem dados.

O que fazer com isso

  • Liste as ferramentas e permissões que seus agentes têm hoje e corte o que não for necessário. O talk aponta escopo grande demais e credenciais soltas como causa principal dos incidentes.
  • Não use a recusa do modelo como defesa. Teste seus agentes com várias tentativas e histórias diferentes, e coloque controles fora do modelo, como política de rede e registry permitido.
  • Ligue instrumentação com OpenTelemetry nos agentes para ver prompts, chamadas de ferramenta e custos, e cuide de dados sensíveis que apareçam nos traces.
  • Só conecte servidores MCP vindos de registry ou gateway aprovado e leia as descrições das ferramentas antes de liberar.

AI Agents Don't Read Your Policy Docs. They Hit Your APIs

Regra escrita em prompt ou documento de política não impede o agente de agir. Quem bloqueia é o gateway, na infraestrutura.

Infraestrutura 17:50 nível ●●●○○ Gravitee Assistir no YouTube (abre em nova aba)

Em 3 frases

O CTO da Gravitee roda cinco demos ao vivo com dois agentes de reservas de hotel. Um tem as regras só no prompt e o outro passa por um gateway com identidade restrita.

O agente sem gateway apaga todas as reservas e vaza dados de hóspedes. O agente governado recebe 403, tem limite de requisições, cache semântico e bloqueio de prompts grandes.

O argumento final é que, com centenas de agentes por pessoa, a governança precisa ficar numa camada de infraestrutura que também roteia modelos, enxuga ferramentas MCP e enxerga o uso de IA nos notebooks.

Antes de ler

Mais 2 termos

Política em documento não vale em tempo de execução

O agente da esquerda recebe um pedido para cancelar uma reserva e rodar a ferramenta de apagar todas. Ele executa, porque a ferramenta existia e o usuário tinha permissão. A política do hotel dizendo para não usar IA nisso não é lida por ninguém na hora. O banco de dados fica sem as reservas.

Sem gateway, a chamada destrutiva retorna 200 e o banco é esvaziado.03:37

O gateway nega com 403 e o agente faz só a parte permitida

No agente governado, a ferramenta é descoberta, mas a execução é barrada no gateway com código 403 (proibido). O token do usuário só vale no momento da tarefa, com permissões estreitas. O agente ainda cancela a reserva autorizada e avisa que não pode apagar o resto.

O mesmo prompt é bloqueado no gateway e o agente cumpre só o que é permitido.04:07

Vazamento de dados pessoais barrado antes de sair

Na segunda demo, o usuário pede a lista completa de hóspedes com e-mails e dados de carro, sob o pretexto de conformidade. O agente sem gateway entrega tudo (dados fictícios). O gateway bloqueia, sugere autenticação e deixa um rastro em OpenTelemetry para auditar cada passo.

O gateway devolve erro real, sem vazamento, e registra cada etapa.05:39
Mais 2 ideias deste talk

Limite de requisições e cache cortam custo de token

Um agente com bug repete o mesmo pedido oito vezes. Com o gateway, só as três primeiras passam e as demais são barradas antes do modelo. No cache semântico, cinco pedidos parecidos são servidos do Redis, gastando cerca de 200 tokens contra cerca de mil. O nível de similaridade é configurável de 0 a 1.

Rate limit de três por minuto barra as chamadas antes de gastar token.07:41

Bloqueio de prompt grande e de assunto fora do escopo

Um prompt com dez minutos de transcrição gasta 2.000 tokens de entrada e gera 312 de saída numa tarefa simples. O gateway recusa antes de chamar o modelo e sugere dividir em passos. Também filtra perguntas que não têm relação com reserva de hotel, como a previsão do tempo.

O gateway recusa o prompt antes de qualquer chamada ao modelo.11:16
analogia

JWT (JSON Web Token, token com as permissões do usuário). O JWT é como um crachá de visitante carimbado pela portaria, que diz quem você é, quais andares você pode visitar e até que horas ele vale.

  1. Quando você entra num sistema, ele precisa lembrar quem você é a cada pedido. Em vez de pedir sua senha toda vez, ele entrega um comprovante digital chamado token.
  2. O JWT (JSON Web Token, ficha digital em formato de texto) é um tipo de token. Ele carrega informações chamadas claims (declarações), como quem é o usuário, o que ele pode fazer e quando o token expira.
  3. Quem emite o token assina o conteúdo com uma chave secreta. Se alguém mudar uma claim para ganhar mais poder, a assinatura deixa de bater e o token é recusado.
  4. No talk, o gateway faz uma token exchange (troca de token). Ele troca a credencial do usuário por um JWT de vida curta, com permissões estreitas, que só vale enquanto a tarefa roda.
  5. Quando o agente tenta usar a ferramenta de apagar todas as reservas, o gateway lê as claims, não encontra essa permissão e devolve o código 403 (proibido).
LOGIN DO USUÁRIOO sistema confirma quem é a pessoa
TOKEN EMITIDOClaims dizem o que pode e até quando
AGENTE CHAMA FERRAMENTAEnvia o token junto com o pedido
GATEWAY CONFERECheca assinatura, claims e validade
LIBERA OU NEGA COM 403A ação só roda se houver permissão

Ajuda saber antes: Autenticação e autorização, Token de acesso, Códigos de status HTTP, AI gateway

leitura crítica

É um pitch de produto do gateway da própria empresa, e o palestrante é o CTO. As demos são ao vivo, mas usam dados fictícios e um cenário montado para o agente falhar. A pesquisa de 88% e 14% é interna e sem metodologia. Não há comparação com outros gateways nem custo e latência do gateway. Os casos de cache e de prompt grande tratam economia de um centavo como argumento, sem medir ganho real.

O que fazer com isso

  • Liste as ferramentas que seus agentes podem chamar e marque as destrutivas (apagar, exportar tudo). Exija permissão no servidor para elas, em vez de confiar no prompt.
  • Dê a cada agente uma identidade própria com permissões mínimas e token de curta duração, em vez de reaproveitar as credenciais do usuário.
  • Ative limite de requisições e limite de tokens por usuário ou agente, para que um loop com bug não gere uma conta alta.
  • Em servidores MCP de terceiros, exponha só as ferramentas necessárias. Cortar uma lista grande reduz custo de contexto e o raio de impacto.

AI Security Engineer Foundations + Certificate

Agentes de IA herdam os velhos riscos de software e ganham novos. Sem inventário, escaneamento contínuo e limites de acesso, ninguém sabe o que roda.

Engenharia de software 1:57:33 nível ●●●○○ Javier Garza, Snyk Assistir no YouTube (abre em nova aba)

Em 3 frases

Javier Garza, da Snyk, percorre em duas horas o OWASP Top 10 para LLMs (lista dos dez maiores riscos de segurança em aplicações com modelos de linguagem), shadow AI, threat modeling, segurança de skills e MCP, vibe coding seguro e red teaming.

Ele defende inventariar tudo que a IA usa com um AI BOM, escanear servidores MCP e skills antes de instalar, limitar o acesso do agente ao mínimo e manter um humano aprovando ações de risco.

Os casos mostrados incluem skill maliciosa publicada num marketplace, injeção de comando num servidor MCP, banco de produção apagado por um agente e um agente que arquivou centenas de e-mails.

Antes de ler

Mais 2 termos

Injeção indireta esconde ordens em conteúdo comum

Na injeção direta, o atacante digita a ordem no chat, como no jogo Gandalf. Na indireta, ele planta o texto em algo que o modelo vai ler, como um perfil do LinkedIn com letras brancas sobre fundo branco. O modelo lê a instrução escondida e pode obedecer. Garza lista defesas: sanitizar entrada, restringir o comportamento no prompt de sistema e exigir aprovação humana em ações de risco.

Texto invisível numa página pode dar ordens ao modelo que a lê.09:05

AI BOM lista modelos, datasets e agentes do projeto

O AI BOM (AI bill of materials, lista de materiais de IA) faz para modelos, datasets, agentes e servidores MCP o que o SBOM faz para bibliotecas. Garza roda o scan pela linha de comando num repositório e abre o resultado num painel com 69 ativos. O painel cruza cada modelo com vulnerabilidades conhecidas. Quando surge uma falha num modelo ou ferramenta, o inventário mostra rápido quem na empresa é afetado.

42:32 O inventário aponta quais componentes de IA têm vulnerabilidade conhecida.

Threat modeling precisa cobrir prompts, memória e APIs

Threat modeling (modelagem de ameaças) é desenhar o sistema e listar ataques antes de implantar. Para IA, o escopo cresce além de bancos e credenciais: entram modelos, prompts de sistema, janela de contexto, memória e APIs acessadas pelo agente. Garza usa a matriz MITRE ATLAS, que organiza táticas de ataque a sistemas de IA, e pede para tratar toda entrada externa como não confiável. Cita o OpenClaw como exemplo de ferramenta popular com falhas.

52:56 A matriz ATLAS mapeia táticas de ataque a agentes de IA.

Mais 2 ideias deste talk

Servidor MCP é código e pode esconder ordens maliciosas

Instalar um servidor MCP é fácil, e por isso também é fácil publicar um malicioso. No tool poisoning (envenenamento de ferramenta), a descrição da ferramenta traz instruções ocultas, por exemplo enviar chaves de API. Garza mostra um exemplo que parece pedir uma busca de pacote npm. Ele recomenda dois tipos de scan: um nas ferramentas instaladas, outro no código do servidor, que acha injeção de comando e path traversal.

Uma ferramenta MCP pode parecer normal e rodar ação maliciosa ao aceitar.1:10:49

Skill maliciosa chegou ao topo do ranking de um marketplace

Marketplaces de skills publicam e instalam com um comando, sem curadoria. Um pesquisador criou de propósito uma skill com nome chamativo, manipulou a contagem de downloads até o topo do ranking e fez a skill enviar um ping ao seu servidor. O ping mostrou o IP e o país de quem instalou. A lição de Garza: skill é texto, mas pode mandar o agente rodar comandos, então leia antes de instalar.

1:38:05 O texto da skill manda o agente executar um comando que avisa o atacante.

leitura crítica

O workshop também vende as ferramentas da Snyk (AI BOM, agent scan, code scan), e o palestrante é da empresa. Os números são citados de memória e sem fonte, como 367 skills com malware em 10.000 (1239s) e a afirmação de que mais de 50% do código gerado tem ao menos cinco vulnerabilidades (2896s), que parece vir de demos dele. Várias histórias circulam como notícia, sem verificação (a ligação de OpenClaw com 2 milhões de dólares em tokens, o caso Mythos). O ritmo corrido deixa pouca profundidade técnica e alguns pontos misturam fatos com opinião.

O que fazer com isso

  • Liste os modelos, servidores MCP e skills que sua equipe usa. Uma planilha já serve como AI BOM inicial.
  • Leia o arquivo inteiro de qualquer skill antes de instalar e rode um scanner de segurança nos servidores MCP, de novo a cada atualização.
  • Configure o agente para pedir aprovação em apagar arquivos, enviar e-mail e mexer em produção, e evite o modo de aprovação automática.
  • Ao pedir código a uma IA, inclua requisitos de segurança no prompt e rode um scan de vulnerabilidades no resultado antes de publicar.

AI Security Engineer Foundations + Certificate

Segurança de IA reaproveita controles clássicos. Tire o dado do alcance do modelo em vez de pedir no prompt que ele não conte.

Engenharia de software 2:00:16 nível ●●●○○ Micah Silverman, Snyk Assistir no YouTube (abre em nova aba)

Em 3 frases

Micah Silverman, da Snyk, percorre em duas horas os riscos da OWASP para LLMs, shadow AI, threat modeling (modelagem de ameaças), MCP, vibe coding e red teaming.

O fio condutor é que prompt não funciona como controle de acesso. Isolar credenciais, limitar dados, exigir aprovação humana e escanear dependências vale mais do que instruir o modelo.

No exercício final, um chatbot de notas escolares recusa revelar notas, e essa recusa já mostra que ele tem acesso a elas. Vários prompts da plateia falham, o que ilustra a variação de comportamento do modelo.

Antes de ler

Mais 2 termos

Prompt não substitui controle de acesso

Um chatbot de alunos deveria mostrar só nomes e horários. Dizer no system prompt para não revelar notas deixa as notas ao alcance do modelo. Silverman propõe uma view do banco, ou uma cópia sincronizada, sem os campos sensíveis. Se o dado nunca chega ao contexto, não há o que vazar.

A defesa mais forte é o modelo nunca ter acesso ao dado.1:02:03

AI BOM como gate de build

Um AI BOM (AI bill of materials, inventário de modelos, datasets, agentes e ferramentas) vira ação quando entra no CI/CD. Na demo da plataforma EVO, uma política que proíbe modelos da Salesforce acusa na hora um problema crítico no projeto AI buffet. A proposta é guardar uma linha de base e quebrar o build quando surgir componente de IA fora dela.

Inventário mais política detecta um modelo proibido sem revisão manual.39:49

Tool poisoning em servidores MCP

Um servidor MCP malicioso pode esconder instruções na descrição de uma ferramenta, como incluir a chave SSH na consulta de uma busca. O modelo trata a descrição como autoridade. Silverman mostra o agent scan da Snyk, que lê os arquivos de configuração do Cursor e do VS Code e aponta prompt injection na definição da ferramenta.

O scan inspeciona a descrição da ferramenta antes de o agente usá-la.1:14:37
Mais 2 ideias deste talk

Servidor MCP também é código com bug

O servidor MCP da Framelink para Figma montava um comando curl concatenando a URL. Um argumento com aspas e ponto e vírgula executava um segundo comando no shell. É o mesmo padrão de SQL injection, aplicado a bash. Por isso a defesa inclui scan de código e de dependências, além do scan do agente.

Entrada sem sanitização virou execução de comando no servidor MCP.1:18:46

Playbook de desenvolvimento seguro com agentes

Depois de casos como o banco de produção apagado no Replit e os e-mails apagados pelo OpenClaw mesmo com regra salva na memória, Silverman lista camadas. Ambientes separados sem credenciais compartilhadas, aprovação humana para deploy e ações destrutivas, sandbox, rede segmentada e verificação de pacotes contra nomes alucinados.

O controle fica fora da conversa, em ambiente, credencial e aprovação.1:38:15
analogia

Tool poisoning (envenenamento de ferramenta). Tool poisoning é como um manual de instruções de uma impressora nova que diz, no meio dos passos, para você mandar uma cópia de todo documento para um endereço estranho, e você obedece porque confia no manual.

  1. Assistentes de IA podem usar ferramentas, como buscar num banco de dados ou enviar uma mensagem. Cada ferramenta vem com um texto que explica para o modelo como usá-la.
  2. O modelo lê esse texto e segue o que está escrito, porque ele não tem outra fonte para saber como a ferramenta funciona.
  3. Tool poisoning (envenenamento de ferramenta) acontece quando quem criou a ferramenta esconde ordens maliciosas nessa descrição. Um exemplo do talk é uma busca que pede para incluir a chave SSH (a senha de acesso do computador) na consulta.
  4. Esse ataque vem de um servidor MCP (o programa que liga o modelo a ferramentas externas) feito de propósito para enganar o agente. Como o agente tem o mesmo acesso que o desenvolvedor, ele pode vazar segredos ou desviar ações sem que ninguém perceba.
  5. A defesa é tratar o servidor MCP como código de terceiros. Leia as descrições das ferramentas e rode um scanner, como o agent scan da Snyk, que procura prompt injection (injeção de prompt) nessas definições.
SERVIDOR MALICIOSOInstalado pelo próprio usuário
DESCRIÇÃO ENVENENADAOrdem escondida no texto da ferramenta
MODELO OBEDECETrata a descrição como autoridade
SEGREDO VAZADOChave ou dados enviados ao atacante

Ajuda saber antes: MCP, Prompt injection, Agente de IA

analogia

Slopsquatting (registro malicioso de pacote alucinado). Slopsquatting é como um GPS que inventa uma rua que não existe, e um golpista corre para abrir uma loja falsa exatamente nesse endereço antes que você chegue lá.

  1. Programas usam pacotes, que são peças de código prontas baixadas da internet pelo nome.
  2. Quando a IA escreve código, às vezes ela inventa o nome de um pacote que não existe. Isso se chama alucinação.
  3. Slopsquatting (registro malicioso de pacote alucinado) acontece quando um atacante percebe esses nomes inventados e publica um pacote real com esse nome, cheio de código malicioso.
  4. Antes, instalar o pacote inventado dava erro. Depois do registro, a instalação funciona e o código do atacante roda na sua máquina. Por isso o palestrante chama de primo do typosquatting (registro de nomes com erro de digitação) e de ataque de tempo.
  5. A defesa é conferir se cada pacote sugerido pela IA existe e é legítimo, manter um SBOM (lista de componentes do software) por projeto e quebrar o build quando surgir dependência fora da lista.
IA ALUCINA PACOTESugere um nome que não existe
ATACANTE MONITORAColeta nomes inventados pela IA
REGISTRO MALICIOSOPublica pacote falso com esse nome
CÓDIGO INSTALADOMalware roda no seu projeto

Ajuda saber antes: Alucinação de LLM, Gerenciador de pacotes, Cadeia de suprimentos de software, Typosquatting

leitura crítica

O talk é também uma vitrine da Snyk. EVO, agent scan e o scanner de código aparecem como solução, e o palestrante admite ser parcial. As estatísticas de shadow AI e de skills com falhas são citadas sem fonte na fala. A demo final tem poucas tentativas, e nenhuma extraiu a nota, então não prova nem a robustez nem a fragilidade do chatbot.

O que fazer com isso

  • Revise o que cada assistente de IA da sua empresa pode ler e escrever. Se o dado sensível não precisa estar no contexto, retire-o em vez de proibir no prompt.
  • Faça um inventário simples dos modelos, servidores MCP e skills em uso nos seus projetos e defina quem aprova cada novo componente.
  • Antes de instalar um servidor MCP ou uma skill, leia as descrições das ferramentas e rode um scanner de segurança, tratando-os como código de terceiros.
  • Mantenha agentes longe de produção, exija sua aprovação para deploy e ações destrutivas e confira se cada pacote sugerido pela IA existe e é legítimo.

Can Your Agent Hear You Now? Building Live Voice Agents with Gemini

Agente de voz com áudio nativo, ferramentas e interrupção já cabe em uma sessão WebSocket da Gemini Live API.

Produto 20:14 nível ●●○○○ Thor Schaeff Assistir no YouTube (abre em nova aba)

Em 3 frases

Thor Schaeff, do Google DeepMind, faz demos ao vivo: história ilustrada com Nano Banana Light, tradução simultânea com Gemini 3.5 Live Translate e um DJ de rádio que gera música com Lyria 3.

A Live API abre uma sessão WebSocket (conexão contínua) com estado. Nela o modelo recebe texto, áudio e vídeo e devolve áudio e transcrição. O modelo é de áudio nativo, sem a cadeia de transcrever, pensar e sintetizar voz.

O modelo suporta 90 idiomas na prévia, interrupção pelo usuário, chamada de ferramentas e busca no Google. O jeito mais rápido de testar é o Google AI Studio.

Antes de ler

Mais 1 termo

API com estado mantém a consistência entre imagens

Na Interactions API, cada geração pode receber o ID da interação anterior. O modelo herda o contexto e mantém personagens e estilo visual nas imagens seguintes. A primeira chamada vai sem ID. As demais passam o ID anterior. Thor diz que cada imagem leva 2 a 3 segundos.

O ID da interação anterior encadeia as gerações e preserva personagens e estilo.05:25

Tradução simultânea para a plateia, por QR code

Thor cria uma sessão de tradução, abre o microfone e a plateia escaneia um QR code. Cada pessoa escolhe o idioma e ouve a palestra por fone. O modelo detecta o idioma de quem fala e começa a traduzir assim que entende o contexto, sem esperar a frase terminar.

Cada ouvinte escolhe o idioma e recebe a tradução quase em tempo real.07:28

Um agente de voz vira útil quando chama ferramentas

No DJ de rádio, o modelo de voz conversa, pergunta gênero e clima da música e então chama uma função que aciona o Lyria 3, o modelo de música. Thor diz que a demo em si tem pouco uso comercial, mas o padrão serve para consultar um CRM ou abrir um ticket por voz.

A voz do agente dispara uma chamada de função que gera a música.10:45
Mais 2 ideias deste talk

Áudio nativo dispensa a cadeia de três etapas

Um agente de voz tradicional transcreve a fala, processa o texto e sintetiza a resposta. Na Live API, o modelo entende o áudio direto e responde em áudio, com transcrição de brinde. Isso facilita trocar de idioma no meio da conversa e permite interromper o modelo enquanto ele fala.

Uma sessão WebSocket recebe texto, áudio e vídeo e devolve áudio mais transcrição.14:24

Teste no AI Studio com voz, câmera e busca

No AI Studio, Thor escolhe o modelo Gemini 3.1 Flash Live, a voz Puck e liga o grounding (ancoragem) com Google Search para dados em tempo real. Na demo, o modelo vê pela câmera, lê a palavra Gemini no moletom e responde em mandarim.

O modelo identifica roupa e texto pela câmera durante a conversa por voz.18:01
leitura crítica

É palestra de fornecedor, feita pelo time de developer experience do Google, com demos curadas. Não há medição de latência, custo, precisão da tradução nem taxa de erro. Thor admite que a demo do DJ tem pouco uso comercial e que o mandarim falhou. O suporte a 90 idiomas vale para a prévia, sem detalhe sobre a qualidade em cada um. Ele também pede que o público use os domínios ai.studio e ai.dev para justificar o gasto, o que mostra o interesse comercial.

O que fazer com isso

  • Abra o Google AI Studio na aba Live, escolha o modelo Gemini 3.1 Flash Live e teste voz, câmera e grounding com Google Search em um caso do seu trabalho.
  • Liste duas ou três ações do seu negócio, como consultar cliente ou abrir ticket, que um agente de voz poderia disparar por chamada de função.
  • Se você hoje usa uma cadeia de transcrição, modelo de texto e síntese de voz, compare latência e naturalidade com um modelo de áudio nativo antes de migrar.
  • Teste a tradução simultânea com falantes do seu idioma e meça os erros antes de usar em reunião ou evento reais.

Latency Is a Budget. Humanlike Is the Goal.

Agente de voz bom cabe num orçamento de latência e soa humano. Testar o pipeline inteiro vale mais que escolher modelo por ranking.

Agentes 17:00 nível ●●●○○ Jesse Hall, LiveKit Assistir no YouTube (abre em nova aba)

Em 3 frases

Jesse Hall, da LiveKit, diz que velocidade pura não resolve agentes de voz. O objetivo é soar humano dentro de um orçamento de latência, e rankings de modelos isolados enganam porque o erro de cada etapa se acumula no pipeline.

A latência que importa é a percebida pelo usuário (tempo até o primeiro áudio audível), não a do painel. Detecção de fim de turno por áudio, resposta em streaming por frase e ferramentas lentas rodando em segundo plano mantêm a conversa fluida.

A LiveKit apresenta um benchmark open source que roda centenas de chamadores simulados contra o seu agente e pontua resultados. Fecha com um checklist e o anúncio de um Gemma 4 31B ajustado para voz.

Antes de ler

Mais 2 termos

A armadilha do ranking

Rankings avaliam um modelo por vez, com áudio limpo. Quem entrega um agente de voz entrega um pipeline de três modelos em cascata. Se a transcrição ouve 'dia 30' em vez de 'dia 3', o LLM agenda o dia errado com toda a confiança e as camadas seguintes não percebem.

O ranking mede um componente, mas o produto é a conversa inteira.04:56

Latência medida versus percebida

O painel do provedor de TTS (text-to-speech, síntese de voz) mostra time to first byte, mas bytes podem ser silêncio. Eles mediram provedores que enviam centenas de milissegundos de silêncio no início, chegando a três quartos de segundo. O número que importa é o tempo até o primeiro áudio audível. No LLM, vale o tempo até completar a primeira frase, não o primeiro token.

Medida do painel e percepção do usuário divergem.05:59

Ganhar tempo como uma pessoa

Ferramentas podem levar de 2 a 40 segundos ou mais, e nenhum modelo esconde isso. Uma recepcionista diz 'um instante, estou consultando' e continua ouvindo. No código, uma única linha devolve a palavra ao agente enquanto a ferramenta trabalha em segundo plano. Conversa e ferramenta deixam de dividir a mesma thread.

Uma linha de código separa a conversa do trabalho da ferramenta.07:50
Mais 2 ideias deste talk

Detecção de turno por áudio

Esperar a transcrição completa para decidir que o usuário terminou já é tarde. O detector da LiveKit usa ritmo, tom e entonação do áudio. O LLM já roda sobre uma transcrição provisória, e o TTS começa na primeira frase completa. Isso pode economizar meio segundo.

Comparação de cortes indevidos no mesmo orçamento de latência.10:39

Benchmark do agente inteiro

O benchmark usa um agente de hotel real, com back end real, e centenas de chamadores simulados que interrompem, murmuram e mudam de ideia. Pontua desfechos (reserva correta no banco, corte do chamador, dados vazados) e penaliza perguntas desnecessárias. Troca-se só a stack, com entrada idêntica, e dá para rodar contra o seu agente.

Avaliação por desfecho, comparável entre stacks de modelos.12:46
leitura crítica

É um talk de um fornecedor de infraestrutura que vende o benchmark e o Gemma ajustado. O número de 4,5% contra 9,9% de cortes indevidos vem de avaliação própria, embora o código seja aberto, e o talk não mostra a amostra. Os 88% de evals de voz e os 380 ms do modelo novo são prévia de lançamento, sem comparação detalhada. O benchmark gira em torno de um único agente de hotel, então vale testar no seu caso. A LiveKit diz ser neutra, mas lucra com o stack que recomenda.

O que fazer com isso

  • Defina o orçamento de latência de ponta a ponta do seu agente de voz (1,5 s como teto, perto de 600 ms como meta) antes de escolher modelos.
  • Meça o tempo até o primeiro áudio audível na ligação real, não o time to first byte do painel do provedor.
  • Mova para execução assíncrona qualquer ferramenta que passe de 1 segundo, e faça o agente avisar o usuário enquanto trabalha.
  • Rode o benchmark open source da LiveKit contra o seu agente, com chamadores simulados que interrompem e mudam de ideia, e repita em produção.

Parsing the Epstein Files for JMail

Antes de qualquer produto com IA sobre documentos, resolva o parsing: sem texto estruturado e confiável, a interface não tem o que mostrar.

Dados e RAG 29:28 nível ●●○○○ Palak Agarwal & Omar Alhait, Reducto Assistir no YouTube (abre em nova aba)

Em 3 frases

A Reducto mostra como transformou mais de 3 milhões de páginas dos arquivos do caso Epstein (PDFs escaneados, manuscritos e redigidos) em dados estruturados que alimentaram o JMail e produtos derivados.

O fluxo é simples: faça o parsing do documento, defina um schema (esquema de campos) de extração, teste no Studio com poucos exemplos e publique como chamada de API.

Nas perguntas, os palestrantes admitem que benchmark público ainda não existe e que o leitor precisa montar o próprio teste com seus documentos.

Antes de ler

Mais 2 termos

O gargalo era ler a página, não montar o produto

Omar pede que a plateia envie a folha de rosto dos documentos a um chatbot e veja o resultado. Layout confuso e ordem de leitura subjetiva quebram a leitura automática. Só depois de resolver isso fez sentido construir o Gmail falso, o JFlights e os outros produtos.

Um documento real que mostra por que ler PDFs escaneados é difícil.04:24

Uma configuração de extração por caso de uso

Para o JFlights, o time montou um pipeline separado no Studio da Reducto, com um schema só para voos. Primeiro roda o parsing, depois a extração, e o resultado aparece em tempo real. Omar testou assim antes de escalar para milhões de documentos.

O Studio permite inspecionar a extração antes de escalar.06:01

Schema rápido ou schema informado pelos documentos

A geração padrão de schema é uma chamada rápida a um LLM (modelo de linguagem) a partir da sua descrição. A versão aprimorada faz o parsing primeiro e ajusta as descrições dos campos ao conteúdo real. Para rapidez, use a padrão. Para nuance, use a aprimorada.

12:47 Duas formas de gerar o schema: rápida ou baseada nos documentos.

Mais 2 ideias deste talk

Tarja preta sobre o PDF não é redação segura

Em alguns arquivos, a tarja estava só desenhada por cima do texto e os metadados do PDF ainda revelavam o conteúdo. O time do JMail precisou fazer redação adicional para não expor dados protegidos. Omar diz que a ferramenta funcionou bem demais.

14:18 Texto sob a tarja ainda pode ser extraído do PDF.

Benchmark próprio vale mais que o do fornecedor

O palestrante recomenda começar com poucos documentos e olhar as saídas no Studio, a que chamam de vibe eval. Para escalar, monte um conjunto de cem ou mil documentos e avalie de forma sistemática. Os benchmarks públicos da empresa ainda não saíram.

22:36 Recomendação de montar o próprio conjunto de teste.

leitura crítica

É palestra de produto da Reducto, com a demo rodando no próprio Studio. Os números de escala (3 milhões de páginas, 450 milhões de visitas) vêm dos palestrantes, sem fonte externa. Não há métrica de acurácia da extração, taxa de erro em manuscritos ou comparação com concorrentes. O próprio Omar admite que os benchmarks ainda não foram publicados e diz que a empresa vence as comparações dos clientes, sem mostrar dados. Respostas sobre treino e entity resolution ficaram vagas. Ao final há oferta de prêmios e vagas.

O que fazer com isso

  • Antes de escolher uma ferramenta de extração de documentos, separe 20 a 50 documentos reais, incluindo os piores (escaneados, girados, manuscritos), e compare as saídas lado a lado.
  • Defina o schema de campos antes de rodar e revise o resultado em poucos documentos. Ajuste as descrições dos campos e rode de novo.
  • Se você publica PDFs com dados sensíveis, não confie em tarja desenhada por cima. Use uma ferramenta que remova o texto e os metadados, e teste extraindo o texto depois.

Building AI Agents with Real-Time Web Data

Agente que decide com preço, avaliação e opinião de hoje precisa buscar dado fresco na web, e o gargalo real é conseguir acesso sem ser bloqueado.

Dados e RAG 27:28 nível ●●○○○ Yohan Raju, Bright Data Assistir no YouTube (abre em nova aba)

Em 3 frases

Yohan Raju, da Bright Data, mostra por que manter scrapers (programas que extraem dados de sites) fica caro quando a lista de sites cresce: cada site tem layout próprio, muda sem aviso e usa proteção anti-bot.

Ele separa dois caminhos de um agente: responder com o que o modelo já sabe ou com dado pré-indexado, ou sair para a web quando a pergunta depende de informação atual, como 'melhor época para viajar este ano'.

Na demo, um notebook puxa dados de um copo térmico na Amazon e comentários no Reddit pelas APIs da empresa, e o Gemini devolve uma recomendação de compra. O servidor MCP da Bright Data entra como a camada que dá ao agente acesso a busca, páginas e navegador.

Antes de ler

Escalar scraping custa engenharia, não só código

Segundo o palestrante, um scraper leva de 3 a 5 dias para ser feito e testado. Com 10 sites isso é gerenciável. Com 100 ou 1000, cada mudança de seletor (o endereço do preço ou do título na página) derruba o pipeline, exige correção e reprocessamento dos dados perdidos. A promessa é que agentes descubram e consertem esses scrapers sozinhos.

04:54 Quando o seletor do preço muda, o pipeline para até alguém consertar.

A arquitetura tradicional tem muitas camadas que podem falhar

O diagrama vai do gatilho agendado (cron) à camada de proxy, ao parsing com validação, à limpeza (deduplicação, enriquecimento) e ao banco de dados. Se qualquer etapa quebra, como o anti-bot ou um seletor, o processo recomeça, às vezes com backfill (preencher o histórico perdido) e risco de estourar SLA (prazo combinado).

O fluxo completo de coleta, de gatilho até banco, com pontos de falha em cada camada.07:07

Dois caminhos: conhecimento guardado ou web ao vivo

Perguntas como 'melhor época para viajar a San Francisco' podem ser respondidas com dado pré-treinado ou pré-indexado. Se a pergunta traz 'este ano', o agente precisa ir à web. O palestrante também cita cache para respostas repetidas, como o clima do dia, para economizar tokens e dinheiro, e diz que sites bloqueiam crawlers de IA via robots.txt.

O agente escolhe entre responder do que já tem e buscar informação atual.10:32
Mais 2 ideias deste talk

MCP dá ao agente busca, páginas e navegador

O servidor MCP (protocolo que conecta agentes a ferramentas) da Bright Data reúne mais de 60 ferramentas: busca no Google, páginas em markdown ou HTML, dados de Amazon, Reddit, LinkedIn e automação de navegador. Na comparação lado a lado, o Claude com o MCP leu uma página do Glassdoor e o Claude sem ele foi bloqueado.

Mesmo prompt, resultado diferente: com o MCP a página abre, sem ele o acesso é bloqueado.15:40

Demo final transforma dois dados em uma recomendação

O notebook busca preço, nota e vendedores na Amazon, pesquisa posts no Reddit e manda os dois para o Gemini. A resposta recomenda a compra por causa do desconto e das avaliações positivas, com ressalvas sobre opiniões mistas e estoque baixo. O padrão vale para outros casos além de e-commerce.

O modelo cruza dados da Amazon e do Reddit e justifica a decisão de comprar.25:52
leitura crítica

O talk é um pitch da Bright Data, feita para vender acesso a dados. A comparação do Glassdoor mostra um único caso, sem taxa de sucesso ou custo. A demo da Amazon e do Reddit não mede se a recomendação é boa, e o comentário sobre Reddit cita poucos posts. A afirmação de que agentes dispensam engenheiros para manter scrapers aparece sem dados. O palestrante também não discute os termos de uso dos sites nem a legalidade de contornar bloqueios.

O que fazer com isso

  • Ao desenhar um agente, liste quais perguntas dependem de dado atual e quais podem usar base interna ou cache. Só as primeiras justificam buscar na web.
  • Antes de montar um scraper próprio, estime o custo de manutenção por site e compare com uma API pronta de dados.
  • Revise os termos de uso e o robots.txt dos sites que você pretende coletar antes de contornar qualquer bloqueio.
  • Teste a recomendação do agente contra uma decisão que você já conhece para ver se os dados coletados sustentam a conclusão.

Just-in-Time Ontologies: What Cheap Intelligence Means for Data

Não existe esquema universal de dados. Com inteligência barata, monte a ontologia na hora da decisão e guarde o contexto e as evidências para reuso.

Dados e RAG 21:03 nível ●●●○○ Hrishi Olickel, Southbridge AI Assistir no YouTube (abre em nova aba)

Em 3 frases

Olickel afirma que todo dado tem quatro esquemas (fonte, armazenamento, decisão e a crença prévia do modelo), e que só na hora da decisão dá para conhecer todos. Por isso defende a ontologia just in time, montada quando a pergunta já existe.

O exemplo é a resolução de entidades dos registros de financiamento de campanha de Ohio. Modelos projetistas, modelos trabalhadores e modelos otimizadores se dividem o trabalho, e definições claras e casos separados para teste pesam tanto quanto a escolha do modelo.

Os erros mais perigosos são silenciosos, como sinais de menos removidos de empréstimos, e até vários modelos concordam no erro. Comparar modelos de famílias diferentes concentra a revisão nas discordâncias, mas premissas compartilhadas ainda passam.

Antes de ler

Mais 2 termos

Os quatro esquemas de qualquer dado

Todo dado carrega o esquema da fonte (o que você consegue medir), o do armazenamento (o que cabe registrar), o da decisão (para que serve) e o do modelo (as crenças que ele traz). O exemplo é anotar a temperatura. Cliente também muda de sentido: para cobrança é quem paga, para suporte é quem liga, para compliance é quem gera obrigação.

Cada esquema muda o que o dado significa.02:36

Projetista, trabalhador e otimizador

Agentes de código misturam três papéis numa só janela de contexto. O projetista precisa de modelo lento e forte. O trabalhador dentro do pipeline deve ser barato, rápido e previsível. O otimizador testa variações do pipeline. Separar os papéis facilita encaixar modelos novos, como os de decisão, na camada de baixo.

Cada papel pede um tipo diferente de modelo.08:51

O custo real de Ohio

O trabalho estadual custou US$ 7,95 contra um teto de US$ 800 e uma estimativa anterior de cerca de US$ 10.000. A checagem custou quase quatro vezes mais que as primeiras respostas. Cada rodada de ajuste corrigiu uma definição, como o que é um comitê. Reescrever a pergunta mudou o resultado sem trocar o modelo.

12:04 O gasto se concentra em checar, não em responder.

Mais 2 ideias deste talk

Erros silenciosos que passam em todos os totais

Um arquivo escrevia o campo com hífen e letra maiúscula, e o pipeline esperava outro formato. Contribuições em espécie viraram dinheiro comum. Um formato de data errado deixou 99,4% das datas vazias, e as contagens ainda batiam. Valores negativos de empréstimo viraram positivos e um líquido de 784 mil virou 5,3 milhões de dívida.

Vários modelos validaram um resultado errado.14:34

Discordância entre modelos como filtro de revisão

Em 200 famílias de teste separadas, dois modelos concordaram em 194 e nenhuma dessa concordância estava errada. Todo erro ficou nas seis em que discordaram. Modelos de famílias diferentes têm crenças diferentes. O limite aparece quando quatro famílias compartilham uma convenção de sinal que o gabarito não tinha.

15:41 A revisão humana fica só nos casos de desacordo.

analogia

Failure surface (superfície de falha, o critério que define o que é errar). A failure surface é como a régua de correção que o professor prepara antes da prova, para saber na hora o que conta como resposta errada.

  1. Antes de pedir um trabalho a alguém, você precisa saber como vai reconhecer um resultado errado.
  2. A failure surface (superfície de falha) é esse critério combinado de antemão, a referência contra a qual cada tentativa é comparada.
  3. No caso de Ohio, a equipe rodou bons modelos numa fatia pequena dos dados e conferiu parte à mão. Esse resultado virou a linha de base.
  4. Em outros projetos, a referência pode ser automática, como checagens de esquema (o formato esperado dos dados) ou medidas de comportamento.
  5. Com o critério fixo, dá para trocar modelos e ajustar o pipeline várias vezes, porque cada mudança é medida contra a mesma régua.
FATIA PEQUENAAmostra dos dados do problema
CONFERÊNCIABons modelos e checagem manual
LINHA DE BASEReferência do que é acertar
CRITÉRIO DE FALHAToda tentativa é medida contra ele

Ajuda saber antes: Linha de base, Pipeline de dados, Checagem de esquema

analogia

Codon (segmento de trabalho limitado e checado de forma independente). Um codon é como uma estação numa cozinha de restaurante, onde cada cozinheiro faz uma parte do prato e alguém confere antes de passar adiante.

  1. Um trabalho grande fica mais fácil quando você divide em pedaços pequenos e confere cada pedaço.
  2. Codon é o nome que a equipe da Southbridge dá a cada pedaço de trabalho com limites claros de tarefa, custo e tempo.
  3. Entre um codon e outro roda um código de checagem, que a equipe chama de rig (bancada de teste), e valida a saída antes da próxima etapa.
  4. Cada codon pode ser repetido, testado sozinho e reaproveitado, e depois os codons são postos em sequência para formar o pipeline.
  5. Como cada pedaço é independente, dá para trocar o modelo de um codon por outro mais barato sem mexer no resto.
DIVIDIR O TRABALHOSegmentos com limites claros
CODONExecuta um segmento isolado
RIGCódigo que valida a saída
SEQUÊNCIACodons validados formam o pipeline

Ajuda saber antes: Pipeline de dados, Failure surface, Projeto piloto

leitura crítica

O talk também divulga os produtos da Southbridge, como o Hankwave. O caso de Ohio tem uma só base e a equipe controlou o projeto, então não há comparação independente. O custo de US$ 7,95 não inclui o trabalho de desenho nem os 10 dias do agente e seus 6 bilhões de tokens, e a estimativa de US$ 10.000 é uma projeção. A afirmação de que nenhuma resposta concordante estava errada vale para 200 famílias. A meta de auditoria quase zero no próximo estado é uma expectativa, sem teste.

O que fazer com isso

  • Antes de pedir uma transformação a um agente, escreva a decisão que o resultado vai apoiar e as definições dos termos (cliente, comitê, titular).
  • Separe um conjunto pequeno de casos conferidos à mão e use-o como linha de base antes de escalar qualquer pipeline de dados com IA.
  • Compare totais e contagens de linhas antes e depois de cada etapa e procure campos vazios, sinais trocados e formatos de data.
  • Rode o mesmo trabalho em dois modelos de famílias diferentes e revise só os casos em que discordam, lembrando que premissas comuns ainda passam.

Vector Isn't Enough: Hybrid Search & Retrieval

Busca vetorial sozinha falha com identificadores exatos. Combine com BM25, meça o resultado e só então confie que o agente responda bem.

Dados e RAG 1:16:19 nível ●●●○○ Jeff Vestal & James Williams, Elastic Assistir no YouTube (abre em nova aba)

Em 3 frases

Workshop prático da Elastic mostra por que a busca semântica erra códigos e IDs, e por que a busca por palavra-chave (BM25) erra paráfrases.

A solução apresentada é a busca híbrida, combinada por RRF (ordem dos resultados) ou por combinação linear (scores normalizados com pesos), com filtros, judgment sets e reranker como segunda etapa.

Na demo com o Agent Builder, um agente diagnostica o exit code 137 (falta de memória) buscando na documentação e cita as fontes, o que prova que a qualidade da resposta depende do que a busca entrega.

Antes de ler

Mais 2 termos

Nenhuma busca resolve tudo sozinha

A busca semântica acha o sentido mesmo com palavras diferentes, mas falha com códigos de produto e identificadores exatos. A busca lexical (BM25) acerta a palavra exata, mas perde paráfrases. Os palestrantes defendem usar as duas juntas e chamam isso de tese central da Elastic.

16:48 O fluxo da busca semântica, de onde vêm seus limites

RRF é o ponto de partida, a combinação linear dá controle

O BM25 e a busca vetorial usam escalas de score diferentes, então somar os números não funciona. O RRF ignora o score e usa só a posição de cada documento nas duas listas. A combinação linear normaliza os scores entre 0 e 1 e deixa você ajustar pesos. Antes, vale filtrar por palavra-chave, data ou local para reduzir o conjunto de candidatos.

38:47 A tabela do RRF mostra a fusão por posição, sem usar score

Roteie cada tipo de consulta para a estratégia certa

Ajustar pesos é difícil e não há receita pronta. Uma alternativa prática é criar search templates (modelos de busca) com RRF, combinação linear ou reranker, e deixar um LLM ou uma regra simples escolher o modelo conforme a pergunta. Eles chamam isso de autotuning dos pobres. Judgment sets (consultas com os documentos esperados) medem qual configuração acerta mais.

Rotear consultas entre estratégias de busca com templates41:52
Mais 2 ideias deste talk

Um agente cita fontes quando o dado traz a fonte

Modelos não consultam uma tabela, eles geram tokens. Por isso, entregar os documentos ao LLM e pedir citação permite que o leitor confira a resposta. Na demo, o agente carrega uma skill, busca com ES|QL, explica que o exit code 137 vem do gerenciador de falta de memória e aponta ajustes de JVM, com links para a documentação.

Resposta do agente com trilha de passos e fontes clicáveis1:03:41

Reranker só quando a ordem exata importa

O reranker reavalia um conjunto pequeno de candidatos juntando consulta e documento, ao custo de uma inferência extra na hora da consulta. O modo pointwise pontua cada documento separado. O listwise compara todos juntos e ajuda quando os candidatos são muito parecidos. Se a primeira etapa já entrega algo bom, o reranker pode ser dispensado.

1:10:28 Pointwise avalia um por vez, listwise vê a lista inteira

analogia

Combinação linear (linear combination com scores normalizados). Combinação linear é como calcular a média final de um aluno: você converte a prova e o trabalho para a mesma escala de 0 a 10 e dá mais peso para a prova antes de somar.

  1. Quando duas buscas avaliam os mesmos documentos, cada uma dá uma nota própria. A combinação linear (linear combination) junta essas notas numa nota final única.
  2. Cada busca usa uma régua diferente. O BM25 (busca por palavra-chave) pode dar nota 12 e a busca vetorial pode dar 0,8. Somar esses números direto favorece a busca com números maiores.
  3. Por isso o primeiro passo normaliza os scores (notas de relevância), ou seja, coloca todos na mesma escala. A técnica min-max transforma a menor nota em 0 e a maior em 1.
  4. Depois você multiplica cada nota por um peso e soma. Com peso 0,7 para a busca semântica e 0,3 para a palavra-chave, por exemplo, a soma define a ordem final dos documentos.
  5. Para escolher os pesos, você testa várias combinações contra um judgment set (perguntas com os documentos esperados). O RRF olha só a posição na lista; aqui a força de cada nota também conta.
DUAS BUSCASBM25 e vetorial rodam em paralelo
NORMALIZARNotas vão para a escala de 0 a 1
APLICAR PESOSCada nota vezes o seu peso
SOMARA soma vira a nota final
RANKING FINALLista única, ajustável pelos pesos

Ajuda saber antes: BM25, Busca vetorial, Busca híbrida, Reciprocal rank fusion (RRF)

leitura crítica

É um workshop de uma fornecedora de busca, então a tese de que o hybrid search é a resposta e o Elastic o melhor lugar para rodá-lo é também pitch de produto. Não há medição comparativa de relevância, latência ou custo, só afirmações dos palestrantes. Eles admitem que a afinação automática de pesos ainda não existe e que não sabem o valor padrão do rank constant do RRF. O dataset do lab é pequeno e sintético, e a demo do exit code 137 é um caso único e favorável.

O que fazer com isso

  • Teste sua base com busca por palavra-chave e busca semântica separadas, usando consultas com código de erro ou ID, e veja onde cada uma falha antes de escolher.
  • Monte um judgment set pequeno, com 20 a 30 perguntas reais e os documentos esperados, para comparar RRF, pesos lineares e reranker com número.
  • Quando o agente responder errado, olhe primeiro os documentos recuperados, não o modelo.
  • Exija que o agente cite fontes com link no conteúdo que ele consulta e confira alguns links por amostragem.

RAG Needs a Map: Using GraphRAG to Retrieve Connected Context

Vetores acham trechos parecidos. Um grafo de conhecimento guarda as ligações entre eles, e o agente passa a responder perguntas de contagem e de vários saltos.

Dados e RAG 52:58 nível ●●●○○ Nyah Macklin, Neo4j Assistir no YouTube (abre em nova aba)

Em 3 frases

Nyah Macklin, da Neo4j, ensina em um workshop de nível introdutório como somar um grafo de conhecimento ao RAG (geração com busca de documentos), formando o GraphRAG.

Na prática, o grupo monta o grafo a partir de PDFs com um LLM, cria um índice vetorial no Aura e configura um agente com busca por similaridade e texto para Cypher.

O teste final mostra o agente citando fontes e errando uma contagem de lições, e a palestrante usa o erro para defender que o banco precisa ser conferido à mão.

Antes de ler

Mais 2 termos

Três visões do mesmo objeto: humano, vetor e grafo

Macklin usa uma maçã para mostrar que um vetor é uma lista de números que ninguém lê, enquanto um grafo diz que a maçã vem de uma árvore, é redonda, é vermelha e é uma fruta. O grafo serve a humanos e a máquinas ao mesmo tempo, e isso sustenta a promessa de respostas explicáveis.

O vetor é opaco, o grafo mostra as relações de forma legível.07:40

RAG comum versus GraphRAG

No RAG comum, os PDFs viram chunks (pedaços de texto), recebem embeddings (vetores) e os top k mais próximos vão para o LLM. No GraphRAG, o caminho de busca também passa por um grafo. Macklin recomenda vetor para perguntas que um buscador resolve e grafo para perguntas com vários saltos ou que exigem agregação. Ela defende usar os dois juntos.

A diferença de arquitetura está em um único bloco extra, o grafo.12:45

Configurar a ferramenta de busca no agente Aura

Na tela de criação do agente, a ferramenta de busca de lições usa o índice vetorial chunk embedding, retorna os 5 melhores resultados e usa o modelo text-embedding-3-small da OpenAI, com 1536 dimensões. Uma consulta Cypher devolve nós conectados e pontuações, o que traz o contexto do grafo junto com o trecho.

A busca vetorial entra como ferramenta do agente e devolve dados do grafo.41:12
Mais 2 ideias deste talk

Resposta com fontes e contagem errada

O agente responde que temperatura controla a aleatoriedade do texto e mostra as fontes no curso. Na pergunta sobre quantas lições existem, ele diz 30. O banco tem 15, porque o construtor rodou duas vezes e duplicou nós. A palestrante confere no console e acha o número certo.

Rodar o construtor duas vezes inflou a contagem; só a consulta direta revelou o erro.45:57

O esquema guia o LLM na criação do grafo

No código, um splitter de tamanho fixo corta o texto em chunks. O esquema lista tipos de nós (tecnologia, conceito, exemplo, processo, desafio, benefício), tipos de relação e padrões permitidos entre eles. Com isso o LLM não inventa estrutura nova a cada documento.

O esquema fixa quais nós e relações o LLM pode extrair.49:02
leitura crítica

O talk é um workshop da Neo4j para vender Neo4j e Aura, e a comparação com RAG só de vetores é feita sem benchmark nem medição de acurácia. As afirmações sobre acurácia e explicabilidade ficam sem evidência. O exemplo usa um curso pequeno da própria empresa, com PDFs de um curso introdutório, e o único teste de agregação deu resposta errada por duplicação, o que mostra fragilidade do pipeline. Ela cita a regra de três saltos sem fonte.

O que fazer com isso

  • Antes de adotar GraphRAG, liste as perguntas reais do seu produto e separe as que um buscador vetorial já resolve das que pedem contagem, soma ou vários saltos.
  • Se for testar, defina o esquema de nós e relações antes de rodar o LLM, para evitar que ele invente tipos diferentes a cada documento.
  • Torne o pipeline de construção idempotente (rodar duas vezes dá o mesmo resultado) e confira contagens com uma consulta direta ao banco.
  • Exija que o agente mostre as fontes de cada resposta e compare algumas por amostragem com o banco.

Beyond RAG: Build a Relational Context Engine from Scratch

Busca por similaridade resolve só metade do problema. Perguntas com data, autor ou estado pedem que o modelo escreva a query, não a resposta.

Dados e RAG 38:18 nível ●●●○○ Peter Werry, Unblocked Assistir no YouTube (abre em nova aba)

Em 3 frases

Peter Werry, da Unblocked, mostra que RAG (busca por similaridade em vetores) falha em perguntas como "PRs que eu mergeei semana passada", porque elas têm uma metade temporal e estrutural.

A solução do workshop faz o modelo gerar uma query de banco de dados a partir de quatro peças: descoberta de schema, resolução de identidade, validação com allow list e um loop de retentativa com erros.

O mesmo motor alimenta um agente de chat, mas o próprio palestrante recomenda reforçar a validação antes de usar em produção e diz que a Unblocked usa schemas estáticos.

Antes de ler

Mais 2 termos

RAG não enxerga autor, data nem estado

Ao embutir a frase "PRs que eu mergeei semana passada", a busca vetorial devolve PRs que falam de merge, mas ignora autor, estado e data. O resultado pode ser um PR semanticamente perfeito e mergeado três anos atrás. A recuperação tem duas metades: a semântica e a estruturada.

Mostra por que similaridade sozinha erra perguntas com filtro temporal.05:33

O modelo escreve a query, não a resposta

O plano de consulta passa o schema ao modelo, força uma chamada de ferramenta para extrair nomes e inclui a data atual no prompt. Assim o modelo gera um filtro de banco, por exemplo mapeando "Peter" para o login do GitHub dele. A execução fica a cargo do banco.

A query gerada troca o nome falado pelo login real do autor.16:00

Validação com allow list, nunca deny list

A saída do modelo é entrada não confiável. Cláusulas como where ou function podem rodar JavaScript no servidor, o que abre um ponto de prompt injection. Por isso o código procedural libera só operadores permitidos e apaga campos ocultos, como o tenant ID, para reinjetar o valor correto.

A validação nega por padrão e barra o operador não permitido.19:07
Mais 2 ideias deste talk

Loop de retentativa com o erro como feedback

Quando a query falha na validação ou na execução, o erro volta ao modelo, que tenta de novo até um limite de tentativas. No exemplo, a terceira tentativa caiu em match exato e não achou nada, o que mostrou a necessidade de busca full text. Peter chama esse loop de uma das peças mais importantes.

O modelo precisou de várias tentativas e esbarrou no match exato.21:11

O mesmo motor serve ao agente de chat

A aba de chat usa o mesmo motor do playground. A pergunta "trabalhamos em algo de autenticação semana passada?" faz o agente gerar a query, buscar os dados e raciocinar sobre eles. A diferença é que o chat raciocina e o playground só consulta.

O agente gera a query e raciocina sobre o resultado.23:10
leitura crítica

O workshop é uma demonstração didática de uma empresa de contexto organizacional, com um único repositório e só pull requests. Não há medição de acerto, custo ou latência. Peter admite que o algoritmo de schema é hacky, que a amostra de 300 documentos veio de tentativa e erro com clientes e que sempre vai faltar algum documento. Ele também diz que a Unblocked usa schemas estáticos em produção e que a validação precisa de mais trabalho antes de uso interno.

O que fazer com isso

  • Separe suas perguntas em dois tipos. Perguntas com data, autor, estado ou contagem pedem filtro estruturado. Perguntas sobre conteúdo pedem busca semântica.
  • Ao deixar um modelo gerar consultas, valide a saída com código: libere só operadores permitidos e remova campos sensíveis, como tenant ID, antes de executar.
  • Passe a data atual e o schema no prompt, e devolva ao modelo as mensagens de erro para ele corrigir a query em poucas tentativas.
  • Combine as duas metades: comece com busca vetorial para achar pontos de partida e dê ao agente uma ferramenta de consulta estruturada para aprofundar.

Beyond RAG: A Relational Context Engine That Cuts Token Burn

RAG responde perguntas de conteúdo. Perguntas de estrutura (quem, quando, quantos) pedem um motor de consulta com schema, validação e retry.

Dados e RAG 19:44 nível ●●●○○ Unblocked Assistir no YouTube (abre em nova aba)

Em 3 frases

Peter Werry, da Unblocked, mostra que um context engine (motor de contexto) entrega ao agente de código PRs, Slack e documentos relacionados, e que isso reduziu o custo de uma sessão em cerca de 50% na demo.

Busca vetorial não responde perguntas como "quais PRs eu fechei semana passada", que são consultas estruturadas. O talk constrói um motor que converte linguagem natural em query de banco.

A parte difícil é o entorno da query: descobrir o schema, resolver identidades, validar a query gerada pelo LLM, devolver erros ao modelo para novas tentativas e somar busca full-text.

Antes de ler

Mais 2 termos

Contexto pronto reduz o trabalho do agente

Sem context engine, o Claude explora o código do zero, como um funcionário novo. Com ele, recebe um pacote de contexto da tarefa, com código, documentos do Notion, PRs e conversas do Slack, mais links para buscar detalhes. Na demo, a sessão custou US$ 1,29 em 1min30 contra cerca de US$ 2,60 em 3 minutos.

Comparação de custo e tempo com e sem context engine.03:41

Rastrear uma regressão até a troca de modelo

Um colega notou que o produto de code review achava cada vez menos problemas. Ao perguntar à Unblocked, ela ligou a queda à troca de versão do modelo Opus e criou um PR de correção, com descrição que cita o PR causador e a conversa no Slack. A fala sobre as versões saiu confusa na legenda automática.

O PR de correção traz o histórico que explica a regressão.05:14

Busca semântica não faz consultas

RAG cobre bem perguntas de conteúdo: o código, o PR que o mudou, a thread que o discute. Perguntas como "PRs que fechei semana passada" ou "quem mais revisou pagamentos" são filtros e agregações com tempo. Essa informação não está codificada em um vector store (banco de vetores), então precisa de um motor de consulta.

Pergunta com recorte temporal que um vector store não responde.07:20
Mais 2 ideias deste talk

Gerar a query é a parte fácil

Quatro peças cercam o LLM: schema para limitar a query, mapeamento de identidades entre sistemas, validação da query (que é não confiável) e retry quando há erro. Schema e identidades saem bem de métodos procedurais comuns, com o LLM só como desempate. A síntese recebe schema, data atual e dados do usuário.

O entorno da query dá mais trabalho que a geração em si.08:21

Validar bloqueia operadores perigosos e vira feedback

A query do LLM pode trazer operadores como $function, que executa JavaScript no servidor, ou tocar campos de tenant. A validação barra isso e injeta o filtro de tenant por baixo, sem o modelo ver. Na demo, uma regex foi barrada; o erro voltou ao LLM, que tentou de novo em um loop com limite de tentativas.

A validação recusa a regex e o erro alimenta a próxima tentativa.14:40
leitura crítica

É em parte pitch da Unblocked. A economia de 50% vem de uma única sessão escolhida pelo palestrante, sem repetições nem média, e a tarefa não é descrita. O caso da regressão é um exemplo único, contado por um colega. A parte de construção é útil, mas o repositório usa um banco de documentos e uma coleção simples de PRs, bem longe da escala real. O simulador open source seria o jeito de verificar o ganho.

O que fazer com isso

  • Classifique as perguntas que seu agente recebe em semânticas (achar conteúdo) e estruturais (contar, filtrar, agrupar por data). Só as estruturais precisam de consulta a banco.
  • Se o agente gera queries, trate a saída do LLM como não confiável: valide operadores, bloqueie campos sensíveis e injete filtros de tenant fora do modelo.
  • Devolva a mensagem de erro da query ao modelo em um loop com limite de tentativas, em vez de falhar na primeira.
  • Teste o ganho de contexto pré-reunido com o simulador open source da Unblocked, rodando a mesma tarefa com e sem contexto.

The Data Context Layer for Agents

Um grafo de contexto dá ao agente a estrutura que o grep não dá, mas só vale se o agente usar a ferramenta e o eval medir esse uso.

Agentes 1:46:21 nível ●●●○○ Yoni Michael & Brandon Callender, Typedef Assistir no YouTube (abre em nova aba)

Em 3 frases

A Typedef defende que agentes de dados erram por falta de contexto sobre o que cada linha de tabela significa, quais joins são seguros e o que quebra numa mudança, e propõe computar esses fatos e guardá-los num grafo consultável.

No workshop, Brandon Callender monta um grafo de código sobre cinco crates do Qdrant com tree-sitter, rustdoc JSON e Neo4j, e mostra que ele separa dois tipos chamados PostingList que o grep mistura.

O agente continua usando grep mesmo com a ferramenta nova, então o trabalho difícil fica em nomear a ferramenta como ele espera, devolver saídas no formato do ripgrep, medir a adoção e medir a consistência com pass^k, além de ler os traces.

Antes de ler

Mais 2 termos

Busca por texto não tem noção de identidade

Brandon pergunta ao agente sobre a struct PostingList do Qdrant. O ripgrep devolve dois resultados exatos e mais uma dúzia de nomes parecidos. O agente escolhe um, talvez o errado, e volta atrás. O texto não diz qual símbolo importa, onde ele é usado nem em que crate vive.

O grep acha os dois PostingList, mas não diz qual é qual.29:17

Resolução de símbolos separa os homônimos

O tree-sitter dá a estrutura sintática, mas os dois PostingList ainda colidem. O rustdoc JSON do compilador Rust resolve cada símbolo para um nome canônico, com arquivo e linha. A ferramenta blast radius então devolve conjuntos diferentes de dependentes para cada tipo, numa só chamada.

43:37 Cada PostingList tem seu próprio conjunto de dependentes no grafo.

O agente ignora a ferramenta melhor

Com ferramentas de grafo e grep disponíveis, o agente usa grep. Brandon atribui isso ao pós-treino, que reforça esse hábito. A saída prática é chamar a ferramenta de search, devolver resultados no formato do ripgrep e garantir que a primeira chamada já traga algo útil, porque o agente abandona uma ferramenta que parece quebrada.

Nome e formato da ferramenta pesam tanto quanto a qualidade dela.1:00:44
Mais 2 ideias deste talk

Acertar uma vez e acertar sempre dão placares opostos

Com uma execução por pergunta, o agente de grafo mal supera o de grep. Com cinco repetições, pass@k (acertou ao menos uma vez) fica parecido, mas pass^k (acertou em todas) inverte o quadro: o agente de grafo vai melhor. Ele também gasta cerca de 3,1 vezes menos tokens.

1:07:59 O mesmo experimento muda de vencedor conforme a métrica de consistência.

Placar favorável pode esconder falha na ferramenta

Brandon refez uma palestra inteira porque, ao ler os traces, viu que a ferramenta de busca devolvia caminhos de arquivo errados. O placar apontava na direção certa, mas por motivos errados. A regra dele é endurecer o eval, ler os traces e nunca confiar no próprio placar.

A leitura dos traces revelou um defeito que o placar não mostrava.1:24:07
analogia

Resolução de símbolos (ligar cada nome no código à sua definição única). Resolução de símbolos é como a secretaria da escola que separa dois alunos chamados João Silva pelo número de matrícula, para que cada nota vá para o boletim certo.

  1. Num programa, cada coisa tem um nome, como uma função ou um tipo de dado. Às vezes duas coisas diferentes recebem o mesmo nome em lugares diferentes.
  2. Uma busca por texto, como o grep (comando que procura palavras em arquivos), acha todas as ocorrências do nome, mas não sabe dizer qual delas é qual.
  3. Um parser (leitor da estrutura do código), como o tree-sitter, entende a gramática do código, mas os dois tipos PostingList do Qdrant continuam colidindo nesse nível.
  4. A resolução liga cada uso do nome à sua definição única. No Rust, o compilador já faz isso e exporta o resultado no rustdoc JSON, com nome canônico, arquivo e linha.
  5. Com cada símbolo identificado, o grafo pode guardar relações separadas para cada um, e ferramentas como o blast radius (raio de impacto) devolvem dependentes diferentes para cada PostingList.
CÓDIGO COM NOMES IGUAISdois PostingList em arquivos distintos
ÁRVORE SINTÁTICAtree-sitter lê a estrutura
COMPILADOR RESOLVErustdoc JSON liga uso à definição
NOME CANÔNICO ÚNICOcada tipo com arquivo e linha

Ajuda saber antes: Símbolo no código, Busca por texto (grep), Árvore sintática (AST), Compilador

analogia

pass@k e pass^k (acertou ao menos uma vez versus acertou em todas as repetições). pass@k e pass^k são como avaliar um goleiro em cinco pênaltis, contando se ele defendeu pelo menos um ou se defendeu todos.

  1. Um agente de IA pode responder a mesma pergunta de jeitos diferentes a cada vez. Por isso uma única tentativa diz pouco sobre ele.
  2. Para medir melhor, a avaliação roda cada pergunta k vezes. No workshop, foram 30 perguntas repetidas cinco vezes.
  3. O pass@k (passou em alguma) marca acerto se pelo menos uma das k tentativas estiver certa. Ele mede se o agente consegue chegar à resposta.
  4. O pass^k (passou em todas) só marca acerto se as k tentativas estiverem certas. Ele mede se o agente é confiável e repete o acerto.
  5. No experimento, o agente de grep e o de grafo empataram no pass@k, mas no pass^k o agente de grafo acertou cerca de duas vezes mais e gastou 3,1 vezes menos tokens.
MESMA PERGUNTA K VEZESex.: 5 rodadas por pergunta
CORRIGIR CADA RODADAcerto ou errado em cada uma
PASS@Kacertou ao menos uma vez
PASS^Kacertou em todas as rodadas
COMPARAR OS PLACARESmostra se o agente é consistente

Ajuda saber antes: Eval (avaliação de agentes), Aleatoriedade nas respostas do modelo, Agente de IA

leitura crítica

A primeira metade é pitch da Typedef. O ganho de cerca de 35 pontos vem de um benchmark interno, sem tabela, sem intervalo e sem comparação publicada com outras ferramentas. A segunda metade é mais honesta: Brandon admite empate com 1 execução, usa só 30 perguntas e o grafo não cobre as partes privadas dos crates, o que favorece o grafo em algumas perguntas. Ele mesmo diz que não vale cada pessoa construir isso como produto. A tese vale, mas o benchmark do Mattermost (300 a 350 modelos dbt) é próprio e não verificado.

O que fazer com isso

  • Ao dar uma ferramenta nova a um agente, meça a adoção nos traces (quantas vezes ele a chama) antes de julgar se a ferramenta é boa.
  • Nomeie a ferramenta com o verbo que o agente já conhece, como search, e devolva a saída no formato de um comando familiar, como o ripgrep.
  • Ao avaliar um agente, rode cada pergunta várias vezes e compare pass@k com pass^k, para saber se ele acerta sempre ou só às vezes.
  • Antes de aceitar um resultado de eval, leia alguns traces completos e procure atalhos, como o agente consultando o git para achar a resposta.

Teaching Agents to Search with NVIDIA Data Designer

Comportamento de agente vira problema de dados: gere em excesso, filtre forte e olhe os exemplos antes de treinar.

Dados e RAG 55:30 nível ●●●○○ Dhruv Nathawani, NVIDIA Assistir no YouTube (abre em nova aba)

Em 3 frases

Dhruv Nathawani, da NVIDIA, mostra como usar o Data Designer, ferramenta open source, para gerar dados sintéticos que ensinam um modelo a pesquisar na web em vez de responder de memória.

O fluxo parte de caminhos no Wikidata, transforma cada caminho em uma charada, deixa um agente buscar a resposta com a Tavily via MCP e filtra o resultado para uso em fine-tuning supervisionado.

A parte mais difícil é verificar se as respostas estão certas, porque até a fonte pode ficar desatualizada. Ele combina juiz LLM, checagem determinística e revisão humana.

Antes de ler

Mais 2 termos

Dados gerados coluna a coluna

O Data Designer monta o conjunto de dados como um grafo de colunas. Uma coluna de semente traz dados reais, colunas sampler injetam variedade (por exemplo, dificuldade fácil, média ou difícil) e colunas de LLM geram texto ou JSON. O ponto é fugir do laço que repete o mesmo prompt, que passa a repetir conteúdo depois de 10 a 20 tentativas.

A receita do dataset é um grafo de colunas que qualquer pessoa pode reexecutar.06:26

Preview antes do lote

Antes de gerar milhares de registros, o modo preview cria só três. Nathawani lê as perguntas, as respostas e a nota do juiz, e ajusta prompts ou samplers. Só depois dispara o lote. Ele insiste que criar dados é um processo iterativo e que olhar os exemplos é a melhor checagem de qualidade.

Três registros de preview bastam para ver se o prompt está produzindo o que se quer.12:44

Charadas a partir de caminhos no Wikidata

A semente é um caminho de 5 a 8 saltos no grafo Wikidata, como NVIDIA, Jensen, Oregon State, Benton County e Thomas Hart Benton. O modelo escreve uma pergunta que exige encadear várias buscas. Perguntas assim não estão no treino do modelo, então ele precisa usar a ferramenta de busca em vez de trapacear. Acima de 8 saltos, o caminho tende a sair do assunto.

Cada caminho no grafo vira uma pergunta que só se responde com várias buscas.24:13
Mais 2 ideias deste talk

Do funil de 50 mil sementes a 7 mil registros

Do total gerado, só uma fração sobrevive ao filtro. Para ele, a qualidade do dado pesa mais que o volume, e diversidade é um dos eixos de qualidade. Ele mostra uma função que cruza a nota do juiz LLM com o tamanho da pergunta e a taxa de aprovação de cada faixa.

O filtro descarta a maior parte dos registros e a taxa de aprovação varia por faixa.40:49

A fonte de verdade também envelhece

Uma charada perguntava qual país é dono da US Steel. O agente respondeu EUA, o verificador aceitou, mas a empresa foi vendida ao Japão. Até a semente do Wikidata estava desatualizada. Por isso ele combina juiz LLM, checagem determinística (que deu cerca de 24% de acerto por ser rígida) e revisão humana dos julgamentos do juiz.

O verificador aprovou uma resposta que já estava desatualizada na fonte.41:21
leitura crítica

O talk também divulga o ecossistema da NVIDIA (Data Designer, Nemotron, NeMo Gym, Anonymizer). Os ganhos citados (0% a 30% no BrowseComp, 26% a 41% no BIRD) vêm do próprio palestrante, sem baseline, número de execuções ou comparação com outros dados. A checagem determinística de 24% e o caso da US Steel mostram que a avaliação do dado gerado segue em aberto. O uso de Tavily vem de um acordo de créditos, como ele admite. O modelo gerador (GPT-OSS 120B) limita o teto da qualidade.

O que fazer com isso

  • Antes de gerar um dataset grande, rode um preview de 3 a 10 registros e leia tudo à mão. Ajuste o prompt até o exemplo ficar bom.
  • Ao criar dados com modelo, acrescente uma coluna de variação (dificuldade, tipo, persona) em vez de repetir o mesmo prompt, e gere mais do que precisa para filtrar depois.
  • Em avaliação com juiz LLM, separe uma amostra dos julgamentos para revisão humana e confira se o juiz concorda com as pessoas antes de confiar na nota.
  • Guarde a receita de geração em código versionado, para que outra pessoa reproduza o dataset com pequenas mudanças.

An AI Future Without the Lock-In

Para fugir do lock-in, separe as quatro camadas da IA interna e ponha um AI gateway no meio, com identidade, orçamento e logs.

Infraestrutura 19:38 nível ●●●○○ Remy Guercio, Tailscale Assistir no YouTube (abre em nova aba)

Em 3 frases

Remy Guercio, da Tailscale, diz que o ano do "token maxing" (gastar token sem limite) acabou e que as empresas agora precisam provar retorno, o que ele chama de "ROI maxing".

Ele divide uma implantação interna de IA em quatro camadas (modelos, conectores de dados, interface e sandbox) e defende que a empresa consiga trocar cada uma sem refazer o resto.

O AI gateway, no caso o Aperture, fica no meio dessas camadas e usa a identidade da rede Tailscale para controlar acesso, orçamento por modelo e logs, sem chaves de API compartilhadas.

Antes de ler

Mais 2 termos

De token maxing para ROI maxing

No último ano, muita empresa tratou o orçamento de IA como ilimitado. Isso mudou nos últimos meses. O palestrante vê sessões com centenas de mensagens sem limpar o contexto e cache cheio o tempo todo. A resposta de pânico, concentrar tudo em um ou dois fornecedores, reduz a escolha. ROI maxing significa provar valor e abrir o uso para mais gente.

O foco passa de gastar token para provar retorno.05:11

As quatro camadas de uma IA interna

Toda implantação interna tem LLMs, conectores de dados (MCP, CLI, API ou leitura de arquivo), interface (chat, IDE, Slack) e sandbox. Cada camada pode ser trocada de forma independente. Times diferentes escolhem coisas diferentes: engenharia no IDE, marketing no Slack. A liberdade de escolha em cada camada é o que evita o lock-in.

As quatro camadas que podem ser trocadas separadamente.06:13

Identidade da rede no lugar de chaves sintéticas

Gateways comuns trocam as chaves dos provedores por outras chaves que você cria para cada usuário. O Aperture usa a rede Tailscale (baseada em WireGuard): cada conexão já traz a identidade do usuário, da máquina ou do agente, com grupos sincronizados de Entra ou Okta. A biblioteca open source tsnet, usada para construir o Aperture, permite ver essa identidade.

Cada conexão na tailnet carrega identidade, sem nova chave.09:51
Mais 2 ideias deste talk

Orçamento por modelo e acesso por time

Com a identidade conhecida, o gateway define quais modelos e provedores cada pessoa pode usar. A regra do exemplo é orçamento ilimitado para modelo barato e bem restrito para modelo de fronteira. A mesma lógica vale para MCP: marketing acessa Calendar e Gmail, engenharia também acessa GitHub, até só leitura.

Configuração de provedores e orçamentos por modelo no gateway.11:54

Logs para diagnosticar o que o agente fez

Com todo o tráfego passando pelo gateway, dá para pedir a um agente que analise o log e explique onde outro agente errou. Segundo o palestrante, modelos baratos têm dificuldade de parar sozinhos, mas analisam bem o erro depois. Isso serve também para uso individual, como agentes rodando em segundo plano.

18:08 Logs do gateway permitem diagnosticar ações inesperadas do agente.

analogia

Tailnet e tsnet (rede privada Tailscale e sua biblioteca em Go). Uma tailnet é como o crachá de um prédio de escritórios, em que cada porta já sabe quem você é e de qual equipe faz parte, e o tsnet é como entregar um crachá próprio a um programa.

  1. A Tailscale cria uma rede privada que liga só os seus aparelhos, como notebooks, servidores e contêineres, mesmo que eles estejam em lugares diferentes. Essa rede privada se chama tailnet.
  2. Você instala o agente da Tailscale em cada máquina. A partir daí, as máquinas conversam direto entre si numa rede em malha (mesh network), por cima do WireGuard, um protocolo de conexão criptografada.
  3. Cada conexão dentro da tailnet chega com a identidade de quem está do outro lado. Pode ser um usuário, uma máquina marcada com uma etiqueta (tag), como um robô que revisa código, e os grupos sincronizados do Entra ou do Okta.
  4. O tsnet é uma biblioteca open source (de código aberto) em Go que coloca um programa dentro da tailnet como se ele fosse mais uma máquina. Assim o programa consegue ler a identidade de cada conexão que recebe.
  5. A Tailscale construiu o gateway Aperture com o tsnet. Por isso o gateway sabe quem faz cada chamada ao modelo e aplica acesso e orçamento sem criar chaves de API novas para cada pessoa.
AGENTE INSTALADONotebook, servidor ou contêiner entra
CONEXÃO NA TAILNETTúnel criptografado com WireGuard
IDENTIDADE ANEXADAUsuário, tag de máquina e grupo
APP COM TSNETLê quem está do outro lado
ACESSO SEM CHAVE NOVAGateway aplica regras por pessoa

Ajuda saber antes: Rede privada (VPN), Criptografia, Chave de API, AI gateway

leitura crítica

O talk é pitch do Aperture, produto da empresa do palestrante, e ele mesmo diz isso. Não apresenta dados de economia, nem casos de clientes com números. As afirmações sobre sessões longas e desperdício de token vêm da experiência dele com centenas de conversas, sem amostra mensurável. A defesa de que o gateway evita lock-in ignora que o próprio gateway vira uma nova dependência, no caso da rede Tailscale. Funcionalidades como a autenticação pass-through e a orquestração de sandbox são promessas futuras.

O que fazer com isso

  • Liste as quatro camadas (modelo, conectores de dados, interface, sandbox) da IA usada na sua equipe e marque em quais você já está preso a um fornecedor.
  • Revise as sessões longas de agente de código no seu time e limpe ou compacte o contexto com mais frequência para reduzir gasto.
  • Avalie um AI gateway (o Aperture ou outro) para concentrar chaves, logs e orçamento por modelo antes de consolidar tudo em um só fornecedor.
  • Se rodar agentes em segundo plano, guarde os logs das chamadas para poder investigar depois quando algo inesperado acontecer.

AI Apps in a Flash: Ship to GPUs Without Docker

Rodar código Python direto em GPU de nuvem, sem Docker, encurta o ciclo de teste e deixa o engenheiro de ML focado no experimento.

Infraestrutura 14:22 nível ●●○○○ Dean Quiñanola, Runpod Assistir no YouTube (abre em nova aba)

Em 3 frases

O palestrante diz que o ciclo tradicional (escrever código, montar imagem Docker, enviar ao registro, executar) leva cerca de 15 minutos por iteração em apps de IA.

O Runpod Flash deixa o dev rodar funções Python em GPU remota como se fossem locais, com instalação de dependências na hora e deploy por um comando, o flash deploy.

A demo ao vivo evolui uma função de checar a GPU para geração de texto e depois de imagem, e termina com o endpoint em produção chamado por API.

Antes de ler

O loop do Docker é o gargalo

Em app de IA serverless, cada mudança no código exige build da imagem, push para o registro e nova execução. O palestrante estima cerca de 15 minutos por volta. A proposta do Flash é cortar esse caminho para escrever, executar e ver o resultado.

O ciclo que o Flash promete eliminar, com estimativa de 15 minutos.00:44

Live serverless na prática

Com o comando flash dev, sobe uma API local que dispara a função numa GPU remota. A primeira função só consulta o torch e devolve a placa usada. O resultado mostra uma RTX 4090, depois de uma espera de cold start (partida a frio do worker).

Função local rodando de fato numa GPU remota, após o cold start.05:02

Dependências instaladas na hora

Ao trocar a função por geração de texto, o Flash recarrega o endpoint e instala as bibliotecas Python durante a execução. Sem o token do Hugging Face, o modelo recusou a pergunta. Com o token no código, respondeu. A correção foi só editar e executar de novo.

06:38 Instalação de dependências em tempo de execução, sem rebuild de imagem.

Mais 2 ideias deste talk

Deploy com um comando

Depois da geração de imagem, o flash deploy empacota o app, envia aos servidores da Runpod e expõe um endpoint de produção. A demo chamou esse endpoint com um novo prompt e recebeu a imagem em base64. O palestrante repete que não há Docker no caminho.

Saída do flash deploy: empacota, envia e sobe o endpoint.10:49

Chamadas entre endpoints e volumes

Um endpoint pode chamar outro como se fosse uma função local, sem o dev precisar saber o endereço de cada servidor. Volumes de rede com cache aquecido levam o cache junto quando o endpoint escala. A parte está listada em slide e não foi demonstrada.

Lista de recursos anunciados, sem demo ao vivo.02:50
leitura crítica

É uma apresentação de produto da Runpod, feita por um funcionário. Não há benchmark: os 15 minutos do loop Docker são experiência pessoal e não se mostra o tempo do Flash. A demo teve cold start, rollout travado que foi encerrado à mão e uma imagem que não saiu como pedido. Endpoint-to-endpoint e warm caching só aparecem em slide. O suporte a pods ainda não existe. A única prova de adoção é um hackathon interno.

O que fazer com isso

  • Meça quanto tempo seu ciclo de build e deploy de um app com GPU leva hoje e compare com uma alternativa sem imagem própria antes de adotar qualquer ferramenta.
  • Se testar o Flash, use os US$ 10 de crédito citados e rode um dos exemplos do repositório flash-examples antes de migrar um projeto real.
  • Planeje o cold start do endpoint na experiência do usuário final, pois a demo mostrou a espera já no primeiro uso.
  • Guarde tokens como o do Hugging Face em variáveis de ambiente e não no código, mesmo em protótipos de demo.

Zero Cold Starts: Serverless AI Agents on Akamai Functions

WebAssembly no servidor elimina o cold start e deixa MCPs e agentes rodarem perto do usuário, com um único comando de deploy.

Infraestrutura 22:37 nível ●●●○○ Thorsten Hans Assistir no YouTube (abre em nova aba)

Em 3 frases

Thorsten Hans, da Akamai, argumenta que containers e VMs sofrem com cold start (partida a frio) e com regiões únicas, e propõe WebAssembly como alternativa leve, portátil e isolada por padrão.

Ele mostra ao vivo como criar um servidor MCP com wasmcp e Spin, testar no MCP Inspector, publicar no Akamai Functions em cerca de 60 segundos e usá-lo no editor Zed.

Na parte final, publica um agente feito com o Vercel AI SDK, ligado a um modelo numa GPU da Linode, e mede cerca de 820 ms para o ciclo completo com o LLM.

Antes de ler

Mais 2 termos

O custo do cold start em containers e VMs

Containers e VMs podem levar de segundos a minutos para subir quando a demanda dispara. Para evitar isso, as equipes mantêm servidores ociosos, o que aumenta a conta de nuvem e o impacto ambiental. Soluções de nível mais alto costumam trazer SDKs proprietários, e migrar depois fica caro.

O slide lista os atritos das arquiteturas presas a uma região.01:36

WebAssembly como contêiner mais leve

O palestrante compara WebAssembly a containers como containers são a VMs: binários pequenos, fáceis de distribuir e rápidos de iniciar. O Spin, projeto da CNCF, reúne CLI, runtime baseado em Wasmtime e SDKs por linguagem. O Akamai Functions é a plataforma que executa esses binários no mundo todo.

O slide mostra as peças do Spin que compõem a pilha edge native.03:39

Montar um MCP só com a lógica de negócio

O wasmcp gera um projeto com as ferramentas (tools) e cuida de autenticação e protocolo. O fluxo da demo é wasmcp new, make para compilar em Wasm, wasmcp compose para montar o servidor e spin up para rodar local. Depois o MCP Inspector confirma que a ferramenta responde.

A demo mostra o caminho do scaffold até o servidor MCP rodando em localhost.09:25
Mais 2 ideias deste talk

Deploy global com um comando

O comando spin aka deploy empacota o app em camadas OCI e envia para o Akamai Functions. A plataforma distribui o pacote por todas as regiões, faz um health check em cada uma e só então libera um subdomínio público. Segundo o palestrante, leva cerca de 60 segundos. O Zed consome o MCP publicado e executa as ferramentas de registro de decisões.

13:06 O deploy distribui o MCP pelas regiões e devolve uma URL pública.

Agente com Vercel AI SDK e medição de latência

O agente de jogos lança moedas e dados, usa o Vercel AI SDK e chama um modelo numa GPU dedicada da Linode. Os cabeçalhos HTTP mostram o ponto de presença e a região mais próxima. O palestrante explica que o snapshot de memória, feito na compilação, mantém o runtime JavaScript aquecido.

18:53 Os cabeçalhos mostram a região atendida e o tempo da chamada.

analogia

Memory snapshot (cópia do estado da memória gravada na compilação). Um memory snapshot é como deixar a marmita pronta e congelada no domingo, para que na segunda você só esquente e coma, sem precisar cozinhar tudo de novo.

  1. Todo programa precisa se preparar antes de responder. Ele carrega o que vai usar e organiza tudo na memória do computador, e essa preparação leva tempo.
  2. Um memory snapshot (fotografia da memória) guarda essa memória já preparada num arquivo. Na próxima vez, o programa abre o arquivo e começa direto do ponto em que estava pronto.
  3. Linguagens interpretadas, como JavaScript, precisam de um interpretador que lê o código na hora. No Spin, a compilação carrega o interpretador, o código do usuário e todas as dependências, e roda a parte inicial do programa.
  4. Depois disso, o compilador tira a fotografia da memória e grava tudo dentro do binário WebAssembly. Quando chega uma requisição, o runtime (ambiente de execução) já está aquecido, o que reduz o cold start (partida a frio).
  5. O custo é o tamanho. O app precisa levar o próprio runtime JavaScript junto. O palestrante cita o SpiderMonkey otimizado, com cerca de 10 MB, e afirma sem mostrar dados que isso supera o JavaScript nativo.
CARREGA INTERPRETADORRuntime JavaScript entra na memória
CARREGA CÓDIGOSeu JavaScript e as dependências
AVALIA ESCOPO GLOBALRoda a preparação inicial do app
GRAVA SNAPSHOTMemória salva no binário Wasm
PARTIDA AQUECIDAApp responde sem refazer o preparo

Ajuda saber antes: Cold start, WebAssembly, Linguagem interpretada, Runtime

leitura crítica

O talk é pitch de produto: o palestrante é advocate da Akamai e vende o Akamai Functions. Os números (menos de 0,5 ms de cold start, 60 segundos de deploy, 33 ms) saem de demos e de afirmações da própria empresa, sem benchmark comparativo com Lambda, Cloudflare Workers ou containers. A medida de 33 ms foi feita antes de um erro e a de cerca de 820 ms é de poucas tentativas. Não há custo, limites de memória ou de tempo de execução. A frase de que apps JavaScript em Wasm superam o JavaScript nativo não vem com dados.

O que fazer com isso

  • Se você mantém MCPs ou agentes em containers, meça o cold start real deles antes de decidir mudar de plataforma.
  • Teste o wasmcp localmente com o template de tools para entender como separar lógica de negócio de autenticação e protocolo.
  • Antes de adotar um serviço gerenciado, pergunte quais SDKs ou formatos proprietários ele exige e quanto custaria migrar depois.
  • Peça ao fornecedor um benchmark reproduzível, com percentis de latência, em vez de aceitar o tempo de uma demo.

Turning My Obsidian Vault Into a Local AI Engineer

Um servidor MCP manda o trabalho pesado e sensível para modelos abertos na sua nuvem, e o agente só vê o resultado enxuto e anonimizado.

Infraestrutura 47:25 nível ●●●○○ Filip Makraduli, Superlinked Assistir no YouTube (abre em nova aba)

Em 3 frases

Filip Makraduli mostra como ligar o Claude Code a um servidor MCP que envia documentos para modelos abertos rodando na nuvem privada do usuário, usando o motor de inferência Superlinked SIE.

Na demo, um NDA e contratos escaneados passam por OCR e por redação de dados pessoais antes de o agente receber um arquivo Markdown menor, o que reduz tokens e evita expor dados sensíveis.

Na parte final, ele cita ganhos de desempenho com batching, troca de modelos na GPU e LoRAs, apresenta o roteamento de modelos como ideia futura e admite que o limite de privacidade ainda precisa de mais testes.

Antes de ler

Mais 2 termos

Delegar o trabalho pesado a um servidor MCP privado

O agente continua no fluxo normal. Quando surge uma tarefa cara em tokens ou sensível, ele chama uma ferramenta MCP. Essa ferramenta envia o arquivo para workers com GPU na nuvem do usuário. O Claude Code recebe de volta só o resultado processado.

A arquitetura separa o agente, o servidor MCP e o cluster que processa os documentos.10:50

Um conjunto de ferramentas para documentos

O pacote expõe ferramentas para converter documentos em Markdown com OCR, extrair entidades, legendar e etiquetar, gerar estruturas, resumir e responder perguntas. Ele é open source, então qualquer pessoa pode contribuir com novas ferramentas que usam a mesma inferência.

14:28 Lista das ferramentas disponíveis, de docs para Markdown a perguntas e respostas.

Redação de um NDA no Claude Code

Na demo, o prompt pede para redigir (mascarar) os dados do NDA. A ferramenta devolve o texto com e-mail, nome e outros dados pessoais trocados por rótulos. O resumo da chamada mostra 10 trechos mascarados e a contagem por tipo de rótulo.

A saída da ferramenta mostra quantos trechos foram mascarados e de que tipo.20:14
Mais 2 ideias deste talk

Scan vira Markdown sem dados pessoais

Um contrato escaneado é uma imagem, então precisa de OCR. O palestrante compara o arquivo antes e depois. O resultado é um Markdown legível com os dados pessoais mascarados. Uma barra de status também contabiliza os tokens economizados, embora ele diga que ainda precisa ajustar essa contagem.

O mesmo contrato como imagem escaneada e como texto Markdown já mascarado.22:21

Batching por worker e embeddings mais baratos

A equipe diz que uma fila compartilhada, da qual cada worker puxa trabalho, deu melhor latência de ponta a ponta. Nos testes de embeddings com tarefas do MTEB, o melhor modelo aberto por tarefa chegou a 99,8% do modelo de fronteira, com preço cerca de 10 vezes menor.

O slide mostra a qualidade relativa e a diferença de preço dos embeddings abertos.27:34
analogia

LoRA (adaptador leve de fine-tuning que especializa um modelo numa tarefa). LoRA é como colar post-its com ajustes num livro de receitas grande, sem reescrever o livro inteiro.

  1. Um modelo de IA sai de fábrica sabendo um pouco de tudo, mas pode errar em assuntos de nicho, como a linguagem jurídica em alemão.
  2. Fine-tuning (ajuste fino) é treinar o modelo de novo com exemplos do seu nicho para ele melhorar naquele assunto.
  3. LoRA (Low-Rank Adaptation, adaptação de baixa ordem) congela os pesos originais do modelo e treina só um conjunto pequeno de pesos extras, chamado adaptador.
  4. Como o adaptador é pequeno, ele sai barato e rápido de treinar. No talk, colegas do palestrante criaram LoRAs para alemão jurídico com custo baixo.
  5. Um mesmo modelo base pode receber vários adaptadores e trocar entre eles. Assim a equipe testa cada LoRA em produção e fica com o que rende mais.
MODELO BASEPesos originais ficam congelados
DADOS DO NICHOExemplos de alemão jurídico
ADAPTADOR LORAPoucos pesos extras treinados
MODELO ESPECIALIZADOBase mais adaptador, fácil de trocar

Ajuda saber antes: Fine-tuning, Pesos do modelo, Modelo base

analogia

Hot swapping de modelos (trocar modelos carregados na mesma GPU sem reiniciar o serviço). Hot swapping de modelos é como uma cozinha com um fogão só, onde o cozinheiro troca a panela conforme o pedido sem apagar o fogo.

  1. Um modelo de IA precisa ficar carregado na memória de uma placa de vídeo, a GPU (unidade de processamento gráfico), para responder.
  2. GPU custa caro. Reservar uma GPU inteira para um modelo pequeno que fica parado boa parte do tempo desperdiça dinheiro.
  3. Hot swapping (troca a quente) mantém vários modelos prontos e troca qual deles roda na GPU sem reiniciar o serviço.
  4. A técnica rende mais com modelos pequenos que cabem numa GPU só, como os de reconhecimento de entidades, embeddings ou geração curta.
  5. No Superlinked SIE, um gateway (porta de entrada) manda cada pedido ao grupo de workers certo. Cada worker junta pedidos em lotes (batching) antes de rodar o modelo.
PEDIDO CHEGAA tarefa indica qual modelo usar
GATEWAYEnvia ao grupo de workers certo
TROCA NA GPUCarrega o modelo pedido sem reiniciar
GPU COMPARTILHADAVários modelos usam a mesma placa

Ajuda saber antes: GPU, Inferência, Batching, LoRA

leitura crítica

O talk também promove o produto da empresa do palestrante, o Superlinked SIE, e oferece créditos de cluster. A demo usa dados sintéticos e um cluster gerenciado pela própria Superlinked. Os números de embedding (99,8% e 10 vezes mais barato) vêm de testes internos, sem metodologia detalhada. A pergunta final expõe o ponto fraco. Se o agente consegue ler o arquivo bruto antes de chamar a ferramenta, a privacidade depende de instrução, não de barreira técnica. O palestrante diz que seus testes não vazaram dados, mas admite que falta testar mais e reforçar com guardrails.

O que fazer com isso

  • Antes de mandar documentos sensíveis a um agente, verifique se ele tem acesso direto à pasta com os originais. Se tiver, a redação por ferramenta não garante nada.
  • Teste o pré-processamento com OCR em um PDF escaneado seu e compare o tamanho do contexto antes e depois, para estimar a economia de tokens.
  • Ao escolher um modelo para resumo, confira se o modo de raciocínio (thinking tokens) está ligado. O palestrante teve resumos vazios porque o modelo gastou tudo pensando.
  • Rode uma amostra de documentos reais anonimizados pela ferramenta de redação e confira à mão se algum dado pessoal passou.

Stop Renting Intelligence: The Train-to-Deploy Loop for Specialized AI

Modelo aberto chega perto do fechado quando você o treina em loop com seus dados e serve na mesma plataforma que treinou.

Infraestrutura 19:17 nível ●●●○○ Fireworks AI Assistir no YouTube (abre em nova aba)

Em 3 frases

A palestrante da Fireworks AI argumenta que modelos abertos como o GLM 5.2 já servem para produção e que o treino com dados próprios fecha a diferença de qualidade para os modelos fechados.

Ela apresenta três formas de treinar (agente de treino, treino gerenciado e API de treino) e um ciclo contínuo de treinar, publicar, monitorar e treinar de novo, com troca de pesos sem downtime.

Os resultados de clientes (Cursor, Vercel, Genspark) vêm da própria empresa, e a tese de que treino e serviço devem ficar na mesma plataforma também é argumento de venda.

Antes de ler

Mais 2 termos

Três verdades sobre modelos abertos

Ela afirma que modelos abertos já são prontos para produção (cita o GLM 5.2 em código), que a diferença de qualidade se fecha com customização e que a pilha de IA virou um ciclo contínuo de treinar e servir, em vez de servir uma vez.

A tese do talk resumida em três afirmações.01:27

Casos de clientes: Cursor, Vercel e Genspark

O Composer 2 do Cursor foi treinado e hospedado na plataforma, com inferência 13 vezes mais rápida. A Vercel teve latência 40 vezes menor. A Genspark ganhou 12% de qualidade com reinforcement fine-tuning (RFT, ajuste fino por reforço). Os números são da empresa, sem metodologia.

Resultados que a Fireworks atribui a cada cliente.03:50

Motor próprio de inferência e draft model

A Fireworks otimiza o FireAttention, seu motor de inferência, e os CUDA kernels (código que roda na GPU) para a carga de cada cliente: tokens de entrada e saída, taxa de acerto do cache e meta de latência. O cliente também pode treinar um draft model para acelerar o modelo principal.

Onde o motor de inferência se encaixa entre modelo e GPU.05:26
Mais 2 ideias deste talk

Três formas de treinar

O agente de treino atende gerentes de produto e iniciantes: limpa dados, escolhe modelo e hiperparâmetros. O treino gerenciado pede modelo, dados e hiperparâmetros e um clique. A API de treino deixa engenheiros de ML definir o próprio loop e a função de perda. Funciona para SFT, RFT e DPO.

Os três níveis de controle do treino na plataforma.07:30

O flywheel: hot loading e fidelidade numérica

Depois do treino, um clique publica o modelo. A plataforma monitora tokens, cache e speculator, e permite retreinar a partir do checkpoint. O hot loading troca os pesos sem downtime. Treinar e servir no mesmo lugar evita diferenças numéricas que pioram a qualidade.

O ciclo contínuo que a plataforma promete automatizar.11:41
analogia

Reinforcement fine-tuning (RFT) (ajuste fino por reforço). RFT é como treinar um time de basquete com um placar: o técnico não mostra cada jogada certa, só diz quantos pontos cada tentativa valeu, e o time repete o que pontua mais.

  1. Um modelo de IA já vem treinado para tarefas gerais. Você pode continuar o treino dele com a sua tarefa para ele ficar melhor nela.
  2. No ajuste fino comum, você mostra pares de pergunta e resposta certa e o modelo copia o padrão. No RFT, você não precisa escrever a resposta certa.
  3. O modelo gera várias respostas para cada pergunta. Uma função avaliadora (evaluator function, a regra que dá nota) pontua cada resposta.
  4. O treino ajusta os pesos do modelo para que respostas com nota alta fiquem mais prováveis e as de nota baixa, menos prováveis.
  5. A qualidade depende da função avaliadora e de dados limpos. No talk, a Genspark limpou os dados, definiu avaliadores e relatou 12% de ganho de qualidade.
PERGUNTAS DA TAREFAExemplos reais do seu uso
MODELO RESPONDEGera várias tentativas por pergunta
AVALIADOR DÁ NOTARegra pontua cada tentativa
AJUSTE DOS PESOSReforça as respostas de nota alta
MODELO MELHORAcerta mais na sua tarefa

Ajuda saber antes: Fine-tuning, Pesos do modelo, Função de avaliação, Aprendizado por reforço

leitura crítica

É um pitch de produto da Fireworks. Os ganhos de Cursor (13x), Vercel (40x) e Genspark (12%) vêm da própria empresa, sem baseline, metodologia ou amostra. O 13x e o 40x misturam otimização de inferência com troca de modelo. O argumento de que treino e serviço precisam estar na mesma plataforma beneficia quem vende as duas coisas. Faltam custos comparados com modelos fechados, apesar de o custo abrir o talk.

O que fazer com isso

  • Se o custo de um modelo fechado pesa, separe uma tarefa repetitiva e meça um modelo aberto nela com seu próprio conjunto de testes antes de decidir.
  • Antes de treinar, monte um conjunto de avaliação separado dos dados de treino, como o agente do demo pede, para medir se o ajuste fino melhorou algo.
  • Ao comparar fornecedores, peça a carga de teste (tokens de entrada e saída, cache, latência) por trás de qualquer número de aceleração.
  • Se treinar e servir em lugares diferentes, compare as saídas do modelo nos dois ambientes para detectar diferenças numéricas.

Same Model, Different Speed: Why Your Inference Provider Matters

O mesmo modelo aberto roda mais rápido ou mais devagar conforme o provedor, porque cache, roteamento e decodificação especulativa mudam a experiência.

Infraestrutura 13:04 nível ●●●○○ FriendliAI Assistir no YouTube (abre em nova aba)

Em 3 frases

Yunmo Koo, engenheiro da FriendliAI, diz que modelos de pesos abertos como o GLM 5.2 já competem com os fechados em código e custam bem menos.

Ele mostra que o mesmo modelo e o mesmo agente de código levam tempos diferentes em provedores diferentes, e atribui a diferença a prefix caching, cache em camadas e speculative decoding híbrido.

A recomendação final é testar a sua própria carga de trabalho, medindo velocidade, confiabilidade, custo e qualidade, em vez de confiar em benchmarks do provedor.

Antes de ler

Mais 2 termos

Modelos abertos já competem com os fechados

O palestrante mostra um ranking de código em que o GLM 5.2 aparece acima do Opus 4.8 e logo abaixo de outro modelo fechado. Ele conclui que a pergunta deixou de ser se o modelo aberto é bom o bastante e passou a ser como rodá-lo rápido e com confiabilidade em produção.

Ranking que coloca o GLM 5.2 acima do Opus 4.8 em código01:20

Mesmo modelo, provedores diferentes, tempos diferentes

Com o GLM 5.2 e o mesmo agente de código, o palestrante pede um jogo estilo Candy Crush. Na FriendliAI o jogo sai em cerca de dois minutos. O outro provedor leva mais de três. Ele diz que a diferença vem da pilha inteira de inferência, e não do modelo.

Mesma tarefa e mesmo modelo, com tempos diferentes por provedor03:55

Reaproveitar o prefixo evita recalcular a entrada

Em agentes, a entrada passa de 10 mil tokens e boa parte se repete entre requisições. Reaproveitar o KV cache do prefixo comum pula o prefill e reduz o TTFT. Para funcionar em escala, o roteador precisa mandar a requisição à réplica que já guarda aquele prefixo.

Prefixo repetido é reaproveitado em vez de recalculado05:51
Mais 2 ideias deste talk

O cache vira uma hierarquia de memória

O KV cache pode ficar maior que os pesos do modelo, e a memória da GPU é pequena. A solução descrita usa três camadas. O cache quente fica na GPU, o morno na RAM da CPU e o frio em NVMe ou disco. O sistema move blocos pouco usados e os traz de volta quando precisa.

Cache em três camadas, da mais rápida à mais barata07:00

Speculative decoding híbrido e adaptativo

Um modelo rascunho propõe vários tokens e o modelo principal valida todos de uma vez. Isso reduz o tempo por token sem mudar a saída. A versão baseada em modelo aceita mais tokens, mas gasta computação extra. A versão sem modelo é barata, mas só funciona bem quando a saída lembra o contexto. A empresa alterna entre as duas conforme o tráfego.

Duas formas de rascunhar tokens, cada uma com custo diferente08:30
analogia

Hierarquia de cache (cache em camadas GPU, CPU e NVMe). A hierarquia de cache é como a cozinha de um restaurante, onde o que o cozinheiro usa toda hora fica na bancada, o que usa às vezes fica na geladeira e o resto fica no estoque dos fundos.

  1. Quando um modelo lê um texto, ele guarda anotações sobre esse texto para não precisar ler tudo de novo. Essas anotações ocupam espaço na memória.
  2. Em textos longos, essas anotações (o KV cache, cache de chave e valor) podem ficar maiores que o próprio modelo. A memória da placa de vídeo (GPU) é a mais rápida, mas é pequena.
  3. A solução organiza o cache em três camadas. O cache quente, usado agora, fica na memória da GPU. O morno fica na RAM do processador (CPU). O frio vai para o NVMe, um disco rápido, ou para o disco comum.
  4. O sistema observa o uso de cada bloco de cache. Ele tira da GPU os blocos pouco usados e traz de volta os que uma nova requisição vai precisar, antes da hora de usar.
  5. Com mais prefixos guardados em algum lugar, o servidor recalcula menos a entrada. Isso reduz o tempo até o primeiro token (TTFT, time to first token) em agentes com contexto longo.
GPU: CACHE QUENTEMais rápida, pouco espaço
CPU RAM: CACHE MORNOMais espaço, um pouco mais lenta
NVME/DISCO: CACHE FRIOBarato e grande, mais lento
MOVIMENTO DINÂMICODesce o pouco usado, sobe o necessário
MENOS RECÁLCULOPrefill menor e TTFT mais baixo

Ajuda saber antes: KV cache, Prefill e decode, Time to first token (TTFT), Cache-aware routing

leitura crítica

O talk é um pitch da FriendliAI, que vende o serviço descrito e convida a plateia a visitar o estande. A comparação do jogo usa uma única tarefa e um único concorrente sem nome, sem repetições nem variância. O 7x do cliente Kilo Code vem de um depoimento, sem metodologia exposta, e a palavra é up to na descrição. Os 99,9% de uptime vêm de um snapshot de agregador, sem janela de tempo informada. A comparação de custo com o Opus 4.8 usa um só prompt. A conclusão de testar a própria carga é a parte mais sólida.

O que fazer com isso

  • Antes de escolher um provedor para um modelo aberto, rode o seu próprio prompt, com o seu tamanho de entrada, em pelo menos dois provedores e compare tempo, taxa de erro e custo.
  • Em agentes, deixe a parte fixa do prompt (instruções e ferramentas) no começo e o conteúdo variável no fim, para aumentar o reaproveitamento de cache do provedor.
  • Meça a taxa de erros 5xx, timeouts e rate limits do provedor, porque uma chamada falha pode derrubar a execução inteira de um agente.
  • Teste o seu fluxo com um modelo aberto e compare o custo por tarefa com o do modelo fechado que você usa hoje.

How Inference Keeps Up with Our Insatiable Need for Tokens

Gerar token é limitado pela memória, então toda otimização de inferência tenta ler menos, reaproveitar mais e casar cada tarefa com o hardware certo.

Infraestrutura 22:46 nível ●●●●○ Cerebras & Gimlet Labs Assistir no YouTube (abre em nova aba)

Em 3 frases

O talk percorre as técnicas que baratearam a inferência, do runtime (batching contínuo, KV cache paginado, prompt caching, chunked prefill) ao sistema (separar prefill e decode, speculative decoding, separar attention e FFN).

A ideia que liga tudo é que o decode espera a memória, enquanto o prefill gasta computação. Por isso cada fase e cada camada rodam melhor em hardware diferente.

Os palestrantes vendem seus produtos (chips da Cerebras e a nuvem multi-chip da Gimlet), e fecham dizendo que agentes já ajudam a escrever kernels otimizados.

Antes de ler

Mais 2 termos

O decode espera a memória, não a conta

Para gerar cada token, o modelo lê todos os pesos da memória. Segundo Daniel, até 90% do tempo o processador fica parado esperando esses dados. Dividir o modelo entre GPUs ajuda, mas exige um all-reduce (soma dos resultados parciais) a cada camada, e 4x mais GPUs rendem só cerca de 2x de velocidade.

Mais GPUs aceleram o token, mas o custo de comunicação cresce mais rápido.03:08

Fronteira de Pareto entre velocidade e vazão

Quem serve inferência escolhe entre rapidez por usuário e total de tokens por segundo. O exemplo dado é o fast mode do Claude Code, que gasta cerca de 6x mais recursos por token para ir ao dobro da velocidade. As otimizações do talk servem para empurrar essa curva para a direita.

Ganhar velocidade custa vazão, e cada técnica tenta deslocar a curva.03:39

KV cache cresce rápido e o paging o domestica

O KV cache guarda os vetores K e V de cada token já processado. Com contexto de 128k, uma única requisição ocupa 42 GB. O KV cache paginado, inspirado em memória virtual de sistema operacional, evita reservar blocos que ficam vazios e, segundo Daniel, atende 3x mais requisições.

Reserva fixa desperdiça memória, e blocos paginados ocupam só o necessário.06:11
Mais 2 ideias deste talk

Separar prefill e decode em pools diferentes

O prefill (ler o prompt) é limitado por computação, e o decode (gerar a resposta) é limitado por memória. Resumir um documento pesa no prefill, e escrever um livro pesa no decode. Com dois pools de máquinas, cada um escala sozinho e um não trava o outro.

Cada fase ganha seu próprio pool, escalado conforme o tipo de carga.11:19

Speculative decoding com modelo rascunho

Um modelo pequeno propõe vários tokens e o modelo grande só verifica. No exemplo de Michelle, nove tokens exigem três passadas do modelo grande em vez de nove. Rodar o rascunho em chips rápidos para modelos pequenos levaria, segundo a Gimlet, a 10x mais interatividade que GPUs homogêneas.

A curva desloca para a direita com rascunho e com chips diferentes por tarefa.16:00
analogia

Continuous batching (batching contínuo). O batching contínuo é como uma van escolar que, a cada parada onde um aluno desce, já embarca outro que estava esperando, em vez de rodar com bancos vazios até o fim da rota.

  1. Para gerar cada palavra, o modelo precisa carregar todos os seus pesos da memória, e isso demora mais que a conta em si.
  2. O batching (processamento em lote) aproveita essa mesma leitura dos pesos para atender vários usuários de uma vez.
  3. O problema é que algumas respostas são mais longas que outras. Quando uma termina cedo, a vaga dela fica ociosa até o lote inteiro acabar.
  4. O batching contínuo (continuous batching) preenche cada vaga liberada com um novo pedido na hora, sem esperar o lote terminar.
  5. O custo é a memória. Cada pedido a mais no lote soma seu próprio KV cache, e isso motivou técnicas como o KV cache paginado.
LEITURA DOS PESOSUm custo pago a cada token
LOTE DE PEDIDOSVários usuários na mesma leitura
VAGA LIBERADAUma resposta curta termina antes
NOVO PEDIDO ENTRAMais tokens por leitura de pesos

Ajuda saber antes: Token, Pesos do modelo, Banda de memória

analogia

Paged KV cache (KV cache paginado). O KV cache paginado é como um restaurante que acomoda cada cliente na primeira mesa livre, em vez de reservar uma mesa de dez lugares para quem talvez traga dois amigos.

  1. Enquanto conversa com você, o modelo guarda anotações sobre cada palavra já lida para não precisar reler tudo de novo.
  2. Essas anotações formam o KV cache (cache de chaves e valores) e crescem rápido. Com contexto de 128 mil tokens, uma só conversa ocupa cerca de 42 GB.
  3. No método antigo, o sistema reservava de antemão um bloco grande e contínuo de memória para cada pedido. Boa parte desse bloco ficava vazia, mas ninguém mais podia usar.
  4. O KV cache paginado (paged KV cache) copia a ideia de memória virtual do sistema operacional. Ele divide a memória em páginas pequenas e grava cada pedaço do cache em qualquer página livre.
  5. Uma tabela registra onde está cada página. Assim quase nada fica reservado sem uso, e o mesmo hardware atende cerca de 3x mais pedidos, segundo o palestrante.
NOVO PEDIDOPrecisa guardar cache de cada token
PÁGINAS PEQUENASMemória dividida em blocos iguais
OCUPA ONDE HÁ ESPAÇOTabela aponta onde está cada bloco
3X MAIS PEDIDOSQuase nenhuma memória fica parada

Ajuda saber antes: KV cache, Token, Memória virtual, Continuous batching

analogia

Disaggregation (desagregação: separar etapas em máquinas diferentes). A desagregação é como uma cozinha de restaurante que separa a equipe de preparo da equipe de finalização, e contrata mais gente só no setor que está apertado naquele dia.

  1. Quando você manda uma pergunta para uma IA, o trabalho acontece em duas fases. Primeiro ela lê o seu texto, depois escreve a resposta palavra por palavra.
  2. A leitura se chama prefill (pré-preenchimento) e gasta muita conta. A escrita se chama decode (decodificação) e passa a maior parte do tempo esperando dados da memória.
  3. Cada tarefa pesa numa fase diferente. Resumir um documento longo pesa no prefill, e escrever um livro a partir de poucos temas pesa no decode.
  4. A desagregação (disaggregation) põe cada fase num grupo próprio de máquinas, chamado pool. Um pool faz só prefill e outro faz só decode.
  5. Cada pool cresce ou encolhe conforme a carga, e uma fase não trava a outra. O passo seguinte é usar hardware diferente em cada pool, com mais computação num e mais banda de memória no outro.
PEDIDO CHEGAPrompt mais resposta a gerar
POOL DE PREFILLLê o prompt, limitado por conta
POOL DE DECODEGera tokens, limitado por memória
ESCALA INDEPENDENTECada pool cresce conforme a carga

Ajuda saber antes: Prefill e decode, KV cache, Banda de memória

leitura crítica

Os dois palestrantes vendem o que descrevem. Cerebras compara a própria banda de memória com a de uma H100 e cita 3.000 contra 600 tokens por segundo, sem dizer modelo, tamanho de lote ou fonte. Os ganhos da Gimlet (3 a 10x, 10x de interatividade, 33% no GPT-OSS-120B em AMD) aparecem em slides sem metodologia, e a parceria com a AWS é descrita como plano. A afirmação de que até 90% do tempo é espera de memória vale para o decode com lote pequeno, não para toda carga.

O que fazer com isso

  • Estruture prompts de agentes com a parte fixa (instruções, ferramentas) no começo, para o provedor reaproveitar o prompt caching e cobrar menos.
  • Ao estimar custo de contexto longo, lembre que cada requisição ocupa memória de KV cache proporcional ao tamanho. A regra citada é 1 GB a cada 3.000 tokens num modelo de 70B.
  • Ao escolher provedor de inferência, peça métricas de velocidade por usuário e de vazão juntas, já que melhorar uma costuma piorar a outra.
  • Se sua equipe escreve kernels ou otimiza modelos, teste um agente de geração de kernels sobre código já otimizado, como o KForge fez, e meça o ganho de ponta a ponta.

Agents That Own Their Inference

Rodar o próprio modelo só compensa se você medir cada ajuste com a sua carga real. Até a otimização famosa pode piorar tudo.

Infraestrutura 1:50:10 nível ●●●●○ Du'an Lightfoot & Khaja Omer, Akamai Technologies Assistir no YouTube (abre em nova aba)

Em 3 frases

O workshop mostra como servir um modelo Qwen de 4 bilhões de parâmetros em GPU dedicada com vLLM, medindo velocidade por requisição, vazão total e uso de memória do KV cache.

Trocar o modelo de BF16 para FP8 elevou a velocidade de 37,5 para 53,4 tokens por segundo, mas o speculative decoding derrubou de 58 para 16, porque o modelo rascunho era incompatível.

O método final é repetir um ciclo: medir a linha de base, mudar um parâmetro de servidor, refazer o teste de carga e checar a qualidade, o que levou a vazão de 800 para 1.100 tokens por segundo com 64 requisições simultâneas.

Antes de ler

Mais 2 termos

Alugar API ou ter GPU própria depende do uso

Uso alto e constante, dados privados e capacidade disponível favorecem GPU dedicada. Tráfego baixo e irregular, modelos mais capazes e time sem experiência em hospedagem favorecem API paga por token. Os palestrantes mostram uma conta de custo mensal para 200 mil tokens por dia, mas o valor da GPU sai truncado na legenda automática.

Critérios que separam GPU própria de API hospedada03:51

Memória da GPU define quantos usuários cabem

Os pesos de um modelo de 4 bilhões de parâmetros em BF16 ocupam 8 GB. O que sobra na GPU vira KV cache, o espaço onde ficam prompt, ferramentas e resposta de cada usuário. O notebook calcula cerca de 37 mil tokens de contexto no total, o que dá quatro usuários com 8 mil tokens cada.

Pesos de 8 GB deixam cerca de 37 mil tokens para o KV cache35:24

FP8 acelera, mas exige eval próprio

Com o modelo FP8 da Red Hat, a velocidade com uma requisição subiu de 37,5 para 53,4 tokens por segundo. O pico de vazão foi 1,4 vez maior. O tempo até o primeiro token também cresceu sob carga alta. Omar insiste em criar evals (avaliações) próprios, por exemplo para ver se o JSON das chamadas de função continua válido.

Comparação antes e depois da quantização FP81:04:05
Mais 2 ideias deste talk

Speculative decoding que piora a velocidade

Um modelo pequeno (0,6B) rascunha 4 tokens e o modelo de 4B verifica. Aqui a taxa de aceitação foi baixa porque o rascunho não foi treinado para esse modelo, e a velocidade caiu de 58 para 16 tokens por segundo. A lição é testar a compatibilidade e o número de tokens especulativos antes de ativar.

Queda de 58 para 16 tokens por segundo com o rascunho incompatível1:15:38

Achar o ponto em que a vazão estabiliza

Acima de 32 requisições simultâneas a vazão parou de crescer e a latência disparou. Subir o limite de sequências de 32 para 128 mudou isso: com 64 simultâneas, a vazão foi a 1.100 tokens por segundo e a latência caiu para cerca de 800 ms. O modelo da comparação final é o BF16, porque o notebook falhou e foi refeito.

1:47:32 Com 64 requisições, vazão sobe e latência cai após o ajuste

leitura crítica

O talk é de uma empresa de nuvem que vende GPU, e o ambiente do workshop usa a infraestrutura dela, então a comparação entre alugar e ter GPU favorece o lado de quem vende. A conta de custo (200 mil tokens por dia) aparece sem detalhes legíveis. Os testes usam um só modelo de 4B, uma GPU e prompts curtos (256 tokens de entrada, 128 de saída). O eval de qualidade do FP8 é simples e os próprios palestrantes avisam que ele não basta. A comparação final mistura FP8 e BF16 por causa da falha do notebook.

O que fazer com isso

  • Antes de mudar qualquer configuração de servidor, rode um teste de carga com o seu tamanho real de prompt e guarde os números como linha de base.
  • Ao testar uma versão quantizada, monte um conjunto pequeno de casos seus, como validade de JSON em chamadas de função, e compare com o modelo original.
  • Mude um parâmetro por vez (memória da GPU, limite de sequências, tamanho do lote) e refaça o teste, anotando vazão e latência.
  • Compare o custo mensal de API com o de uma GPU dedicada usando seu volume diário de tokens, e só considere ter a GPU se o uso for alto e constante.

Taming the AI Hardware Cambrian Explosion

Com chips novos toda hora, a Modular aposta numa pilha única (Mojo, MAX, Cloud) para rodar inferência rápida em qualquer hardware.

Infraestrutura 17:08 nível ●●●●○ Abdul Dakkak, Modular Assistir no YouTube (abre em nova aba)

Em 3 frases

A falta de computação e a chegada de muitos chips novos deixaram o software de inferência fragmentado, com vLLM, SGLang, TensorRT-LLM e llama.cpp cada um remendando um hardware.

A Modular propõe reconstruir tudo do zero: a linguagem Mojo (parecida com Python), o motor de inferência MAX e a Modular Cloud para distribuir o serviço.

O palestrante apresenta benchmarks de velocidade contra vLLM e torch.compile em Kimi K2.5, FLUX.2, AMD MI355 e Gemma 4, e convida o público a validar os resultados com pip install modular.

Antes de ler

Mais 2 termos

Cada chip novo complica a pilha

O vLLM já precisa de caminhos separados para Nvidia e AMD. Cada hardware adicional deixa o diagrama mais confuso. Na prática, as equipes misturam vLLM, SGLang, TensorRT-LLM e llama.cpp, e cada ferramenta resolve só uma parte do problema.

Cada hardware extra torna a pilha de software mais difícil de manter.01:06

Quatro camadas, uma pilha

A Modular divide a solução em camadas. Mojo é a linguagem para CPUs, GPUs e aceleradores. MAX é o motor de inferência feito sobre Mojo. Os kernels (código que roda direto na GPU) ficam por baixo. A Modular Cloud cuida de escolher hardware, rotear requisições e distribuir o modelo.

A arquitetura proposta, do código de baixo nível até a nuvem.02:42

Mojo no quadrante ideal

O palestrante compara linguagens em três eixos: usabilidade, desempenho e portabilidade. CUDA dá desempenho, mas custa usabilidade. OpenCL dá portabilidade, mas perde velocidade. Triton fica no meio, com cerca de 70% do desempenho. Mojo diz querer reunir os três.

Posicionamento de Mojo contra CUDA, OpenCL e Triton, feito pela própria Modular.04:48
Mais 2 ideias deste talk

MAX atende vários tipos de modelo

MAX foi pensado para a inferência de IA generativa atual, sem herdar as limitações do PyTorch. Ele serve texto, imagem, vídeo e voz no mesmo framework, expõe endpoints compatíveis com a API da OpenAI e permite separar prefill e decode em hardwares diferentes.

Definir modelos em Python e servir por endpoint compatível com OpenAI.07:57

Benchmarks de velocidade

A Modular mostra ganhos sobre vLLM e torch.compile: 5,5x no tempo até o primeiro token com Kimi K2.5 e 7x com FLUX.2. Na AMD MI355 o ganho é de 4x, e ele lembra que a AMD custa cerca de 30% menos. Ele cita a Artificial Analysis como verificadora independente.

Comparação de velocidade apresentada pela própria Modular.11:37
analogia

Mojo (linguagem de programação parecida com Python para CPU e GPU). Mojo é como um único livro de receitas escrito em linguagem simples que funciona igual no fogão a gás, no elétrico e no forno industrial.

  1. Mojo é uma linguagem de programação, ou seja, um jeito de escrever instruções para o computador.
  2. Ela tem a cara do Python, a linguagem mais usada em IA. Segundo a Modular, quem sabe Python já conhece cerca de 90% do Mojo.
  3. A diferença está no alcance. O mesmo código roda em CPU (processador comum), em GPU (placa gráfica) e em outros aceleradores, de fabricantes diferentes.
  4. Ela também dá acesso de baixo nível ao chip. Isso permite escrever kernels (funções que rodam direto na GPU) tão rápidos quanto os feitos em CUDA, segundo a empresa.
  5. A Modular usa Mojo como base de toda a pilha. O motor de inferência MAX e os kernels dele são escritos em Mojo.
CÓDIGO EM MOJOsintaxe parecida com Python
COMPILAÇÃOtraduz para o chip escolhido
CPU, GPU OU ACELERADORNvidia, AMD e outros
MESMO CÓDIGO, RÁPIDOportável e com bom desempenho

Ajuda saber antes: Python, CPU e GPU, Compilador, GPU kernel

analogia

CUDA (plataforma da Nvidia para programar GPUs). CUDA é como o manual exclusivo de uma marca de máquina de lavar, que ensina a usar todos os recursos dela mas não serve para máquinas de outras marcas.

  1. Uma GPU (placa gráfica) faz milhares de contas pequenas ao mesmo tempo. Por isso ela acelera tanto a IA.
  2. Para dar ordens a uma GPU, o programador precisa de uma ferramenta própria. CUDA é a ferramenta da Nvidia para isso.
  3. Com CUDA, o programador escreve kernels (funções que rodam direto na GPU) em uma variação de C++ e controla memória e paralelismo de perto.
  4. O resultado é desempenho máximo em chips Nvidia. O custo é um código difícil de escrever e preso a um único fabricante.
  5. No talk, CUDA aparece como referência de velocidade. A Modular diz que Mojo compete com CUDA no desempenho e ainda roda em outros hardwares, como AMD.
CÓDIGO CUDAkernel escrito em C++ da Nvidia
COMPILADOR NVIDIAgera instruções para a GPU
MILHARES DE NÚCLEOSexecutam contas em paralelo
RESULTADO RÁPIDOsó em GPUs da Nvidia

Ajuda saber antes: CPU e GPU, Processamento paralelo, GPU kernel

leitura crítica

O talk é pitch de produto da Modular, feito pelo cientista-chefe da empresa. Os benchmarks aparecem em slides, sem detalhar hardware, tamanho de lote ou configuração do vLLM usado como base. Ele diz que a Artificial Analysis verificou os resultados, mas só mostra isso para o FLUX.2. A comparação entre 7x (Nvidia) e 4x (AMD) é reconhecida por ele mesmo como difícil. Mojo 1.0 e o código aberto do Mojo ainda são promessa para os próximos meses.

O que fazer com isso

  • Se você roda modelos em GPU própria ou alugada, meça TTFT e throughput da sua configuração atual antes de comparar com qualquer alternativa.
  • Teste o pip install modular em uma máquina de laboratório com um modelo que você já usa e compare com o vLLM na sua carga real.
  • Ao ver benchmark de fornecedor, pergunte qual hardware, qual versão do concorrente e quem verificou o resultado.
  • Se sua equipe depende só de Nvidia, avalie quanto custaria trocar de hardware e se uma camada portável reduziria esse risco.

How MiniMax M3 Was Built: Sparse Attention and Native Multimodality

A MiniMax ajustou a atenção esparsa ao hardware real e treinou texto e imagem juntos desde o passo zero para ter contexto longo sem perder qualidade.

Modelos 15:03 nível ●●●●● Olive Song Assistir no YouTube (abre em nova aba)

Em 3 frases

O MiniMax M3 é um modelo open weights (pesos abertos) com 1 milhão de tokens de contexto, foco em código e agentes, e visão treinada junto com o texto desde o início.

A MSA, a atenção esparsa da MiniMax, usa um ramo indexador leve para escolher blocos de tokens e um ramo esparso que olha só para esses blocos, com desenho pensado para GQA e para a memória da GPU.

Nos testes da equipe, adicionar visão depois do pré-treino prejudicou o texto ou ficou instável, e o treino multimodal desde o passo zero integrou melhor as duas modalidades.

Antes de ler

Mais 2 termos

Dois ramos decidem onde o modelo presta atenção

A sparse attention (atenção esparsa) da MiniMax tem um ramo indexador, que faz uma atenção completa barata com quatro cabeças de query e uma de key. Ele aprende a imitar as notas de atenção do ramo principal. O ramo esparso então calcula a atenção só nos blocos que o indexador escolheu. Assim o modelo evita comparar cada token com todos os outros em contextos de 1 milhão de tokens.

O indexador escolhe os blocos e o ramo esparso só calcula atenção neles02:57

O desenho da DeepSeek não servia para GQA

A DSA, atenção esparsa da DeepSeek, foi feita para MQA, em que existe uma única cabeça de key e value bem larga. Em GQA (grouped-query attention), a mesma largura se divide em várias cabeças. Com a DSA, todas essas cabeças acabavam olhando os mesmos tokens e perdiam diversidade. A GPU também precisava fazer várias leituras separadas na memória, o que custa mais tempo.

Em GQA a GPU faz leituras separadas por cabeça, o que encarece a atenção esparsa05:49

Escolher blocos sai mais barato do que escolher tokens

A MSA deixa cada cabeça de KV selecionar o seu próprio conjunto de tokens. Ela também troca a seleção token a token por seleção de blocos. Com menos candidatos, o cálculo de top-k fica mais leve, e a leitura contígua de memória aproveita melhor a GPU. A palestrante afirma que essa troca não trouxe perda relevante de qualidade, e a equipe escreveu kernels próprios para treino e inferência.

Selecionar blocos reduz candidatos do top-k e melhora o acesso à memória07:46
Mais 2 ideias deste talk

Três jeitos de ensinar visão a um modelo de texto

A equipe testou três estratégias. Adicionar visão depois do pré-treino, no estilo CPT (continued pre-training), degradou o texto. Adicionar visão no meio do pré-treino ficou sensível demais à mistura de dados e à taxa de aprendizado, e o resultado de uma rodada não se repetia na outra. Treinar com texto e imagem desde o passo zero quase não prejudicou o texto com o mesmo orçamento de tokens de texto.

Só o treino multimodal desde o início preservou o desempenho em texto09:58

Mapas de atenção mostram a integração entre texto e imagem

Nos modelos treinados no estilo CPT, os tokens de texto quase ignoram os tokens visuais, e essa região aparece escura no mapa de atenção. No modelo nativo, o mapa não separa texto e imagem. A equipe lê isso como sinal de que o modelo aprendeu a juntar as duas informações. Depois, a palestrante mostra que a atenção 3D dentro do ViT, com quatro quadros por vez, melhora a compreensão de vídeo e também de imagens.

No modelo nativo o texto presta atenção aos tokens visuais11:45
analogia

Sparse attention (atenção esparsa, que calcula a atenção só em parte dos tokens). Sparse attention é como estudar para a prova lendo só os capítulos que o professor marcou como importantes, em vez de reler o livro inteiro.

  1. Para escrever cada palavra, o modelo consulta o que já leu antes. Esse ato de consultar e pesar o texto anterior se chama attention (atenção).
  2. Na atenção completa, cada token (pedaço de palavra) é comparado com todos os outros. Com 1 milhão de tokens, o número de comparações fica enorme e lento.
  3. A sparse attention (atenção esparsa) compara cada token só com uma parte do texto. O desafio é escolher bem essa parte para não perder informação importante.
  4. Na MSA, da MiniMax, um ramo indexador leve faz uma atenção barata e dá notas aos trechos. Ele aprende a imitar as notas do ramo principal durante o treino.
  5. O ramo esparso calcula a atenção de verdade só nos blocos que o indexador escolheu. A MiniMax afirma ganhos de 9 vezes na leitura do prompt e 15 vezes na geração.
CONTEXTO LONGOAté 1 milhão de tokens para consultar
RAMO INDEXADORAtenção barata que dá notas aos trechos
ESCOLHA DE BLOCOSSepara os blocos com nota mais alta
RAMO ESPARSOCalcula atenção só nos blocos escolhidos
MENOS CONTASResposta mais rápida em texto longo

Ajuda saber antes: Token, Mecanismo de atenção, Janela de contexto

analogia

GQA (grouped-query attention) (atenção em que grupos de queries compartilham cabeças de key e value). GQA é como uma escola em que cada grupo de alunos divide o mesmo livro didático, em vez de cada aluno ter o seu próprio exemplar.

  1. Na atenção, cada token faz uma pergunta, chamada query, e procura respostas nos outros tokens, que guardam uma etiqueta (key) e um conteúdo (value).
  2. O modelo tem várias cabeças de atenção trabalhando em paralelo. Se cada cabeça guardar suas próprias keys e values, a memória da GPU enche rápido em textos longos.
  3. Na GQA (grouped-query attention, ou atenção com queries agrupadas), as queries se dividem em grupos e cada grupo compartilha uma cabeça de key e value. Isso economiza memória.
  4. A MQA leva a ideia ao extremo, com uma única cabeça de key e value bem larga. A DeepSeek desenhou sua atenção esparsa para MQA.
  5. Aplicada em GQA, essa atenção fazia todas as cabeças olharem os mesmos tokens e exigia leituras separadas na memória. A MSA deixa cada cabeça escolher seus próprios blocos.
MUITAS QUERIESCada cabeça faz sua própria pergunta
GRUPOSQueries divididas em poucos grupos
KV COMPARTILHADOUma cabeça de key e value por grupo
MENOS MEMÓRIACache menor sem perder diversidade

Ajuda saber antes: Mecanismo de atenção, Query, key e value, Cache KV, Sparse attention

analogia

Continued pre-training (CPT) (pré-treino continuado sobre um modelo já treinado). CPT é como mandar um cozinheiro experiente de comida italiana fazer um curso rápido de comida japonesa depois de anos de carreira.

  1. Primeiro, o modelo passa pelo pré-treino, a fase longa em que lê uma quantidade gigante de texto e aprende a língua e o mundo.
  2. No CPT (continued pre-training, ou pré-treino continuado), a equipe pega esse modelo pronto e continua o treino com um tipo novo de dado, como imagens ou um domínio específico.
  3. O CPT sai barato porque reaproveita o modelo existente. O risco é que, no fim do pré-treino, o modelo já se acomodou, e os dados novos podem atrapalhar o que ele já sabia.
  4. A MiniMax testou adicionar visão no estilo CPT e viu o desempenho em texto cair. Nos mapas de atenção, o texto quase ignorava os tokens de imagem.
  5. Por isso a equipe treinou texto e imagem juntos desde o passo zero. Com o mesmo orçamento de tokens de texto, essa escolha quase não prejudicou o texto.
MODELO JÁ TREINADOPré-treino de texto quase concluído
DADOS NOVOSImagens ou um domínio diferente
TREINO CONTINUAAjusta os pesos com a nova mistura
MODELO ADAPTADOGanha a habilidade, pode perder texto

Ajuda saber antes: Pré-treino, Taxa de aprendizado, Modelo multimodal

analogia

Vision transformer (ViT) (transformer que converte imagens em tokens visuais). Um ViT é como montar um quebra-cabeça ao contrário, em que você corta a foto em peças, descreve cada peça e depois compara as peças entre si para entender a cena.

  1. Um modelo de linguagem só entende tokens. Para ele ler uma imagem, alguém precisa traduzir a imagem em tokens.
  2. O ViT (vision transformer, ou transformer de visão) corta a imagem em pequenos quadrados, chamados patches, e transforma cada um numa lista de números.
  3. Dentro do ViT, os patches trocam informação entre si pela atenção. No fim, ele entrega tokens visuais que o modelo de linguagem consegue ler junto com o texto.
  4. No MiniMax M3, esses tokens visuais entram no lugar de marcadores de imagem dentro do texto, e o modelo processa tudo junto.
  5. Em vídeo, um ViT comum olha cada quadro separado. A MiniMax usou atenção 3D, em que patches de quatro quadros seguidos se enxergam, o que melhorou vídeo e imagem.
IMAGEM OU VÍDEOEntrada visual bruta
PATCHESImagem cortada em pequenos quadrados
ATENÇÃO NO VITPatches comparam entre si, até 4 quadros
TOKENS VISUAISEntram no texto e o modelo lê junto

Ajuda saber antes: Transformer, Token, Mecanismo de atenção, Modelo multimodal

leitura crítica

A palestrante trabalha na MiniMax e apresenta o próprio modelo. Os ganhos de 9 vezes no prefill e 15 vezes no decode não vêm com tamanho de contexto, hardware nem custo do teste. A frase de que o modelo assume 90% do trabalho de código atual não tem nenhum dado no talk. As estratégias de treino aparecem sem números de benchmark, e os mapas de atenção são exemplos visuais escolhidos pela equipe. O relatório técnico citado na descrição é o lugar para checar essas afirmações.

O que fazer com isso

  • Antes de adotar o M3 para bases de código grandes, rode suas próprias tarefas com contexto longo e meça latência e acerto contra o modelo que você já usa.
  • Ao escolher um modelo para ler telas, gráficos ou documentos com imagem, teste com exemplos reais do seu trabalho e veja se ele usa a imagem na resposta.
  • Desconfie de números de velocidade sem condição de teste. Procure no relatório técnico o tamanho de contexto e o hardware usados.
  • Se você usa agentes de computer use, inclua o M3 na comparação, porque a visão nativa é o argumento principal da MiniMax para esse caso.

Fim da edição

Termos novos no glossário: Failure surface, Codon, Token exchange, Security token service (STS), Intent based authorization, Dreaming, SPF, DKIM e DMARC, ID-JAG, Paged KV cache, Disaggregation, Continuous batching, Seccomp, eBPF, Container escape, Reinforcement fine-tuning (RFT), Dilema estabilidade-plasticidade, Mojo, CUDA, Bits per byte (BPB), Hierarquia de cache, Taint analysis, JSONPath, Admission controller, Runtime security, Split key custody, Trusted execution environment (TEE), Agent experiments, Tool poisoning, Slopsquatting, Combinação linear, Resolução de símbolos, pass@k e pass^k, LoRA, Hot swapping de modelos, Tailnet e tsnet, Sparse attention, GQA (grouped-query attention), Continued pre-training (CPT), Vision transformer (ViT), JWT, Memory snapshot.