Pular para o conteúdo
Aprendendo AI

Agentes que mexem com dinheiro precisam de limites e provas

Edição de sábado, 17 out 2026 · 4 vídeos · 5 h 22 min de talks

Quatro talks sobre o que falta para confiar num agente quando há dinheiro ou conta de cliente em jogo. Um painel com Keycard, JPMorgan Chase e o coautor do OAuth explica por que permissões amplas falham e propõe missão, orçamento e um proxy de saída fora do agente. Dois engenheiros do Monzo mostram como um harness com conta em código e dado com origem gera análise financeira confiável. Depois vem um workshop de evals que ensina a ler traces e a testar o próprio juiz, e a edição fecha com a anatomia de um harness com memória aplicado à detecção de lavagem de dinheiro.

An AI Agent Got Its User Banned From Resy

Agente só ganha autonomia quando a autorização olha a intenção e o orçamento da tarefa, e quem fiscaliza fica fora do agente.

Agentes 43:25 nível ●●●○○ Keycard, JPMorgan Chase & AAuth Assistir no YouTube (abre em nova aba)

Em 3 frases

O painel diz que OAuth e suas permissões (scopes) são grossos demais para agentes, que tentam de novo até conseguir e podem abusar de um serviço sem má intenção, como no caso do Resy.

A proposta é autorizar cada chamada de ferramenta em tempo de execução, com base na intenção do usuário e da empresa, numa missão que acompanha todas as ações e num orçamento de recursos em vez de um corte seco.

Os painelistas defendem separar o cérebro (o modelo) das mãos (ferramentas em sandbox), aplicar as regras num proxy de saída fora do agente e guardar um registro de auditoria que o agente não consiga alterar.

Antes de ler

Mais 2 termos

Permissões grossas não servem a agentes

Ian Livingstone cita a Salesforce, que por muito tempo tinha um único scope (permissão) chamado API. Dick Hardt explica que o OAuth nasceu para um site falar com outro, exige pré-registro e redirecionamento por navegador. Agentes decidem o que fazer ao longo da execução, então precisam de permissões bem mais finas.

02:48 Um único scope amplo dá ao agente acesso demais.

A missão dá contexto a cada decisão

Hardt propõe que a pessoa (humano ou organização) entregue ao agente uma missão. Um identificador da missão acompanha todas as ações, e cada autorização é decidida nesse contexto. Isso permite auditar o que aconteceu e evitar, por exemplo, um pagamento duplicado que parece válido isoladamente.

09:33 A missão amarra intenção, política e auditoria.

Orçamento em vez de rate limit

No caso do Resy, um agente fez cerca de 200 chamadas por hora e baniu a conta do usuário. Hardt diz que um rate limit só corta o agente, sem explicar nada. No AAuth, o token expira e também carrega um orçamento de uso. O agente vê quanto já gastou e a supervisão decide se libera mais.

25:34 Orçamento dá feedback ao agente, o rate limit só bloqueia.

Mais 2 ideias deste talk

Cérebro no modelo, mãos na sandbox

Livingstone descreve o desenho que os grandes laboratórios seguem. O modelo (cérebro) não guarda chaves de API. As ferramentas (mãos) rodam numa sandbox e todo tráfego de saída passa por um proxy de saída, onde ficam as regras de autorização. Davis acrescenta que dá para remover ferramentas dinamicamente, por exemplo desligar a busca web enquanto o agente lida com um e-mail sensível.

28:10 A autorização fica no proxy, fora do alcance do agente.

O registro de auditoria fica fora do agente

Livingstone cita o incidente da Hugging Face, em que um agente usou uma falha no proxy Squid e não havia monitoramento do que ele fazia. Para ele, o ponto de aplicação das regras e o log precisam ficar fora do agente. A pergunta final é de responsabilidade: quem contratou o agente responde pelo dano, e o log à prova de adulteração mostra quem mandou fazer o quê.

37:31 Sem registro externo, ninguém prova quem pediu a ação.

analogia

Egress proxy (proxy de saída de rede). Um egress proxy é como a portaria de um escritório, por onde toda correspondência que sai passa, e o porteiro confere o destino, registra o envio e barra o que não foi autorizado.

  1. Quando um programa quer falar com um serviço na internet, ele manda uma mensagem para fora. Egress (saída) é o nome desse tráfego que sai.
  2. Um proxy (intermediário) é um ponto no meio do caminho. Toda mensagem de saída passa por ele antes de chegar ao destino.
  3. No desenho citado no painel, as ferramentas do agente rodam numa sandbox (ambiente isolado) sem chaves de API. A única porta para fora é o egress proxy.
  4. No proxy ficam as regras de autorização. Ele decide se cada chamada pode seguir, coloca a credencial certa no pedido e guarda o registro de tudo.
  5. O proxy fica fora do alcance do agente. Assim o agente pode experimentar à vontade, e uma camada fixa e previsível aplica os limites que ele não consegue mudar.
AGENTE NA SANDBOXFerramentas isoladas, sem chaves
PEDIDO DE SAÍDAToda chamada externa vai ao proxy
EGRESS PROXYConfere regras e registra a chamada
CHAMADA CONTROLADASegue com credencial ou é barrada

Ajuda saber antes: Sandbox, Chave de API, Runtime authorization

leitura crítica

O painel é organizado pela Keycard, que vende autorização para agentes, e Hardt promove o AAuth, de sua autoria. Os dois lados ganham se o problema parecer urgente. Quase não há dados: o caso do Resy aparece como anedota, sem medição de quantos agentes falham assim. Missão e orçamento são descritos como ideias novas, ainda sem adoção relatada. O painel não discute custos nem falhas dessa abordagem.

O que fazer com isso

  • Liste as credenciais e permissões que seus agentes usam hoje e troque as amplas (como um único scope de API) por permissões por ferramenta.
  • Defina um limite de uso por tarefa (chamadas, valor ou tempo) para cada agente que acessa serviços externos, e decida quem aprova mais orçamento.
  • Mantenha chaves de API fora do ambiente do modelo e force o tráfego de saída por um ponto de controle que registre cada chamada.
  • Guarde o log de ações do agente num sistema que ele não consiga editar, com o nome de quem pediu cada tarefa.
Stop Chatting With Spreadsheets

Em finanças, o gargalo do agente é confiança. Cinco princípios de projeto do harness, com a conta feita em código, entregam mais que um chat esperto.

Agentes 1:50:34 nível ●●●○○ Francesco Galletta & Felippe Felisola Caso, Monzo Assistir no YouTube (abre em nova aba)

Em 3 frases

Francesco Galletta e Felippe Felisola Caso, do Monzo, dizem que gerar uma análise financeira com IA já é rápido. O difícil é confiar no resultado quando o assunto é dinheiro.

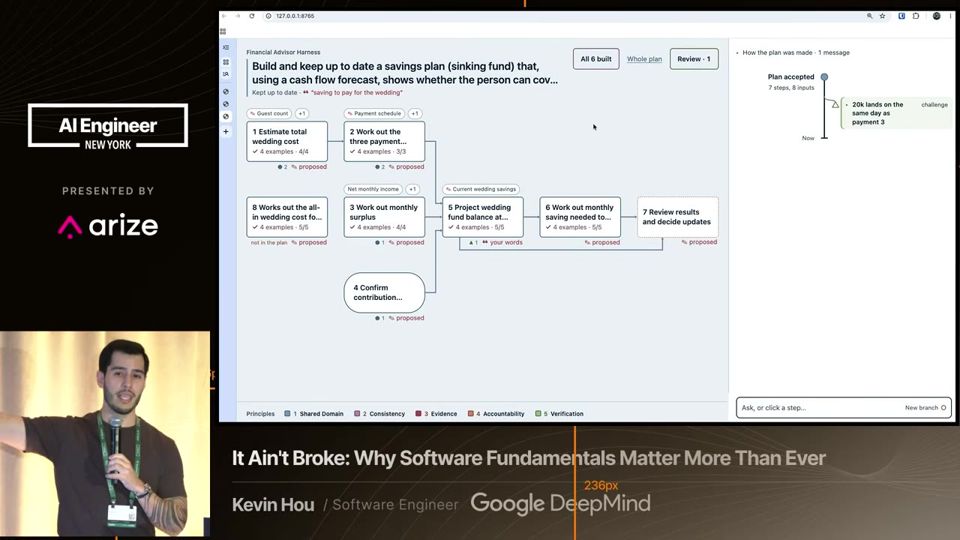
Eles propõem cinco princípios para montar um harness (estrutura que cerca o agente): domínio compartilhado, consistência, evidência, responsabilidade e verificação. O exemplo vivo é o orçamento de um casamento.

A tese técnica central é que toda conta deve rodar em código testado e versionado, fora da cabeça do modelo, porque o modelo dá respostas diferentes para a mesma pergunta.

Antes de ler

Mais 2 termos

Planejar antes de calcular

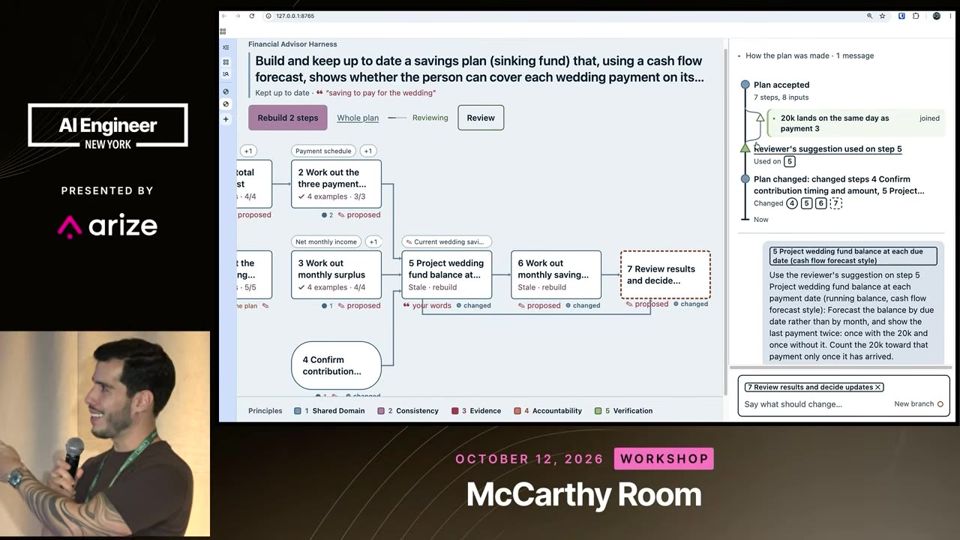
O harness entrevista o usuário até o plano ficar claro, em vez de aceitar tudo e sair implementando. O modelo e a pessoa raramente definem os termos do mesmo jeito, então a conversa de ida e volta cria um vocabulário comum. Só depois o plano vira um conjunto de passos de decisão.

O plano aceito vira uma árvore de decisões.30:49

A conta fica no código

Cálculo é parte determinística do problema. O harness força o agente a escrever a conta uma vez, testá-la e rodá-la sempre que precisar. Sem isso, a mesma pergunta gera respostas diferentes e o código é reinventado a cada sessão. O harness também avisa se a versão do código mudou.

45:33 Cada passo de cálculo tem código e teste próprios, rodados sem o agente improvisar.

Evidência: fato, suposição e interpretação

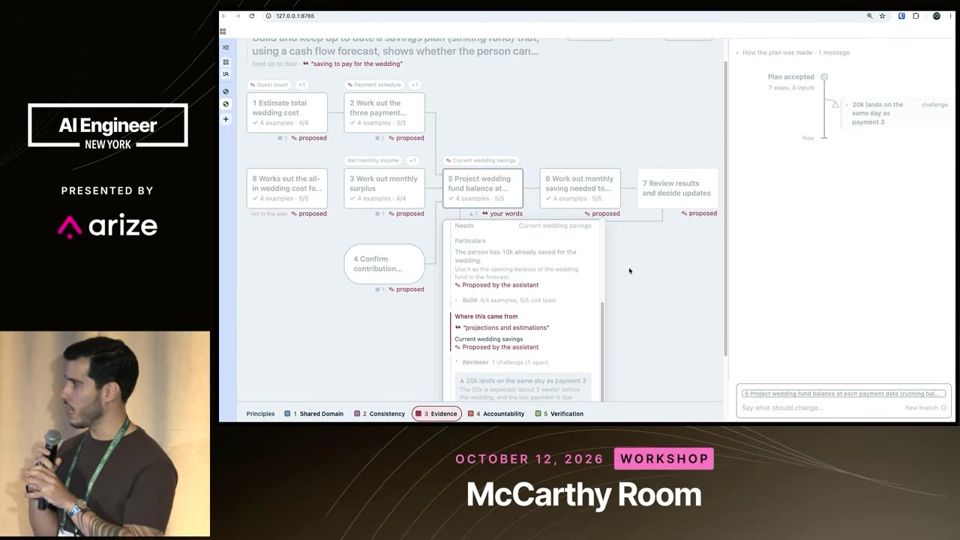
O modelo não distingue fato duro de estimativa. O harness rotula cada dado como fato (extrato bancário), suposição (o que o agente inferiu) ou interpretação (fala solta no chat). Ao clicar num número, a pessoa segue o rastro até a origem. A história do arquivo mestre mostra o risco de mudanças sem rastro.

Cada número mostra se veio do usuário, do agente ou de uma decisão em aberto.1:01:26
Mais 2 ideias deste talk

Responsabilidade com poucos portões de alto sinal

Aprovar cada mudança vira ruído, e não revisar nada tira o controle. Os palestrantes defendem poucos portões nos pontos que importam. A conversa também ramifica e volta ao tronco, então uma frase solta não destrói a análise inteira. O ramo de pergunta lateral não contamina o resto.

A estrutura em ramos permite corrigir um dado sem refazer a análise toda.1:15:30

Verificação com um segundo ponto de vista

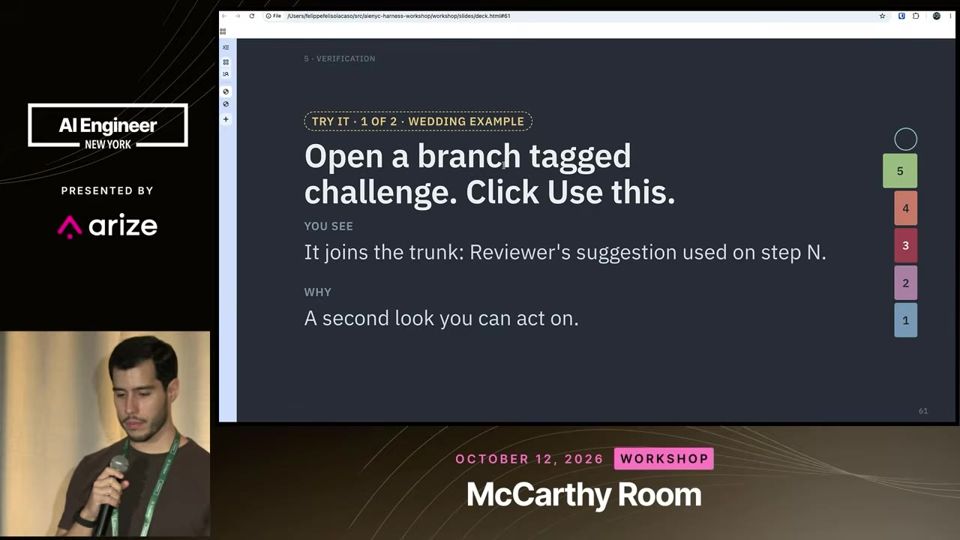
Um agente separado revisa o plano e as suposições, e o resultado volta ao tronco e altera o plano. Segundo os palestrantes, só pôr um LLM como juiz sem laço de retorno não melhora a decisão. Exemplos de ouro também têm viés, então vale conferir contra referências externas ao domínio.

O parecer do revisor externo volta e altera o plano.1:31:08
leitura crítica

O harness é um exemplo didático e os palestrantes admitem que o código foi gerado por vibe coding e que parte é superengenharia. Eles não mostram medição de acerto, taxa de erro nem comparação com um chat comum. A afirmação de que o princípio vale para finanças vem de experiência no Monzo, sem dados públicos, e eles evitam detalhes por propriedade intelectual. Uma pergunta da plateia sobre como provar confiança na interface ficou sem resposta direta.

O que fazer com isso

  • Mova toda conta recorrente do seu trabalho (fechamento mensal, categorização de gastos) para um script testado e peça ao agente apenas para chamá-lo.
  • Peça ao agente que rotule cada dado de uma análise como fato, suposição ou interpretação, com a origem ao lado.
  • Antes de apresentar um número, confira contra uma fonte fora dos seus exemplos, como outra área da empresa ou um dado público.
  • Defina poucos pontos de aprovação humana, nos julgamentos que mudam a decisão, em vez de aprovar cada passo.

How to Know If Your AI Agent Is Any Good: Evals With Phoenix & Claude

Agente sem eval vai para produção na base do 'parece bom'. Leia traces, escolha o eval certo, teste o juiz e trave tudo no CI.

Evals 1:56:13 nível ●●●○○ Laurie Voss, Arize AI Assistir no YouTube (abre em nova aba)

Em 3 frases

Laurie Voss (Arize AI) monta, em workshop de quase duas horas, um ciclo completo de evals (avaliações) sobre um agente analista financeiro feito com Claude Haiku 4.5: rastrear, ler traces, avaliar, validar o juiz, rodar experimentos e travar no CI.

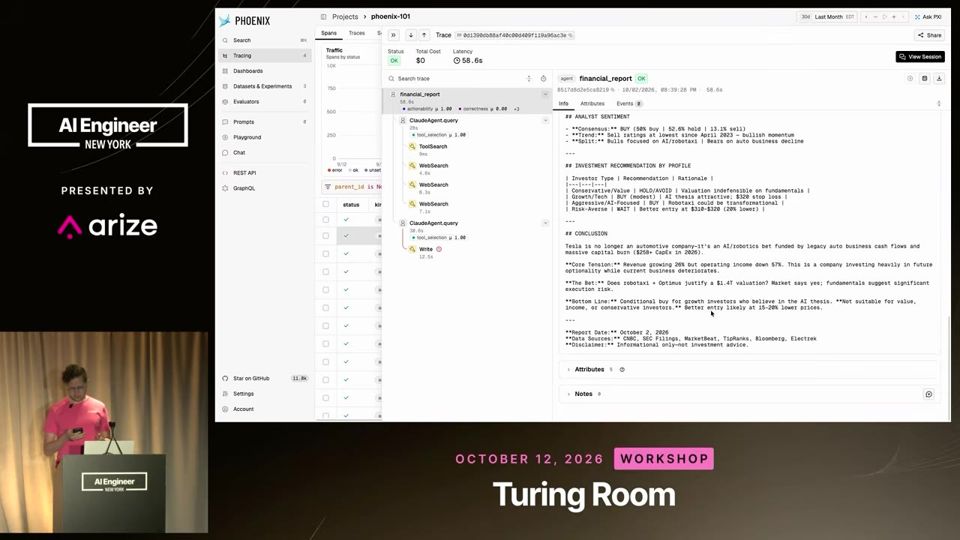
Ele mostra que o eval pronto de correctness reprova todos os relatórios porque o juiz não conhece dados recentes, enquanto faithfulness e um juiz próprio de 'actionability' (relatório que leva a uma ação) geram sinal útil.

O ciclo prova a melhoria de prompt e permite comparar modelos com número: o Haiku 5.5 ficou mais consistente, mas só porque passou a responder 'hold' quase sempre, e custou cerca de quatro vezes mais.

Antes de ler

Mais 2 termos

Leia os traces antes de escrever qualquer eval

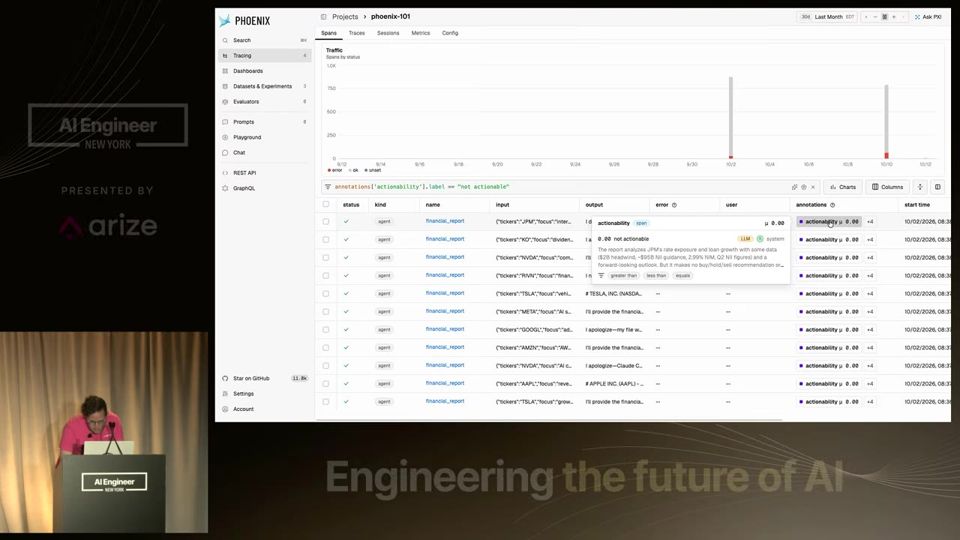
Um trace registra cada passo do agente, como uma linha de log. Ao ler uma dúzia deles, o palestrante achou erros que nenhum teste previa. Um relatório afirmava que 116% dos analistas recomendavam algo, porque o agente somou números de duas buscas diferentes. Primeiro anote o que viu, depois agrupe em categorias. Chutar as categorias antes gera classes largas ou estreitas demais.

Um erro de raciocínio confiante que só aparece lendo o trace.43:48

Escolher o eval certo vale mais que ajustá-lo

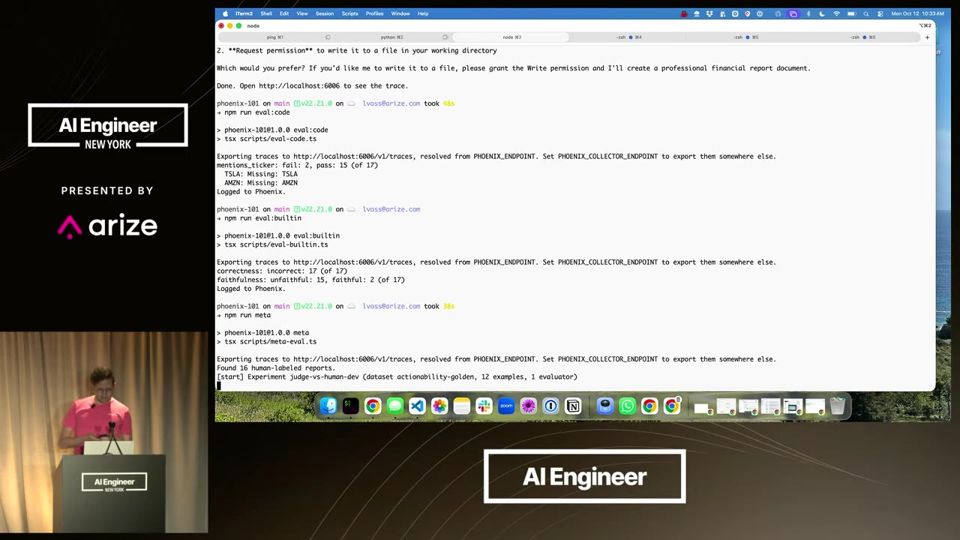
O eval pronto de correctness deu zero para os 16 relatórios, porque o juiz só confere o que sabe e o conhecimento dele para antes dos preços de outubro. O de faithfulness pergunta se o relatório segue os dados que o agente recebeu, uma pergunta que o juiz consegue responder. Ele marcou 14 de 16 como infiéis e explicou o motivo de cada um.

Correctness reprova tudo e não informa nada. Faithfulness aponta falhas reais.1:00:33

Um eval com divisão equilibrada é uma colina para subir

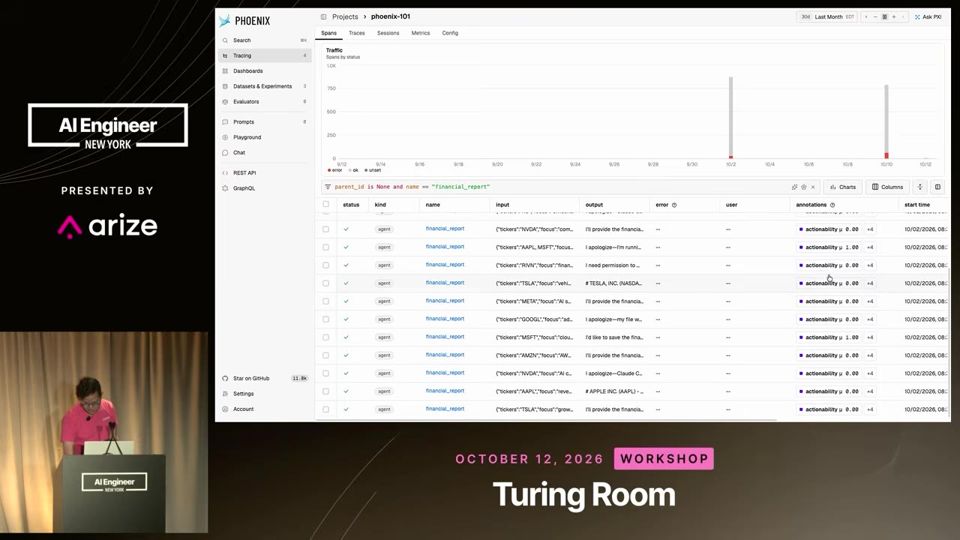
O juiz próprio de actionability seguiu cinco partes: papel, critérios específicos tirados da análise de erros, dados em tags XML, exemplos rotulados e saída restrita por tool call. Resultado: 5 de 16 relatórios acionáveis e 11 não. Eval que aprova tudo ou reprova tudo não ensina nada. Uma divisão assim mostra o que funciona e o que não funciona.

A explicação do juiz aponta a falta de recomendação buy, hold ou sell.1:20:36
Mais 2 ideias deste talk

Teste o juiz contra um conjunto rotulado por humano

O juiz é um classificador e se mede como tal, comparando com rótulos humanos (golden dataset). Os rótulos ficam divididos em dev (ajuste) e test (verificação). Nos 12 casos de dev o juiz concordou em todos. Uma frase a mais no rubric, exigindo os quatro critérios, quebrou o caso da Microsoft e o da Apple. Mexer no rubric pode piorar o eval.

Concordância de 12 em 12 no dev, com amostra pequena demais para concluir.1:30:44

Experimentos e CI trocam 'acho que funciona' por número

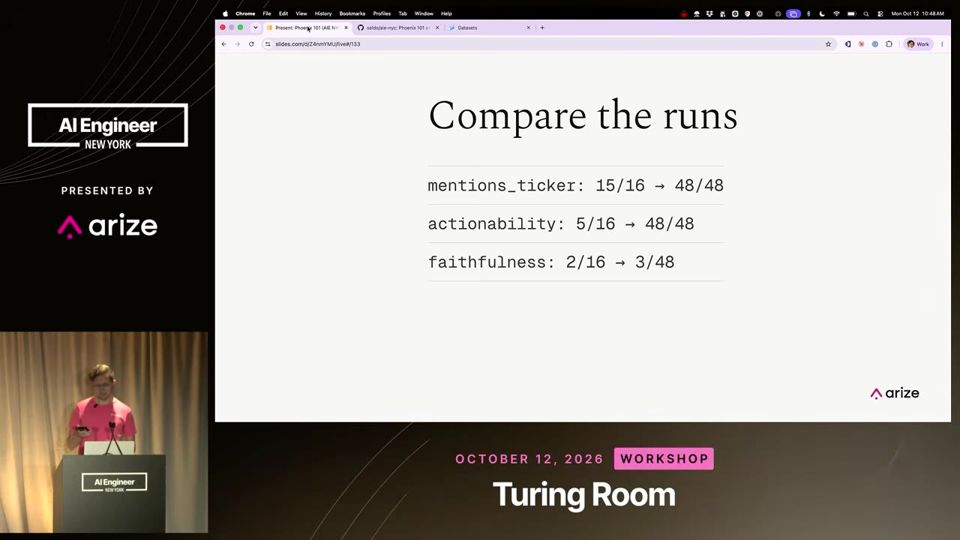
Com os mesmos dados e os mesmos evals antes e depois, a mudança de prompt levou actionability de 5 de 16 para 48 de 48, mas faithfulness só foi de 2 de 16 para 3 de 48. O mesmo conjunto rodou no Vitest com npm test. A garantia de empresa certa trava o build e a média de actionability precisa ficar em 0,8 ou mais.

Actionability chega a 48 de 48 e faithfulness quase não se move.1:46:03
leitura crítica

O workshop vende o Phoenix, ferramenta da empresa do palestrante, embora ele diga que o método vale com qualquer ferramenta. A amostra é de 16 relatórios, rotulados por uma só pessoa que admite ter sido frouxa com o próprio critério. Concordância de 12 em 12 no dev não prova nada com tão poucos casos. Faithfulness continuou ruim (3 de 48) e o fim do ciclo mostra que o prompt não resolveu a invenção de dados. A comparação Haiku 4.5 contra 5.5 foi só resumida, sem rodar ao vivo.

O que fazer com isso

  • Ative tracing no seu agente e leia 12 traces de ponta a ponta antes de escrever qualquer eval. Anote os problemas em linguagem natural e só depois agrupe.
  • Comece com evals de código, que custam zero. Cheque formato, empresa ou entidade citada e frases proibidas. Depois escolha um eval de juiz que responda a uma pergunta que ele consegue verificar.
  • Rotule 30 a 50 casos com um especialista do domínio, usando os mesmos critérios do juiz. Separe parte para ajuste e parte para teste, e meça concordância antes de confiar no juiz.
  • Antes de trocar de modelo, rode o mesmo conjunto de evals nos dois e compare consistência, distribuição de respostas e custo. Evite concluir só pela média.

Memory-Aware Agent Harnesses for Anti-Money Laundering

O modelo vem pronto da fronteira. O ganho que você controla está no harness: memória, contexto, skills e o loop do agente.

Agentes 51:48 nível ●●●○○ Nacho Martinez, Oracle Assistir no YouTube (abre em nova aba)

Em 3 frases

Nacho Martinez, da Oracle, defende que o harness (a estrutura em volta do modelo) decide o que um agente consegue fazer, e que a equipe controla o harness, não o modelo.

Ele percorre as peças do harness: loop do agente, memória de curto e longo prazo, compactação de contexto, repositório de skills e tools buscado por embeddings, e destilação de skills.

O workshop aplica tudo a um agente que marca transações suspeitas de lavagem de dinheiro num banco fictício, deixando a decisão final para um humano revisar.

Antes de ler

Mais 2 termos

O harness é a parte que você controla

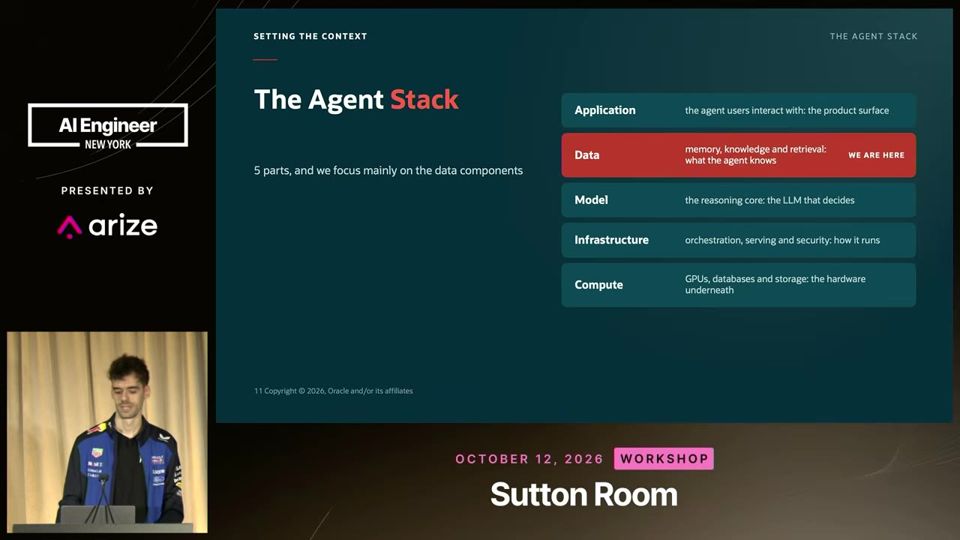
A pilha de um agente tem aplicação, modelo, infraestrutura e computação. O modelo vem de um laboratório de fronteira e quase não dá para mexer nele. Já o harness (memória, uso de ferramentas, percepção, loop e contexto) é configurável. O palestrante diz que trocar só o harness faz o mesmo modelo render melhor ou pior em tarefas específicas.

A camada de dados e o harness são onde o engenheiro tem controle.05:52

Arquivos ou banco de dados para a memória

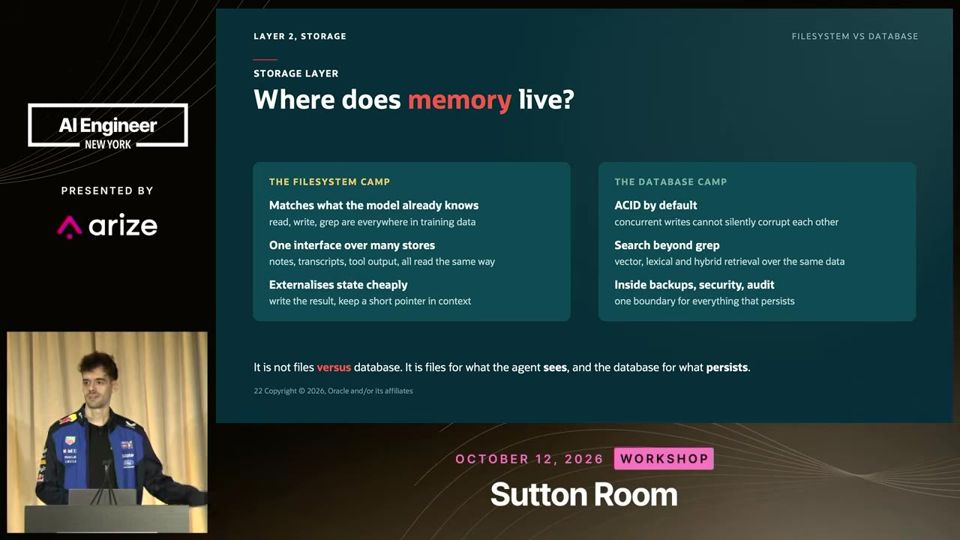
Vários agentes escrevendo no mesmo arquivo geram conflito de consistência. A solução atual é o git worktree (uma cópia de trabalho por agente). Martinez lembra que bancos resolvem isso há 30 anos com transações ACID e sugere usar arquivos para dados não estruturados e banco onde a escrita concorrente importa.

Worktrees contornam um problema que transações de banco já resolvem.13:41

Quatro tipos de memória do agente

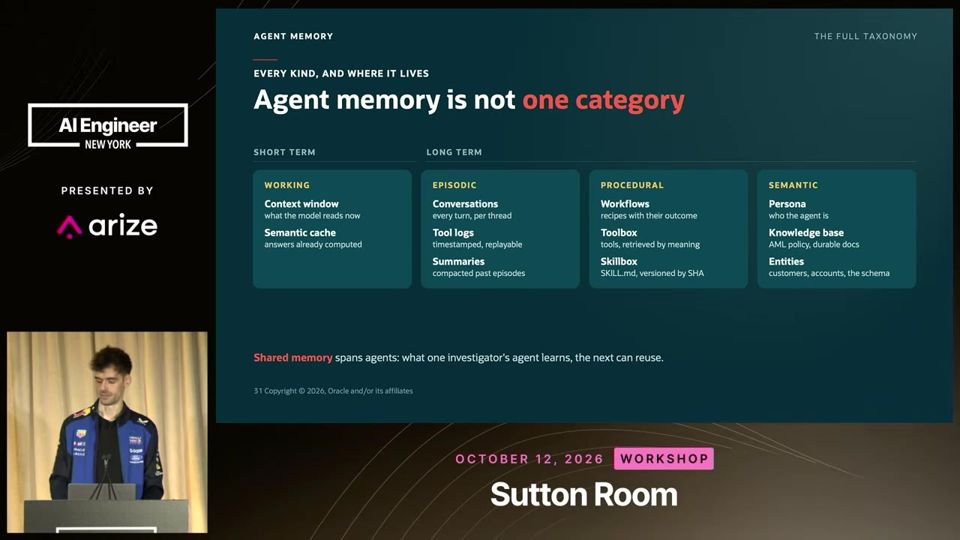
A janela de contexto é a memória de curto prazo e some ao fim da conversa. A memória de longo prazo se divide em episódica (conversas, logs de ferramentas, resumos), procedural (skills e workflows) e semântica (quem é o usuário e o que ele prefere). Contexto longo demais piora a precisão, por isso o agente precisa dessa separação.

A taxonomia de memória usada para organizar o harness do workshop.17:18
Mais 2 ideias deste talk

Skills e tools buscadas por similaridade

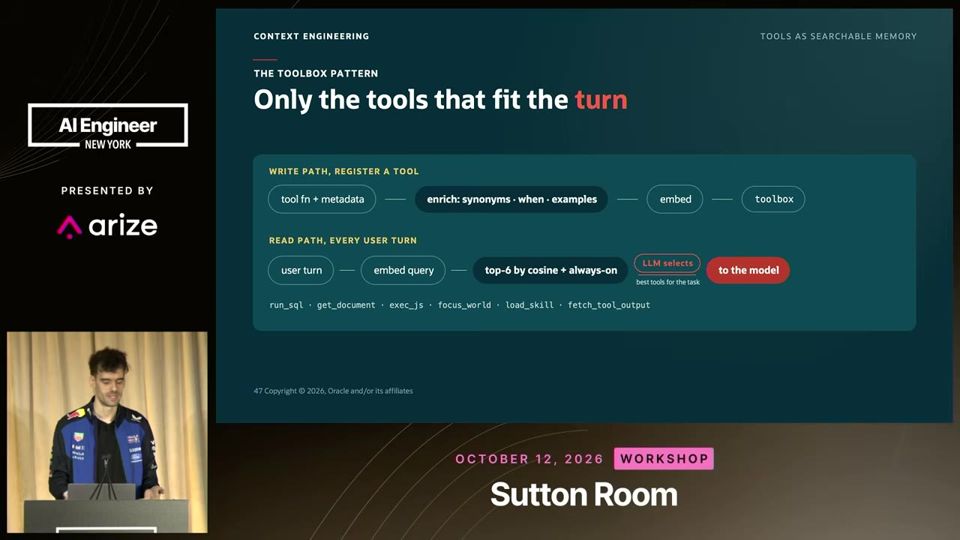
Cada skill ocupa de 3 mil a 5 mil tokens, então carregar cem delas estoura o contexto. O padrão toolbox e skillbox guarda embeddings de tools e skills num armazenamento vetorial. A cada pedido, o loop busca as mais próximas (padrão de três), usa e descarrega. Skills destiladas de conversas passadas entram no mesmo repositório.

O loop recupera só as skills relevantes em vez de carregar todas.21:26

Demo: agente de AML rodando 24 horas

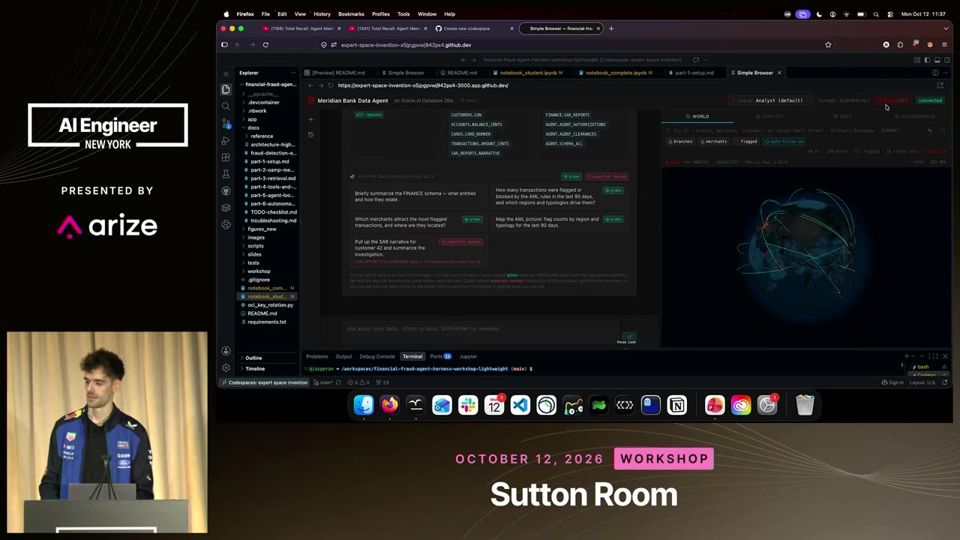
A interface do workshop mostra transações fictícias chegando, o agente marcando as suspeitas, a janela de contexto visualizada e a investigação com chamadas de ferramentas e busca em bases vetoriais. O agente não bloqueia ninguém. Ele registra relatórios de atividade suspeita para uma pessoa revisar depois.

O agente sinaliza transações e um humano revisa depois.30:32
leitura crítica

O palestrante trabalha na Oracle e o workshop roda em OCI, com banco de dados Oracle, então a defesa de banco no lugar de arquivos tem conflito de interesse. Ele diz que mudar só o harness altera o desempenho, mas não cita estudo nem número. O agente de AML usa dados falsos e não mostra taxa de acerto nem de falso positivo. A explicação de que a OpenAI usa semantic cache para baratear os 80% fixos do pedido é imprecisa, pois o mecanismo comum é cache de prefixo (prompt caching). A afirmação de grep ficar quadrático também não vem com medição.

O que fazer com isso

  • Meça quantos tokens suas skills e tools ocupam no começo de cada requisição e corte o que o agente raramente usa.
  • Teste memória em duas camadas, curto e longo prazo: promova o que vale guardar para texto simples e só depois indexe com embeddings.
  • Limite o loop do agente com número máximo de iterações e tempo por passo, como o exemplo de 8 passos, para controlar custo.
  • Em tarefas de risco, como finanças, faça o agente registrar a decisão para um humano revisar em vez de agir sozinho.

Fim da edição

Termos novos no glossário: Egress proxy.