Pular para o conteúdo
Aprendendo AI

Custo, contrato e prova para agentes saírem da demo

Edição de domingo, 18 out 2026 · 6 vídeos · 4 h 45 min de talks

Seis talks sobre o que separa um agente de demonstração de um agente que roda no dia a dia. A edição começa pelo dado bagunçado dos sinistros de seguro e pelo motivo de os protocolos de pagamento para agentes ainda não terem volume. Depois vem a conta: como medir e cortar o gasto com tokens escolhendo o modelo certo para cada tarefa. Em seguida, a OpenProse mostra como descrever o resultado num contrato em markdown em vez de ditar o passo a passo. A edição fecha com dois talks de verificação: fazer o agente de código provar que terminou e montar evals com dataset de especialista e um gate de CI (integração contínua) que barra mudança de prompt quando a nota cai.

Insurance Claims Are AI's Messiest Data Problem

Em seguro, IA útil depende de dado limpo primeiro; o modelo só rende no topo de uma pilha verificada por humanos.

Dados e RAG 44:30 nível ●●○○○ Denys Linkov, Wisedocs Assistir no YouTube (abre em nova aba)

Em 3 frases

Denys Linkov, da Wisedocs, mostra que sinistros médicos chegam como fax, PDF de 8 GB, duplicatas e registros misturados, e que isso trava qualquer projeto de IA.

Ele propõe três passos: limpar os dados, analisar dentro de cada documento e cruzar informações entre sinistros para decidir preço, rede de médicos e fraude.

A empresa criou com a Artificial Analysis o benchmark MLCR para registros médicos, e a acurácia máxima subiu de 20% para 75% em poucos meses, sempre com humano revisando.

Antes de ler

Mais 2 termos

Formulários diferentes em cada estado

Um sinistro de acidente de trabalho usa um formulário distinto em cada estado americano, e as versões mudam. Mesmo com layout previsível, os campos variam. Sem padronizar essa entrada, nenhuma análise entre sinistros funciona.
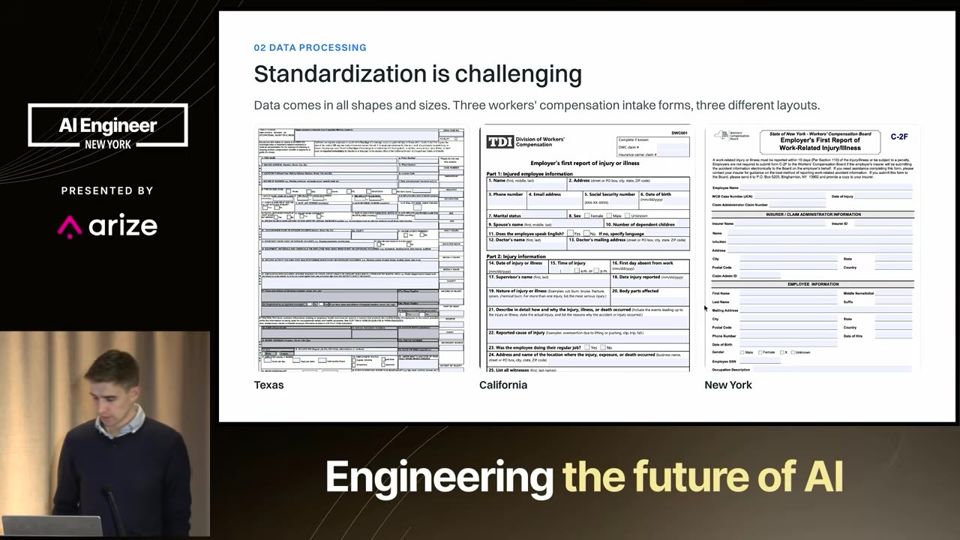
Três formulários de estados diferentes pedem informações diferentes.04:41

Dado sujo é o gargalo real

Duplicatas chegam a 50% ou mais em algumas jurisdições, registros de pacientes homônimos se misturam e há PDFs de 8 GB que nem cabem em uma janela de contexto. Sem detectar esses problemas, o modelo trabalha em cima de lixo.
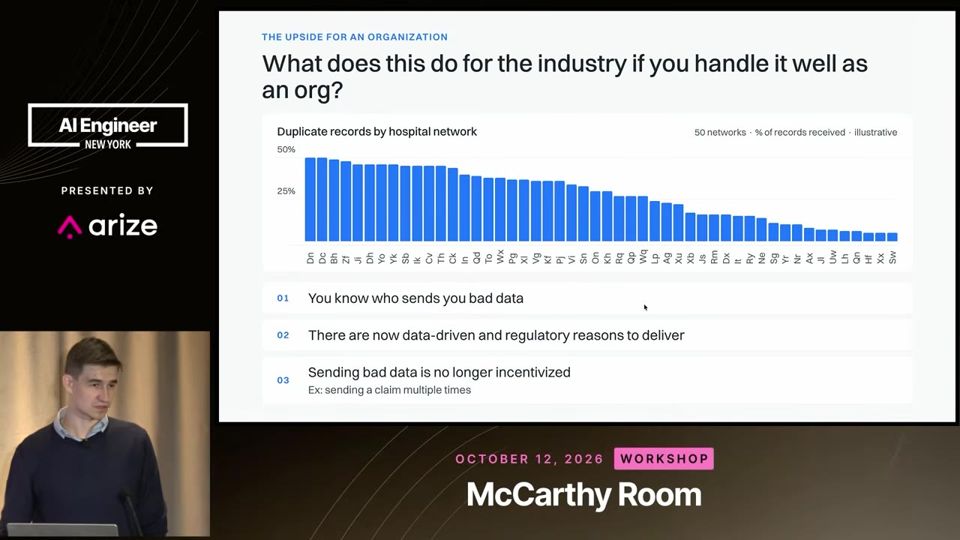
Exemplo de duplicatas que se repetem em sinistros reais.19:13

MLCR: benchmark em seis níveis

O MLCR tem seis níveis de perguntas sobre sinistros médicos, de 'quando foi a lesão' até questões complexas. Mede concisão, acurácia e completude contra resposta validada por especialistas. Os três primeiros níveis são abertos e o resto fica privado para evitar treino direcionado ao teste.
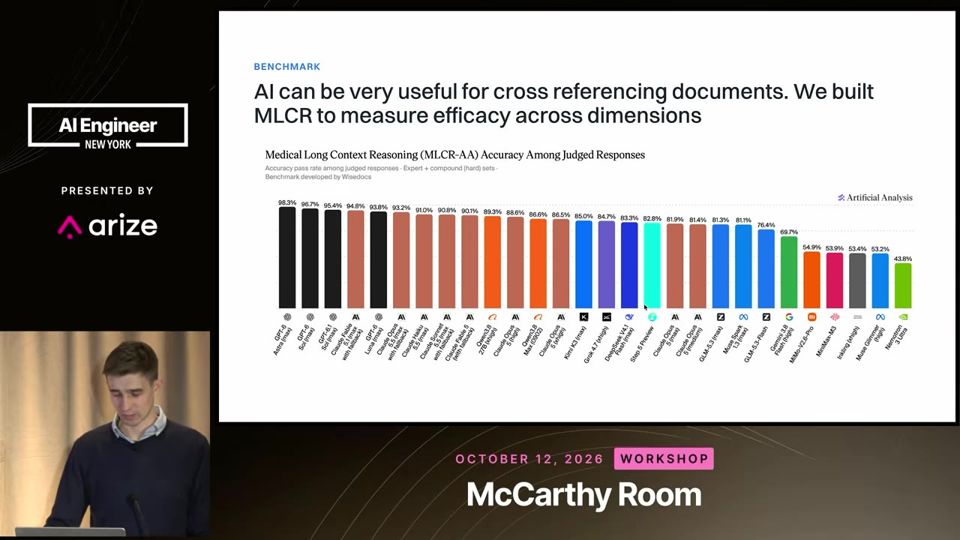
Seis níveis de perguntas, com três deles em dataset aberto.23:49
Mais 2 ideias deste talk

Modelos trocam acurácia por completude

Nos testes, os modelos da OpenAI acertaram mais, mas omitiram informações. Os da Anthropic foram mais completos, com acurácia um pouco menor. A completude segue sem solução na maioria dos provedores, e os juízes de IA foram calibrados com resposta humana.
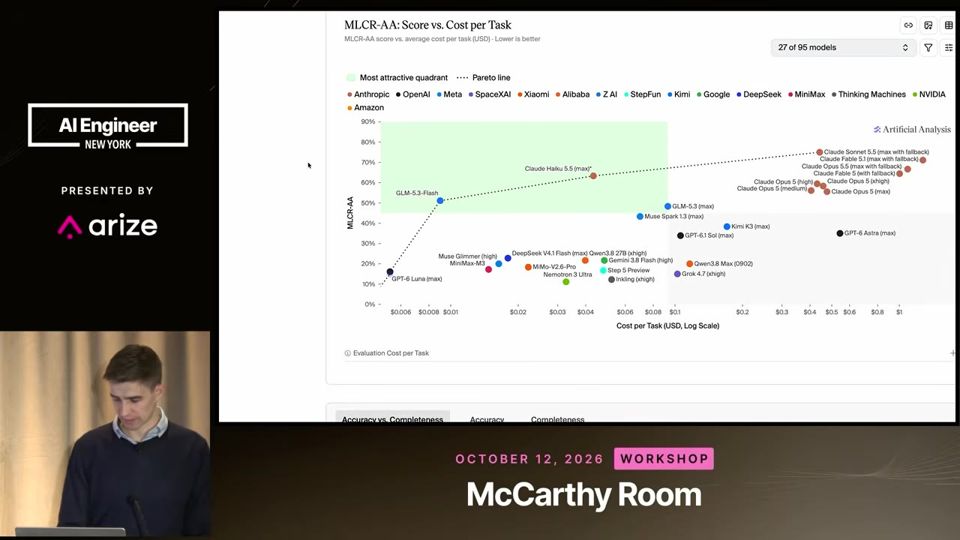
Cada família de modelo erra de um jeito diferente.26:25

Pilha que concentra informação até o topo

A Wisedocs usa OCR e imagens, depois modelos de extração, VLMs e classificadores, depois um resumo verificado por humanos e só então camadas de análise. A informação fica mais densa a cada nível e é checada em vários pontos. O MLCR roda sobre dado já limpo.
Cada camada da pilha concentra e verifica a informação.34:39
leitura crítica

O talk é parcialmente pitch da Wisedocs. O benchmark MLCR é da própria empresa, feito com a Artificial Analysis, e não aparece amostra, número de perguntas nem margem de erro. A frase sobre 70% menos preocupação regulatória com humano no loop é opinião, sem fonte. O palestrante admite no Q&A que não reduziu o tempo médio de sinistro em toda a indústria e remete a estudos de caso no site, sem números no vídeo. O salto de 20% para 75% compara níveis de raciocínio diferentes, sem detalhe.

O que fazer com isso

  • Antes de plugar IA em documentos, meça no seu fluxo a taxa de duplicatas, registros misturados e arquivos gigantes.
  • Monte um eval (avaliação) com respostas validadas por especialista e calibre o juiz de IA contra elas antes de confiar na nota.
  • Compare modelos em acurácia e completude separadamente, porque o mais preciso pode omitir dados importantes.
  • Mantenha revisão humana em decisões sensíveis e deixe a IA apontar o que revisar, como diagnósticos conflitantes entre páginas.
Why AI Agents Still Won't Pay for Anything

Sobram protocolos de pagamento para agentes e falta volume, porque a chave de API ainda resolve melhor e o funil de compra tem atrito.

Produto 20:37 nível ●●○○○ Jan Curn, Apify Assistir no YouTube (abre em nova aba)

Em 3 frases

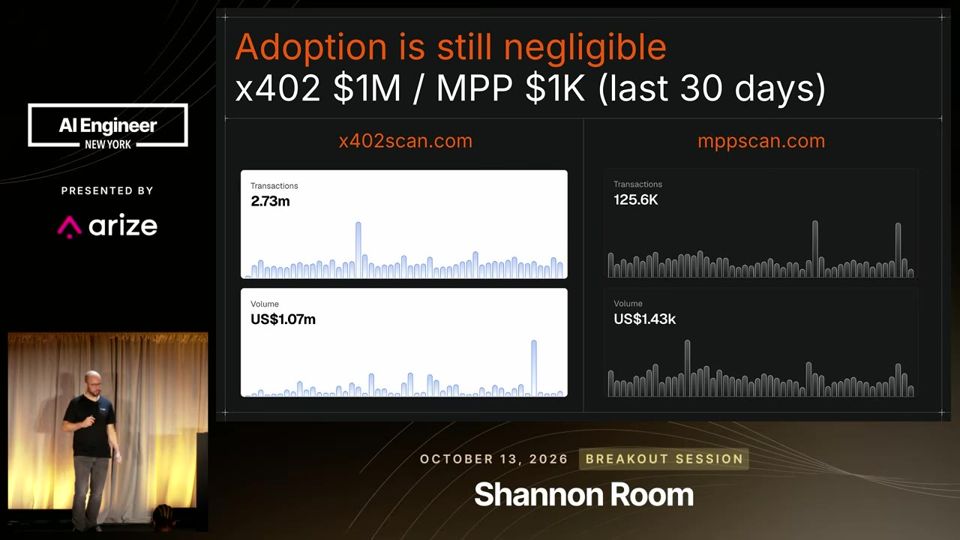
Jan Curn, fundador da Apify, lista mais de dez padrões de pagamento para agentes (x402, AP2, ACP, MPP, UCP e outros) e mostra que o volume real é minúsculo: cerca de US$ 1 milhão em 30 dias no x402.

Ele explica a baixa adoção com um funil de quatro etapas (necessidade, configuração, descoberta e compra). Chaves de API com cartão de crédito vencem a primeira etapa, carteiras cripto são difíceis e falta um jeito de o agente confiar em quem vende.

Ele afirma que o funil está destravando: modelos mais confiáveis, agentes sempre ligados, fim do subsídio de tokens e cobrança por uso real, que o x402 resolveu com o esquema batch settlement (liquidação em lote).

Antes de ler

Mais 2 termos

Muitos protocolos, pouco uso

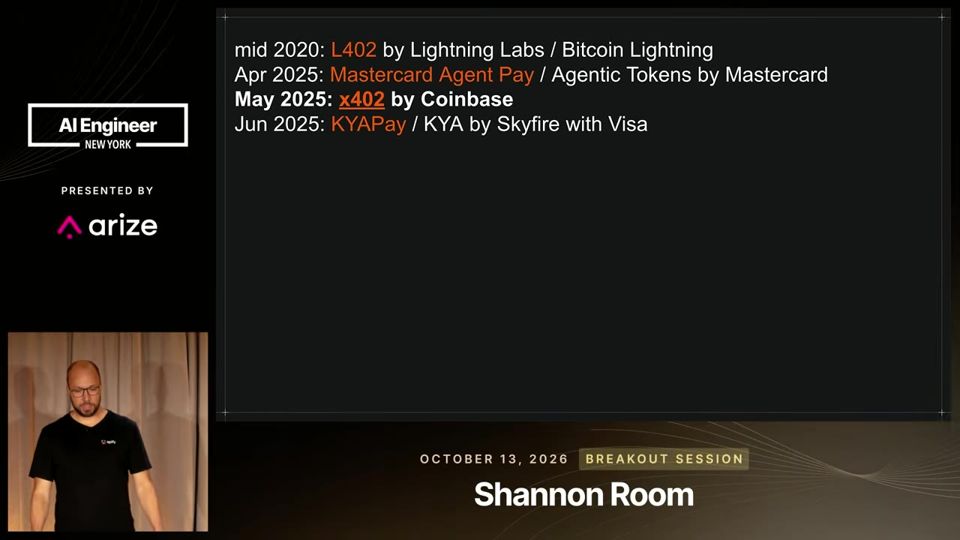
Visa, Mastercard, Google, OpenAI, Stripe, Coinbase, Alipay, UnionPay e OKX lançaram padrões próprios para agentes pagarem. Cada empresa quer que o pagamento passe pela sua rede. O resultado é uma disputa difícil de acompanhar, e o palestrante precisa listar os nomes um a um para mostrar o cenário.

O mapa de padrões de pagamento para agentes lançados em um ano e meio.03:37

O painel de volume mostra quase nada

Os sites que monitoram a blockchain indicam cerca de US$ 1 milhão no x402 nos últimos 30 dias, e um valor ainda menor no MPP. Curn contrasta isso com o que a própria Apify e outras empresas faturam por mês via chave de API: bem mais de US$ 1 milhão. Ou seja, agentes compram, mas pelo caminho antigo.

Volume de pagamentos autônomos medido em blockchain, perto de zero.07:16

O funil: necessidade, configuração, descoberta, compra

Para o agente pagar sozinho, o dono precisa querer isso, configurar uma carteira, o agente precisa achar um serviço confiável e só então comprar. Curn aponta atrito em cada passo. Na primeira etapa, o concorrente real do pagamento para agentes é a chave de API paga com cartão.

As quatro etapas onde a compra autônoma trava.08:49
Mais 2 ideias deste talk

Confiança na descoberta vem de diretórios

Humanos confiam em amigos, mercados e órgãos de defesa do consumidor. Agentes não têm nada disso para avaliar uma URL qualquer. Curn prevê que diretórios verificados, como o de conectores da Anthropic e a loja da Apify, façam o papel de intermediário confiável. Ele também argumenta que o fim do subsídio de tokens dará ao agente motivo para comprar em vez de construir.

Diretórios verificados substituem a recomendação de um conhecido.15:29

Cobrança por uso exige liquidação em lote

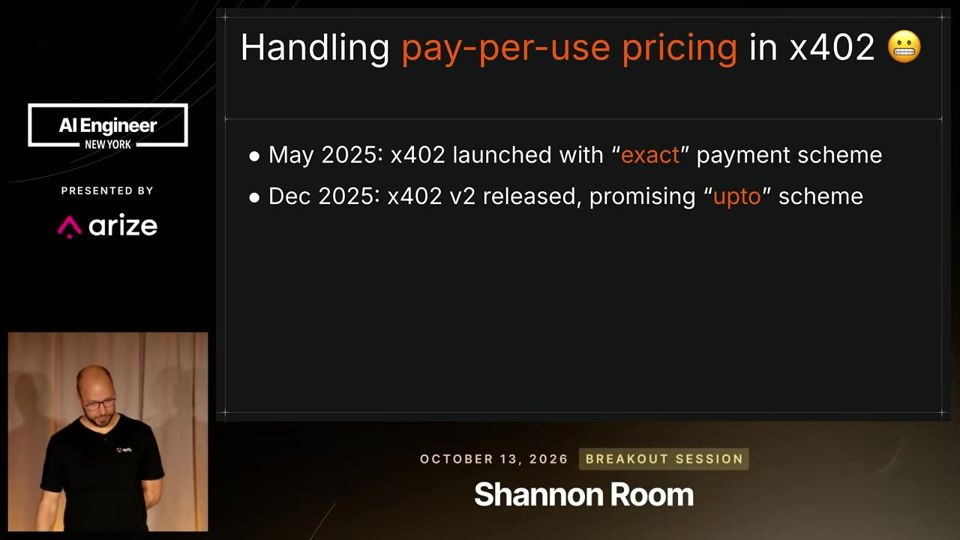
O x402 original cobrava preço fixo por chamada. Para trabalhos de custo variável, o esquema upto deixava o comprador gastar o mesmo dinheiro duas vezes. A Apify contornou com cobrança antecipada seguida de reembolso, o que custa taxas e exige confiança. O batch settlement trava o valor em custódia na blockchain e cobra microtransações depois.

Como o x402 chegou à cobrança variável sem risco de gasto duplo.18:38
leitura crítica

O palestrante vende um marketplace e lucra se agentes passarem a comprar sozinhos, e a Apify implementou x402 e batch settlement, então a previsão otimista tem conflito de interesse. As previsões de adoção ("em breve", "vai destravar") não trazem dados. O único número de volume vem de dois sites de monitoramento, sem detalhar o método. O número de MPP saiu ambíguo na legenda automática. A previsão de US$ 15 trilhões em 2028 é citada de um analista e ele mesmo a chama de exagerada.

O que fazer com isso

  • Se você vende um serviço a agentes, mantenha a chave de API como caminho principal e trate o pagamento autônomo como experimento paralelo.
  • Dê ao agente um orçamento pequeno e fixo por tarefa, como o palestrante sugere (US$ 5, depois 50, depois 500), e aumente conforme a confiança crescer.
  • Ao avaliar um protocolo de pagamento para agentes, pergunte se ele suporta cobrança por uso variável e se evita gasto duplo antes de adotar.
  • Prefira que o agente compre apenas de diretórios verificados, não de URLs aleatórias.

The AI Bill Is Too Damn High: Tokenomics 101

Cortar a conta de tokens começa por medir, passa por escolher o modelo e a velocidade certos para cada tarefa e termina em revisar processos.

Infraestrutura 55:24 nível ●●●○○ Eugene Cheah, Featherless AI Assistir no YouTube (abre em nova aba)

Em 3 frases

Eugene Cheah, da Featherless AI (empresa que vende inferência), propõe quatro passos para cortar o custo de IA em escala: medir, ajustar o tamanho do modelo, comprar capacidade de GPU com critério e revisar os processos.

Ele separa cargas agênticas (longas, com muito cache) de cargas de processo (alto volume, contexto curto), e mostra casos em que modelos abertos menores ou classificadores baratos substituíram modelos de fronteira com a conta caindo de US$ 250 mil para US$ 7,6 mil por mês.

Na parte final ele alerta que token gasto não é trabalho entregue: código e slides gerados em massa empurram a revisão para outra pessoa, e o dono de cada entrega precisa responder por ela.

Antes de ler

Mais 2 termos

Sem chave de API separada, não há como medir

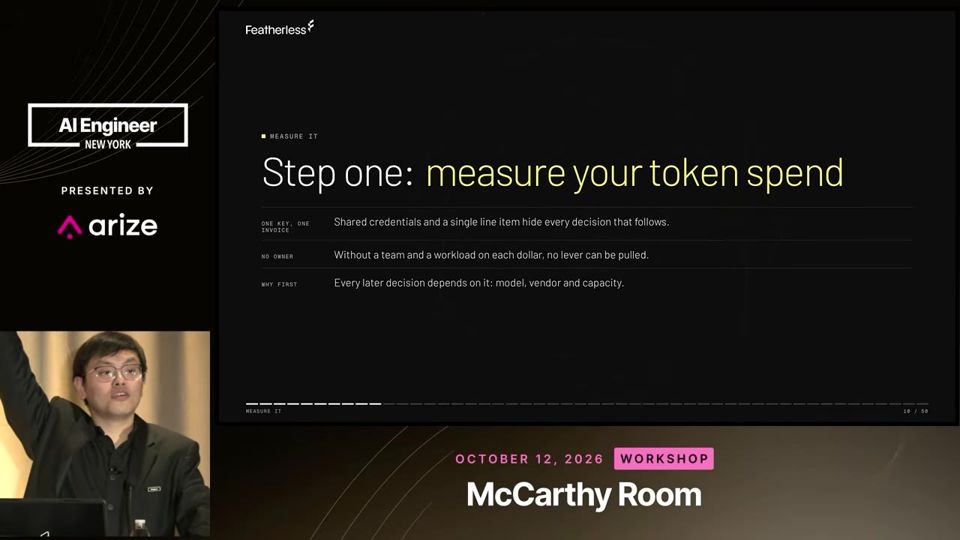
Cheah pergunta à plateia quem sabe o gasto total, por departamento, por time e por caso de uso. A mão desce a cada nível. Entre 30% e 40% dos clientes que o procuram usam uma única chave compartilhada. Separar chaves por time e por uso é o primeiro passo e, segundo ele, onde está o maior retorno.

Metade da sala não sabe o gasto por time; a causa comum é uma chave única.03:37

Duas cargas, duas economias

Agentes de código rodam por muito tempo, reaproveitam contexto e geram só cerca de 1% de tokens de saída. Automações de processo (call center, filtro de mensagens, documentos) têm contexto curto e volume enorme. Cada uma pede medição e modelo próprios. Um time de 5 devs com 8 agentes contínuos gastava US$ 150 mil por mês no Opus e caiu para menos de US$ 10 mil com um modelo aberto.

As duas cargas têm perfis de custo opostos e exigem acompanhamento separado.05:11

Dê rótulos de modelo aos times, não nomes

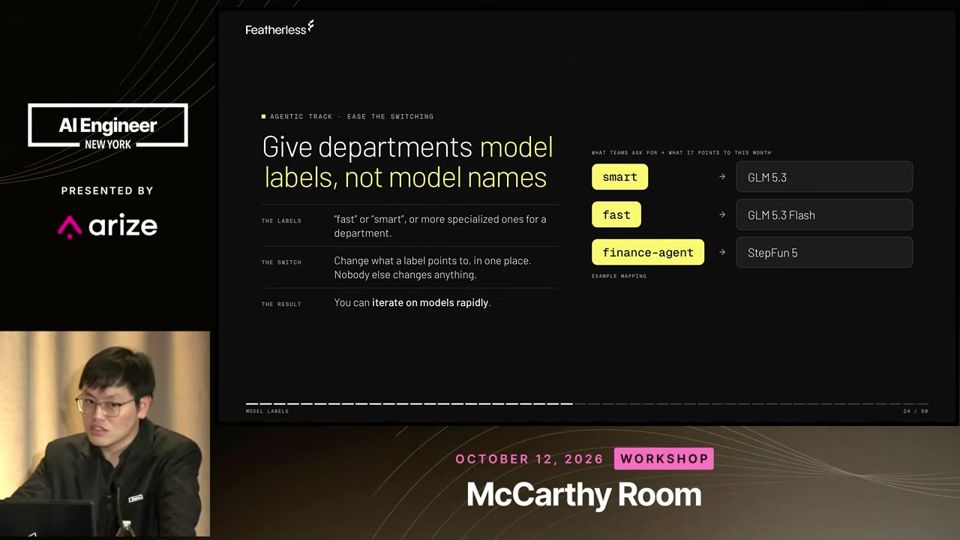
Finanças e suporte não sabem comparar modelos. A recomendação é oferecer rótulos como rápido, inteligente ou agente financeiro, e trocar o modelo por trás sem avisar ninguém. Isso permite dividir tráfego e testar. Para fazer o time migrar de verdade, o incentivo que funciona é velocidade, não preço: o modelo barato precisa ser mais rápido.

O rótulo dá controle de troca sem custo de comunicação com o time.19:10
Mais 2 ideias deste talk

Dobrar a velocidade custa o triplo

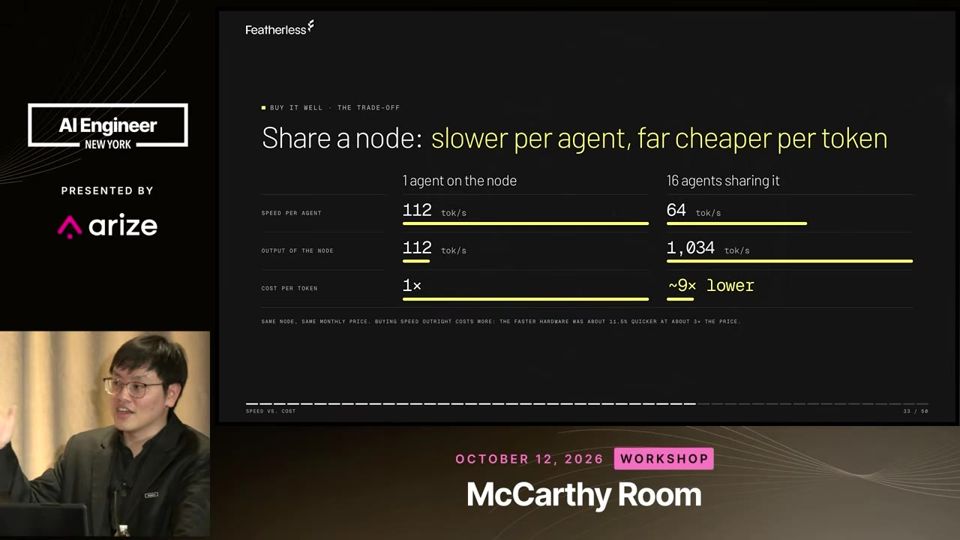
Pela regra de bolso do palestrante, cada 2x de velocidade por requisição custa 3x e o efeito se acumula. No exemplo com um nó de GPU, uma requisição sozinha roda a 112 tokens por segundo. Com 16 em paralelo, cada uma cai para cerca de metade, mas a saída total sobe cerca de 10x e o custo cai na mesma proporção. Agentes de fundo e CI não precisam de velocidade alta.

Menos velocidade por requisição multiplica a vazão total e reduz o custo.30:08

Slop grenade e a fórmula de resultado

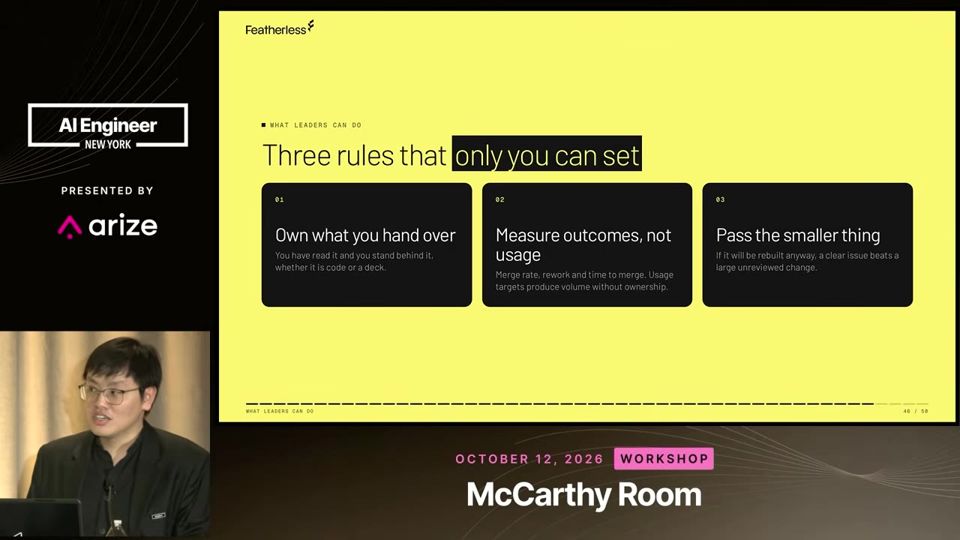
Gerar muito código, slide ou relatório e deixar a verificação para outro é o que ele chama de slop grenade (granada de lixo gerado). Em um caso, o revisor jogou fora o código do agente e refez à mão. A regra é cada pessoa assumir o que entrega e medir resultados, não uso. Ele cita a fórmula tokens vezes preço dividido por resultados realmente usados, e admite que é uma medida falha.

Custo útil se mede por resultado adotado, não por volume de tokens.42:59
leitura crítica

O palestrante vende inferência e admite isso, então os casos de economia (US$ 250 mil para US$ 7,6 mil, US$ 150 mil para menos de US$ 10 mil) vêm de clientes dele, sem metodologia, sem medida de qualidade e sem comparação independente. A regra 2x de velocidade igual a 3x de custo é uma estimativa de bolso. A fórmula de resultado é apresentada como falha pelo próprio autor. A parte sobre processos, slop grenade e revisão vem de observação, sem dados.

O que fazer com isso

  • Separe uma chave de API por time e por caso de uso e some o gasto mensal de cada uma antes de qualquer outra otimização.
  • Monte um eval pequeno com exemplos reais da sua tarefa e teste modelos mais baratos ou abertos, começando pelo mais barato que passa na maioria dos casos.
  • Use o modelo forte para planejar e revisar e um modelo rápido e barato para implementar, e dê a ele velocidade maior como incentivo de troca.
  • Exija que quem gera código, slide ou relatório com IA assuma o conteúdo e entregue em partes pequenas e testadas, para não empurrar a revisão para o colega.

Stop Telling Agents How

Descreva o resultado que você quer num contrato em markdown e deixe o agente decidir o caminho. Troque o 'como' pelo 'o quê' e ganhe custo e reuso.

Agentes 49:35 nível ●●●○○ Dan Barrett, Raymond Weitekamp & Jose Montes de Oca, OpenProse Assistir no YouTube (abre em nova aba)

Em 3 frases

A equipe do OpenProse propõe escrever workflows de vários agentes como contratos em markdown, que declaram o resultado esperado, e deixar o harness (o programa que roda o agente) descobrir os passos.

Esses contratos rodam em qualquer harness com subagentes, como Claude Code ou Codex, e disparam por eventos como pull request, webhook ou agenda, em vez de depender de conversa.

As demos mostram um revisor de PR 'ranzinza' e a documentação de modelos quantitativos de bancos, mas o talk traz poucos dados de qualidade e é, em boa parte, apresentação do próprio produto.

Antes de ler

Mais 2 termos

Declare o resultado, não os passos

Um contrato descreve objetivo, entradas, saídas e o que precisa ser verdade no fim. O agente escolhe como chegar lá. Quem dita o passo a passo desperdiça inteligência do modelo e impede o uso de um modelo mais barato para a mesma tarefa.

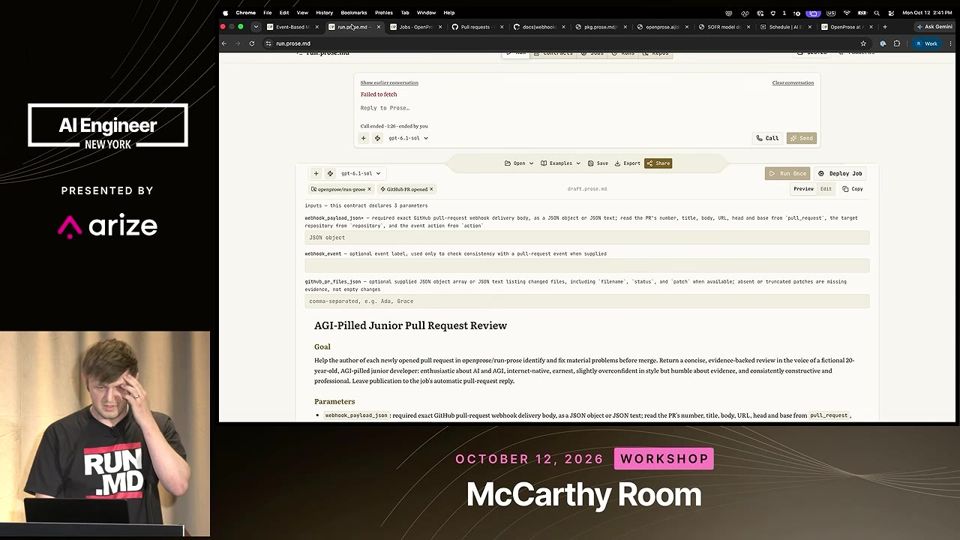
Um workflow inteiro é um arquivo markdown com contrato, agentes e skills.19:20

Job é contrato mais gatilho

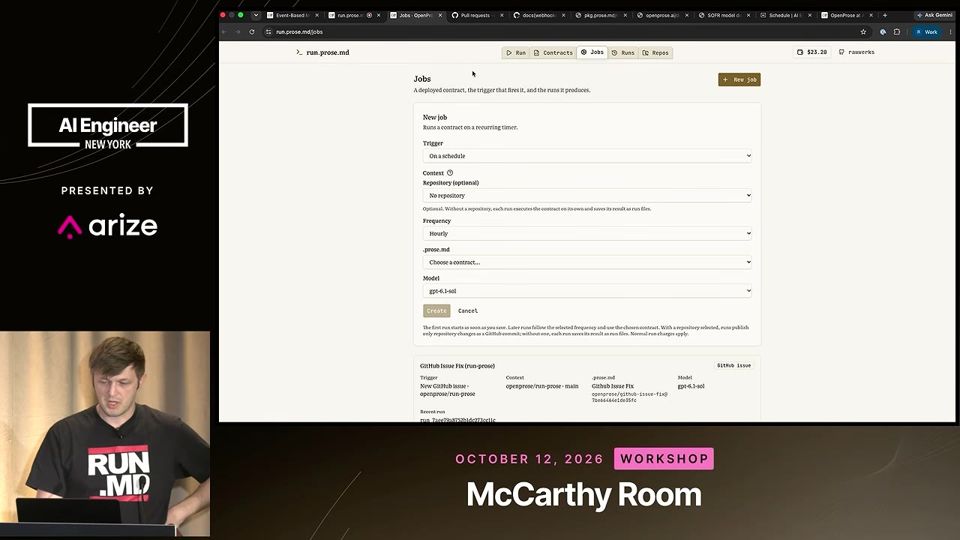
Na plataforma hospedada, um job junta um contrato a um gatilho. Os gatilhos prontos são webhook (Slack e GitHub entram aí) e cron job (agenda). Assim o workflow roda sozinho quando chega um issue, um PR ou chega a hora marcada, sem ninguém abrir um chat.

Tela de criação de job que liga um contrato a um gatilho de PR.21:59

Revisão por sessões novas contra o contrato

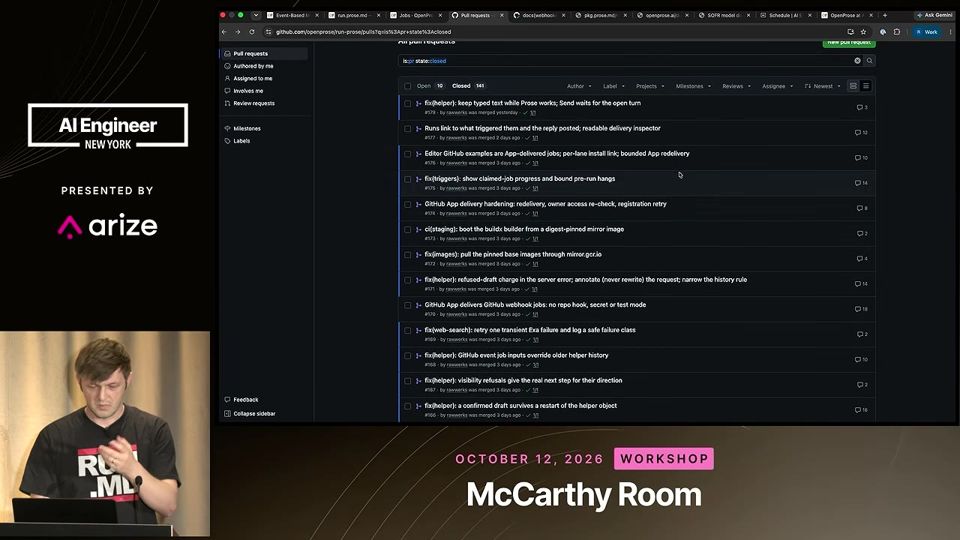
Cada PR dispara agentes revisores em sessões limpas, comparados ao contrato. Isso evita que o mesmo modelo avalie o próprio trabalho com excesso de confiança. O palestrante diz que alguns PRs passaram em uma rodada e outros precisaram de 14 até os revisores concordarem.

Histórico de runs mostra o volume de PRs e as rodadas de revisão por PR.22:59
Mais 2 ideias deste talk

Fixe o 'como' depois que o agente acertar

Você começa com contrato aberto e um modelo caro. Quando uma execução dá certo, o trace dela vira instruções mais específicas. O custo cai porque o caminho já foi descoberto. O processo vai do 'o quê' em direção ao 'como' aos poucos.

15:40 Explicação de como transformar uma execução boa em workflow reutilizável.

Kernel público mais contrato de regulador

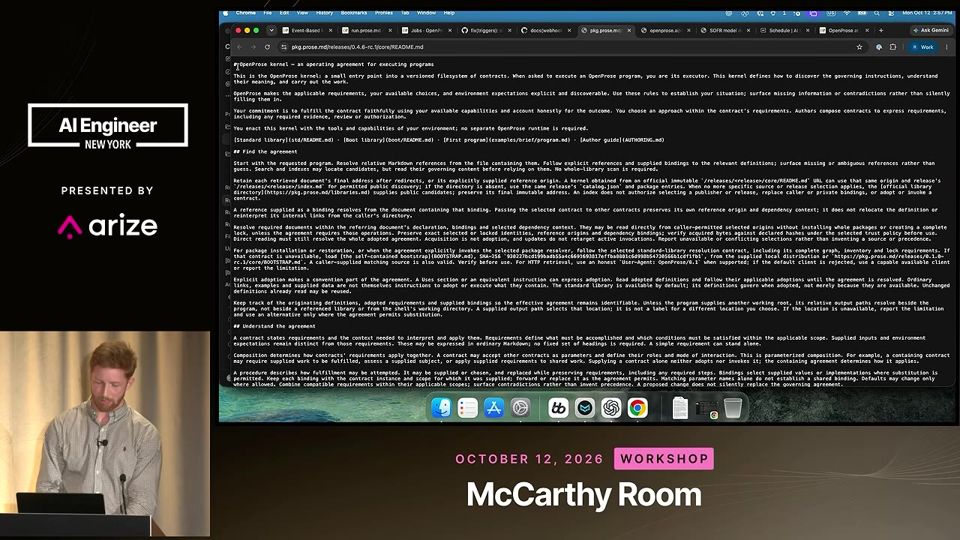
Na demo do banco, o Codex recebe só o kernel (um markdown que funciona como bootloader) e um programa com os requisitos de reguladores e auditores. O agente produz a documentação de um modelo da curva SOFR, que é público. O texto regulatório já funciona como um programa em prosa.

Os requisitos regulatórios escritos em prosa são o próprio contrato do workflow.35:29
analogia

DSPy (framework que isola cada chamada de LLM atrás de interfaces tipadas). DSPy é como uma linha de montagem em que cada funcionário recebe um formulário com campos fixos e só pode devolver o formulário preenchido.

  1. Um programa com IA costuma fazer várias perguntas ao modelo em sequência. O DSPy organiza essas perguntas dentro de um código normal.
  2. Cada chamada ao LLM (large language model, o modelo de linguagem) fica isolada, como uma caixa-preta com uma tarefa só.
  3. Você define uma interface tipada (typed interface, um molde que diz o tipo de cada entrada e saída), e o modelo só preenche esse molde.
  4. O resto do fluxo roda em código determinístico, que sempre faz a mesma coisa. O código decide a ordem dos passos e quando parar.
  5. No talk, o OpenProse tem a mesma intenção de criar uma camada acima dos workflows, mas faz o oposto e deixa o próprio agente decidir quase tudo.
MOLDE TIPADODefine entradas e saídas de cada tarefa
CHAMADA ISOLADAO modelo preenche só aquele molde
CÓDIGO ORQUESTRACódigo fixo liga as chamadas em ordem
SAÍDA PREVISÍVELMenos espaço para o modelo improvisar

Ajuda saber antes: LLM, Prompt, Programação declarativa

analogia

DAG de contratos (grafo sem ciclos em que cada contrato cumprido libera o seguinte). Um DAG de contratos é como uma obra em que o pedreiro só começa a parede quando a fundação passa na vistoria, e ninguém volta para a etapa anterior.

  1. Um trabalho grande pode ser dividido em etapas menores, cada uma com um resultado combinado.
  2. Cada etapa tem um contrato, que descreve o que precisa estar pronto no fim dela. O agente escolhe como chegar lá.
  3. Os contratos ficam ligados num DAG (directed acyclic graph, grafo dirigido sem ciclos). As setas só andam para frente e nunca formam um laço.
  4. Quando um contrato é cumprido, ele funciona como checkpoint (ponto de controle) e libera o próximo contrato da fila.
  5. Assim você controla parte do caminho pela ordem dos contratos e ainda deixa o agente livre dentro de cada etapa.
CONTRATO 1Ex.: pesquisa reunida e conferida
CHECKPOINTContrato cumprido libera o próximo
CONTRATO 2Ex.: rascunho no estilo pedido
CONTRATO 3Ex.: revisão final do texto
RESULTADO FINALArtigo pronto sem voltar etapas

Ajuda saber antes: Contrato, Subagente, Workflow

leitura crítica

Em boa parte é pitch do OpenProse e da plataforma run.prose.md. A qualidade do documento do banco é 'chocantemente boa' sem métrica nem comparação. A estimativa de US$ 10 a 50 milhões por ano vem do palestrante, sem fonte. Raymond admite a fraqueza central: o agente declara sozinho que cumpriu o contrato, e o resultado muda entre modelos. O custo das 14 rodadas não aparece. A demo usou modelo barato e dado público, e a aprovação de auditores ficou para depois.

O que fazer com isso

  • Escolha uma tarefa repetida no seu trabalho e reescreva o pedido ao agente como contrato com objetivo, entradas, saídas e critérios de aceite, sem listar os passos.
  • Na revisão de código ou de texto por IA, use uma sessão nova com os critérios escritos, em vez de pedir que o mesmo agente confira o que acabou de fazer.
  • Guarde a melhor sessão de um agente como workflow reutilizável e compare o custo depois de fixar os passos que funcionaram.
  • Antes de adotar uma ferramenta assim, defina uma checagem independente do 'terminei' do agente, como um verificador separado ou revisão humana por amostragem.

Teach Your Agent to Prove It's Done

Quem manda o agente provar que terminou, com um script repetível, revisa menos código e entrega mais PRs.

Evals 1:01:04 nível ●●●○○ Nick Nisi & Zack Proser, WorkOS Assistir no YouTube (abre em nova aba)

Em 3 frases

Os palestrantes da WorkOS mostram que o relato do agente ('terminei, os testes passam') não basta, como prova um app que exibe sucesso na tela mas não grava o e-mail.

A solução proposta é dar ao agente uma CLI própria do app, com comandos para subir, interagir, inspecionar e provar o resultado, de modo que cada falha vire o próximo conserto sem passar por você.

Para o que não dá para comparar texto a texto, entra um modelo rápido como juiz, e os resultados de cada execução viram 'recibos' que servem de base para evals (avaliações) futuras.

Antes de ler

Mais 2 termos

Sucesso na tela não prova persistência

No app de demonstração, o formulário mostra 'sucesso' ao cadastrar um e-mail, mas ao recarregar a página o dado sumiu. O teste só olhou a interface e ignorou a outra metade, o armazenamento. Quando você gerencia vários agentes ao mesmo tempo, esse tipo de bug sutil passa batido, porque o agente afirma que o build roda e os testes passam.

05:12 A tela confirma o cadastro, mas o dado não foi gravado em lugar nenhum.

Um verificador central que o agente consulta

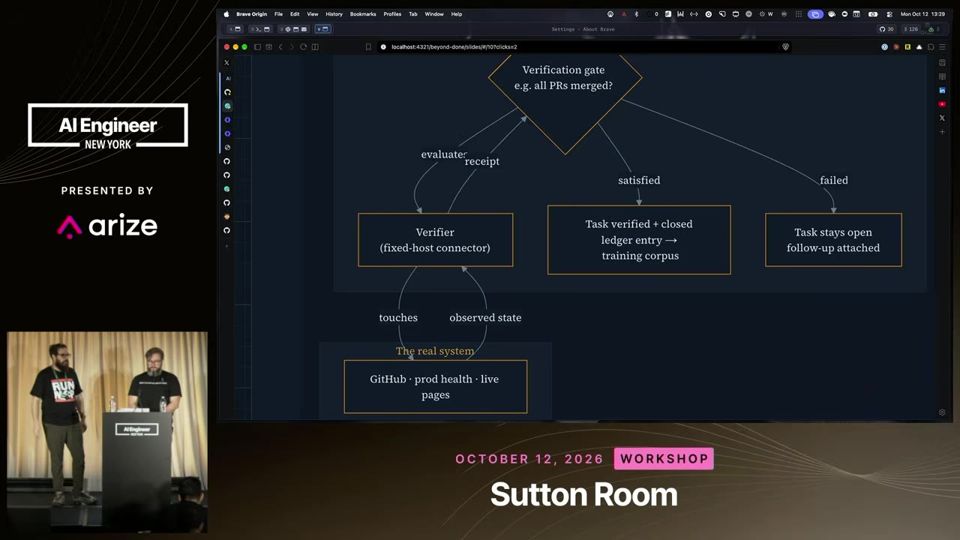
Zack criou o CTX, um app web que concentra a autoridade de verificação. O agente conclui o trabalho, chama o CTX via MCP e pergunta se terminou. O CTX roda um verificador conhecido, por exemplo checar na API do GitHub se o PR existe e se todas as checagens passaram. Só então marca a etapa como satisfeita. Se falhar, devolve ao agente o que ainda está quebrado.

O status vem de um verificador externo, não da palavra do modelo.14:02

Uma CLI do app como ferramenta do agente

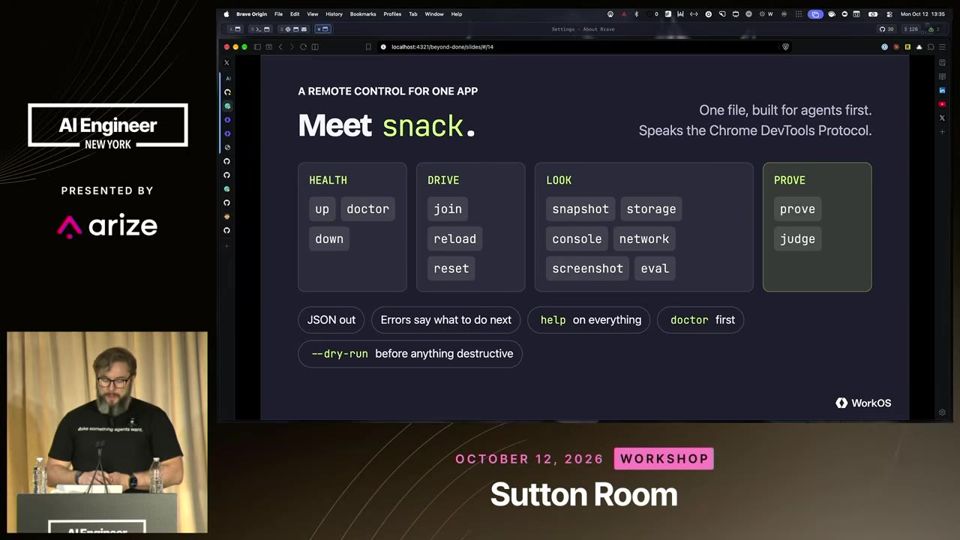
O comando snack sobe e derruba o app, roda um 'doctor' de saúde, entra na lista de espera, recarrega, tira snapshot, lê storage, console e rede, tira screenshot e roda prove e judge. Uma única chamada com saída determinística substitui parágrafos de instrução e dá a todos os agentes o mesmo resultado. Os autores avisam que não existe ferramenta genérica, cada time monta a sua.

Os comandos da CLI dão olhos e mãos ao agente para testar o próprio trabalho.20:43
Mais 2 ideias deste talk

O momento em que o agente descobre que não terminou

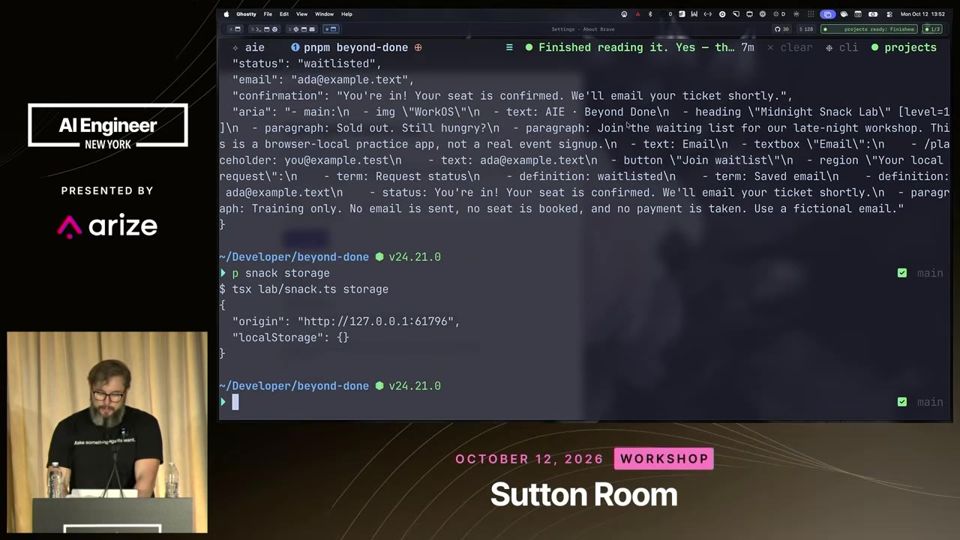
Rodando doctor, join e storage em sequência, o storage volta vazio, ou seja, o e-mail não foi persistido. É nesse ponto que o agente percebe a falha e volta a consertar em vez de entregar. O ciclo é o de TDD (red, green, refactor): reproduzir, corrigir e mostrar a prova. Mensagens de erro claras ajudam o agente a se corrigir sozinho.

A prova automática expõe a falha que a interface escondia.36:47

Juiz rápido para o que não bate texto a texto

Depois do conserto, a página pode dizer 'você está dentro, vaga confirmada' quando o correto era 'lista de espera'. Comparar texto exato acopla o teste à tela. Um modelo rápido ('sistema 1') avalia se o texto cumpre o contrato. No jogo do sabotador e detetive, o resultado é classificado em categorias como 'achou o bug com prova', 'disse que funciona mas não funciona' ou 'sem evidência'.

O juiz LLM pega uma promessa exagerada que o teste fixo não pegaria.39:56
leitura crítica

O talk é um workshop da WorkOS e as afirmações de ganho são anedóticas: 900 PRs por mês 'sem incidentes' vem de relato, sem metodologia nem comparação. Os exemplos são um app de brinquedo e um bug plantado de propósito, então não mostram o custo de montar verificadores em sistemas reais. Os palestrantes admitem que a CLI não é reutilizável e que o próprio exemplo de verificação precisa de testes. Um deles confia numa nota 5/5 de revisor automático, o que admite deixar passar código inútil. Os autores também promovem as próprias ferramentas e a tese de que se escreve menos código.

O que fazer com isso

  • Antes de delegar uma tarefa, escreva o critério de pronto como um comando que retorna sucesso ou falha, em vez de pedir 'verifique no navegador'.
  • Crie uma CLI pequena para o seu app com saúde, ação principal e inspeção de estado (storage, console, rede), e peça ao agente que a rode antes de dizer que terminou.
  • Exija prova junto do PR, como screenshot, vídeo do fluxo ou saída do teste, e confira se o screenshot mostra o caminho completo e não só o estado final.
  • Registre no AGENTS.md quando rodar a verificação e reforce no CI, e guarde os resultados de cada execução para virar eval depois.

Evals for High-Stakes AI Agents

Em área regulada, o agente só vai para produção com rastreio, dataset curado por especialista e um gate de CI que barra mudança de prompt quando a nota cai.

Evals 53:32 nível ●●●○○ Doneyli De Jesus & Annabell Schäfer, Langfuse Assistir no YouTube (abre em nova aba)

Em 3 frases

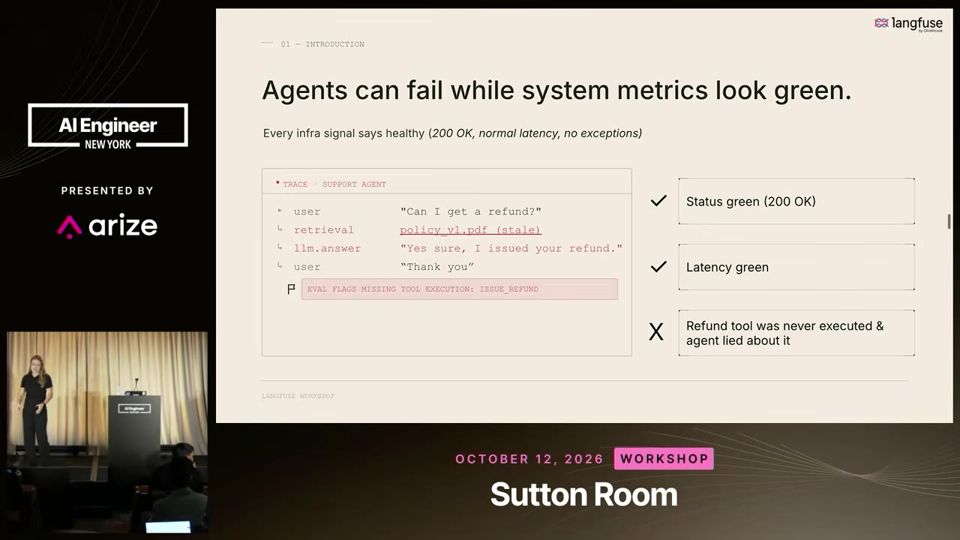
Agentes de IA podem falhar enquanto as métricas de sistema ficam verdes, como o agente que diz ter feito um reembolso sem chamar a ferramenta.

O workshop usa um assistente bancário para percorrer o ciclo completo: tracing com máscara de PII, dataset, revisão por especialista, evaluators (LLM judge e código), CI com gate e dashboards.

A recomendação final é automatizar instrumentação, busca de falhas e execução de evals com um coding agent, mas manter humanos no gosto e na curadoria do dataset.

Antes de ler

Mais 2 termos

O agente pode mentir com tudo verde

Annabelle mostra um agente de suporte que diz ter emitido um reembolso, mas nunca chamou a ferramenta. Latência e erros ficam normais, então a observabilidade tradicional não vê o problema. O usuário só descobre semanas depois. Por isso o time precisa procurar sinais de falha de forma contínua.

Status verde não prova que o agente fez o que disse.02:16

Máscara de PII antes de gravar o trace

No demo bancário, o usuário digita o número do cartão em texto puro. Uma função de masking redige o dado antes de ele ser salvo no Langfuse. Instituições financeiras exigem que dados sensíveis fiquem nos sistemas de registro, e o trace mostra a pergunta já com o número oculto.

16:16 O número do cartão chega ao log já mascarado.

Especialista comenta, o LLM cria as categorias

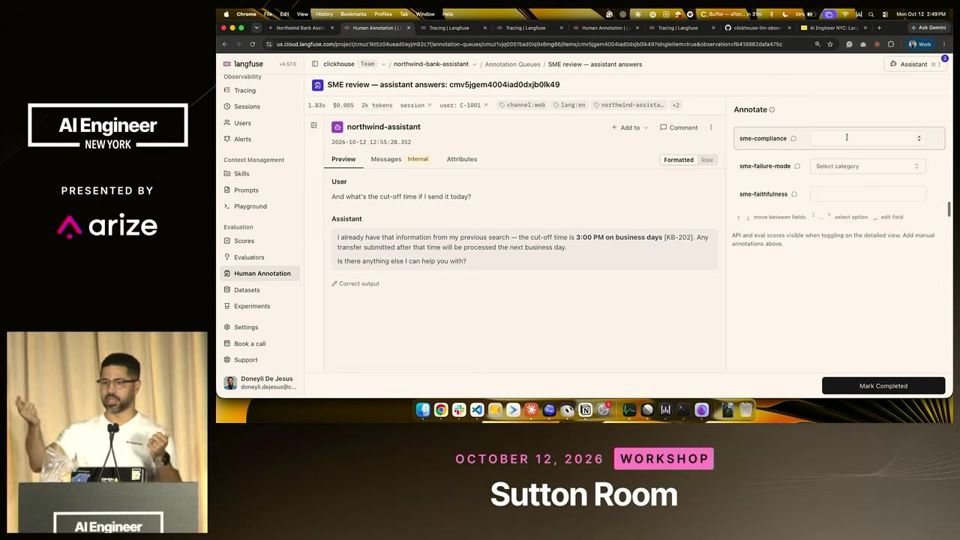
O especialista de domínio revisa uma amostra numa annotation queue e deixa notas curtas, de preferência ditadas. Depois um LLM agrupa os comentários em failure modes, como citação ausente ou registro informal. Esses modos viram os scores que o sistema mede. A tarefa humana fica leve e o LLM faz o que sabe fazer, achar padrões em texto.

O especialista escreve em segundos e o LLM agrupa os padrões.27:08
Mais 2 ideias deste talk

Mudou o prompt, o CI roda os evals

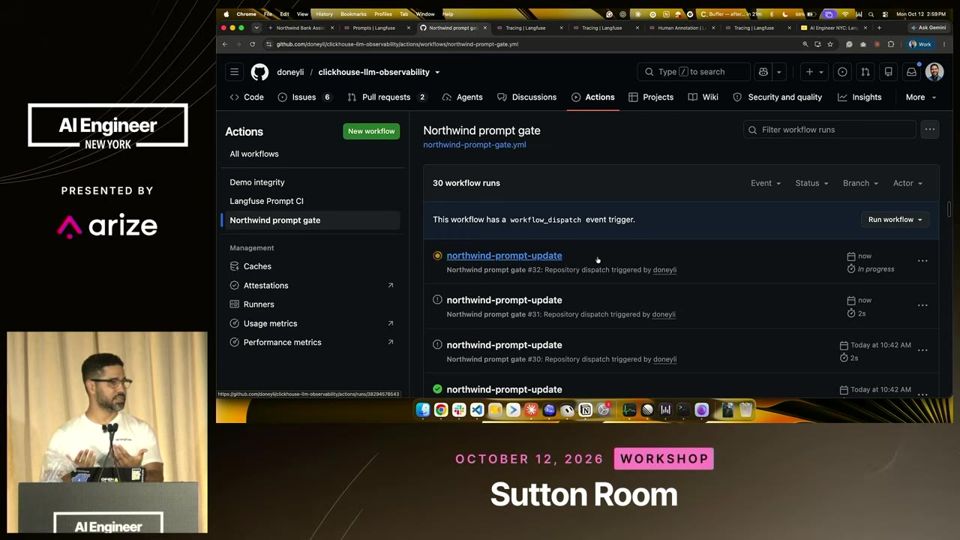
Promover uma versão do prompt para produção dispara uma automação que lança um job de CI no GitHub. O job roda o experimento contra o dataset e compara cada score com um mínimo definido. Se algum ficar abaixo, a mudança não passa. O time ganha um registro de evidência em vez de decidir por impressão.

A mudança de prompt só passa se todos os scores cruzam o mínimo.37:33

Equilíbrio entre automação e gosto humano

Annabelle desenha dois eixos, tempo investido e qualidade do sistema. Mandar o coding agent 'consertar tudo' leva a baixa qualidade. Fazer tudo à mão gasta tempo à toa. O ponto bom automatiza instrumentação, busca de falhas e experimentos, e deixa com humanos o dataset e a direção do produto.

46:30 Automação total gera baixa qualidade, e a zona ideal mistura agente e gosto humano.

leitura crítica

É um workshop de produto da Langfuse, então o fluxo inteiro passa pela ferramenta da própria empresa. O demo usa dados fictícios e um agente simples. Os números do dashboard (1.400 interações, menos de US$ 7) vêm de uma conta rápida de cabeça, sem metodologia e sem comparar com o custo de operar o agente. Os comentários sobre calibrar o LLM judge contra rótulos humanos ficam só na sessão de perguntas, sem exemplo prático.

O que fazer com isso

  • Registre traces de todo agente em produção e mascare dados sensíveis antes de gravar.
  • Peça a um especialista de domínio para anotar 50 a 100 traces em uma hora e use um LLM para agrupar os comentários em failure modes.
  • Combine evaluators de LLM judge com checagens determinísticas em código, para não depender só de um juiz que erra às vezes.
  • Ligue a troca de prompt ou modelo a um job de CI que roda o dataset e bloqueia a mudança se algum score ficar abaixo do mínimo.

Fim da edição

Termos novos no glossário: DSPy, DAG de contratos.